
Curso
Implementação de Soluções de IA nos Negócios
2 h
54.8K
Dê à sua equipe acesso à biblioteca completa do DataCamp, com relatórios centralizados, atribuições, projetos e muito mais
Se você quer aprender mais sobre gestão de dados, confira meus outros artigos desta série:
Um data warehouse é um sistema de armazenamento especializado, criado para coletar e organizar grandes volumes de dados. Ele tem várias características-chave que definem seu propósito e funcionamento.
Em um data warehouse, os dados são organizados por temas ou áreas de negócio específicas (por exemplo, vendas, marketing, estoque). Isso facilita analisar aspectos específicos do negócio.
Dados de fontes diversas são combinados e transformados em um formato consistente dentro do data warehouse. Essa integração estruturada garante uniformidade e confiabilidade, o que torna a análise mais simples e precisa.
Os dados são armazenados historicamente em um data warehouse. Ou seja, versões antigas não são sobrescritas quando novas chegam. Essa variação temporal permite análise de tendências e comparações ao longo do tempo. A perspectiva histórica é crucial para entender padrões e tendências de longo prazo.
Diferente de sistemas em tempo real, os dados em um warehouse normalmente não são atualizados continuamente. Em vez disso, são carregados em lotes para manter estabilidade e consistência. Depois de inseridos, não são alterados. Essa não volatilidade ajuda a garantir um registro confiável e consistente das transações do negócio.
Resumindo: data warehouses focam áreas específicas do negócio, combinam dados de fontes diferentes em um formato consistente, mantêm histórico para acompanhar mudanças ao longo do tempo e armazenam dados de forma estável, sem alterações após a carga.
Data warehouses e data lakes fazem parte da arquitetura moderna de dados e têm papéis complementares. Ambos são projetados para gerenciar e analisar grandes volumes de dados, mas adotam abordagens diferentes.
|
Recurso |
Data warehouse |
Data lake |
|
Estrutura dos dados |
Estruturados |
Não estruturados, semiestruturados e estruturados |
|
Esquema |
Esquema predefinido |
Schema-on-read (esquema definido no processamento) |
|
Processamento de dados |
ETL (Extract, Transform, Load) antes do armazenamento |
Dados armazenados em formato bruto, processados conforme necessário |
|
Principais casos de uso |
Business intelligence, relatórios, análise histórica |
Análises exploratórias, machine learning, análises avançadas |
|
Desempenho de consultas |
Otimizado para consultas rápidas |
Varia conforme o framework e a organização dos dados |
|
Armazenamento de dados |
Otimizado para dados estruturados |
Acomoda tipos e formatos de dados diversos |
|
Flexibilidade |
Menos flexível, exige transformação antes de armazenar |
Mais flexível, permite evolução de esquema |
|
Uso comum |
Usado para necessidades bem definidas de relatórios e análises |
Usado para análise exploratória e descoberta de insights |
|
Integração |
Frequentemente usado com data lakes como fonte de dados curados |
Frequentemente usado ao lado de data warehouses para armazenamento e processamento de dados brutos |
Confira este tutorial sobre Data Lakes vs. Data Warehouses para uma comparação mais aprofundada.
O diagrama abaixo é um exemplo de como dados de múltiplas fontes podem fluir para um data warehouse.
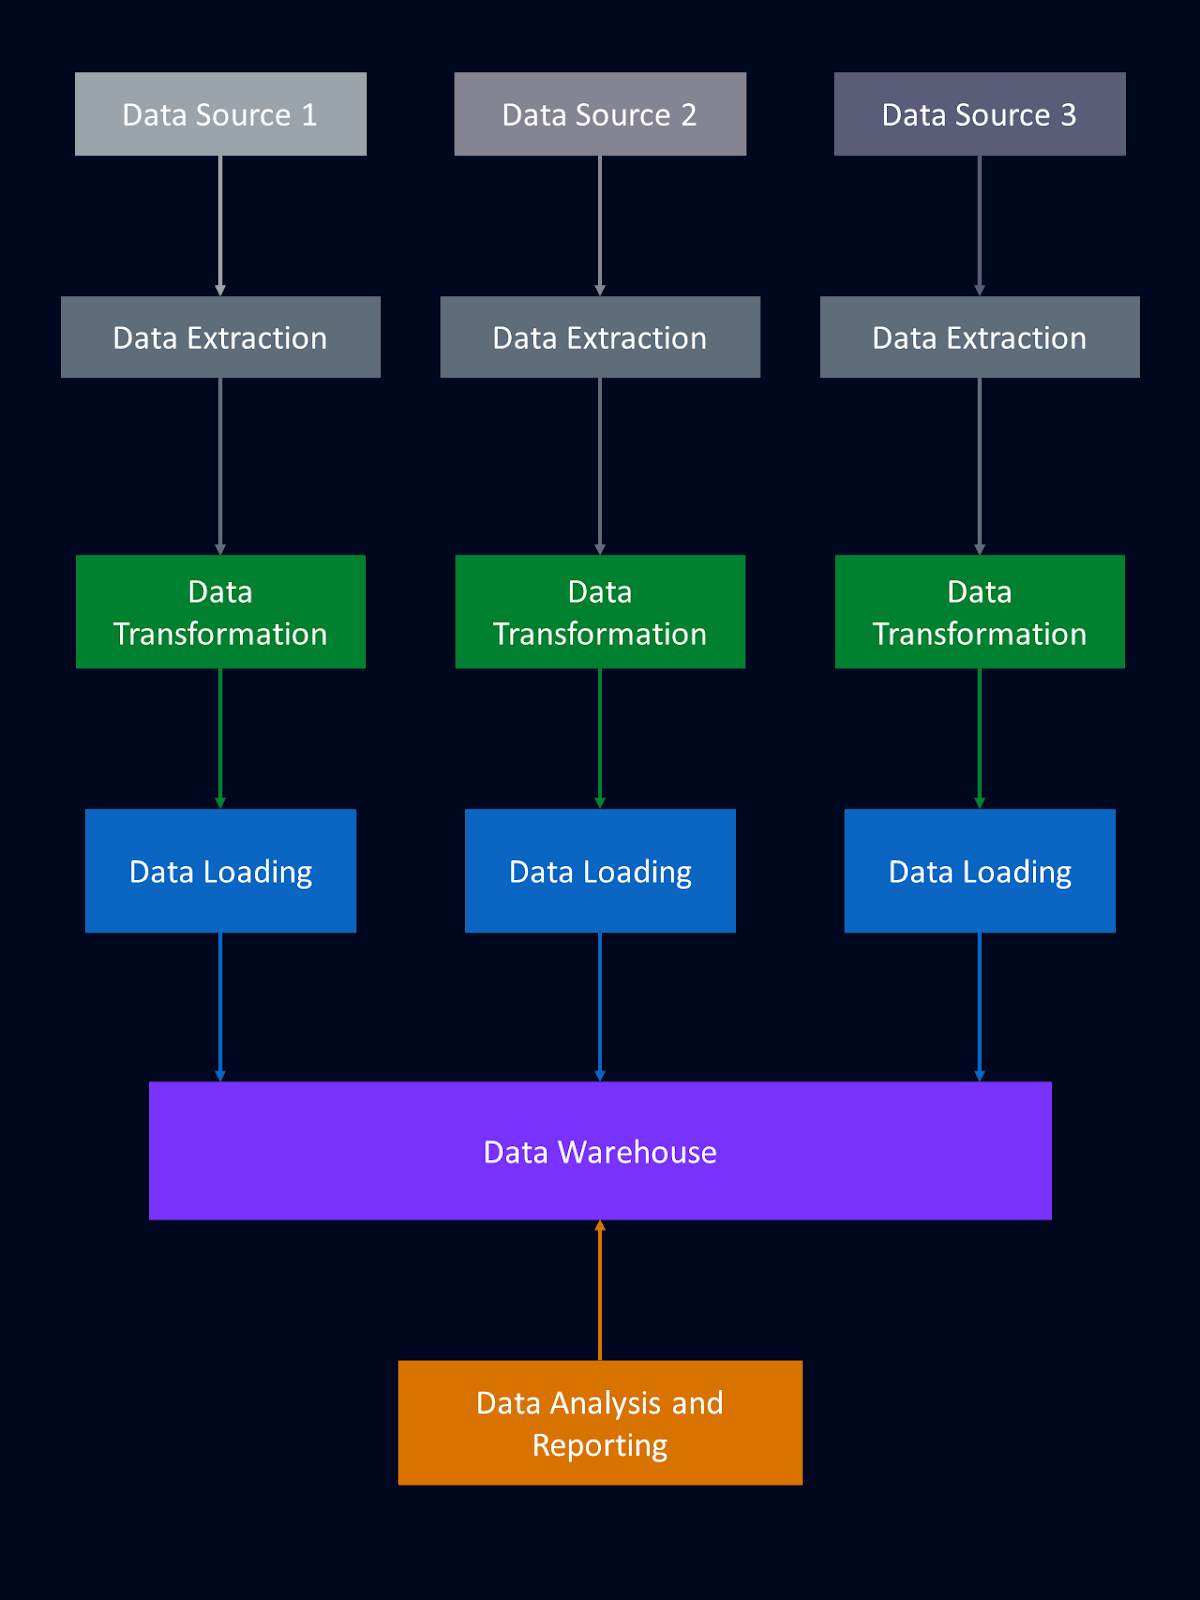
Configurar um data warehouse envolve estruturar dados de várias fontes em um repositório central. Vamos explorar os componentes que formam a arquitetura de um data warehouse e como eles apoiam funções críticas em gestão de dados e analytics.
A área de estágio funciona como a "pista de pouso" dos dados brutos no pipeline. É um local intermediário onde os dados são inicialmente extraídos de sistemas-fonte como bancos de dados, APIs, data lakes e arquivos. Esses dados brutos costumam ser diversos e pouco estruturados, exigindo processamento inicial antes de integrá-los ao data warehouse.
Na área de estágio, os dados passam por limpeza e validação preliminares, como remoção de duplicidades, tratamento de ausências e garantia de integridade. Você pode ler mais sobre limpeza de dados neste guia para iniciantes de data cleaning ou neste curso de Cleaning Data in Python. Os dados também podem ser transformados para um formato padronizado, facilitando a integração com o esquema do data warehouse.
A área de estágio funciona como um buffer que desacopla a extração do carregamento no warehouse. Essa separação dá flexibilidade para gerenciar o fluxo e garante que apenas dados validados e no formato correto entrem no warehouse. Ao preparar os dados nessa etapa, aumentamos a qualidade e a confiabilidade do que será armazenado.
Depois de chegar à área de estágio, os dados passam pelas etapas de extração, transformação e carga (ETL). O processo de ETL é essencial em gestão de dados. Vamos resumir as três etapas:
O ETL é fundamental para converter dados brutos em um ativo útil e valioso para a organização.
A camada de armazenamento de um data warehouse define como os dados são guardados, gerenciados e acessados. Warehouses modernos costumam combinar soluções para aproveitar pontos fortes de diferentes tecnologias. Vamos ver algumas opções comuns: bancos relacionais, bancos colunares e armazenamento em nuvem.
Bancos de dados relacionais tradicionalmente são a base do armazenamento em data warehouses. Eles usam tabelas com relacionamentos predefinidos, seguindo o modelo relacional. Dados estruturados ficam em linhas e colunas, o que facilita a interpretação. SQL (Structured Query Language) é amplamente usada para gerenciar e consultar esses dados.
Bancos relacionais brilham em cenários transacionais estruturados, como sistemas financeiros e de CRM. Porém, podem sofrer com desempenho em volumes massivos de dados. O escalonamento horizontal (adicionar servidores) também pode ser complexo e caro. Por isso, apesar de adequados a muitos casos, costumam ser complementados por outros tipos de armazenamento otimizados para diferentes necessidades.
Bancos colunares são mais especializados, projetados para operações de leitura e consultas analíticas. Em vez de armazenar por linhas, guardam os dados por colunas. Isso permite recuperar e processar grandes conjuntos com mais eficiência. São especialmente indicados para data warehousing e aplicações de business intelligence.
Um dos principais benefícios é otimizar armazenamento e desempenho de consultas analíticas. Ao guardar cada coluna separadamente, dá para acessar só o que importa sem varrer linhas inteiras, acelerando bastante as consultas. Além disso, costumam oferecer melhor compressão, reduzindo custos de armazenamento.
Apesar das vantagens para análises, bancos colunares são menos eficientes para cargas transacionais com muitas escritas e atualizações. Em geral, usamos quando é preciso agregar e resumir rapidamente grandes volumes. Já em sistemas com atualizações e inserções frequentes, não são a melhor escolha.
O armazenamento em nuvem ganhou muita popularidade para data warehousing por sua escalabilidade, flexibilidade e custo-benefício. Provedores como Amazon Web Services (AWS), Google Cloud Platform (GCP) e Microsoft Azure oferecem uma gama de ferramentas e serviços para armazenamento e processamento.
A principal vantagem é a escalabilidade: dá para aumentar ou reduzir a capacidade conforme a demanda, sem grandes investimentos iniciais em hardware. Isso é ótimo para lidar com volumes grandes e flutuantes. A nuvem também oferece alta disponibilidade e recuperação de desastres, mantendo os dados acessíveis e seguros mesmo em falhas de hardware.
Plataformas em nuvem costumam integrar bancos relacionais e colunares, permitindo aproveitar o melhor de cada um. Essa abordagem híbrida suporta tipos de dados e cargas variadas, otimizando desempenho e custo.
No entanto, segurança de dados e privacidade podem ser preocupações, já que dados sensíveis ficam fora do ambiente local. A latência também pode variar conforme a proximidade aos servidores. Além disso, é importante avaliar custos de longo prazo e o risco de dependência de fornecedor (vendor lock-in).
A camada de armazenamento pode combinar bancos relacionais, colunares e nuvem para atender às necessidades diversas da gestão e análise de dados moderna.
Data marts são subconjuntos menores e focados do data warehouse, voltados a áreas ou funções específicas do negócio. Essencialmente, são segmentos do warehouse pensados para atender necessidades de um grupo específico de usuários.
Diferente do warehouse corporativo, que consolida dados de toda a organização, um data mart foca um único domínio ou função. Ao oferecer uma visão mais direcionada, permite análises mais objetivas para cada departamento.
São especialmente úteis quando áreas específicas precisam de acesso rápido a dados relevantes para decidir. Entregam soluções sob medida sem a complexidade e o custo de um warehouse completo. Também ajudam a evoluir uma solução de warehousing de forma incremental, começando por escopos menores.
Mas não servem para todo cenário. Data marts podem enfrentar problemas de integração, exigindo processos robustos de ETL e governança para manter alinhamento com o warehouse central. Manter desempenho e escalabilidade com o crescimento dos dados também pode ser desafiador. É preciso planejamento e alocação de recursos, principalmente ao escalar.
Se você estiver recorrendo a muitos data marts, talvez valha considerar mudar de estratégia para um data mesh.
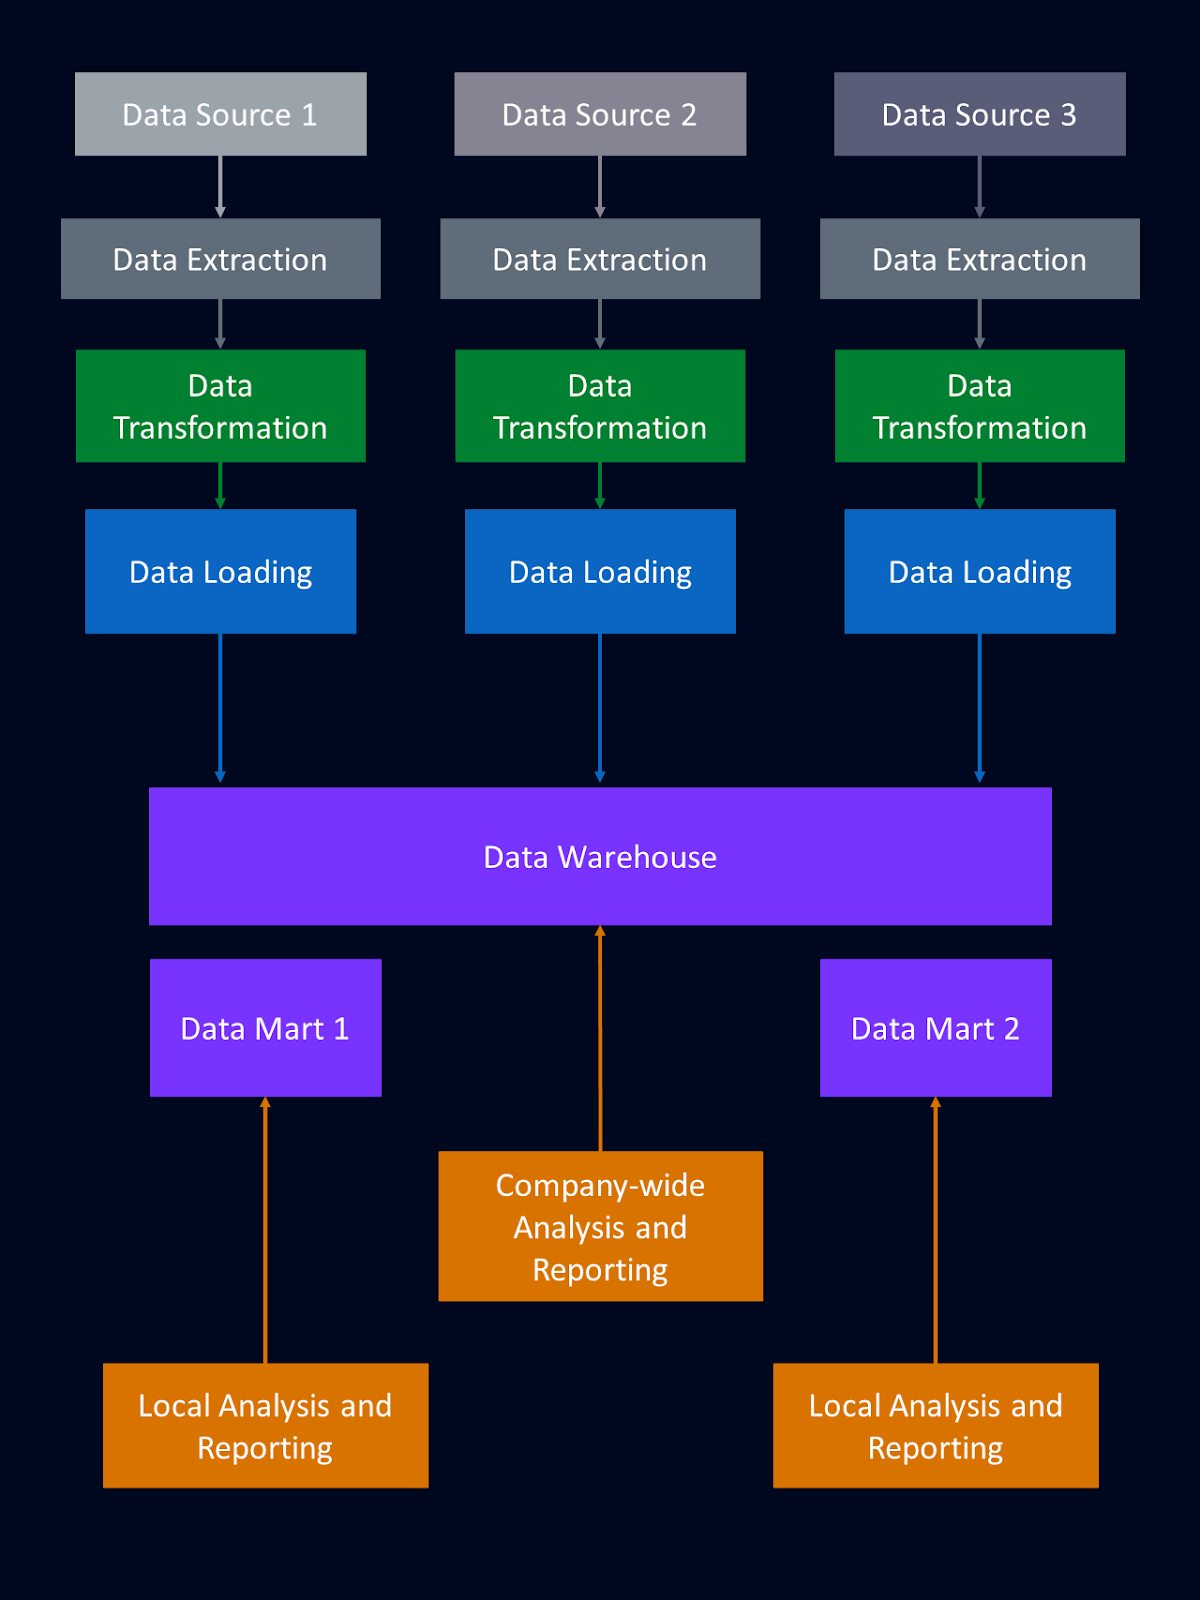
O diagrama acima ilustra como seções do data warehouse podem ser configuradas como data marts independentes.
Para acessar e analisar os dados do warehouse, usamos diversas ferramentas de consulta, manipulação e visualização.
Um cliente SQL é um aplicativo que permite conectar a um banco de dados e escrever/rodar consultas SQL para recuperar e manipular dados. Eles ajudam em tarefas como consultar dados, atualizar registros e criar tabelas. Você talvez conheça clientes populares como MySQL Workbench e pgAdmin. Se você quer gerenciar sistemas de servidor, Introduction to SQL Servers é um ótimo começo! Ou confira a SQL Server Developer Track.
Plataformas de Business Intelligence oferecem um conjunto completo de ferramentas para análise, relatórios e visualização. Elas permitem criar relatórios detalhados e extrair insights dos dados. Ferramentas de visualização como Tableau, Power BI e Looker são especialmente populares e facilitam criar dashboards interativos. Saiba mais em Tableau Fundamentals ou Power BI Fundamentals.
Ferramentas como essas ajudam você a aproveitar todo o potencial dos dados armazenados no warehouse.
Um data warehouse oferece vantagens que elevam a capacidade de gestão de dados da organização.
Um warehouse traz gestão centralizada e uma única fonte da verdade para relatórios e análises. Essa centralização garante consistência e confiabilidade, eliminando divergências que surgem quando os dados ficam espalhados por várias fontes.
Outra grande vantagem é permitir análises históricas. Como armazena dados ao longo do tempo, dá para analisar tendências e fazer comparações históricas. Isso gera insights sobre padrões de longo prazo, úteis para planejamento e previsão.
Melhorar a qualidade dos dados é um benefício central de qualquer sistema de gestão centralizada, incluindo o warehouse. Os dados são padronizados e limpos para garantir precisão e consistência, tornando análises e relatórios mais confiáveis.
Data warehouses são otimizados para consultas analíticas complexas. Isso acelera a recuperação de informações, algo vital quando insights ágeis orientam decisões de negócio.
Ferramentas de BI aproveitam os dados centralizados do warehouse para gerar insights acionáveis. As plataformas mais comuns se conectam muito bem a data warehouses.
Um data warehouse é uma fonte rica para análises avançadas, como data mining e machine learning. A natureza estruturada dos dados facilita criar modelos preditivos sofisticados, que ajudam a antecipar tendências, identificar oportunidades e mitigar riscos.
Embora não seja a solução ideal para todo caso, há situações em que vale muito avaliar um data warehouse. Veja alguns cenários:
Se sua organização sofre para gerenciar dados espalhados por vários sistemas e aplicativos, um sistema centralizado como o warehouse pode ajudar a consolidar esse ambiente diverso e simplificar análises abrangentes.
Para necessidades de análise histórica — quando é importante entender tendências e padrões ao longo do tempo — um warehouse oferece o contexto necessário.
Se seus sistemas operacionais têm dificuldade para executar consultas complexas com eficiência, criar um ambiente de dados mais estruturado pode melhorar o desempenho. Nesse caso, considere um data warehouse.
Em muitos cenários, um data warehouse é peça importante de um bom plano de gestão de dados — essencial para fazer os dados trabalharem a seu favor.
Um data warehouse é uma ferramenta poderosa para aproveitar ao máximo seus dados. Ele fornece um repositório centralizado, integrado e estruturado para a informação da sua organização.
Aprenda mais sobre data warehouses no curso Data Warehousing Concepts da DataCamp. Também recomendo O que é data federation e O que é data fabric como leituras complementares.
Garanta a conformidade e proteja seus negócios com o DataCamp for Business. Cursos especializados e rastreamento centralizado para proteger seus dados.
Aprenda IA para negócios!
Curso
Programa
Curso
blog
Tim Lu
12 min
blog
Matt Crabtree
15 min
blog
Matt Crabtree
14 min
blog
Matt Crabtree
15 min
blog
Abid Ali Awan
9 min
Tutorial
Zoumana Keita
15 min




