
Kurs
KI-Lösungen im Unternehmen implementieren
2 Std.
54.8K
Verschaffe deinem Team Zugang zur gesamten DataCamp-Bibliothek mit zentralisierten Berichten, Aufgaben, Projekten und mehr
Wenn du mehr über Datenmanagement erfahren möchtest, lies auch die weiteren Artikel dieser Serie:
Ein Data Warehouse ist ein spezialisiertes Speichersystem, das große Datenmengen sammelt und organisiert. Mehrere zentrale Merkmale definieren Zweck und Funktionsweise.
Im Data Warehouse werden Daten rund um spezifische Themen oder Geschäftsbereiche organisiert (z. B. Vertrieb, Marketing, Bestände). Das erleichtert Analysen zu gezielten Aspekten des Geschäfts.
Daten aus unterschiedlichen Quellen werden zusammengeführt und in ein einheitliches Format transformiert. Diese strukturierte Integration stellt Einheitlichkeit und Verlässlichkeit sicher und macht Analysen einfacher und verständlicher.
Daten werden im Data Warehouse historisiert gespeichert. Frühere Versionen werden bei neuen Ladevorgängen nicht überschrieben. Diese Zeitlichkeit ermöglicht Trendanalysen und Vergleiche über Zeiträume hinweg – essenziell, um langfristige Entwicklungen und Muster zu erkennen.
Anders als in Echtzeitsystemen werden Daten im Warehouse üblicherweise nicht in Echtzeit aktualisiert, sondern in Batches geladen – für Stabilität und Konsistenz. Einmal geladen, werden sie nicht verändert. Diese Nicht-Flüchtigkeit sorgt für eine verlässliche, konsistente Aufzeichnung von Geschäftsvorfällen.
Kurz gesagt: Data Warehouses fokussieren auf Geschäftsbereiche, vereinheitlichen Daten aus verschiedenen Quellen, halten Historien zur Veränderungsverfolgung vor und speichern Daten stabil, ohne sie nachträglich zu ändern.
Data Warehouses und Data Lakes sind beides zentrale Bausteine moderner Datenarchitekturen und ergänzen sich. Beide verwalten und analysieren große Datenmengen, setzen dabei aber auf unterschiedliche Ansätze.
|
Merkmal |
Data Warehouse |
Data Lake |
|
Datenstruktur |
Strukturiert |
Unstrukturiert, semi-strukturiert und strukturiert |
|
Schema |
Vordefiniertes Schema |
Schema-on-Read (Schema bei der Verarbeitung definiert) |
|
Datenverarbeitung |
ETL (Extract, Transform, Load) vor der Speicherung |
Rohdaten gespeichert, Verarbeitung nach Bedarf |
|
Primäre Einsatzszenarien |
Business Intelligence, Reporting, historische Analysen |
Explorative Analysen, Machine Learning, Advanced Analytics |
|
Abfrageleistung |
Für schnelle Abfragen optimiert |
Variiert je nach Framework und Datenorganisation |
|
Datenspeicherung |
Für strukturierte Daten optimiert |
Unterstützt vielfältige Datentypen und -formate |
|
Flexibilität |
Weniger flexibel, Transformation vor Speicherung nötig |
Flexibler, erlaubt Schema-Evolution |
|
Typische Nutzung |
Für klar definierte Reporting- und Analysebedarfe |
Für explorative Analysen und das Entdecken von Insights |
|
Integration |
Oft mit Data Lakes als Quelle kuratierter Daten kombiniert |
Häufig neben Data Warehouses für Rohdatenspeicherung und -verarbeitung genutzt |
Sieh dir dieses Tutorial zu Data Lakes vs. Data Warehouses für einen tieferen Vergleich an.
Das folgende Diagramm zeigt beispielhaft, wie Daten aus mehreren Quellen in ein Data Warehouse fließen.
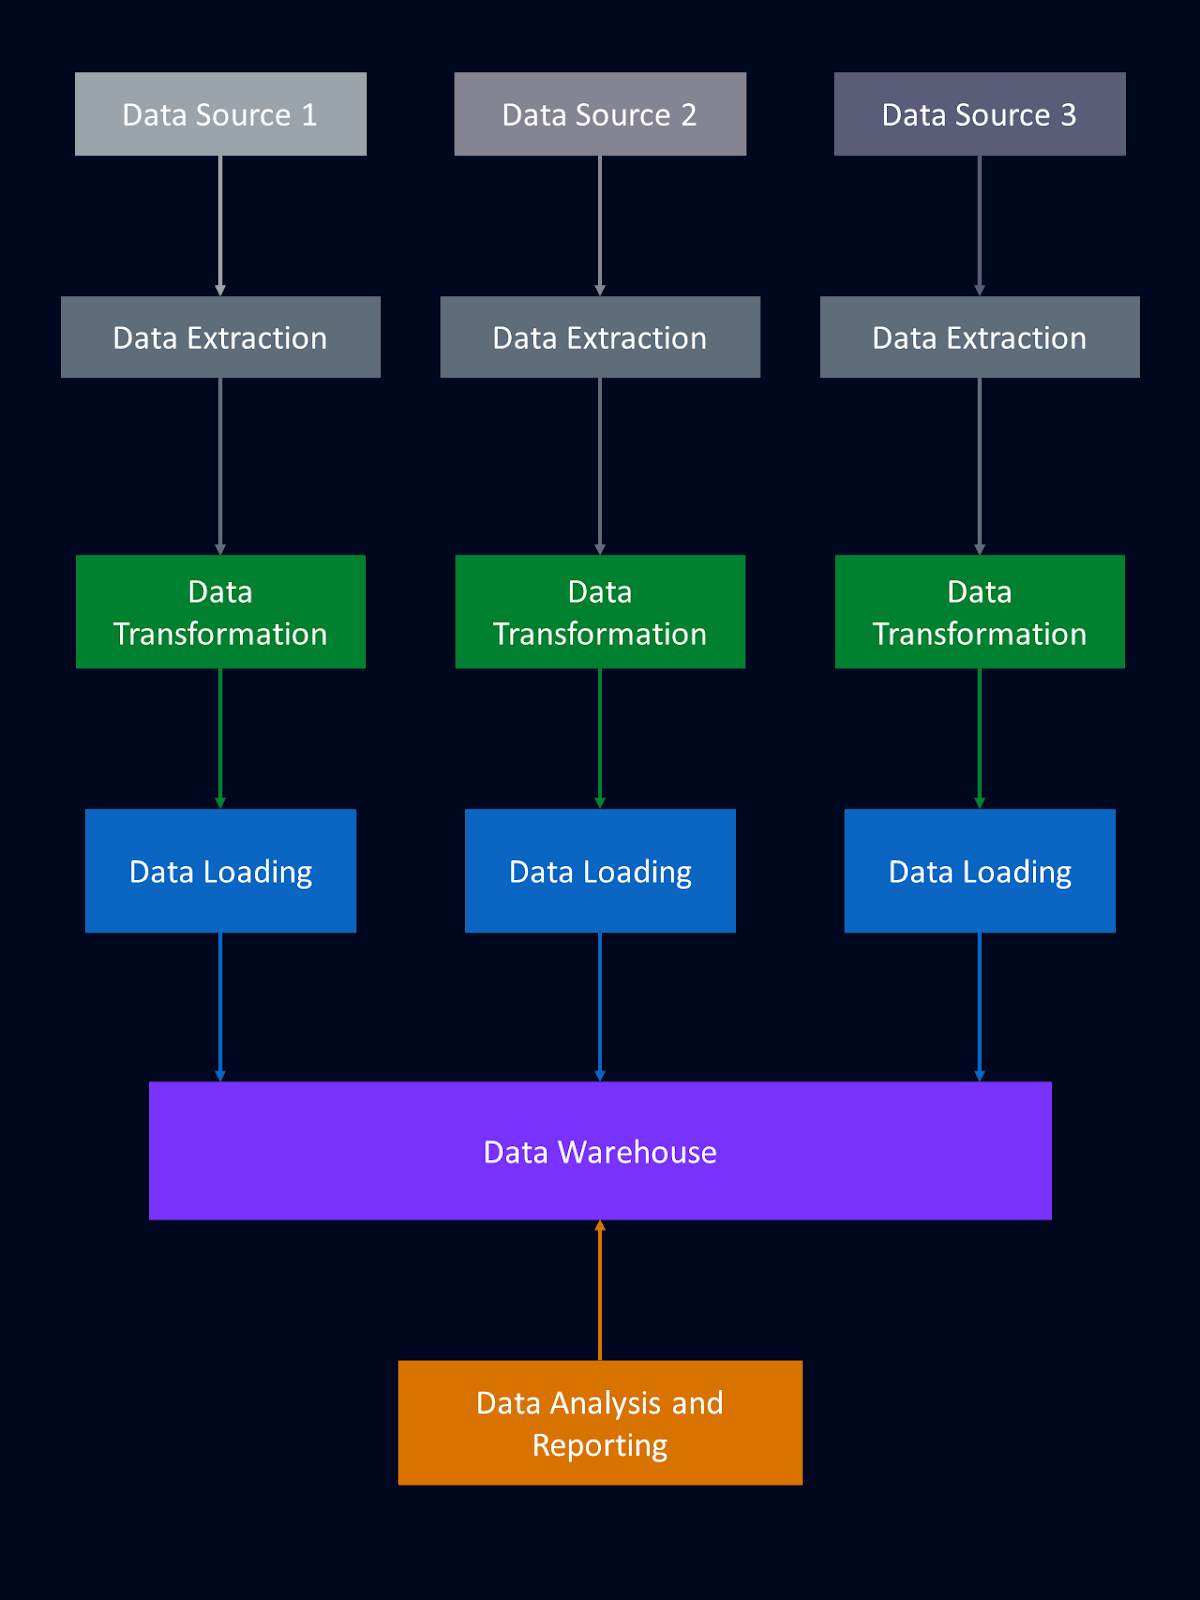
Beim Aufbau eines Data Warehouses werden Daten aus verschiedenen Quellen in einem zentralen Repository strukturiert. Schauen wir uns die Komponenten der Data-Warehouse-Architektur an und wie sie zentrale Aufgaben in Datenmanagement und Analytics unterstützen.
Der Staging-Bereich ist die erste Anlaufstelle für Rohdaten in der Datenpipeline. Hier werden Daten zunächst aus Quellsystemen wie Datenbanken, APIs, Data Lakes und Dateien abgelegt. Diese Rohdaten sind oft heterogen und teils unstrukturiert und benötigen eine erste Aufbereitung, bevor sie ins Data Warehouse integriert werden können.
Im Staging werden Daten vorläufig bereinigt und validiert – etwa Duplikate entfernt, fehlende Werte behandelt und die Datenintegrität sichergestellt. Mehr zur Datenbereinigung findest du in diesem Einsteigerleitfaden zur Datenbereinigung oder im Kurs Data Cleaning in Python. Häufig werden Daten zudem in ein standardisiertes Format transformiert, um die Integration in das Data-Warehouse-Schema zu erleichtern.
Der Staging-Bereich entkoppelt die Extraktion vom Laden ins Warehouse. Diese Trennung schafft Flexibilität im Datenfluss und stellt sicher, dass nur validierte, korrekt formatierte Daten ins Warehouse gelangen. So steigern wir Qualität und Verlässlichkeit der gespeicherten Daten.
Im Staging durchlaufen die Daten die üblichen Schritte Extraktion, Transformation und Laden (ETL). Der ETL-Prozess ist ein Kernelement im Datenmanagement. Kurz zusammengefasst:
ETL macht aus Rohdaten einen nutzbaren, wertvollen Unternehmenswert.
Die Speicherschicht eines Data Warehouses legt fest, wie Daten gespeichert, verwaltet und abgerufen werden. Moderne Warehouses kombinieren häufig mehrere Speichertechnologien, um deren Stärken zu nutzen. Übliche Optionen sind relationale Datenbanken, spaltenorientierte Datenbanken und Cloudspeicher.
Relationale Datenbanken sind traditionell das Rückgrat der Datenspeicherung in Data Warehouses. Sie nutzen Tabellen mit vordefinierten Beziehungen im relationalen Modell. Strukturierte Daten werden in Zeilen und Spalten abgelegt und sind damit gut interpretierbar. SQL (Structured Query Language) wird häufig zur Verwaltung und Abfrage eingesetzt.
Relationale Datenbanken glänzen bei strukturierten Transaktionsdaten, etwa in Finanzsystemen oder CRM-Systemen. Bei sehr großen Datenmengen können jedoch Performance-Themen auftreten, und horizontales Skalieren (mehr Server hinzufügen) ist komplex und teuer. Daher werden sie oft durch andere Speicherarten ergänzt, die für spezielle Anforderungen optimiert sind.
Spaltenorientierte Datenbanken sind auf leseintensive Operationen und analytische Abfragen ausgelegt. Statt Daten zeilenweise zu speichern, werden Spalten separat abgelegt. Das ermöglicht einen effizienten Zugriff und die Verarbeitung großer Datensätze. Sie eignen sich besonders für Data Warehousing und Business Intelligence.
Ein wesentlicher Vorteil ist die optimierte Speicherung und Abfrageleistung für analytische Workloads. Durch die spaltenweise Ablage können nur die benötigten Werte gelesen werden, ohne ganze Zeilen zu scannen – das beschleunigt Abfragen deutlich. Zudem ermöglichen spaltenorientierte Systeme oft bessere Kompression und senken so Speicherkosten.
Für transaktionale Workloads mit häufigen Schreib- und Update-Operationen sind sie dagegen weniger effizient. Üblicherweise kommen sie bei schnellen Aggregationen und Zusammenfassungen großer Datensätze zum Einsatz, weniger in Systemen mit vielen laufenden Änderungen und Einfügungen.
Cloudspeicher hat sich dank Skalierbarkeit, Flexibilität und Kostenvorteilen als Option für Data Warehouses etabliert. Anbieter wie Amazon Web Services (AWS), Google Cloud Platform (GCP) und Microsoft Azure bieten umfangreiche Tools und Services für Speicherung und Verarbeitung.
Der größte Vorteil ist die Skalierbarkeit. Unternehmen können ihren Speicherbedarf flexibel nach oben oder unten anpassen, ohne hohe Anfangsinvestitionen in Hardware. Das ist besonders hilfreich bei großen oder schwankenden Datenvolumina. Zudem bieten Cloudspeicher hohe Verfügbarkeit und Desaster Recovery, sodass Daten auch bei Hardwareausfällen zugänglich und geschützt bleiben.
Cloudplattformen integrieren häufig relationale und spaltenorientierte Datenbanken, sodass wir die Vorteile beider Welten nutzen können. Dieser hybride Ansatz unterstützt verschiedene Datentypen und Workloads und optimiert Leistung und Kosten.
Allerdings sind Datensicherheit und Privatsphäre zu beachten, da sensible Daten außerhalb des eigenen Rechenzentrums liegen. Je nach Nähe zu den Cloud-Servern kann Latenz entstehen. Außerdem sollten wir langfristige Kosten und potenzielle Anbieterbindung im Blick behalten.
Die Speicherschicht eines Data Warehouses kann eine Mischung aus relationalen Datenbanken, spaltenorientierten Datenbanken und Cloudspeicher umfassen, um den vielfältigen Anforderungen moderner Daten- und Analyseprozesse gerecht zu werden.
Data Marts sind kleinere, fokussierte Teilbereiche des Data Warehouses für bestimmte Abteilungen oder Funktionen. Im Kern ist es ein Segment des Warehouses, zugeschnitten auf die Bedürfnisse einer klar definierten Nutzergruppe im Unternehmen.
Während das unternehmensweite Warehouse Daten aus der gesamten Organisation bündelt, konzentriert sich ein Data Mart auf ein einzelnes Thema oder eine Funktion. Diese fokussierte Sicht ermöglicht gezielte Analysen für spezifische Anforderungen.
Besonders hilfreich sind Data Marts, wenn Abteilungen schnellen Zugriff auf relevante Daten für Entscheidungen brauchen. Sie liefern maßgeschneiderte Datenlösungen ohne die Komplexität und Kosten eines vollumfänglichen Warehouses und eignen sich auch für einen schrittweisen Aufbau der Gesamtarchitektur.
Nicht in jedem Fall sind Data Marts ideal. Es können Integrationsprobleme auftreten, die robuste ETL-Prozesse und Data Governance erfordern, um die Anbindung ans zentrale Warehouse zu sichern. Mit wachsendem Datenvolumen werden Performance und Skalierung anspruchsvoller. Data Marts benötigen sorgfältige Planung und Ressourcen – gerade beim Skalieren.
Wenn du sehr viele Data Marts nutzt, kann sich ein Strategiewechsel hin zu einem Data Mesh lohnen.
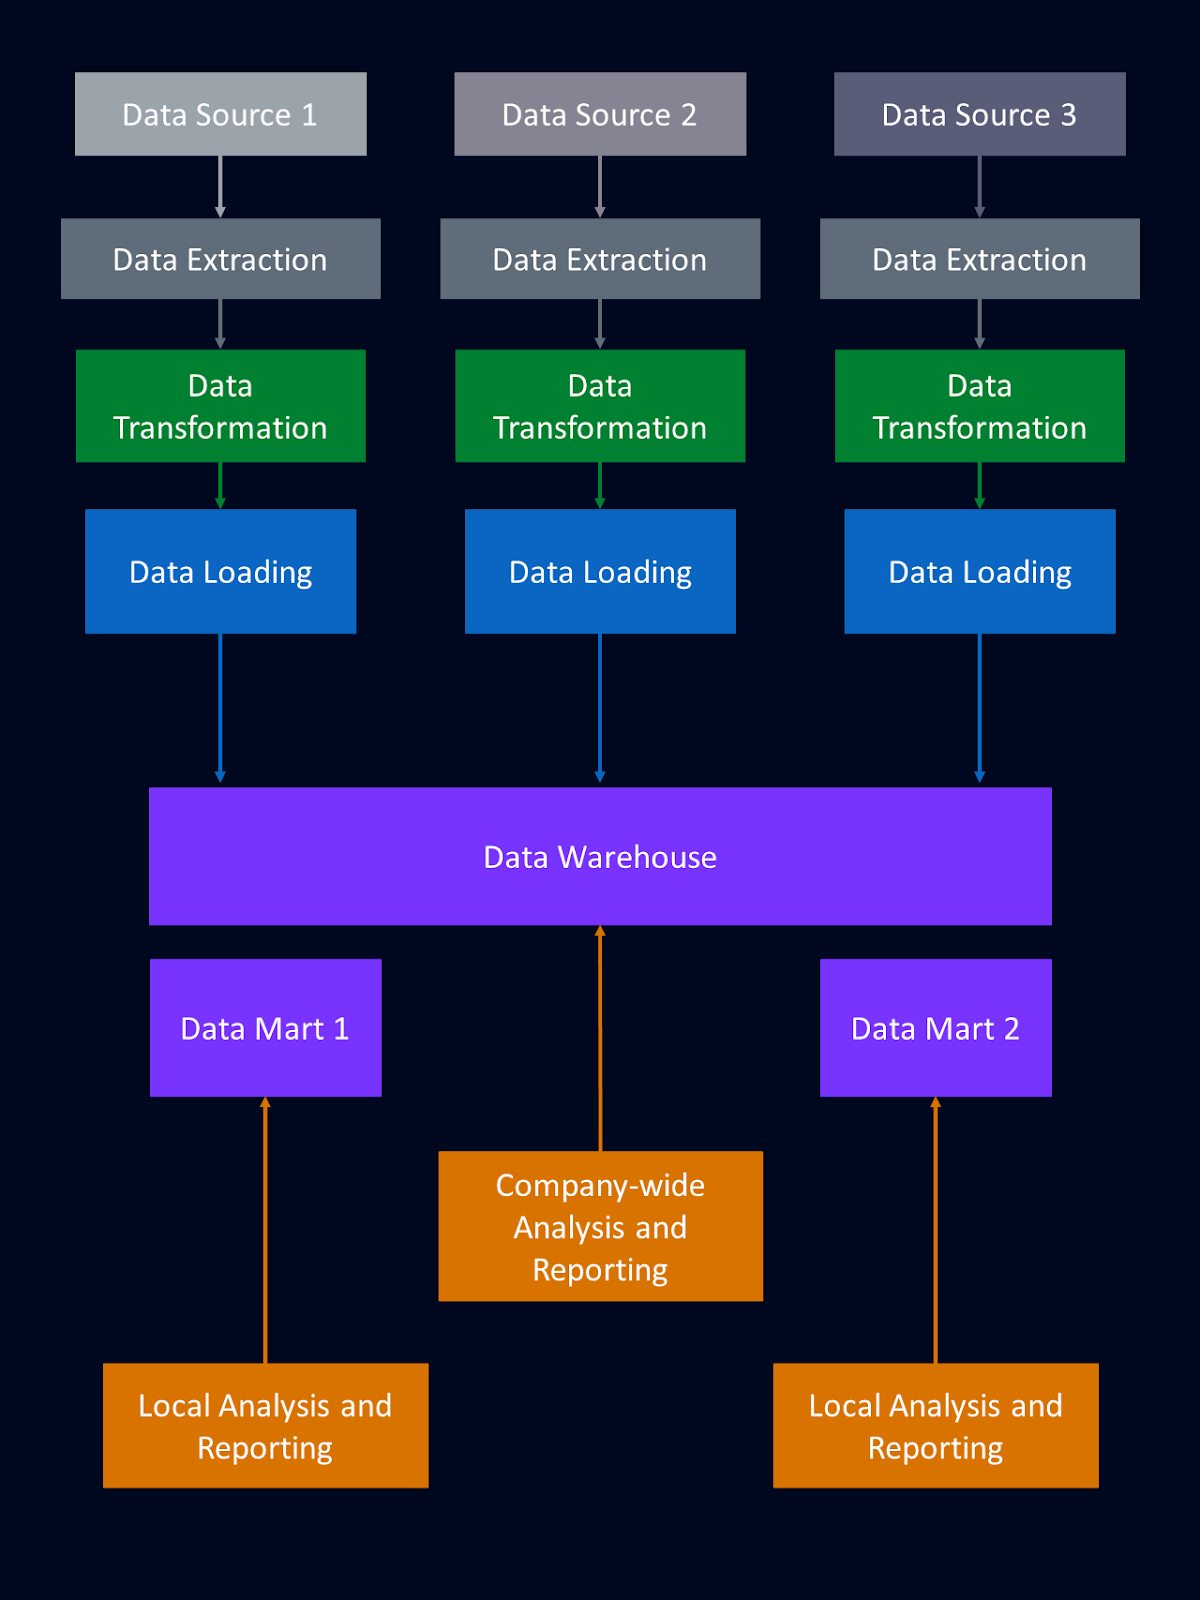
Das Diagramm zeigt, wie Teilbereiche des Data Warehouses als eigenständige Data Marts aufgebaut werden können.
Für den Zugriff auf und die Analyse von Daten im Warehouse nutzen wir verschiedene Tools zur Abfrage, Aufbereitung und Visualisierung.
Ein SQL-Client ist eine Anwendung, mit der wir uns mit einer Datenbank verbinden, SQL-Abfragen schreiben und ausführen, Daten abfragen und manipulieren. Typische Aufgaben sind Abfragen, Updates oder das Erstellen von Tabellen. Bekannte Clients sind zum Beispiel MySQL Workbench und pgAdmin. Wenn du Server-Systeme verwalten möchtest, ist Introduction to SQL Servers ein guter Start. Oder schau dir den SQL Server Developer Track an.
Business-Intelligence-Plattformen bieten umfassende Werkzeuge für Analyse, Reporting und Visualisierung. Damit lassen sich detaillierte Berichte erstellen und aus Daten Erkenntnisse ableiten. Beliebte Visualisierungstools wie Tableau, Power BI und Looker machen es leicht, interaktive Dashboards und Visualisierungen zu erstellen. Mehr zu gängigen BI-Tools findest du in Tableau Fundamentals oder Power BI Fundamentals.
Solche Analysetools helfen uns, das volle Potenzial der im Warehouse gespeicherten Daten zu nutzen.
Ein Data Warehouse bietet zahlreiche Vorteile, die die Datenmanagement-Fähigkeiten einer Organisation stärken.
Ein Data Warehouse schafft eine zentrale Datenbasis – die Single Source of Truth für Reporting und Analysen. Diese Zentralisierung sorgt für Konsistenz und Verlässlichkeit und beseitigt Widersprüche, die durch verteilte Datensilos entstehen.
Ein weiterer großer Vorteil ist die Fähigkeit zu historischen Auswertungen. Durch die Speicherung historischer Daten können wir Trends analysieren und Vergleiche über Zeiträume anstellen – wertvoll für Planung und Forecasting.
Zentrale Systeme – auch Data Warehouses – erhöhen die Datenqualität. Daten werden standardisiert und bereinigt, sodass Analysen und Reports auf einer konsistenten, korrekten Grundlage beruhen.
Data Warehouses sind für komplexe analytische Abfragen optimiert. Dadurch werden Daten schneller und effizienter bereitgestellt – entscheidend, wenn zeitnahe Insights benötigt werden.
BI-Tools nutzen die zentralen Daten im Warehouse, um handlungsrelevante Erkenntnisse zu liefern. Die gängigen BI-Lösungen sind bestens auf die Arbeit mit Data-Warehouse-Daten vorbereitet.
Ein Data Warehouse ist eine reichhaltige Datenquelle für Advanced Analytics, einschließlich Data Mining und Machine Learning. Die strukturierte Natur der Daten erleichtert den Aufbau anspruchsvoller Prognosemodelle, die Trends antizipieren, Chancen erkennen und Risiken mindern.
Nicht in jedem Szenario ist ein Data Warehouse die beste Wahl. In manchen Situationen sollten wir es jedoch unbedingt in Betracht ziehen. Hier einige typische Fälle:
Wenn unsere Organisation mit verteilten Daten über viele Systeme und Anwendungen hinweg ringt, kann eine zentrale Lösung wie ein Data Warehouse helfen. Es konsolidiert die Landschaft und erleichtert ganzheitliche Analysen.
Wenn historische Analysen nötig sind oder wir Trends über längere Zeit verstehen müssen, bietet ein Data Warehouse den erforderlichen historischen Kontext.
Wenn operative Systeme bei komplexen Abfragen ins Straucheln geraten, kann eine stärker strukturierte Datenumgebung die Effizienz erhöhen – hier punktet das Data Warehouse mit optimierter Performance und schnelleren Zugriffen.
In vielen Fällen ist ein Data Warehouse ein zentraler Baustein eines tragfähigen Datenmanagementplans. Und ein guter Plan ist der Schlüssel, damit Daten für uns arbeiten.
Ein Data Warehouse ist ein starkes Werkzeug, um das volle Potenzial unserer Daten zu heben. Es bietet ein zentrales, integriertes und strukturiertes Repository für unsere Daten.
Mehr über Data Warehouses erfährst du im DataCamp-Kurs Data Warehousing Concepts. Außerdem empfehle ich What Is a Data Federation und What Is a Data Fabric als weiterführende Lektüre zu diesem Thema.
Stelle die Einhaltung von Vorschriften sicher und schütze dein Unternehmen mit DataCamp for Business. Spezialisierte Kurse und zentralisierte Nachverfolgung zum Schutz deiner Daten.
Lerne KI fürs Business!
Kurs
Lernpfad
Kurs