Courses
使用 Google ADK 构建 AI Agent
1小时
7.5K
本月的焦点在语音。于 Artificial Analysis 的 Speech to Speech Index(语音对语音指数)上,OpenAI 的 GPT-Live-1 Astra 与 SpaceXAI 的 Grok Voice Think Fast 2.0 以 0.2 分之差位居顶端,OpenAI 已在九月上旬发布 GPT-6 Astra。9 月 15 日,谷歌以两款全新的语音对语音模型回应:Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking。
Extended Thinking 以 82.6 分登上该指数榜首,并在 τ-Voice 代理性基准上以 68.6% 领先。基础款 3.8 Live 则主打低价:在 Artificial Analysis 的成本测试中,处理一小时输入音频仅需 $0.84,为谷歌图表中所有模型的最低。两款模型今日均以与其前代 Gemini 3.1 Flash Live 相同的价格在 Gemini API 上普遍可用。
本文将全面介绍 Gemini 3.8 Live 的新变化,包括功能、基准表现、两种变体的分工,以及运行成本。您也可以参考我们的指南:Gemini Live API 入门与使用 GPT-Live-1 构建语音助手。
Gemini 3.8 Live 是谷歌面向实时语音代理的原生语音对语音模型,于 2026 年 9 月 15 日发布,同时发布的还有推理能力更强的同系模型 Gemini 3.8 Live Extended Thinking。两者均通过 Gemini Live API 的 WebSocket 连接运行,支持音频、视频、图像与文本作为输入,并输出音频。谷歌将 3.8 Live 定位为低时延对话的默认选择,而 Extended Thinking 则用于复杂的多步骤任务。
相较于 Gemini 3.1 Flash Live,此代在“非对话性工作”的处理方式上发生了变化。工具与 API 调用默认在后台运行,同时模型继续对话;Extended Thinking 还在此基础上加入了可配置的后台推理。谷歌将这对组合描述为对其以往实时模型的飞跃,并可替代将语音转文本、LLM 与文本转语音串联的级联式流水线。
谷歌列出了五项能力,其中对构建语音代理最关键的是改变对话循环的两项:异步工具调用与后台推理。
两款模型都能在后台执行函数调用与 API 请求,同时向用户回传音频。在 Gemini 3.8 Live 上,异步执行现为默认的函数调用模式。您仍可在工具声明中设置 behavior: BLOCKING 强制旧的同步行为,且模型支持通过 SILENT、WHEN_IDLE 与 INTERRUPTED 选项来调度函数,从而决定何时播报结果。
Extended Thinking 走得更远:它要求工具非阻塞,若声明了阻塞工具会直接返回硬错误。其效果是,呼叫者在请求更改预订时会先听到确认,再听到进度更新,随后得到结果;而级联式流水线会在等待 API 时保持沉默。在 Gemini 3.1 Flash Live 上,函数调用只能顺序执行,且在您回传工具结果前,模型不会开始响应。
Gemini 3.8 Live Extended Thinking 能一边推理一边说话。谷歌文档描述模型会用“让我查一下”之类的早期口头提示来确认收到请求,并在多步骤后台工作推进时叙述进度。您可通过将 thinking_level 设为 low、medium 或 high 来控制深度;3.1 Flash Live 上的 MINIMAL 等级已取消。
这改变了协议,我认为这是本次迁移中最重要的细节。由于模型在一次请求中可多次说话,turnComplete: true 已不再表示其空闲。
您的客户端需要监听新的 interaction_status 字段:在推理或工具运行期间报告为 IN_PROGRESS,当整个任务完成时为 IDLE。若忽略它,您的界面可能会在模型仍在处理中就切回“正在聆听”。
Gemini 3.8 Live 将对话锚定于实时视觉输入,能近乎实时处理视频帧,因此代理既能回应用户所说,也能回应用户所见。谷歌演示包括一场实时象棋对弈,以及一段员工入职引导,模型可回答屏幕内容相关的问题。
但视频并非免费。轮次覆盖默认会将音频活动与所有视频帧一并发送给模型,因此若您的应用不需要视觉能力,应只在有用时再发送帧,以节省上下文预算并降低成本。音频加视频会话还会被限制为 2 分钟,超过需通过会话管理延长;仅音频会话的上限为 15 分钟。
谷歌称之为“字母数字精度”:能准确解析口述的确认码、理赔号与技术标识符。做过客服或物流语音代理的人都知道,级联栈常在此处失足,因为一旦前面的语音转文本出错,后续环节无法挽回。原生语音模型可在完整语境中听到整段话,这里有结构性优势。
Gemini 3.8 Live 可在对话中识别并切换 97 种受支持语言,且谷歌称其口音在不同语言间保持一致。两款模型还支持所谓的增量内容更新:您可在任意时刻以明确的 user 或 model 角色将结构化数据注入会话,模型会将其与实时音频合并。这正是您在不中断通话的情况下向对话中注入客户记录或订单状态的方式。
两项较小但会影响现有代码的变更:主动音频(模型可决定不回应并非对它说的话)现已永久开启,设为 false 将返回错误。情感化对话已完全从 API 中移除,因此任何 enable_affective_dialog 配置都需删除。
Extended Thinking 在谷歌发布的各项质量与代理性榜单上均领先,但与 OpenAI 的 GPT-Live-1 Astra 差距不大;基础款 3.8 Live 则以明显优势赢在成本上,但在代理性任务中落后。
下文的指数、τ-Voice、Big Bench Audio 与成本数据均来自 Artificial Analysis 的公开榜单,因此是独立测量而非厂商自报。τ³-Banking 的数据来自谷歌发布图表中引用的 Sierra,在 Sierra 榜单同步前,请将该行视为厂商自报。
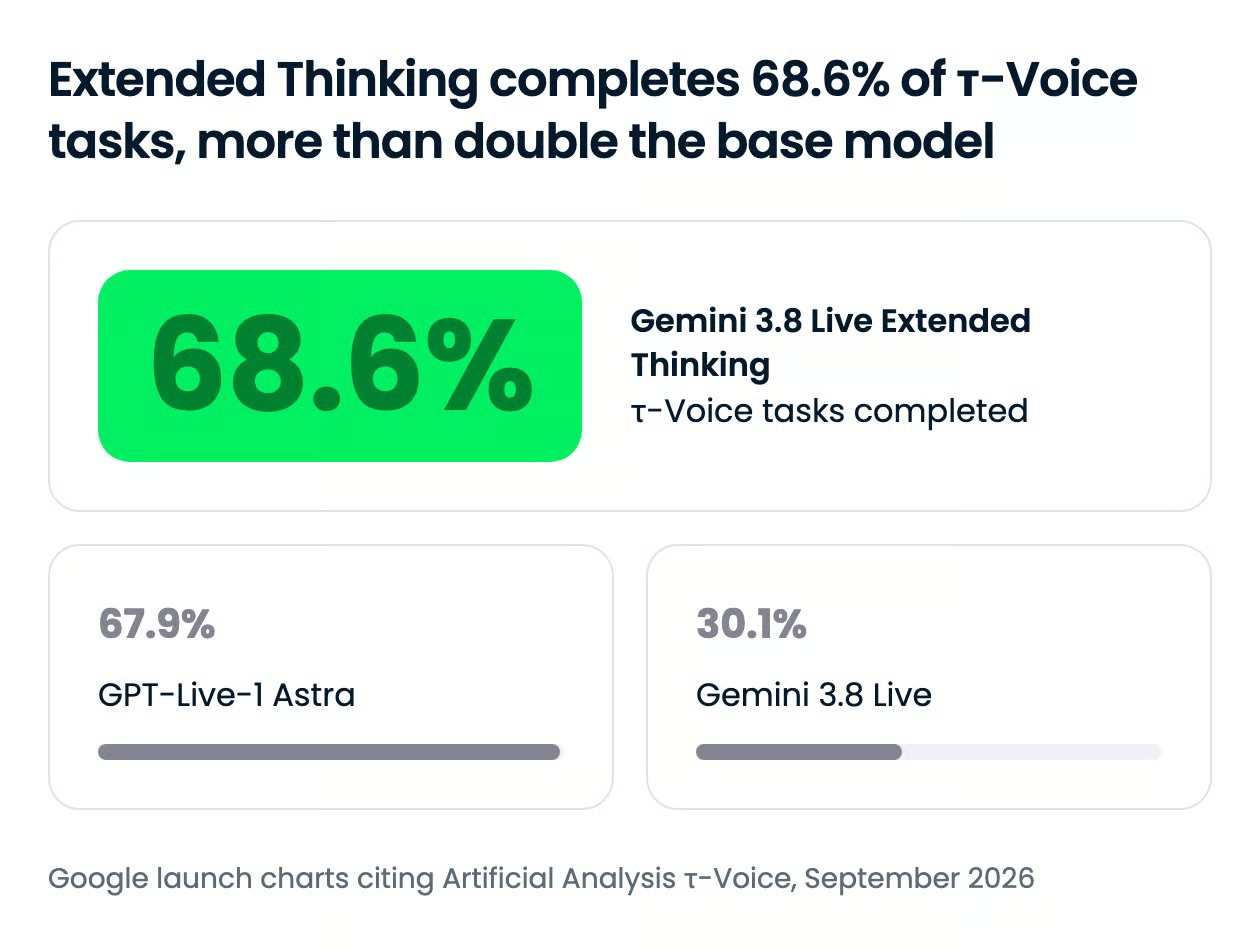
据 Artificial Analysis 测量,Gemini 3.8 Live Extended Thinking 在 Sierra 的 τ-Voice(评估语音代理是否能用工具完成多步骤任务)基准上领先。GPT-Live-1 Astra 紧随其后,其余对手则被甩开:
让我惊讶的是基础款在 τ-Voice 上的得分低于它自己的前代。谷歌明确表示 3.8 Live 面向规模化与成本效率而非复杂流程,但两款变体间 38 分以上的差距意味着分层选择并非细微取舍。若您的代理会串联调用工具,基础款就不是正确的默认项。
在 Sierra 的 τ³-Banking 榜单上(更严苛的银行业务客服基准),Extended Thinking 得分 35.1%,GPT-Live-1 Astra 为 32.0%,SpaceXAI 的 Grok Voice Think Fast 2.0 为 16.5%,Gemini 3.1 Flash Live 为 11.3%,GPT-Realtime 2 为 10.3%。该榜单上的所有模型大多仍以失败告终,这表明语音代理距离无人监管的银行业务还有距离,但相较上一代 Gemini 实现三倍提升,确实是进步。
在 Speech to Speech Index 上,Extended Thinking 也小幅领先:
领先 OpenAI 1.1 分终究是领先,但我不会仅凭此做采购决策。
对于纯粹的口语推理,谷歌报告 Extended Thinking 在 Big Bench Audio 上达到 97.7%。谷歌还报告称,两款模型在 ServiceNow 的 EVA-Bench 语音代理基准上推动了帕累托前沿,在准确性与对话质量间取得平衡,不过该测试是通过 Gemini Enterprise Agent Platform 调用 Live API 完成的,而非公共 API。
这是谷歌最希望您看到的图表。在 Artificial Analysis 的 Big Bench Audio 子集成本测试中,Gemini 3.8 Live 处理一小时输入音频仅需 $0.84。
Extended Thinking 同样一小时需 $3.50,Grok Voice Think Fast 2.0 为 $4.80,GPT-Live-1 Astra 为 $5.83。Gemini 3.1 Flash Live 则在不同思考等级下为 $1.50 与 $1.75。
将两条 Gemini 柱状一起看,产品策略一目了然。基础款以巨大优势压低全场价格,而在质量上对标 OpenAI 的推理款,每小时输入成本仍低 40%。需注意推理款在更高思考等级会消耗更多 token,这也是它与同价表的兄弟相比成本约为四倍的原因。
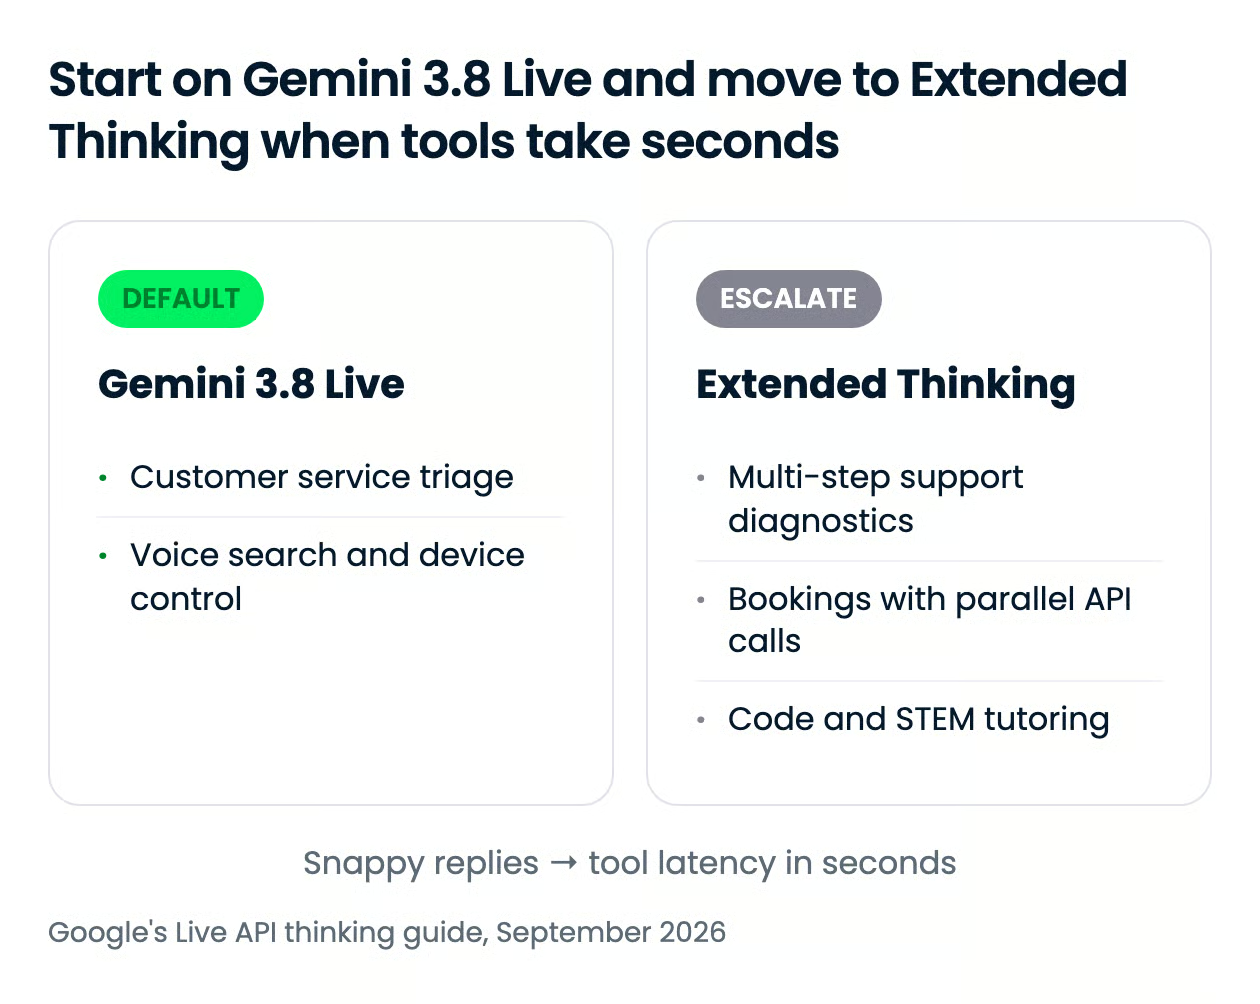
对大多数语音代理而言,Gemini 3.8 Live 是正确的默认选择;只有当代理需要规划、对比,或等待慢速工具时,Extended Thinking 才值得其更高的 token 消耗。谷歌的建议以工具时延为界:若函数在毫秒级返回,请留在基础款。
两种变体共享价格表(下文将介绍)、131,072 个输入与 65,536 个输出 token 上限,以及相同的 WebSocket 端点。区别在于推理架构。
Gemini 3.8 Live 使用交错推理,具固定时延特性,且完全没有 thinking_level 设置。Extended Thinking 则提供 low、medium、high 的后台推理等级,在工作时持续输出对话填充语,并要求异步工具。思考等级是此次发布中唯一的努力控制项。
| 使用场景 | 选择 | 原因 |
|---|---|---|
| 客服分诊、语音搜索、语言练习 | Gemini 3.8 Live | 轮次交互的即时性比深度更重要,且每次用户发言只需一次响应 |
| 智能设备控制、读取传感器数值 | Gemini 3.8 Live | 工具在毫秒级返回,无需掩护等待 |
| 跨日志、错误码与配置检查的技术支持 | Extended Thinking | 多步骤诊断需要在话语间进行后台推理 |
| 并行查询航班与酒店的旅行与预订代理 | Extended Thinking | 并行异步调用并以语音播报进度,替代沉默等待 |
| 理工与编程辅导 | Extended Thinking | 模型会在开口解释前先验证公式或调试代码 |
还有一点:客户端复杂度。迁移到 Extended Thinking 意味着需围绕 interaction_status 重写状态处理;因此若您已有可用的 3.1 Flash Live 应用,基础款是即插即用的升级,而推理款需要小幅重构。
两款模型共享 Gemini 3.1 Flash Live 预览的价目表,因此升级免费。在付费层,音频输入为每百万 token $3.00(谷歌估算约 $0.005/分钟),音频输出为每百万 token $12.00(约 $0.018/分钟)。思考 token 按输出费率计费,这也是 Extended Thinking 运行成本更高的原因。
| 模态 | 付费层(每百万 token) | 每分钟估算 |
|---|---|---|
| 文本输入 | $0.75 | n/a |
| 音频输入 | $3.00 | $0.005/min |
| 图像与视频输入 | $1.00 | $0.002/min |
| 文本输出 | $4.50 | n/a |
| 音频输出(含思考 token) | $12.00 | $0.018/min |
免费层覆盖两款模型的输入与输出,通常的前提是谷歌会使用免费层数据改进其产品;付费层数据不会用于该目的。
两种层级均支持结合 Google 搜索进行“落地”,每月在所有 Gemini 3.x 模型间共享 5,000 次免费搜索请求,之后每 1,000 次 $14。谷歌尚未公布针对这些模型的特定速率限制,因此在计划发布前,请查看您层级对应的 Gemini API 速率限制页面。
可用性分为三类:
两款模型的每段音频输出都带有 SynthID 水印,且谷歌的模型卡片坦诚其限制:模型仍可能发生幻觉、越狱防护仍在改进、偶尔可能出现变慢或超时。在将任一模型直接面向客户前,这些注意事项都值得一读。
模型 ID 分别为 gemini-3.8-live 与 gemini-3.8-live-extended-thinking,均为稳定字符串,无预览后缀。
您可以通过 Gemini Live API 搭配 google-genai 的 Python 或 JavaScript SDK 访问,也可通过原生 WebSocket,或在 Google AI Studio 的 Stream 视图中进行交互。谷歌还列出 Agora、Fishjam、LiveKit、LangChain、Pipecat、Vercel 与 Vision Agents 作为集成伙伴,负责媒体流层;若您已基于 ADK 构建,也有 Agent Development Kit 的流式路径可用。
下方最小 Python 会话示例会打开连接、发送一个文本轮次,并开启输出转录以便阅读模型说了什么:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
若您从 gemini-3.1-flash-live-preview 迁移,请更换模型字符串,并从设置中删除任何 thinking_level 或 thinking_config;其余轮次生命周期保持一致。Live API 默认是服务端到服务端,因此浏览器与移动端客户端需要临时令牌。
关于音频捕获、回放与会话管理的完整演练,请参见我们的 Gemini Live API 教程;同家族的文本侧内容,请参考我们的 Gemini 3.8 Flash API 教程,涵盖 Python 中的思考等级与函数调用。
谷歌此番的发力点在价格,而非绝对质量。Extended Thinking 相较 GPT-Live-1 Astra 在各榜单上仅领先一两分,但 Gemini 3.8 Live 以每小时输入音频 $0.84 的价格,几乎便宜 OpenAI 模型 7 倍——这才是决定生产语音流量流向的数字。
我的看法:若您在用 Gemini 3.1 Flash Live,请在本周升级,价格不变且仅异步工具调用这一项就值得。若您在用 OpenAI 的实时栈,基础款值得在分诊与搜索流程中试用;凡是工具需要数秒的场景,都值得试下 Extended Thinking。基础款在 τ-Voice 上的 30.1% 也正是不要把它用于任何代理性任务的理由。
若您希望正确打造语音代理的工具调用一侧,推荐我们的课程 Building AI Agents with Google ADK,其中将 Gemini 接入具备工具、护栏与分工能力的客服代理。
在 DataCamp 学习 Agentic AI!
Courses
Courses
Courses