Hadoop 专家需要编写应用程序并分析不断变化的数据,以获取洞察并维护数据安全。因此,招聘经理在筛选岗位匹配度时标准严格,可能会从基础到高级任意提问。
在本文中,我们收集了 24 道最常见的 Hadoop 面试题及其答案。
本文旨在帮助您为下一次大数据面试做充分准备,覆盖基础概念与高级场景。无论您是初学者还是有经验的专业人士,都能从中获得有价值的见解与实用信息,增强信心,提高成功率。
基础 Hadoop 面试题
面试官通常会从基础问题开始,以评估您对 Hadoop 以及其在大数据管理中作用的理解。
即使您是资深工程师,也请确保这些问题都已掌握。
1. 什么是大数据?
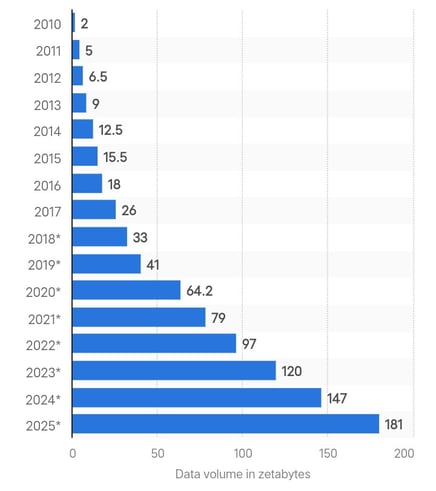
以泽字节计的全球数据生成量。来源:Statista。
大数据是指从多个来源以高速产生的海量复杂数据。2025 年全球创造的数据总量为 180 泽字节,预计到 2029 年将增长至三倍。
随着数据生成加速,传统分析方法无法实现实时处理和数据安全。因此,公司采用 Hadoop 等高级框架来处理和管理不断增长的数据量。
如果您想开启大数据职业生涯,请查看我们的大数据培训指南。
2. 什么是 Hadoop?它如何解决大数据问题?
Hadoop 是一个开源框架,用于处理分布在多台计算机上的大型数据集。它通过 Hadoop 分布式文件系统(HDFS)将数据以小块的形式存储在多台机器上。
借助 Hadoop,您可以向集群添加更多节点,在无需昂贵硬件升级的情况下处理海量数据。
即便是 Google 和 Facebook 这样的巨头,也依赖 Hadoop 来管理和分析每天从 TB 到 PB 级别的数据。
3. Hadoop 的两个主要组件是什么?
以下是 Hadoop 的两个主要组件:
- Hadoop 分布式文件系统(HDFS): 负责数据存储,将大文件切分为块(默认每块 128 MB),并分布到集群的多个节点上。
- MapReduce: Hadoop 依赖的编程模型,用于数据处理。它分为映射(map)和归约(reduce)两个阶段。映射将数据转换为另一组数据;归约接收映射作业输出的键值对作为输入,将其合并为更小的键值对,最终交由用户定义的 reduce 函数处理。
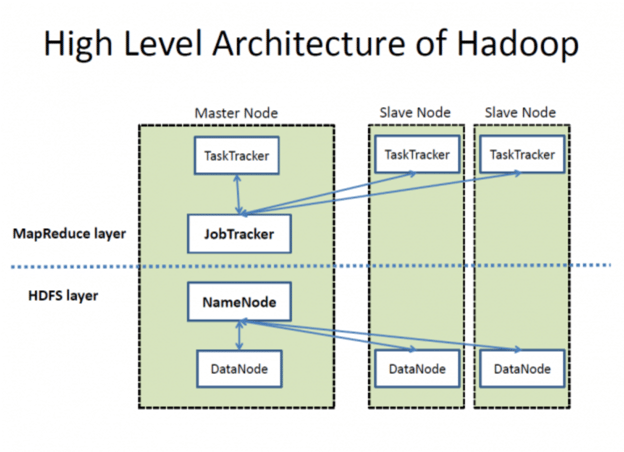
Hadoop 的高层架构。来源:维基媒体共享资源
4. 说明 Hadoop 中 NameNode 和 DataNode 的角色。
如上图所示,HDFS 由一个 NameNode 和多个 DataNode 组成以进行数据管理。它们的工作方式如下:
- 作为 HDFS 的主服务器,NameNode 处理打开、关闭、重命名文件等操作,并维护权限与数据块位置等元数据。
- DataNode 则作为工作节点,存储文件的实际数据块。客户端需要读写数据时,会从 NameNode 获取数据块的位置,随后直接与相应的 DataNode 通信以执行所需操作。
5. 解释 Hadoop YARN 的作用。
在 Hadoop 1.x 中,MapReduce 使用 JobTracker 处理资源管理和作业调度,但处理速度较慢是一个显著缺点。
Hadoop 2.0 引入了 YARN(Yet Another Resource Negotiator)来解决这些问题。YARN 将资源管理与作业调度解耦为独立组件,从而提升可扩展性与资源利用率。其主要组件包括:
- ResourceManager(RM):管理整个集群的资源。
- NodeManager(NM):管理各个节点的资源与监控。
- ApplicationMaster(AM):管理应用的生命周期,包括资源需求与执行。
YARN 的工作流程:
- 作业提交:客户端向 YARN 集群提交应用。
- 资源分配:ResourceManager 与 ApplicationMaster 协调开始分配资源。
- ApplicationMaster 注册:ApplicationMaster 向 ResourceManager 注册。
- 容器协商:ApplicationMaster 向 ResourceManager 申请容器(资源)。
- 容器启动:资源分配完成后,ApplicationMaster 指示各 NodeManager 启动容器。
- 应用执行:应用代码在分配的容器内执行。
中级 Hadoop 面试题
中级问题更侧重于评估您对 Hadoop 框架技术细节的了解。面试官可能会询问有关 Hadoop 集群、其挑战以及不同版本之间的对比。
6. 什么是 Hadoop 集群?公司是否偏好特定的集群规模?
Hadoop 集群是由互联的主从节点构成的集合,旨在以分布式方式存储与处理大型数据集。该架构确保高可用性、可扩展性与容错性。
Hadoop 集群的组件:
- 主节点:这些节点管理集群资源与分布式文件系统。关键组件包括:
- NameNode:管理 HDFS 命名空间并调节客户端对文件的访问。
- ResourceManager:管理运行应用所需的资源分配。
- 从节点:这些节点负责存储数据与执行计算。关键组件包括:
- DataNode:在 HDFS 中存储实际数据块。
- NodeManager:管理该节点上的容器执行。
搭建 Hadoop 集群主要有两种方式:
- 本地部署集群:使用通用硬件组件构建集群。此方式可控性强,可根据具体需求进行定制,且具有成本效益。
- 云端集群:选择 Amazon EMR、Google Cloud Dataproc 或 Azure HDInsight 等云服务。该方式灵活、可扩展,且运维开销更低。
本地与云端集群对比:
|
特性
|
本地部署集群
|
云端集群
|
|
部署成本
|
初始投入较高
|
按需付费模式
|
|
可扩展性
|
受物理硬件限制
|
几乎无限
|
|
维护
|
需内部团队运维
|
由云服务商托管
|
|
灵活性
|
硬件与软件可深度自定义
|
预配置选项
|
|
部署时间
|
搭建周期更长
|
部署快速便捷
|
对集群规模没有特定偏好。集群规模可轻松扩展,完全取决于存储需求。小公司可能使用约 20 个节点的集群,而像 Yahoo 这样的企业(过去)则运行过多达包含 40,000 个节点的超大集群。
7. Hadoop 生态系统有哪些项目?
不同行业有各自特定的数据分析与处理需求,因此 Hadoop 在其生态中推出了众多项目以提供相应解决方案。Hadoop 项目的名单远超您想象——以下是最重要的一些:
- MapReduce:用于以并行、分布式算法处理大型数据集的编程模型。
- Apache Hive:用于数据汇总、查询与分析的数据仓库基础设施,使用 HiveQL。
- Apache HBase:可扩展的大数据存储,提供对大型数据集的实时读写访问。
- Apache Pig:使用 Pig Latin 创建 MapReduce 程序的高级平台。
- Apache Sqoop:在 Hadoop 与结构化数据存储(如关系型数据库)之间传输海量数据的工具。
- Apache Flume:高效收集、聚合并传输海量日志数据的服务。
- Apache Oozie:用于管理 Hadoop 作业及其依赖关系的工作流调度系统。
- Apache Zookeeper:维护配置信息并提供分布式同步的集中式服务。
- Apache Spark:快速、通用的集群计算系统,支持内存计算。
- Apache Storm:用于处理大规模数据流的实时计算系统。
- Apache Kafka:用于处理实时数据馈送的分布式流平台。
8. Hadoop 面临的常见挑战有哪些?
尽管 Hadoop 框架在管理与处理海量数据方面表现出色,但也存在一些关键挑战。
具体如下:
- 最大的问题是 NameNode 存在单点故障,一旦失败会导致数据丢失。
- Hadoop 易受安全威胁。您无法直接控制数据,也无法确认是否被滥用。
- Hadoop 的 MapReduce 框架采用批处理方式,不支持实时数据处理。
- 该框架适用于大容量数据,但无法高效处理小文件。当数据小于 HDFS 默认块大小时,会加重 NameNode 负载并引发延迟问题。
9. 什么是 HBase?其组件分别承担什么角色?
HBase 是一种为快速访问大文件而设计的数据库。它按列存储数据,并以唯一行键建立索引,可对超大数据集进行实时读写。
这种设计实现了快速的数据检索与高效扫描,适合大而稀疏的表,因为我们可以按需增加节点。
HBase 包含三个组件:
- HMaster: 管理 RegionServer,负责创建与删除表。
- RegionServer: 处理读写请求并管理 region 拆分。
- ZooKeeper: 维护集群状态并管理服务器分配。
10. Hadoop 2.0 与 Hadoop 1.x 有何不同?
下表对两代 Hadoop 版本进行并列比较:
|
对比维度
|
Hadoop 1.x
|
Hadoop 2.0
|
|
NameNode 管理
|
由单个 NameNode 管理命名空间
|
通过 HDFS 联邦由多个 NameNode 管理命名空间
|
|
操作系统支持
|
不支持 Microsoft Windows
|
新增对 Microsoft 的支持
|
|
作业与资源管理
|
使用 JobTracker 与 TaskTracker 管理作业与资源
|
以 YARN 取代并分离两类任务
|
|
可扩展性
|
每个集群可扩展至 4,000 个节点
|
每个集群可扩展至 10,000 个节点
|
|
DataNode 块大小
|
数据块大小为 64 MB
|
增至 128 MB
|
|
任务执行
|
使用槽位(slot),可运行 Map 或 Reduce 任务之一
|
使用容器(container),可运行任意任务
|
如果您正在申请数据工程岗位,欢迎阅读我们关于数据工程面试题的深度文章。
高级 Hadoop 面试题
现在进入更有挑战的部分。这些问题用于考察您的高级水平,尤其适合应聘高级工程师时重点关注。
11. Hadoop 2.0 中的主动 NameNode 与备用 NameNode 的概念是什么?
在 Hadoop 2.0 中,主动(Active)NameNode 负责管理文件系统命名空间并控制客户端对文件的访问;而备用(Standby)NameNode 作为备份,维护足够的信息以便在主动 NameNode 发生故障时接管。
这解决了在 Hadoop 1.x 中常见的单点故障(SPOF)问题。
12. Hadoop 中分布式缓存的目的是什么?为什么 HDFS 无法高效读取小文件?
HDFS 在处理成千上万的小文件时效率低下,导致延迟增加。因此,分布式缓存允许您存储只读、归档与 jar 文件,并将其提供给 MapReduce 任务使用。
假设您需要在 MapReduce 中运行 40 个作业,每个作业都要从 HDFS 访问同一文件。在实际场景中,读取次数可能增长到数百甚至上千。应用会频繁定位这些文件,给 HDFS 带来过载并影响性能。
而分布式缓存可以高效处理大量小文件,同时不牺牲访问时间与处理速度。
13. 解释校验和在检测数据损坏中的作用。同时,说明标准的差错检测码。
校验和用于识别 HDFS 中的损坏数据。数据进入系统时会生成一个称为校验和的小值。当用户请求传输数据时,Hadoop 会重新计算校验和。若新旧校验和一致,则数据完好;否则数据已损坏。
Hadoop 使用的差错检测码为 CRC-32。
14. HDFS 如何实现容错?
HDFS 通过副本机制实现可靠性与可用性。其复制过程如下:
- 初始块分布: 保存文件时,HDFS 将其切分为数据块并分配到不同 DataNode。例如,一个被切为 A、B、C 的文件,可能分别存放在 A1、B2、C3 这几个 DataNode 上。
- 副本复制: 持有某块的 DataNode 会将该块复制到集群中的其他 DataNode。例如,持有块 A 的 A1 会在 D1 与 D2 上创建副本。这样即使 A1 宕机,D1 与 D2 上的副本仍可用。
- 故障处理: 若 D1 失败,您可以从其他 DataNode(如 B2、C3)检索所需的块(B 与 C)。
15. MapReduce 能处理压缩文件吗?如果可以,支持哪些格式?它们可分片吗?
可以,MapReduce 能处理压缩文件。Hadoop 支持多种压缩格式,但并非所有格式都可分片。
MapReduce 支持的格式包括:
- DEFLATE
- gzip
- bzip2
- LZO
- LZ4
- Snappy
在这些格式中,只有 bzip2 可分片。
HDFS 会将超大文件切分为 128 MB 的小块。例如,1.28 GB 的文件会被拆分为 10 个数据块。每个数据块由一个独立的 mapper 在 MapReduce 作业中处理。但若文件不可分片,将由一个 mapper 处理整个文件。
Hive 面试题
有些岗位要求具备 Hive 与 Hadoop 的集成能力。在这类岗位中,招聘经理会重点关注以下问题:
16. 定义 Hive。
Hive 是一个数据仓库系统,可执行批处理作业与数据分析。它由 Facebook 开发,用于在存储于 HDFS 的海量数据上运行类 SQL 查询,而无需依赖 Java。
借助 Hive,我们可以将数据组织为表,并使用 metastore 存储架构等元数据。它支持多种存储系统,如 S3、Azure Data Lake Storage(ADLS)和 Google Cloud Storage。
Hive Metastore(HMS)是一个集中式的元数据库。它包含存储于 HDFS 对象存储中的表、视图与访问权限等信息。
Hive Metastore 的表有两种类型:
- 托管 Metastore: 该表由 Hive 服务 JVM 存储与管理。我们可通过默认路径
/user/hive/warehouse 定位这些表。
- 外部 Metastore: 这些表运行在外部 JVM 上,因此 Hive 元数据的变更不会影响其中存储的数据。
18. Hive 支持哪些编程语言?
Hive 提供对多种编程语言的良好集成,增强了其在不同应用中的通用性与可用性:
- Python: 数据分析与机器学习。
- Java: 企业应用与自定义数据处理。
- C++: 性能关键型应用与自定义 SerDe。
- PHP: 访问 Hive 数据的 Web 应用。
19. Hive 能处理的最大数据规模是多少?
由于与 HDFS 的集成与可扩展架构,Hive 能处理 PB 级数据。它在可管理的数据规模上没有固定上限,是大数据处理与分析的强大工具。
20. Hive 中有多少种数据类型?
Hive 提供了丰富的数据类型以满足不同的数据需求:
- 内置数据类型: 数值、字符串、日期/时间及其他基础类型,用于基本数据存储。
- 复杂数据类型: ARRAY、MAP、STRUCT 与 UNIONTYPE,用于更高级、结构化的数据表示。
内置数据类型:
|
类别
|
数据类型
|
描述
|
示例
|
|
数值类型
|
TINYINT
|
1 字节有符号整数
|
127
|
| |
SMALLINT
|
2 字节有符号整数
|
32767
|
| |
INT
|
4 字节有符号整数
|
2147483647
|
| |
BIGINT
|
8 字节有符号整数
|
9223372036854775807
|
| |
FLOAT
|
单精度浮点数
|
3.14
|
| |
DOUBLE
|
双精度浮点数
|
3.141592653589793
|
| |
DECIMAL
|
任意精度有符号十进制数
|
1234567890.1234567890
|
|
字符串类型
|
STRING
|
可变长度字符串
|
'Hello, World!'
|
| |
VARCHAR
|
具有最大长度的可变长度字符串
|
'Example'
|
| |
CHAR
|
定长字符串
|
'A'
|
|
日期/时间类型
|
TIMESTAMP
|
包含时区的日期与时间
|
'2023-01-01 12:34:56'
|
| |
DATE
|
不含时间的日期
|
'2023-01-01'
|
| |
INTERVAL
|
时间间隔
|
INTERVAL '1' DAY
|
|
其他类型
|
BOOLEAN
|
表示 true 或 false
|
TRUE
|
| |
BINARY
|
字节序列
|
0x1A2B3C
|
复杂数据类型:
|
数据类型
|
描述
|
示例
|
|
ARRAY
|
有序的元素集合
|
ARRAY<STRING> ('apple', 'banana', 'cherry')
|
|
MAP
|
键值对集合
|
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
|
|
STRUCT
|
由不同数据类型字段组成的集合
|
STRUCT<name: STRING, age: INT> ('Alice', 30)
|
|
UNIONTYPE
|
可容纳多种指定类型中的任意一种
|
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three')
|
面向大数据工程师的场景题
这些问题考察您使用 Hadoop 处理真实问题的能力。若您申请数据架构师岗位尤其相关,但凡需要 Hadoop 知识的面试流程都可能涉及。
21. 您正在使用 Hadoop 的副本机制搭建一个 HDFS 集群。集群有三个机架:A、B、C。说明 Hadoop 将如何复制名为 datafile.text 的文件。
Hadoop 将按如下方式复制数据:
- 第一份副本放在机架 A: Hadoop 会在机架 A 中随机选择一个节点放置初始副本。此举通过选择本地或邻近节点来最小化写入延迟。
- 第二份副本放在机架 B: 第二份副本会放在另一机架(如机架 B)的某个节点上。这样即使机架 A 故障也不会丢失数据,从而提升容错性。
- 第三份副本放在机架 B: 第三份副本放在机架 B 的另一个节点上。与第二份副本放在同一机架有助于在机架间平衡网络负载并减少跨机架流量。
Hadoop 在含有三个机架(A、B、C)的 HDFS 集群中的副本策略,旨在优化负载分布、增强容错并提升网络效率。如此,datafile.text 的复制兼顾了性能与可靠性。
22. 您正在开发一个基于 Hadoop 的应用,使用 LocalFileSystem 操作文件。如何通过校验和保障数据完整性?
在 Hadoop 的 LocalFileSystem 中使用校验和可通过以下方式保障数据完整性:
- 生成校验和: 在写入文件时为数据块自动创建校验和。
- 存储校验和: 将校验和保存在同一目录下隐藏的
.filename.crc 文件中。
- 校验校验和: 读取时将存储的校验和与实际数据进行比对。
- 发现不一致: 如有不一致则抛出
ChecksumException。
遵循以上步骤,可确保应用维护数据完整性,并能够及时发现潜在的数据损坏。
23. 假设您在调试一个跨多节点的大规模 Hadoop 作业,出现了影响输出的异常情况。您会如何处理?
可按以下步骤进行:
- 记录潜在问题: 使用调试语句将潜在问题记录到
stderr。
- 更新任务状态: 在任务状态消息中包含错误日志位置。
- 自定义计数器: 实施计数器以跟踪并分析异常情况。
- 映射输出调试: 将调试信息写入 map 的输出。
- 日志分析程序: 创建一个 MapReduce 程序用于详细的日志分析。
通过这些步骤,我们可以系统性地调试大规模 Hadoop 作业,高效跟踪并解决影响输出的异常情况。
24. 您在使用 YARN 为 Hadoop 集群计算内存设置。请说明如何为 NodeManager 和 MapReduce 作业设置内存。
在使用 YARN 为 Hadoop 集群配置内存时,需要在 Hadoop 守护进程、系统进程与 NodeManager 之间平衡内存分配,以优化性能与资源利用率。
为 NodeManager 设置内存:
- 计算节点物理内存总量: 确定集群中每个节点可用的物理内存总量。例如,若节点有 64 GB 内存,则总物理内存为 64,000 MB。
- 预留 Hadoop 守护进程内存: 为运行在该节点上的 Hadoop 守护进程(如 DataNode 与 NodeManager)分配内存。通常每个守护进程 1000–2000 MB 即可。例如 DataNode 与 NodeManager 各分配 1500 MB,则需预留 3000 MB。
- 预留系统进程内存: 为其他系统进程与后台服务留出内存,以确保操作系统与关键服务稳定运行。典型预留约为 2 GB(2000 MB)。
- 剩余内存用于 NodeManager: 用总物理内存减去为守护进程与系统进程预留的内存,得到 NodeManager 可用于分配给容器的内存。
为 MapReduce 作业设置内存:
- 调整
mapreduce.map.memory.mb: 定义每个 map 任务的内存分配量。根据 map 任务的内存需求进行设置。
- 例如将
mapreduce.map.memory.mb 设为 2048 MB,表示每个 map 任务分配 2 GB 内存。
- 调整
mapreduce.reduce.memory.mb: 定义每个 reduce 任务的内存分配量。根据 reduce 任务的内存需求进行设置。
- 例如将
mapreduce.reduce.memory.mb 设为 4096 MB,表示每个 reduce 任务分配 4 GB 内存。
- 配置容器大小: 在
yarn-site.xml 中适当设置容器大小参数,如 yarn.nodemanager.resource.memory-mb,与分配给 NodeManager 的内存保持一致。
- 例如,若 NodeManager 可用 59,000 MB,可将
yarn.nodemanager.resource.memory-mb 设为 59,000 MB。
内存配置摘要:
|
组件
|
配置项
|
示例值
|
|
NodeManager
|
物理内存总量
|
64,000 MB
|
| |
Hadoop 守护进程内存
|
3000 MB
|
| |
系统进程内存
|
2000 MB
|
| |
NodeManager 可用内存
|
59,000 MB
|
|
MapReduce map 任务
|
mapreduce.map.memory.mb
|
2048 MB
|
|
MapReduce reduce 任务
|
mapreduce.reduce.memory.mb
|
4096 MB
|
|
容器大小
|
yarn.nodemanager.resource.memory-mb
|
59,000 MB
|
结语
理解这些问题后,您应当已经掌握基础术语,并且对
真实世界 Hadoop 应用的复杂性有了深入把握。此外,您还需要不断适应基于 Hadoop 的新项目,以保持竞争力并在面试中脱颖而出。
您也可以拓展对其他大数据框架的了解,如 Spark 和 Flink,它们通常更快、延迟更低。
如果您希望通过结构化路径系统掌握大数据,推荐以下资源:
- Big Data Fundamentals with PySpark:这门课程是学习 PySpark 大数据处理基础的绝佳起点。
- Big Data with PySpark:该学习路径全面介绍使用 PySpark 的大数据概念,涵盖数据处理、机器学习等内容。


Hadoop 专家需要编写应用程序并分析不断变化的数据,以获取洞察并维护数据安全。因此,招聘经理在筛选岗位匹配度时标准严格,可能会从基础到高级任意提问。
在本文中,我们收集了 24 道最常见的 Hadoop 面试题及其答案。
本文旨在帮助您为下一次大数据面试做充分准备,覆盖基础概念与高级场景。无论您是初学者还是有经验的专业人士,都能从中获得有价值的见解与实用信息,增强信心,提高成功率。
基础 Hadoop 面试题
面试官通常会从基础问题开始,以评估您对 Hadoop 以及其在大数据管理中作用的理解。
即使您是资深工程师,也请确保这些问题都已掌握。
1. 什么是大数据?
以泽字节计的全球数据生成量。来源:Statista。
大数据是指从多个来源以高速产生的海量复杂数据。2025 年全球创造的数据总量为 180 泽字节,预计到 2029 年将增长至三倍。
随着数据生成加速,传统分析方法无法实现实时处理和数据安全。因此,公司采用 Hadoop 等高级框架来处理和管理不断增长的数据量。
如果您想开启大数据职业生涯,请查看我们的大数据培训指南。
2. 什么是 Hadoop?它如何解决大数据问题?
Hadoop 是一个开源框架,用于处理分布在多台计算机上的大型数据集。它通过 Hadoop 分布式文件系统(HDFS)将数据以小块的形式存储在多台机器上。
借助 Hadoop,您可以向集群添加更多节点,在无需昂贵硬件升级的情况下处理海量数据。
即便是 Google 和 Facebook 这样的巨头,也依赖 Hadoop 来管理和分析每天从 TB 到 PB 级别的数据。
3. Hadoop 的两个主要组件是什么?
以下是 Hadoop 的两个主要组件:
Hadoop 的高层架构。来源:维基媒体共享资源
4. 说明 Hadoop 中 NameNode 和 DataNode 的角色。
如上图所示,HDFS 由一个 NameNode 和多个 DataNode 组成以进行数据管理。它们的工作方式如下:
5. 解释 Hadoop YARN 的作用。
在 Hadoop 1.x 中,MapReduce 使用 JobTracker 处理资源管理和作业调度,但处理速度较慢是一个显著缺点。
Hadoop 2.0 引入了 YARN(Yet Another Resource Negotiator)来解决这些问题。YARN 将资源管理与作业调度解耦为独立组件,从而提升可扩展性与资源利用率。其主要组件包括:
YARN 的工作流程:
中级 Hadoop 面试题
中级问题更侧重于评估您对 Hadoop 框架技术细节的了解。面试官可能会询问有关 Hadoop 集群、其挑战以及不同版本之间的对比。
6. 什么是 Hadoop 集群?公司是否偏好特定的集群规模?
Hadoop 集群是由互联的主从节点构成的集合,旨在以分布式方式存储与处理大型数据集。该架构确保高可用性、可扩展性与容错性。
Hadoop 集群的组件:
搭建 Hadoop 集群主要有两种方式:
本地与云端集群对比:
特性
本地部署集群
云端集群
部署成本
初始投入较高
按需付费模式
可扩展性
受物理硬件限制
几乎无限
维护
需内部团队运维
由云服务商托管
灵活性
硬件与软件可深度自定义
预配置选项
部署时间
搭建周期更长
部署快速便捷
对集群规模没有特定偏好。集群规模可轻松扩展,完全取决于存储需求。小公司可能使用约 20 个节点的集群,而像 Yahoo 这样的企业(过去)则运行过多达包含 40,000 个节点的超大集群。
7. Hadoop 生态系统有哪些项目?
不同行业有各自特定的数据分析与处理需求,因此 Hadoop 在其生态中推出了众多项目以提供相应解决方案。Hadoop 项目的名单远超您想象——以下是最重要的一些:
8. Hadoop 面临的常见挑战有哪些?
尽管 Hadoop 框架在管理与处理海量数据方面表现出色,但也存在一些关键挑战。
具体如下:
9. 什么是 HBase?其组件分别承担什么角色?
HBase 是一种为快速访问大文件而设计的数据库。它按列存储数据,并以唯一行键建立索引,可对超大数据集进行实时读写。
这种设计实现了快速的数据检索与高效扫描,适合大而稀疏的表,因为我们可以按需增加节点。
HBase 包含三个组件:
10. Hadoop 2.0 与 Hadoop 1.x 有何不同?
下表对两代 Hadoop 版本进行并列比较:
对比维度
Hadoop 1.x
Hadoop 2.0
NameNode 管理
由单个 NameNode 管理命名空间
通过 HDFS 联邦由多个 NameNode 管理命名空间
操作系统支持
不支持 Microsoft Windows
新增对 Microsoft 的支持
作业与资源管理
使用 JobTracker 与 TaskTracker 管理作业与资源
以 YARN 取代并分离两类任务
可扩展性
每个集群可扩展至 4,000 个节点
每个集群可扩展至 10,000 个节点
DataNode 块大小
数据块大小为 64 MB
增至 128 MB
任务执行
使用槽位(slot),可运行 Map 或 Reduce 任务之一
使用容器(container),可运行任意任务
如果您正在申请数据工程岗位,欢迎阅读我们关于数据工程面试题的深度文章。
高级 Hadoop 面试题
现在进入更有挑战的部分。这些问题用于考察您的高级水平,尤其适合应聘高级工程师时重点关注。
11. Hadoop 2.0 中的主动 NameNode 与备用 NameNode 的概念是什么?
在 Hadoop 2.0 中,主动(Active)NameNode 负责管理文件系统命名空间并控制客户端对文件的访问;而备用(Standby)NameNode 作为备份,维护足够的信息以便在主动 NameNode 发生故障时接管。
这解决了在 Hadoop 1.x 中常见的单点故障(SPOF)问题。
12. Hadoop 中分布式缓存的目的是什么?为什么 HDFS 无法高效读取小文件?
HDFS 在处理成千上万的小文件时效率低下,导致延迟增加。因此,分布式缓存允许您存储只读、归档与 jar 文件,并将其提供给 MapReduce 任务使用。
假设您需要在 MapReduce 中运行 40 个作业,每个作业都要从 HDFS 访问同一文件。在实际场景中,读取次数可能增长到数百甚至上千。应用会频繁定位这些文件,给 HDFS 带来过载并影响性能。
而分布式缓存可以高效处理大量小文件,同时不牺牲访问时间与处理速度。
13. 解释校验和在检测数据损坏中的作用。同时,说明标准的差错检测码。
校验和用于识别 HDFS 中的损坏数据。数据进入系统时会生成一个称为校验和的小值。当用户请求传输数据时,Hadoop 会重新计算校验和。若新旧校验和一致,则数据完好;否则数据已损坏。
Hadoop 使用的差错检测码为 CRC-32。
14. HDFS 如何实现容错?
HDFS 通过副本机制实现可靠性与可用性。其复制过程如下:
15. MapReduce 能处理压缩文件吗?如果可以,支持哪些格式?它们可分片吗?
可以,MapReduce 能处理压缩文件。Hadoop 支持多种压缩格式,但并非所有格式都可分片。
MapReduce 支持的格式包括:
在这些格式中,只有 bzip2 可分片。
HDFS 会将超大文件切分为 128 MB 的小块。例如,1.28 GB 的文件会被拆分为 10 个数据块。每个数据块由一个独立的 mapper 在 MapReduce 作业中处理。但若文件不可分片,将由一个 mapper 处理整个文件。
Hive 面试题
有些岗位要求具备 Hive 与 Hadoop 的集成能力。在这类岗位中,招聘经理会重点关注以下问题:
16. 定义 Hive。
Hive 是一个数据仓库系统,可执行批处理作业与数据分析。它由 Facebook 开发,用于在存储于 HDFS 的海量数据上运行类 SQL 查询,而无需依赖 Java。
借助 Hive,我们可以将数据组织为表,并使用 metastore 存储架构等元数据。它支持多种存储系统,如 S3、Azure Data Lake Storage(ADLS)和 Google Cloud Storage。
17. 什么是 Hive Metastore(HMS)?如何区分托管 Metastore 与外部 Metastore?
Hive Metastore(HMS)是一个集中式的元数据库。它包含存储于 HDFS 对象存储中的表、视图与访问权限等信息。
Hive Metastore 的表有两种类型:
/user/hive/warehouse定位这些表。18. Hive 支持哪些编程语言?
Hive 提供对多种编程语言的良好集成,增强了其在不同应用中的通用性与可用性:
19. Hive 能处理的最大数据规模是多少?
由于与 HDFS 的集成与可扩展架构,Hive 能处理 PB 级数据。它在可管理的数据规模上没有固定上限,是大数据处理与分析的强大工具。
20. Hive 中有多少种数据类型?
Hive 提供了丰富的数据类型以满足不同的数据需求:
内置数据类型:
类别
数据类型
描述
示例
数值类型
TINYINT
1 字节有符号整数
127
SMALLINT
2 字节有符号整数
32767
INT
4 字节有符号整数
2147483647
BIGINT
8 字节有符号整数
9223372036854775807
FLOAT
单精度浮点数
3.14
DOUBLE
双精度浮点数
3.141592653589793
DECIMAL
任意精度有符号十进制数
1234567890.1234567890
字符串类型
STRING
可变长度字符串
'Hello, World!'
VARCHAR
具有最大长度的可变长度字符串
'Example'
CHAR
定长字符串
'A'
日期/时间类型
TIMESTAMP
包含时区的日期与时间
'2023-01-01 12:34:56'
DATE
不含时间的日期
'2023-01-01'
INTERVAL
时间间隔
INTERVAL '1' DAY
其他类型
BOOLEAN
表示 true 或 false
TRUE
BINARY
字节序列
0x1A2B3C
复杂数据类型:
数据类型
描述
示例
ARRAY
有序的元素集合
ARRAY<STRING> ('apple', 'banana', 'cherry')
MAP
键值对集合
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
STRUCT
由不同数据类型字段组成的集合
STRUCT<name: STRING, age: INT> ('Alice', 30)
UNIONTYPE
可容纳多种指定类型中的任意一种
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three')
面向大数据工程师的场景题
这些问题考察您使用 Hadoop 处理真实问题的能力。若您申请数据架构师岗位尤其相关,但凡需要 Hadoop 知识的面试流程都可能涉及。
21. 您正在使用 Hadoop 的副本机制搭建一个 HDFS 集群。集群有三个机架:A、B、C。说明 Hadoop 将如何复制名为 datafile.text 的文件。
Hadoop 将按如下方式复制数据:
Hadoop 在含有三个机架(A、B、C)的 HDFS 集群中的副本策略,旨在优化负载分布、增强容错并提升网络效率。如此,
datafile.text的复制兼顾了性能与可靠性。22. 您正在开发一个基于 Hadoop 的应用,使用 LocalFileSystem 操作文件。如何通过校验和保障数据完整性?
在 Hadoop 的
LocalFileSystem中使用校验和可通过以下方式保障数据完整性:.filename.crc文件中。ChecksumException。遵循以上步骤,可确保应用维护数据完整性,并能够及时发现潜在的数据损坏。
23. 假设您在调试一个跨多节点的大规模 Hadoop 作业,出现了影响输出的异常情况。您会如何处理?
可按以下步骤进行:
stderr。通过这些步骤,我们可以系统性地调试大规模 Hadoop 作业,高效跟踪并解决影响输出的异常情况。
24. 您在使用 YARN 为 Hadoop 集群计算内存设置。请说明如何为 NodeManager 和 MapReduce 作业设置内存。
在使用 YARN 为 Hadoop 集群配置内存时,需要在 Hadoop 守护进程、系统进程与 NodeManager 之间平衡内存分配,以优化性能与资源利用率。
为 NodeManager 设置内存:
为 MapReduce 作业设置内存:
mapreduce.map.memory.mb: 定义每个 map 任务的内存分配量。根据 map 任务的内存需求进行设置。mapreduce.map.memory.mb设为 2048 MB,表示每个 map 任务分配 2 GB 内存。mapreduce.reduce.memory.mb: 定义每个 reduce 任务的内存分配量。根据 reduce 任务的内存需求进行设置。mapreduce.reduce.memory.mb设为 4096 MB,表示每个 reduce 任务分配 4 GB 内存。yarn-site.xml中适当设置容器大小参数,如yarn.nodemanager.resource.memory-mb,与分配给 NodeManager 的内存保持一致。yarn.nodemanager.resource.memory-mb设为 59,000 MB。内存配置摘要:
组件
配置项
示例值
NodeManager
物理内存总量
64,000 MB
Hadoop 守护进程内存
3000 MB
系统进程内存
2000 MB
NodeManager 可用内存
59,000 MB
MapReduce map 任务
mapreduce.map.memory.mb
2048 MB
MapReduce reduce 任务
mapreduce.reduce.memory.mb
4096 MB
容器大小
yarn.nodemanager.resource.memory-mb
59,000 MB
结语
理解这些问题后,您应当已经掌握基础术语,并且对
真实世界 Hadoop 应用的复杂性有了深入把握。此外,您还需要不断适应基于 Hadoop 的新项目,以保持竞争力并在面试中脱颖而出。
您也可以拓展对其他大数据框架的了解,如 Spark 和 Flink,它们通常更快、延迟更低。
如果您希望通过结构化路径系统掌握大数据,推荐以下资源: