
Cursus
Big Data Fundamentals met PySpark
4 uur
67K
Oefen en volg je voortgang.
Ga Verder Met GoogleHadoop-experts schrijven applicaties en analyseren continu veranderende data om inzichten te verkrijgen en databeveiliging te waarborgen. Daarom hanteren hiring managers strenge criteria om de beste match voor de functie te vinden en kunnen ze je alles vragen, van basis tot geavanceerd.
In dit artikel hebben we de 24 meest gestelde Hadoop-sollicitatievragen en -antwoorden verzameld.
Dit artikel helpt je grondig voorbereiden op je volgende bigdata-sollicitatie. Het behandelt fundamentele concepten en geavanceerde scenario's. Of je nu een beginner of een ervaren professional bent, je vindt er waardevolle inzichten en praktische informatie om je zelfvertrouwen te vergroten en je kansen op succes te verbeteren.
Interviewers beginnen meestal met basisvragen om je begrip van Hadoop en de relevantie ervan bij het beheren van big data te toetsen.
Zelfs als je een ervaren engineer bent, zorg dat je deze vragen beheerst.
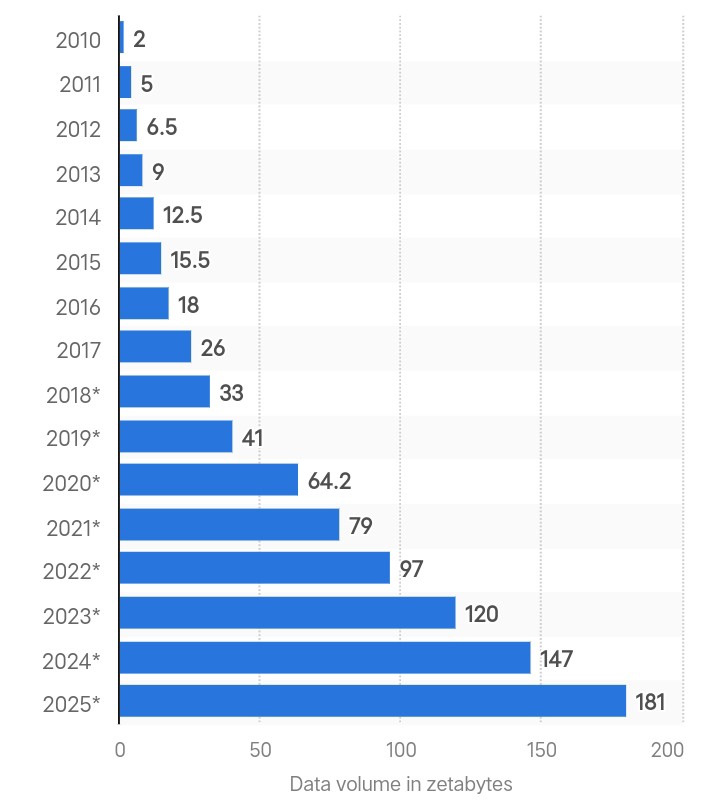
Wereldwijde datacreatie in zettabytes. Bron: Statista.
Big data verwijst naar enorme hoeveelheden complexe data die met hoge snelheid uit meerdere bronnen worden gegenereerd. De totale hoeveelheid wereldwijd gecreëerde data bedroeg 180 zettabyte in 2025 en zal naar verwachting verdrievoudigen tegen 2029.
Naarmate datageneratie versnelt, schieten traditionele analysemethoden tekort voor realtime verwerking en databeveiliging. Daarom gebruiken bedrijven geavanceerde frameworks zoals Hadoop om groeiende datavolumes te verwerken en te beheren.
Wil je je carrière in big data starten? Bekijk dan onze gids voor bigdata-training.
Hadoop is een open-source framework voor het verwerken van grote datasets die over meerdere computers zijn verdeeld. Het slaat data op verschillende machines op als kleine blokken met behulp van het Hadoop Distributed File System (HDFS).
Met Hadoop kun je meer nodes toevoegen aan een cluster en grote hoeveelheden data verwerken zonder dure hardware-upgrades.
Zelfs grote bedrijven zoals Google en Facebook vertrouwen op Hadoop om dagelijks terabytes tot petabytes aan data te beheren en te analyseren.
De twee belangrijkste componenten van Hadoop zijn:
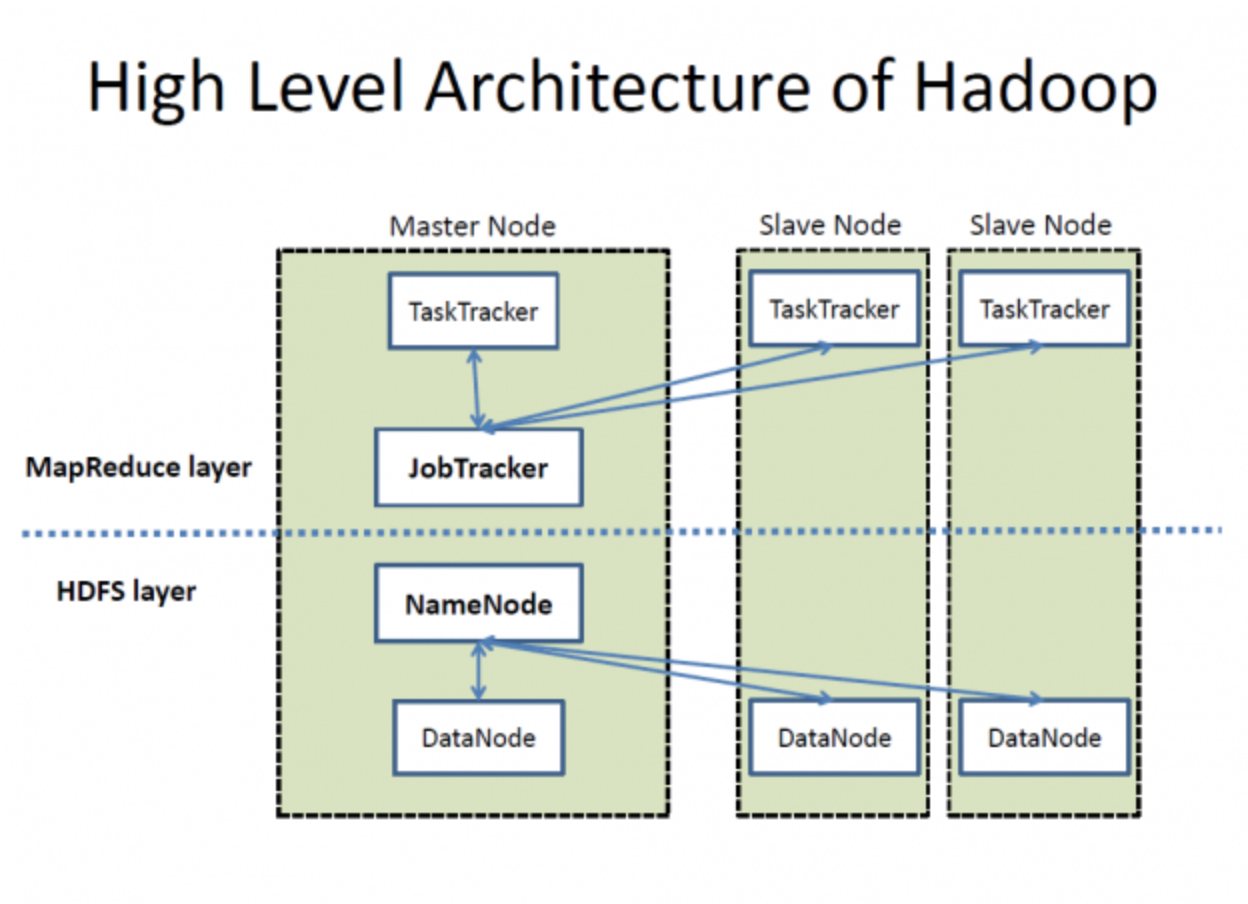
High-level architectuur van Hadoop. Bron: Wikimedia Commons
HDFS bestaat uit een NameNode en meerdere DataNodes voor databeheer, zoals te zien is in de afbeelding hierboven. Zo werken ze:
In Hadoop 1.x verzorgt MapReduce het resourcemanagement en de taakscheduling via JobTracker. Een belangrijk nadeel is echter trage verwerking.
Hadoop 2.0 introduceerde YARN (Yet Another Resource Negotiator) om deze problemen aan te pakken. YARN ontkoppelt resourcemanagement en taakscheduling in afzonderlijke componenten, wat de schaalbaarheid en resourcebenutting verbetert. De primaire componenten van YARN zijn:
Hoe YARN werkt:
De intermediaire vragen zijn meer gericht op het toetsen van je kennis van de technische aspecten van het Hadoop-framework. De interviewer kan je vragen naar het Hadoop-cluster, de uitdagingen en de vergelijking van verschillende versies.
Een Hadoop-cluster is een verzameling onderling verbonden master- en slavenodes, ontworpen om grote datasets op een gedistribueerde manier op te slaan en te verwerken. De clusterarchitectuur zorgt voor hoge beschikbaarheid, schaalbaarheid en fouttolerantie.
Componenten van een Hadoop-cluster:
Er zijn twee primaire manieren om een Hadoop-cluster op te zetten:
Vergelijking van on-premises en cloudgebaseerde clusters:
|
Kenmerk |
On-premises cluster |
Cloudgebaseerd cluster |
|
Opstartkosten |
Hogere initiële investering |
Pay-as-you-go-model |
|
Schaalbaarheid |
Beperkt door fysieke hardware |
Vrijwel onbeperkt |
|
Onderhoud |
Vereist intern beheer |
Beheerd door de cloudprovider |
|
Flexibiliteit |
Aanpasbare hardware en software |
Vooraf geconfigureerde opties |
|
Implementatietijd |
Langere opzetduur |
Snelle en eenvoudige implementatie |
Er is geen specifieke voorkeur voor clustergrootte. De clustergrootte is eenvoudig schaalbaar en volledig afhankelijk van de opslagbehoeften. Kleine bedrijven gebruiken mogelijk clusters met circa 20 nodes, terwijl bedrijven zoals Yahoo werken (of werkten) met clusters van wel 40.000 nodes.
Verschillende sectoren hebben specifieke behoeften op het gebied van data-analyse en -verwerking. Daarom heeft Hadoop veel projecten uitgebracht als onderdeel van zijn ecosysteem om hierop in te spelen. De lijst met Hadoop-projecten is breder dan je je kunt voorstellen—maar dit zijn de belangrijkste:
Hoewel het Hadoop-framework uitstekend is in het beheren en verwerken van enorme hoeveelheden waardevolle data, brengt het enkele kritieke uitdagingen met zich mee.
Laten we ze begrijpen:
HBase is een database die is ontworpen voor snelle toegang tot grote bestanden. Het stelt je in staat grote datasets in realtime te lezen en te schrijven door data in kolommen op te slaan en te indexeren met unieke rijsleutels.
Deze opzet maakt snelle data-opvraging en efficiënte scans mogelijk, wat geschikt is voor grote en schaars gevulde tabellen omdat we zoveel nodes kunnen toevoegen als nodig is.
HBase heeft drie componenten:
Deze tabel vergelijkt beide Hadoop-versies naast elkaar:
|
Criteria |
Hadoop 1.x |
Hadoop 2.0 |
|
NameNode-beheer |
Eén NameNode beheert de namespace |
Meerdere NameNodes beheren namespaces via HDFS-federatie |
|
Ondersteuning besturingssysteem |
Geen ondersteuning voor Microsoft Windows |
Ondersteuning voor Microsoft toegevoegd |
|
Taak- en resourcemanagement |
Gebruikt JobTracker en TaskTracker voor taak- en resourcemanagement |
Vervangen door YARN om beide taken te scheiden |
|
Schaalbaarheid |
Kan tot 4.000 nodes per cluster schalen |
Kan tot 10.000 nodes per cluster schalen |
|
DataNode-grootte |
Heeft een DataNode-blokgrootte van 64 MB |
Heeft de grootte verdubbeld naar 128 MB |
|
Taakuitvoering |
Gebruikt slots die ofwel Map- of Reduce-taken kunnen draaien |
Gebruikt containers die elke taak kunnen draaien |
Solliciteer je op een data-engineeringfunctie? Bekijk dan ons uitgebreide artikel met data-engineering sollicitatievragen.
Nu wordt het interessant. Deze sollicitatievragen testen je op een geavanceerd niveau. Ze zijn vooral belangrijk voor senior engineers.
In Hadoop 2.0 beheert de actieve NameNode de bestandsysteem-namespace en controleert hij de toegang van clients tot bestanden. De standby NameNode is daarentegen een back-up en bewaart genoeg informatie om over te nemen als de actieve NameNode uitvalt.
Dit pakt het single point of failure (SPOF)-probleem aan, dat vaak voorkwam in Hadoop 1.x.
HDFS is inefficiënt bij het verwerken van duizenden kleine bestanden, wat leidt tot verhoogde latentie. Daarom kun je met distributed cache alleen-lezen-, archief- en jar-bestanden opslaan en beschikbaar maken voor taken in MapReduce.
Stel dat je 40 MapReduce-taken moet draaien en elke taak het bestand uit HDFS moet ophalen. In de praktijk kan dit aantal oplopen tot honderden of duizenden reads. De applicatie zal deze bestanden vaak in HDFS opzoeken, wat HDFS overbelast en de prestaties beïnvloedt.
Een distributed cache kan echter veel kleine bestanden aan zonder in te leveren op toegangstijd en verwerkingssnelheid.
Checksums identificeren corrupte data in HDFS. Wanneer data het systeem binnenkomt, wordt een kleine waarde gegenereerd, een checksum. Hadoop berekent de checksum opnieuw wanneer een gebruiker om datatransfer vraagt. Komt de nieuwe checksum overeen met de oorspronkelijke, dan is de data intact; zo niet, dan is deze corrupt.
De foutdetectiecode voor Hadoop is CRC-32.
HDFS bereikt fouttolerantie via een replicatieproces dat betrouwbaarheid en beschikbaarheid waarborgt. Zo werkt het replicatieproces:
Ja, het is mogelijk om gecomprimeerde bestanden te verwerken met MapReduce. Hadoop ondersteunt meerdere compressieformaten, maar niet allemaal zijn ze splitbaar.
Dit zijn de formaten die MapReduce ondersteunt:
Van al deze formaten is bzip2 het enige splitbare formaat.
HDFS verdeelt zeer grote bestanden in kleinere delen van elk 128 MB. Zo zal HDFS een bestand van 1,28 GB opsplitsen in tien blokken. Elk blok wordt vervolgens verwerkt door een afzonderlijke mapper in een MapReduce-taak. Maar als een bestand niet splitbaar is, verwerkt één mapper het hele bestand.
Voor sommige functies is expertise in de integratie van Hive met Hadoop vereist. In zo'n specifieke rol zal de hiring manager zich op deze vragen richten:
Hive is een datawarehouse-systeem dat batchtaken en data-analyses uitvoert. Het werd ontwikkeld door Facebook om SQL-achtige queries uit te voeren op enorme datasets die in HDFS zijn opgeslagen, zonder afhankelijk te zijn van Java.
Met Hive kunnen we data in tabellen organiseren en een metastore gebruiken om metadata zoals schema's op te slaan. Het ondersteunt een reeks opslagsystemen, zoals S3, Azure Data Lake Storage (ADLs) en Google Cloud Storage.
De Hive Metastore (HMS) is een gecentraliseerde database voor metadata. Het bevat informatie over tabellen, views en toegangsrechten die zijn opgeslagen in HDFS-objectopslag.
Er zijn twee soorten HIVE Metastore-tabellen:
/user/hive/warehouse. Hive biedt robuuste ondersteuning voor integratie met meerdere programmeertalen, wat de veelzijdigheid en bruikbaarheid in verschillende toepassingen vergroot:
Dankzij de integratie met HDFS en de schaalbare architectuur kan Hive petabytes aan data verwerken. Er is geen vaste bovengrens aan de datagrootte die Hive kan beheren, wat het een krachtig hulpmiddel maakt voor bigdataverwerking en -analyse.
Hive biedt een rijke set aan datatypen om aan verschillende data-eisen te voldoen:
Ingebouwde datatypen:
|
Categorie |
Datatype |
Beschrijving |
Voorbeeld |
|
Numerieke typen |
TINYINT |
1-byte signed integer |
127 |
|
SMALLINT |
2-byte signed integer |
32767 |
|
|
INT |
4-byte signed integer |
2147483647 |
|
|
BIGINT |
8-byte signed integer |
9223372036854775807 |
|
|
FLOAT |
Single-precision floating-point |
3.14 |
|
|
DOUBLE |
Double-precision floating-point |
3.141592653589793 |
|
|
DECIMAL |
Arbitrary-precision signed decimal number |
1234567890.1234567890 |
|
|
String-typen |
STRING |
Variabele-lengte string |
'Hello, World!' |
|
VARCHAR |
Variabele-lengte string met opgegeven maximale lengte |
'Example' |
|
|
CHAR |
String met vaste lengte |
'A' |
|
|
Datum-/tijdt ypen |
TIMESTAMP |
Datum en tijd, inclusief tijdzone |
'2023-01-01 12:34:56' |
|
DATE |
Datum zonder tijd |
'2023-01-01' |
|
|
INTERVAL |
Tijdsinterval |
INTERVAL '1' DAY |
|
|
Overige typen |
BOOLEAN |
Stelt waar of onwaar voor |
TRUE |
|
BINARY |
Reeks bytes |
0x1A2B3C |
Complexe datatypen:
|
Datatype |
Beschrijving |
Voorbeeld |
|
ARRAY |
Geordende verzameling elementen |
ARRAY<STRING> ('apple', 'banana', 'cherry') |
|
MAP |
Verzameling sleutel-waardeparen |
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2) |
|
STRUCT |
Verzameling velden van verschillende datatypen |
STRUCT<name: STRING, age: INT> ('Alice', 30) |
|
UNIONTYPE |
Kan elk van meerdere gespecificeerde typen bevatten |
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three') |
Deze vragen testen je vermogen om Hadoop te gebruiken voor realistische problemen. Ze zijn vooral relevant als je solliciteert op een data-architectrol, maar kunnen in elk sollicitatieproces worden gesteld waarbij Hadoop-kennis vereist is.
Zo zal Hadoop de data repliceren:
De replicatiestrategie van Hadoop in een HDFS-cluster met drie racks (A, B en C) is ontworpen om de lastverdeling te optimaliseren, de fouttolerantie te vergroten en de netwerk efficiëntie te verbeteren. Zo wordt datafile.text gerepliceerd op een manier die prestaties en betrouwbaarheid in balans brengt.
Het gebruik van checksums in Hadoop's LocalFileSystem waarborgt dataintegriteit door:
.filename.crc-bestand in dezelfde map.ChecksumException te genereren bij afwijkingen.Door deze stappen te volgen, zorg je ervoor dat je applicatie dataintegriteit behoudt en potentiële datacorruptie snel detecteert.
Dit kunnen we doen:
stderr te loggen.Door deze stappen te volgen, kunnen we grootschalige Hadoop-taken systematisch debuggen en ongewone gevallen die de output beïnvloeden effectief traceren en oplossen.
Bij het configureren van geheugeninstellingen voor een Hadoop-cluster met YARN is het belangrijk om de geheugentoewijzing tussen Hadoop-daemons, systeemtaken en de NodeManager in balans te brengen om prestaties en resourcebenutting te optimaliseren.
Geheugen instellen voor de NodeManager:
Geheugen instellen voor MapReduce-taken:
mapreduce.map.memory.mb aanpassen: Deze parameter definieert de hoeveelheid geheugen die aan elke maptask wordt toegewezen. Pas deze instelling aan op basis van de geheugeneisen van je maptaken.mapreduce.map.memory.mb bijvoorbeeld instelt op 2048 MB, krijgt elke maptask 2 GB geheugen toegewezen.mapreduce.reduce.memory.mb aanpassen: Deze parameter definieert de hoeveelheid geheugen die aan elke reducetaak wordt toegewezen. Pas deze instelling aan op basis van de geheugeneisen van je reducetaken.mapreduce.reduce.memory.mb bijvoorbeeld instelt op 4096 MB, krijgt elke reducetaak 4 GB geheugen toegewezen.yarn-site.xml met parameters zoals yarn.nodemanager.resource.memory-mb, die moet aansluiten bij het aan de NodeManager toegewezen geheugen.yarn.nodemanager.resource.memory-mb instellen op 59.000 MB.Samenvatting van geheugenconfiguratie:
|
Component |
Configuratie |
Voorbeeldwaarden |
|
NodeManager |
Totaal fysiek geheugen |
64.000 MB |
|
Geheugen voor Hadoop-daemons |
3000 MB |
|
|
Geheugen voor systeemprocessen |
2000 MB |
|
|
Beschikbaar geheugen voor NodeManager |
59.000 MB |
|
|
MapReduce maptask |
mapreduce.map.memory.mb |
2048 MB |
|
MapReduce reducetaak |
mapreduce.reduce.memory.mb |
4096 MB |
|
Container-grootte |
yarn.nodemanager.resource.memory-mb |
59.000 MB |
Na het doornemen van deze vragen zou je de basisbegrippen moeten kennen en een
stevige greep moeten hebben op de complexiteit van Hadoop-toepassingen in de praktijk. Daarnaast moet je je kunnen aanpassen aan nieuwe projecten die op Hadoop zijn gebouwd om relevant te blijven en je sollicitaties te scoren.
Je kunt je kennis ook uitbreiden over andere bigdata-frameworks, zoals Spark en Flink, omdat die sneller zijn en lagere latentieproblemen hebben dan Hadoop.
Maar als je op zoek bent naar een gestructureerd leerpad om big data te beheersen, bekijk dan de volgende bronnen:
Leer meer over data engineering en big data met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

