Pakar Hadoop menulis aplikasi dan menganalisis data yang terus berubah untuk mendapatkan wawasan dan menjaga keamanan data. Itulah sebabnya manajer perekrutan memiliki kriteria ketat untuk menemukan kandidat terbaik dan dapat menanyakan apa pun mulai dari dasar hingga tingkat lanjut.
Dalam artikel ini, kami mengumpulkan 24 pertanyaan dan jawaban wawancara Hadoop yang paling sering ditanyakan.
Artikel ini dirancang untuk membantu Anda mempersiapkan diri secara menyeluruh untuk wawancara kerja big data berikutnya. Ini mencakup konsep fundamental dan skenario tingkat lanjut. Baik Anda pemula maupun profesional berpengalaman, Anda akan menemukan wawasan berharga dan informasi praktis untuk meningkatkan kepercayaan diri serta peluang sukses.
Pertanyaan Wawancara Hadoop Dasar
Pewawancara biasanya memulai dengan pertanyaan dasar untuk menilai pemahaman Anda tentang Hadoop dan relevansinya dalam mengelola big data.
Sekalipun Anda seorang insinyur berpengalaman, pastikan Anda menguasai pertanyaan-pertanyaan ini.
1. Apa itu big data?
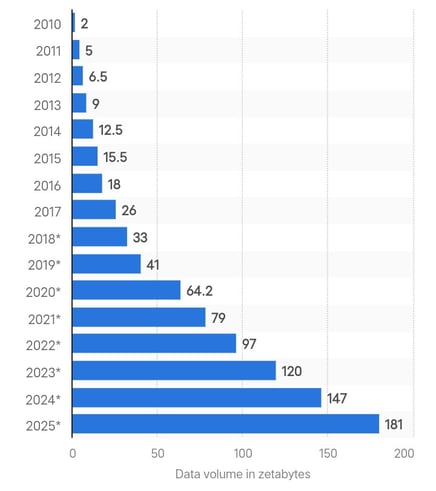
Penciptaan data global dalam Zettabyte. Sumber: Statista.
Big data mengacu pada sejumlah besar data kompleks yang dihasilkan dengan kecepatan tinggi dari berbagai sumber. Total data yang dibuat secara global mencapai 180 zettabyte pada 2025 dan diproyeksikan akan meningkat tiga kali lipat pada 2029.
Seiring percepatan generasi data, metode analisis tradisional akan gagal menyediakan pemrosesan waktu nyata dan keamanan data. Karena itu, perusahaan menggunakan kerangka kerja canggih seperti Hadoop untuk memproses dan mengelola volume data yang terus bertambah.
Jika Anda ingin memulai karier di big data, lihat panduan pelatihan big data kami.
2. Apa itu Hadoop, dan bagaimana cara mengatasinya dalam masalah big data?
Hadoop adalah kerangka kerja open-source untuk menangani kumpulan data besar yang terdistribusi di banyak komputer. Ia menyimpan data di beberapa mesin sebagai blok-blok kecil menggunakan Hadoop Distributed File System (HDFS).
Dengan Hadoop, Anda dapat menambahkan lebih banyak node ke sebuah klaster dan menangani data dalam jumlah besar tanpa perlu peningkatan perangkat keras yang mahal.
Bahkan perusahaan besar seperti Google dan Facebook mengandalkan Hadoop untuk mengelola dan menganalisis data harian dari terabyte hingga petabyte.
3. Apa dua komponen utama Hadoop?
Berikut adalah dua komponen utama Hadoop:
- Hadoop Distributed File System (HDFS): Mengelola penyimpanan data dengan memecah file besar menjadi potongan seukuran blok, masing-masing 128 MB secara default, dan mendistribusikannya ke banyak node dalam sebuah klaster.
- MapReduce: Model pemrograman yang diandalkan Hadoop untuk pemrosesan data. Ini adalah proses dua tahap yang terdiri dari pekerjaan mapping dan reducing. Mapping mengambil data dan mengonversinya menjadi kumpulan data lain. Reducer mengambil pasangan nilai keluaran dari pekerjaan map sebagai masukan dan menggabungkannya menjadi pasangan yang lebih kecil. Tujuannya adalah memprosesnya ke dalam fungsi reduce yang ditentukan pengguna.
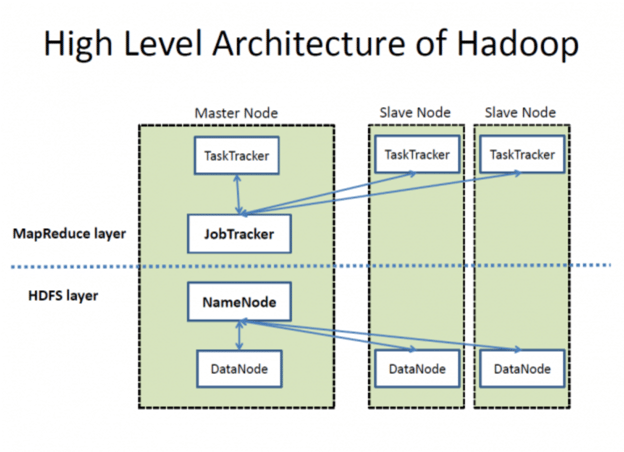
Arsitektur tingkat tinggi Hadoop. Sumber: Wikimedia Commons
4. Jelaskan peran NameNode dan DataNode dalam Hadoop.
HDFS terdiri dari sebuah NameNode dan banyak DataNode untuk manajemen data, seperti terlihat pada gambar di atas. Berikut cara kerjanya:
- Sebagai server master di HDFS, NameNode menangani operasi seperti membuka, menutup, dan mengganti nama file. Ia memelihara metadata perizinan dan lokasi blok.
- DataNode, di sisi lain, bertindak sebagai node pekerja untuk menyimpan blok data aktual dari sebuah file. Ketika klien perlu membaca atau menulis data, klien mendapatkan lokasi blok data dari NameNode. Setelah itu, klien berkomunikasi langsung dengan DataNode terkait untuk melakukan operasi yang diperlukan.
5. Jelaskan peran Hadoop YARN.
Di Hadoop 1.x, MapReduce menangani manajemen sumber daya dan penjadwalan pekerjaan menggunakan JobTracker. Namun, pemrosesan yang lambat menjadi kelemahan signifikan.
Hadoop 2.0 memperkenalkan YARN (Yet Another Resource Negotiator) untuk mengatasi masalah ini. YARN memisahkan manajemen sumber daya dan penjadwalan pekerjaan ke dalam komponen terpisah, yang meningkatkan skalabilitas dan pemanfaatan sumber daya. Komponen utama YARN adalah:
- ResourceManager (RM): Mengelola sumber daya di seluruh klaster.
- NodeManager (NM): Mengelola sumber daya dan pemantauan setiap node.
- ApplicationMaster (AM): Mengelola siklus hidup aplikasi, termasuk kebutuhan sumber daya dan eksekusinya.
Cara kerja YARN:
- Pengajuan job: Klien mengajukan sebuah aplikasi ke klaster YARN.
- Alokasi sumber daya: ResourceManager mulai mengalokasikan sumber daya dengan berkoordinasi bersama ApplicationMaster.
- Pendaftaran ApplicationMaster: ApplicationMaster mendaftarkan dirinya ke ResourceManager.
- Negosiasi container: ApplicationMaster menegosiasikan sumber daya (container) dari ResourceManager.
- Peluncuran container: Setelah sumber daya dialokasikan, ApplicationMaster menginstruksikan NodeManager untuk meluncurkan container.
- Eksekusi aplikasi: Kode aplikasi dijalankan di dalam container yang dialokasikan.
Pertanyaan Wawancara Hadoop Menengah
Pertanyaan tingkat menengah lebih berfokus pada penilaian pengetahuan Anda tentang seluk-beluk kerangka kerja Hadoop. Pewawancara dapat menanyakan tentang klaster Hadoop, tantangannya, serta perbandingan berbagai versinya.
6. Apa itu klaster Hadoop, dan adakah ukuran klaster tertentu yang disukai perusahaan?
Klaster Hadoop adalah kumpulan node master dan slave yang saling terhubung, dirancang untuk menyimpan dan memproses kumpulan data besar secara terdistribusi. Arsitektur klaster memastikan ketersediaan tinggi, skalabilitas, dan toleransi kesalahan.
Komponen Klaster Hadoop:
- Node master: Node ini mengelola sumber daya klaster dan sistem berkas terdistribusi. Komponen kunci meliputi:
- NameNode: Mengelola namespace Hadoop Distributed File System (HDFS) dan mengatur akses file oleh klien.
- ResourceManager: Mengelola alokasi sumber daya untuk menjalankan aplikasi.
- Node slave: Node ini bertanggung jawab menyimpan data dan melakukan komputasi. Komponen kunci meliputi:
- DataNode: Menyimpan blok data aktual di HDFS.
- NodeManager: Mengelola eksekusi container pada node.
Ada dua cara utama untuk menyiapkan klaster Hadoop:
- Klaster on-premises: Gunakan komponen perangkat keras komoditas untuk membangun klaster Anda. Pendekatan ini bisa hemat biaya dan dapat disesuaikan berdasarkan kebutuhan spesifik.
- Klaster berbasis cloud: Pilih layanan berbasis cloud seperti Amazon EMR, Google Cloud Dataproc, atau Azure HDInsight. Metode ini menawarkan fleksibilitas, skalabilitas, dan mengurangi beban pengelolaan.
Perbandingan Klaster On-Premises dan Berbasis Cloud:
|
Fitur
|
Klaster on-premises
|
Klaster berbasis cloud
|
|
Biaya penyiapan
|
Investasi awal lebih tinggi
|
Model bayar sesuai pemakaian
|
|
Skalabilitas
|
Dibatasi perangkat keras fisik
|
Hampir tidak terbatas
|
|
Pemeliharaan
|
Memerlukan pengelolaan internal
|
Dikelola oleh penyedia cloud
|
|
Fleksibilitas
|
Perangkat keras dan perangkat lunak dapat disesuaikan
|
Opsi prakonfigurasi
|
|
Waktu penerapan
|
Waktu penyiapan lebih lama
|
Penerapan cepat dan mudah
|
Tidak ada preferensi khusus untuk ukuran klaster. Ukuran klaster mudah diskalakan dan sepenuhnya bergantung pada kebutuhan penyimpanan. Perusahaan kecil mungkin mengandalkan klaster sekitar 20 node, sementara bisnis seperti Yahoo mengoperasikan (atau pernah) klaster sebesar berisi 40.000 node.
7. Apa saja proyek ekosistem Hadoop?
Berbagai industri memiliki kebutuhan analisis dan pemrosesan data yang spesifik. Karena itu, Hadoop merilis banyak proyek sebagai bagian dari ekosistemnya untuk menyediakan solusi yang sesuai. Daftar proyek Hadoop jauh lebih luas dari yang Anda bayangkan—namun berikut adalah yang paling esensial:
- MapReduce: Model pemrograman untuk memproses kumpulan data besar dengan algoritma terdistribusi paralel.
- Apache Hive: Infrastruktur gudang data untuk ringkasan data, kueri, dan analisis menggunakan HiveQL.
- Apache HBase: Penyimpanan big data yang skalabel yang menyediakan akses baca/tulis real-time ke kumpulan data besar.
- Apache Pig: Platform tingkat tinggi untuk membuat program MapReduce dengan Pig Latin.
- Apache Sqoop: Alat untuk mentransfer data massal antara Hadoop dan datastore terstruktur seperti basis data relasional.
- Apache Flume: Layanan untuk mengumpulkan, mengagregasi, dan memindahkan data log dalam jumlah besar secara efisien.
- Apache Oozie: Sistem penjadwal alur kerja untuk mengelola job Hadoop dan ketergantungannya.
- Apache Zookeeper: Layanan terpusat untuk memelihara informasi konfigurasi dan menyediakan sinkronisasi terdistribusi.
- Apache Spark: Sistem komputasi klaster serbaguna yang cepat dengan pemrosesan in-memory.
- Apache Storm: Sistem komputasi real-time untuk memproses aliran data besar.
- Apache Kafka: Platform streaming terdistribusi untuk menangani feed data real-time.
8. Apa saja tantangan umum pada Hadoop?
Meskipun kerangka kerja Hadoop sangat baik dalam mengelola dan memproses jumlah data bernilai besar, ada beberapa tantangan krusial yang ditimbulkannya.
Mari kita pahami:
- Masalah terbesar pada Hadoop adalah NameNode memiliki single point of failure, yang menyebabkan hilangnya data jika terjadi kegagalan.
- Hadoop rentan terhadap ancaman keamanan. Anda tidak dapat mengontrol data secara langsung, dan tidak ada cara untuk mengetahui apakah data disalahgunakan.
- Kerangka MapReduce Hadoop memproses data secara batch dan tidak mendukung pemrosesan data real-time.
- Kerangka ini bekerja baik dengan data berkapasitas tinggi namun tidak dapat memproses file kecil. Ketika data lebih kecil dari ukuran blok HDFS default, itu akan membebani NameNode dan menyebabkan masalah latensi.
9. Apa itu HBase, dan apa peran komponennya?
HBase adalah basis data yang dirancang untuk akses cepat ke file besar. Ini memungkinkan Anda membaca dan menulis kumpulan data besar secara real-time dengan menyimpan data dalam kolom dan mengindeksnya dengan row key unik.
Pengaturan ini memungkinkan pengambilan data yang cepat dan pemindaian yang efisien, cocok untuk tabel besar dan jarang terisi karena kita dapat menambahkan node sebanyak yang diperlukan.
HBase memiliki tiga komponen:
- HMaster: Mengelola region server dan bertanggung jawab untuk membuat dan menghapus tabel.
- Region server: Menangani permintaan baca dan tulis serta mengelola pemisahan region.
- ZooKeeper: Memelihara status klaster dan mengelola penugasan server
10. Apa yang membedakan Hadoop 2.0 dari Hadoop 1.x?
Tabel ini membandingkan kedua versi Hadoop secara berdampingan:
|
Kriteria
|
Hadoop 1.x
|
Hadoop 2.0
|
|
Manajemen NameNode
|
Satu NameNode mengelola Namespace
|
Beberapa NameNode menangani namespace melalui federasi HDFS
|
|
Dukungan sistem operasi
|
Tidak ada dukungan untuk Microsoft Windows
|
Menambahkan dukungan untuk Microsoft
|
|
Manajemen job dan sumber daya
|
Menggunakan JobTracker dan TaskTracker untuk manajemen job dan sumber daya
|
Digantikan dengan YARN untuk memisahkan kedua tugas
|
|
Skalabilitas
|
Dapat diskalakan hingga 4.000 node per klaster
|
Dapat diskalakan hingga 10.000 node per klaster
|
|
Ukuran DataNode
|
Ukuran DataNode 64 MB
|
Menggandakannya menjadi 128 MB
|
|
Eksekusi tugas
|
Menggunakan slot yang dapat menjalankan tugas Map atau Reduce
|
Menggunakan container yang dapat menjalankan tugas apa pun
|
Jika Anda melamar pekerjaan data engineering, lihat artikel komprehensif kami tentang pertanyaan wawancara data engineering.
Pertanyaan Wawancara Hadoop Tingkat Lanjut
Sekarang bagian ini mulai menarik. Pertanyaan-pertanyaan ini diajukan untuk menguji Anda pada tingkat lanjut. Pertanyaan-pertanyaan ini sangat penting bagi insinyur senior.
11. Apa konsep Active NameNode dan Standby NameNode di Hadoop 2.0?
Di Hadoop 2.0, Active NameNode mengelola namespace sistem berkas dan mengontrol akses klien ke file. Sebaliknya, Standby NameNode adalah cadangan dan memelihara informasi yang cukup untuk mengambil alih jika Active NameNode gagal.
Ini mengatasi masalah single point of failure (SPOF) yang umum di Hadoop 1.x.
12. Apa tujuan distributed cache di Hadoop? Mengapa HDFS tidak dapat membaca file kecil?
HDFS tidak efisien dalam memproses ribuan file kecil, yang mengakibatkan peningkatan latensi. Karena itu, distributed cache memungkinkan Anda menyimpan file read-only, arsip, dan jar serta membuatnya tersedia untuk tugas-tugas di MapReduce.
Misalkan Anda perlu menjalankan 40 job di MapReduce, dan setiap job perlu mengakses file dari HDFS. Dalam situasi nyata, jumlah ini dapat meningkat menjadi ratusan atau ribuan pembacaan. Aplikasi akan sering mencari lokasi file-file ini di HDFS, yang akan membebani HDFS dan memengaruhi kinerjanya.
Namun, distributed cache dapat menangani banyak file berukuran kecil tanpa mengorbankan waktu akses dan kecepatan pemrosesan.
13. Jelaskan peran checksum dalam mendeteksi data yang rusak. Sebutkan juga kode pendeteksi kesalahan standar.
Checksum mengidentifikasi data yang rusak di HDFS. Saat data masuk ke sistem, dibuat sebuah nilai kecil yang disebut checksum. Hadoop menghitung ulang checksum saat pengguna meminta transfer data. Jika checksum baru cocok dengan yang asli, datanya utuh; jika tidak, berarti rusak.
Kode pendeteksi kesalahan untuk Hadoop adalah CRC-32.
14. Bagaimana HDFS mencapai toleransi kesalahan?
HDFS mencapai toleransi kesalahan melalui proses replikasi yang memastikan keandalan dan ketersediaan. Berikut cara kerja proses replikasi:
- Distribusi blok awal: Saat sebuah file disimpan, HDFS membaginya menjadi blok-blok dan menempatkannya ke DataNode yang berbeda. Misalnya, file yang dibagi menjadi blok A, B, dan C dapat disimpan pada DataNode A1, B2, dan C3.
- Replikasi: Setiap DataNode yang menyimpan sebuah blok mereplikasi blok tersebut ke DataNode lain dalam klaster. Misalnya, DataNode A1 yang menyimpan blok A akan membuat salinan tambahan pada DataNode lain, seperti D1 dan D2. Artinya, jika A1 gagal, salinan A1 pada D1 dan D2 tetap tersedia.
- Menangani kegagalan: Jika DataNode D1 gagal, Anda dapat mengambil blok yang diperlukan (B dan C) dari DataNode lain seperti B2 dan C3.
Ya, file terkompresi dapat diproses dengan MapReduce. Hadoop mendukung beberapa format kompresi, namun tidak semuanya dapat dipecah.
Berikut adalah format yang didukung MapReduce:
- DEFLATE
- gzip
- bzip2
- LZO
- LZ4
- Snappy
Dari semua ini, bzip2 adalah satu-satunya format yang dapat dipecah.
HDFS membagi file yang sangat besar menjadi bagian-bagian lebih kecil, masing-masing 128 MB. Misalnya, HDFS akan memecah file 1,28 GB menjadi sepuluh blok. Setiap blok kemudian diproses oleh mapper terpisah dalam job MapReduce. Namun jika file tidak dapat dipecah, satu mapper akan menangani seluruh file.
Pertanyaan Wawancara Hive
Beberapa pekerjaan memerlukan keahlian integrasi Hive dengan Hadoop. Dalam peran spesifik seperti ini, manajer perekrutan akan berfokus pada pertanyaan-pertanyaan berikut:
16. Definisikan Hive.
Hive adalah sistem gudang data yang menjalankan job batch dan analisis data. Ini dikembangkan oleh Facebook untuk menjalankan kueri mirip SQL pada kumpulan data masif yang disimpan di HDFS tanpa bergantung pada Java.
Dengan Hive, kita dapat mengorganisasi data ke dalam tabel dan menggunakan metastore untuk menyimpan metadata seperti skema. Ia mendukung berbagai sistem penyimpanan, seperti S3, Azure Data Lake Storage (ADLs), dan Google Cloud Storage.
Hive Metastore (HMS) adalah basis data terpusat untuk metadata. Ini berisi informasi tentang tabel, view, dan izin akses yang disimpan dalam penyimpanan objek HDFS.
Ada dua jenis tabel Hive Metastore:
- Managed Metastore: Hive menyimpan dan mengelola tabel ini di Hive service JVM. Kita dapat menemukan tabel-tabel ini menggunakan nilai default
/user/hive/warehouse.
- External Metastore: Tabel-tabel ini berjalan pada JVM di luar. Jadi, perubahan apa pun pada metadata Hive tidak memengaruhi data yang disimpan dalam tabel-tabel ini.
18. Bahasa pemrograman apa yang didukung Hive?
Hive menyediakan dukungan yang kuat untuk integrasi dengan berbagai bahasa pemrograman, meningkatkan fleksibilitas dan kegunaannya dalam berbagai aplikasi:
- Python: Analisis data dan pembelajaran mesin.
- Java: Aplikasi enterprise dan pemrosesan data kustom.
- C++: Aplikasi yang kritis terhadap kinerja dan SerDes kustom.
- PHP: Aplikasi berbasis web yang mengakses data Hive.
19. Berapa ukuran data maksimum yang dapat ditangani Hive?
Berkat integrasinya dengan HDFS dan arsitektur yang skalabel, Hive dapat menangani data hingga tingkat petabyte. Tidak ada batas atas tetap pada ukuran data yang dapat dikelola Hive, menjadikannya alat yang kuat untuk pemrosesan dan analitik big data.
20. Ada berapa tipe data di Hive?
Hive menawarkan beragam tipe data untuk menangani berbagai kebutuhan data:
- Tipe data bawaan: Numerik, String, Tanggal/Waktu, dan lain-lain untuk penyimpanan data dasar.
- Tipe data kompleks: ARRAY, MAP, STRUCT, dan UNIONTYPE untuk representasi data yang lebih maju dan terstruktur.
Tipe data bawaan:
|
Kategori
|
Tipe data
|
Deskripsi
|
Contoh
|
|
Tipe numerik
|
TINYINT
|
Integer bertanda 1-byte
|
127
|
| |
SMALLINT
|
Integer bertanda 2-byte
|
32767
|
| |
INT
|
Integer bertanda 4-byte
|
2147483647
|
| |
BIGINT
|
Integer bertanda 8-byte
|
9223372036854775807
|
| |
FLOAT
|
Floating-point presisi tunggal
|
3.14
|
| |
DOUBLE
|
Floating-point presisi ganda
|
3.141592653589793
|
| |
DECIMAL
|
Bilangan desimal bertanda presisi sewenang-wenang
|
1234567890.1234567890
|
|
Tipe string
|
STRING
|
String panjang variabel
|
'Hello, World!'
|
| |
VARCHAR
|
String panjang variabel dengan panjang maks tertentu
|
'Example'
|
| |
CHAR
|
String panjang tetap
|
'A'
|
|
Tipe Tanggal/Waktu
|
TIMESTAMP
|
Tanggal dan waktu, termasuk zona waktu
|
'2023-01-01 12:34:56'
|
| |
DATE
|
Tanggal tanpa waktu
|
'2023-01-01'
|
| |
INTERVAL
|
Selang waktu
|
INTERVAL '1' DAY
|
|
Tipe lain-lain
|
BOOLEAN
|
Mewakili true atau false
|
TRUE
|
| |
BINARY
|
Urutan byte
|
0x1A2B3C
|
Tipe Data Kompleks:
|
Tipe Data
|
Deskripsi
|
Contoh
|
|
ARRAY
|
Koleksi elemen yang terurut
|
ARRAY<STRING> ('apple', 'banana', 'cherry')
|
|
MAP
|
Koleksi pasangan key-value
|
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
|
|
STRUCT
|
Koleksi field dari berbagai tipe data
|
STRUCT<name: STRING, age: INT> ('Alice', 30)
|
|
UNIONTYPE
|
Dapat menampung salah satu dari beberapa tipe yang ditentukan
|
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three')
|
Pertanyaan Wawancara Hadoop Berbasis Skenario untuk Big Data Engineer
Pertanyaan-pertanyaan ini menguji kemampuan Anda menggunakan Hadoop untuk menangani masalah nyata. Pertanyaan ini sangat relevan jika Anda melamar peran arsitek data namun dapat ditanyakan di proses wawancara apa pun yang membutuhkan pengetahuan Hadoop.
21. Anda menyiapkan klaster HDFS dengan sistem replikasi Hadoop. Klaster memiliki tiga rak: A, B, dan C. Jelaskan bagaimana Hadoop akan mereplikasi file bernama datafile.text.
Berikut cara Hadoop mereplikasi data:
- Replika pertama di rak A: Hadoop menempatkan replika awal pada node yang dipilih acak di rak A. Keputusan ini meminimalkan latensi tulis dengan memilih node lokal atau yang berdekatan.
- Replika kedua di rak B: Replika kedua ditempatkan pada node di rak yang berbeda, seperti rak B. Ini memastikan data tidak hilang jika rak A gagal, sehingga meningkatkan toleransi kesalahan.
- Replika ketiga di rak B: Replika ketiga ditempatkan pada node lain di dalam rak B. Penempatan pada rak yang sama dengan replika kedua membantu menyeimbangkan beban jaringan antar rak dan mengurangi lalu lintas antar-rak.
Strategi replikasi Hadoop dalam klaster HDFS dengan tiga rak (A, B, dan C) dirancang untuk mengoptimalkan distribusi beban, meningkatkan toleransi kesalahan, dan memperbaiki efisiensi jaringan. Dengan demikian, datafile.text direplikasi dengan cara yang menyeimbangkan kinerja dan keandalan.
22. Anda mengerjakan aplikasi berbasis Hadoop yang berinteraksi dengan file menggunakan LocalFileSystem. Bagaimana Anda menangani integritas data dengan checksum?
Menggunakan checksum di LocalFileSystem Hadoop memastikan integritas data dengan:
- Menghasilkan checksum: Secara otomatis membuat checksum untuk potongan data saat penulisan file.
- Menyimpan checksum: Menyimpan checksum dalam file tersembunyi
.filename.crc di direktori yang sama.
- Memverifikasi checksum: Membandingkan checksum yang disimpan dengan data aktual saat pembacaan.
- Mendeteksi ketidaksesuaian: Menimbulkan
ChecksumException jika terjadi perbedaan.
Dengan mengikuti langkah-langkah ini, kita dapat memastikan aplikasi Anda menjaga integritas data dan segera mendeteksi potensi kerusakan data.
23. Misalkan Anda melakukan debug job Hadoop skala besar yang tersebar di beberapa node, dan ada kasus tidak biasa yang memengaruhi keluaran. Bagaimana Anda menanganinya?
Berikut yang dapat kita lakukan:
- Catat potensi masalah: Gunakan pernyataan debug untuk mencatat potensi masalah ke
stderr.
- Perbarui status tugas: Sertakan lokasi log kesalahan dalam pesan status tugas.
- Counter khusus: Implementasikan counter untuk melacak dan menganalisis kondisi yang tidak biasa.
- Debug output map: Tulis informasi debug ke output map.
- Program analisis log: Buat program MapReduce untuk analisis log mendetail.
Dengan mengikuti langkah-langkah ini, kita dapat melakukan debug job Hadoop skala besar secara sistematis dan secara efektif melacak serta menyelesaikan kasus tidak biasa yang memengaruhi keluaran.
24. Anda menghitung pengaturan memori untuk klaster Hadoop menggunakan YARN. Jelaskan bagaimana Anda akan mengatur memori untuk NodeManager dan job MapReduce.
Saat mengonfigurasi pengaturan memori untuk klaster Hadoop menggunakan YARN, penting untuk menyeimbangkan alokasi memori antara daemon Hadoop, proses sistem, dan NodeManager guna mengoptimalkan kinerja serta pemanfaatan sumber daya.
Mengatur memori untuk NodeManager:
- Hitung total memori fisik node: Tentukan total memori fisik yang tersedia pada setiap node di klaster. Misalnya, jika sebuah node memiliki RAM 64 GB, total memori fisiknya adalah 64.000 MB.
- Kurangi memori untuk daemon Hadoop: Alokasikan memori untuk daemon Hadoop yang berjalan pada node, seperti DataNode dan NodeManager. Biasanya, 1000 hingga 2000 MB per daemon sudah cukup. Misalnya, jika Anda mengalokasikan masing-masing 1500 MB untuk DataNode dan NodeManager, Anda perlu mencadangkan 3000 MB.
- Cadangkan memori untuk proses sistem: Sisihkan memori untuk proses sistem dan layanan latar belakang lainnya agar sistem operasi dan layanan penting berjalan lancar. Cadangan umum sekitar 2 GB (2000 MB).
- Alokasikan sisa memori untuk NodeManager: Kurangi memori yang dicadangkan untuk daemon Hadoop dan proses sistem dari total memori fisik untuk menentukan memori yang tersedia bagi NodeManager guna dialokasikan ke container.
Mengatur memori untuk job MapReduce:
- Sesuaikan
mapreduce.map.memory.mb: Parameter ini menentukan jumlah memori yang dialokasikan untuk setiap tugas map. Sesuaikan pengaturan ini berdasarkan kebutuhan memori tugas map Anda.
- Misalnya, menetapkan
mapreduce.map.memory.mb ke 2048 MB berarti setiap tugas map akan dialokasikan memori 2 GB.
- Sesuaikan
mapreduce.reduce.memory.mb: Parameter ini menentukan jumlah memori yang dialokasikan untuk setiap tugas reduce. Sesuaikan berdasarkan kebutuhan memori tugas reduce Anda.
- Misalnya, menetapkan
mapreduce.reduce.memory.mb ke 4096 MB berarti setiap tugas reduce akan dialokasikan memori 4 GB.
- Konfigurasikan ukuran container: Pastikan ukuran container ditetapkan dengan tepat di
yarn-site.xml dengan parameter seperti yarn.nodemanager.resource.memory-mb, yang harus selaras dengan memori yang dialokasikan ke NodeManager.
- Misalnya, jika NodeManager memiliki 59.000 MB yang tersedia, Anda dapat menetapkan
yarn.nodemanager.resource.memory-mb ke 59.000 MB.
Ringkasan konfigurasi memori:
|
Komponen
|
Konfigurasi
|
Nilai Contoh
|
|
NodeManager
|
Total memori fisik
|
64.000 MB
|
| |
Memori untuk daemon Hadoop
|
3000 MB
|
| |
Memori untuk proses sistem
|
2000 MB
|
| |
Memori tersedia untuk NodeManager
|
59.000 MB
|
|
Tugas map MapReduce
|
mapreduce.map.memory.mb
|
2048 MB
|
|
Tugas reduce MapReduce
|
mapreduce.reduce.memory.mb
|
4096 MB
|
|
Ukuran container
|
yarn.nodemanager.resource.memory-mb
|
59.000 MB
|
Pemikiran Akhir
Setelah memahami pertanyaan-pertanyaan ini, Anda seharusnya mengetahui istilah dasar dan memiliki
penguasaan yang kuat atas kompleksitas aplikasi Hadoop di dunia nyata. Selain itu, Anda harus beradaptasi dengan proyek-proyek baru yang dibangun di atas Hadoop untuk tetap relevan dan sukses dalam wawancara.
Anda juga dapat memperluas pengetahuan tentang kerangka kerja big data lainnya, seperti Spark dan Flink, karena keduanya cepat dan memiliki masalah latensi yang lebih rendah dibandingkan Hadoop.
Namun jika Anda mencari jalur belajar terstruktur untuk menguasai big data, Anda dapat melihat sumber daya berikut:
- Big Data Fundamentals with PySpark: Kursus ini merupakan titik awal yang sangat baik untuk mempelajari dasar-dasar pemrosesan big data dengan PySpark.
- Big Data with PySpark: Jalur ini memberikan pengenalan komprehensif tentang konsep big data menggunakan PySpark, mencakup aspek seperti manipulasi data, pembelajaran mesin, dan lainnya.





Pakar Hadoop menulis aplikasi dan menganalisis data yang terus berubah untuk mendapatkan wawasan dan menjaga keamanan data. Itulah sebabnya manajer perekrutan memiliki kriteria ketat untuk menemukan kandidat terbaik dan dapat menanyakan apa pun mulai dari dasar hingga tingkat lanjut.
Dalam artikel ini, kami mengumpulkan 24 pertanyaan dan jawaban wawancara Hadoop yang paling sering ditanyakan.
Artikel ini dirancang untuk membantu Anda mempersiapkan diri secara menyeluruh untuk wawancara kerja big data berikutnya. Ini mencakup konsep fundamental dan skenario tingkat lanjut. Baik Anda pemula maupun profesional berpengalaman, Anda akan menemukan wawasan berharga dan informasi praktis untuk meningkatkan kepercayaan diri serta peluang sukses.
Pertanyaan Wawancara Hadoop Dasar
Pewawancara biasanya memulai dengan pertanyaan dasar untuk menilai pemahaman Anda tentang Hadoop dan relevansinya dalam mengelola big data.
Sekalipun Anda seorang insinyur berpengalaman, pastikan Anda menguasai pertanyaan-pertanyaan ini.
1. Apa itu big data?
Penciptaan data global dalam Zettabyte. Sumber: Statista.
Big data mengacu pada sejumlah besar data kompleks yang dihasilkan dengan kecepatan tinggi dari berbagai sumber. Total data yang dibuat secara global mencapai 180 zettabyte pada 2025 dan diproyeksikan akan meningkat tiga kali lipat pada 2029.
Seiring percepatan generasi data, metode analisis tradisional akan gagal menyediakan pemrosesan waktu nyata dan keamanan data. Karena itu, perusahaan menggunakan kerangka kerja canggih seperti Hadoop untuk memproses dan mengelola volume data yang terus bertambah.
Jika Anda ingin memulai karier di big data, lihat panduan pelatihan big data kami.
2. Apa itu Hadoop, dan bagaimana cara mengatasinya dalam masalah big data?
Hadoop adalah kerangka kerja open-source untuk menangani kumpulan data besar yang terdistribusi di banyak komputer. Ia menyimpan data di beberapa mesin sebagai blok-blok kecil menggunakan Hadoop Distributed File System (HDFS).
Dengan Hadoop, Anda dapat menambahkan lebih banyak node ke sebuah klaster dan menangani data dalam jumlah besar tanpa perlu peningkatan perangkat keras yang mahal.
Bahkan perusahaan besar seperti Google dan Facebook mengandalkan Hadoop untuk mengelola dan menganalisis data harian dari terabyte hingga petabyte.
3. Apa dua komponen utama Hadoop?
Berikut adalah dua komponen utama Hadoop:
Arsitektur tingkat tinggi Hadoop. Sumber: Wikimedia Commons
4. Jelaskan peran NameNode dan DataNode dalam Hadoop.
HDFS terdiri dari sebuah NameNode dan banyak DataNode untuk manajemen data, seperti terlihat pada gambar di atas. Berikut cara kerjanya:
5. Jelaskan peran Hadoop YARN.
Di Hadoop 1.x, MapReduce menangani manajemen sumber daya dan penjadwalan pekerjaan menggunakan JobTracker. Namun, pemrosesan yang lambat menjadi kelemahan signifikan.
Hadoop 2.0 memperkenalkan YARN (Yet Another Resource Negotiator) untuk mengatasi masalah ini. YARN memisahkan manajemen sumber daya dan penjadwalan pekerjaan ke dalam komponen terpisah, yang meningkatkan skalabilitas dan pemanfaatan sumber daya. Komponen utama YARN adalah:
Cara kerja YARN:
Pertanyaan Wawancara Hadoop Menengah
Pertanyaan tingkat menengah lebih berfokus pada penilaian pengetahuan Anda tentang seluk-beluk kerangka kerja Hadoop. Pewawancara dapat menanyakan tentang klaster Hadoop, tantangannya, serta perbandingan berbagai versinya.
6. Apa itu klaster Hadoop, dan adakah ukuran klaster tertentu yang disukai perusahaan?
Klaster Hadoop adalah kumpulan node master dan slave yang saling terhubung, dirancang untuk menyimpan dan memproses kumpulan data besar secara terdistribusi. Arsitektur klaster memastikan ketersediaan tinggi, skalabilitas, dan toleransi kesalahan.
Komponen Klaster Hadoop:
Ada dua cara utama untuk menyiapkan klaster Hadoop:
Perbandingan Klaster On-Premises dan Berbasis Cloud:
Fitur
Klaster on-premises
Klaster berbasis cloud
Biaya penyiapan
Investasi awal lebih tinggi
Model bayar sesuai pemakaian
Skalabilitas
Dibatasi perangkat keras fisik
Hampir tidak terbatas
Pemeliharaan
Memerlukan pengelolaan internal
Dikelola oleh penyedia cloud
Fleksibilitas
Perangkat keras dan perangkat lunak dapat disesuaikan
Opsi prakonfigurasi
Waktu penerapan
Waktu penyiapan lebih lama
Penerapan cepat dan mudah
Tidak ada preferensi khusus untuk ukuran klaster. Ukuran klaster mudah diskalakan dan sepenuhnya bergantung pada kebutuhan penyimpanan. Perusahaan kecil mungkin mengandalkan klaster sekitar 20 node, sementara bisnis seperti Yahoo mengoperasikan (atau pernah) klaster sebesar berisi 40.000 node.
7. Apa saja proyek ekosistem Hadoop?
Berbagai industri memiliki kebutuhan analisis dan pemrosesan data yang spesifik. Karena itu, Hadoop merilis banyak proyek sebagai bagian dari ekosistemnya untuk menyediakan solusi yang sesuai. Daftar proyek Hadoop jauh lebih luas dari yang Anda bayangkan—namun berikut adalah yang paling esensial:
8. Apa saja tantangan umum pada Hadoop?
Meskipun kerangka kerja Hadoop sangat baik dalam mengelola dan memproses jumlah data bernilai besar, ada beberapa tantangan krusial yang ditimbulkannya.
Mari kita pahami:
9. Apa itu HBase, dan apa peran komponennya?
HBase adalah basis data yang dirancang untuk akses cepat ke file besar. Ini memungkinkan Anda membaca dan menulis kumpulan data besar secara real-time dengan menyimpan data dalam kolom dan mengindeksnya dengan row key unik.
Pengaturan ini memungkinkan pengambilan data yang cepat dan pemindaian yang efisien, cocok untuk tabel besar dan jarang terisi karena kita dapat menambahkan node sebanyak yang diperlukan.
HBase memiliki tiga komponen:
10. Apa yang membedakan Hadoop 2.0 dari Hadoop 1.x?
Tabel ini membandingkan kedua versi Hadoop secara berdampingan:
Kriteria
Hadoop 1.x
Hadoop 2.0
Manajemen NameNode
Satu NameNode mengelola Namespace
Beberapa NameNode menangani namespace melalui federasi HDFS
Dukungan sistem operasi
Tidak ada dukungan untuk Microsoft Windows
Menambahkan dukungan untuk Microsoft
Manajemen job dan sumber daya
Menggunakan JobTracker dan TaskTracker untuk manajemen job dan sumber daya
Digantikan dengan YARN untuk memisahkan kedua tugas
Skalabilitas
Dapat diskalakan hingga 4.000 node per klaster
Dapat diskalakan hingga 10.000 node per klaster
Ukuran DataNode
Ukuran DataNode 64 MB
Menggandakannya menjadi 128 MB
Eksekusi tugas
Menggunakan slot yang dapat menjalankan tugas Map atau Reduce
Menggunakan container yang dapat menjalankan tugas apa pun
Jika Anda melamar pekerjaan data engineering, lihat artikel komprehensif kami tentang pertanyaan wawancara data engineering.
Pertanyaan Wawancara Hadoop Tingkat Lanjut
Sekarang bagian ini mulai menarik. Pertanyaan-pertanyaan ini diajukan untuk menguji Anda pada tingkat lanjut. Pertanyaan-pertanyaan ini sangat penting bagi insinyur senior.
11. Apa konsep Active NameNode dan Standby NameNode di Hadoop 2.0?
Di Hadoop 2.0, Active NameNode mengelola namespace sistem berkas dan mengontrol akses klien ke file. Sebaliknya, Standby NameNode adalah cadangan dan memelihara informasi yang cukup untuk mengambil alih jika Active NameNode gagal.
Ini mengatasi masalah single point of failure (SPOF) yang umum di Hadoop 1.x.
12. Apa tujuan distributed cache di Hadoop? Mengapa HDFS tidak dapat membaca file kecil?
HDFS tidak efisien dalam memproses ribuan file kecil, yang mengakibatkan peningkatan latensi. Karena itu, distributed cache memungkinkan Anda menyimpan file read-only, arsip, dan jar serta membuatnya tersedia untuk tugas-tugas di MapReduce.
Misalkan Anda perlu menjalankan 40 job di MapReduce, dan setiap job perlu mengakses file dari HDFS. Dalam situasi nyata, jumlah ini dapat meningkat menjadi ratusan atau ribuan pembacaan. Aplikasi akan sering mencari lokasi file-file ini di HDFS, yang akan membebani HDFS dan memengaruhi kinerjanya.
Namun, distributed cache dapat menangani banyak file berukuran kecil tanpa mengorbankan waktu akses dan kecepatan pemrosesan.
13. Jelaskan peran checksum dalam mendeteksi data yang rusak. Sebutkan juga kode pendeteksi kesalahan standar.
Checksum mengidentifikasi data yang rusak di HDFS. Saat data masuk ke sistem, dibuat sebuah nilai kecil yang disebut checksum. Hadoop menghitung ulang checksum saat pengguna meminta transfer data. Jika checksum baru cocok dengan yang asli, datanya utuh; jika tidak, berarti rusak.
Kode pendeteksi kesalahan untuk Hadoop adalah CRC-32.
14. Bagaimana HDFS mencapai toleransi kesalahan?
HDFS mencapai toleransi kesalahan melalui proses replikasi yang memastikan keandalan dan ketersediaan. Berikut cara kerja proses replikasi:
15. Bisakah Anda memproses file terkompresi dengan MapReduce? Jika ya, format apa yang didukung, dan apakah dapat dipecah (splittable)?
Ya, file terkompresi dapat diproses dengan MapReduce. Hadoop mendukung beberapa format kompresi, namun tidak semuanya dapat dipecah.
Berikut adalah format yang didukung MapReduce:
Dari semua ini, bzip2 adalah satu-satunya format yang dapat dipecah.
HDFS membagi file yang sangat besar menjadi bagian-bagian lebih kecil, masing-masing 128 MB. Misalnya, HDFS akan memecah file 1,28 GB menjadi sepuluh blok. Setiap blok kemudian diproses oleh mapper terpisah dalam job MapReduce. Namun jika file tidak dapat dipecah, satu mapper akan menangani seluruh file.
Pertanyaan Wawancara Hive
Beberapa pekerjaan memerlukan keahlian integrasi Hive dengan Hadoop. Dalam peran spesifik seperti ini, manajer perekrutan akan berfokus pada pertanyaan-pertanyaan berikut:
16. Definisikan Hive.
Hive adalah sistem gudang data yang menjalankan job batch dan analisis data. Ini dikembangkan oleh Facebook untuk menjalankan kueri mirip SQL pada kumpulan data masif yang disimpan di HDFS tanpa bergantung pada Java.
Dengan Hive, kita dapat mengorganisasi data ke dalam tabel dan menggunakan metastore untuk menyimpan metadata seperti skema. Ia mendukung berbagai sistem penyimpanan, seperti S3, Azure Data Lake Storage (ADLs), dan Google Cloud Storage.
17. Apa itu Hive Metastore (HMS)? Bagaimana Anda membedakan Managed Metastore dari External Metastore?
Hive Metastore (HMS) adalah basis data terpusat untuk metadata. Ini berisi informasi tentang tabel, view, dan izin akses yang disimpan dalam penyimpanan objek HDFS.
Ada dua jenis tabel Hive Metastore:
/user/hive/warehouse.18. Bahasa pemrograman apa yang didukung Hive?
Hive menyediakan dukungan yang kuat untuk integrasi dengan berbagai bahasa pemrograman, meningkatkan fleksibilitas dan kegunaannya dalam berbagai aplikasi:
19. Berapa ukuran data maksimum yang dapat ditangani Hive?
Berkat integrasinya dengan HDFS dan arsitektur yang skalabel, Hive dapat menangani data hingga tingkat petabyte. Tidak ada batas atas tetap pada ukuran data yang dapat dikelola Hive, menjadikannya alat yang kuat untuk pemrosesan dan analitik big data.
20. Ada berapa tipe data di Hive?
Hive menawarkan beragam tipe data untuk menangani berbagai kebutuhan data:
Tipe data bawaan:
Kategori
Tipe data
Deskripsi
Contoh
Tipe numerik
TINYINT
Integer bertanda 1-byte
127
SMALLINT
Integer bertanda 2-byte
32767
INT
Integer bertanda 4-byte
2147483647
BIGINT
Integer bertanda 8-byte
9223372036854775807
FLOAT
Floating-point presisi tunggal
3.14
DOUBLE
Floating-point presisi ganda
3.141592653589793
DECIMAL
Bilangan desimal bertanda presisi sewenang-wenang
1234567890.1234567890
Tipe string
STRING
String panjang variabel
'Hello, World!'
VARCHAR
String panjang variabel dengan panjang maks tertentu
'Example'
CHAR
String panjang tetap
'A'
Tipe Tanggal/Waktu
TIMESTAMP
Tanggal dan waktu, termasuk zona waktu
'2023-01-01 12:34:56'
DATE
Tanggal tanpa waktu
'2023-01-01'
INTERVAL
Selang waktu
INTERVAL '1' DAY
Tipe lain-lain
BOOLEAN
Mewakili true atau false
TRUE
BINARY
Urutan byte
0x1A2B3C
Tipe Data Kompleks:
Tipe Data
Deskripsi
Contoh
ARRAY
Koleksi elemen yang terurut
ARRAY<STRING> ('apple', 'banana', 'cherry')
MAP
Koleksi pasangan key-value
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
STRUCT
Koleksi field dari berbagai tipe data
STRUCT<name: STRING, age: INT> ('Alice', 30)
UNIONTYPE
Dapat menampung salah satu dari beberapa tipe yang ditentukan
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three')
Pertanyaan Wawancara Hadoop Berbasis Skenario untuk Big Data Engineer
Pertanyaan-pertanyaan ini menguji kemampuan Anda menggunakan Hadoop untuk menangani masalah nyata. Pertanyaan ini sangat relevan jika Anda melamar peran arsitek data namun dapat ditanyakan di proses wawancara apa pun yang membutuhkan pengetahuan Hadoop.
21. Anda menyiapkan klaster HDFS dengan sistem replikasi Hadoop. Klaster memiliki tiga rak: A, B, dan C. Jelaskan bagaimana Hadoop akan mereplikasi file bernama datafile.text.
Berikut cara Hadoop mereplikasi data:
Strategi replikasi Hadoop dalam klaster HDFS dengan tiga rak (A, B, dan C) dirancang untuk mengoptimalkan distribusi beban, meningkatkan toleransi kesalahan, dan memperbaiki efisiensi jaringan. Dengan demikian,
datafile.textdireplikasi dengan cara yang menyeimbangkan kinerja dan keandalan.22. Anda mengerjakan aplikasi berbasis Hadoop yang berinteraksi dengan file menggunakan LocalFileSystem. Bagaimana Anda menangani integritas data dengan checksum?
Menggunakan checksum di
LocalFileSystemHadoop memastikan integritas data dengan:.filename.crcdi direktori yang sama.ChecksumExceptionjika terjadi perbedaan.Dengan mengikuti langkah-langkah ini, kita dapat memastikan aplikasi Anda menjaga integritas data dan segera mendeteksi potensi kerusakan data.
23. Misalkan Anda melakukan debug job Hadoop skala besar yang tersebar di beberapa node, dan ada kasus tidak biasa yang memengaruhi keluaran. Bagaimana Anda menanganinya?
Berikut yang dapat kita lakukan:
stderr.Dengan mengikuti langkah-langkah ini, kita dapat melakukan debug job Hadoop skala besar secara sistematis dan secara efektif melacak serta menyelesaikan kasus tidak biasa yang memengaruhi keluaran.
24. Anda menghitung pengaturan memori untuk klaster Hadoop menggunakan YARN. Jelaskan bagaimana Anda akan mengatur memori untuk NodeManager dan job MapReduce.
Saat mengonfigurasi pengaturan memori untuk klaster Hadoop menggunakan YARN, penting untuk menyeimbangkan alokasi memori antara daemon Hadoop, proses sistem, dan NodeManager guna mengoptimalkan kinerja serta pemanfaatan sumber daya.
Mengatur memori untuk NodeManager:
Mengatur memori untuk job MapReduce:
mapreduce.map.memory.mb: Parameter ini menentukan jumlah memori yang dialokasikan untuk setiap tugas map. Sesuaikan pengaturan ini berdasarkan kebutuhan memori tugas map Anda.mapreduce.map.memory.mbke 2048 MB berarti setiap tugas map akan dialokasikan memori 2 GB.mapreduce.reduce.memory.mb: Parameter ini menentukan jumlah memori yang dialokasikan untuk setiap tugas reduce. Sesuaikan berdasarkan kebutuhan memori tugas reduce Anda.mapreduce.reduce.memory.mbke 4096 MB berarti setiap tugas reduce akan dialokasikan memori 4 GB.yarn-site.xmldengan parameter sepertiyarn.nodemanager.resource.memory-mb, yang harus selaras dengan memori yang dialokasikan ke NodeManager.yarn.nodemanager.resource.memory-mbke 59.000 MB.Ringkasan konfigurasi memori:
Komponen
Konfigurasi
Nilai Contoh
NodeManager
Total memori fisik
64.000 MB
Memori untuk daemon Hadoop
3000 MB
Memori untuk proses sistem
2000 MB
Memori tersedia untuk NodeManager
59.000 MB
Tugas map MapReduce
mapreduce.map.memory.mb
2048 MB
Tugas reduce MapReduce
mapreduce.reduce.memory.mb
4096 MB
Ukuran container
yarn.nodemanager.resource.memory-mb
59.000 MB
Pemikiran Akhir
Setelah memahami pertanyaan-pertanyaan ini, Anda seharusnya mengetahui istilah dasar dan memiliki
penguasaan yang kuat atas kompleksitas aplikasi Hadoop di dunia nyata. Selain itu, Anda harus beradaptasi dengan proyek-proyek baru yang dibangun di atas Hadoop untuk tetap relevan dan sukses dalam wawancara.
Anda juga dapat memperluas pengetahuan tentang kerangka kerja big data lainnya, seperti Spark dan Flink, karena keduanya cepat dan memiliki masalah latensi yang lebih rendah dibandingkan Hadoop.
Namun jika Anda mencari jalur belajar terstruktur untuk menguasai big data, Anda dapat melihat sumber daya berikut: