
Kurs
PySpark ile Big Data Temelleri
4 sa
66.8K
Hadoop uzmanları içgörü elde etmek ve veri güvenliğini sağlamak için sürekli değişen veriler üzerinde uygulamalar yazar ve analiz yapar. Bu nedenle işe alım yöneticileri, pozisyona en uygun adayı bulmak için katı kriterlere sahiptir ve temel düzeyden ileri seviyeye kadar her şeyi sorabilirler.
Bu yazıda, en sık sorulan 24 Hadoop mülakat sorusu ve cevabını derledik.
Bu makale, bir sonraki büyük veri iş mülakatınıza kapsamlı şekilde hazırlanmanıza yardımcı olmak için hazırlandı. Temel kavramları ve ileri seviye senaryoları kapsar. İster yeni başlıyor olun ister deneyimli bir profesyonel olun, özgüveninizi artıracak ve başarı şansınızı yükseltecek değerli içgörüler ve pratik bilgiler bulacaksınız.
Görüşmeciler genellikle, Hadoop'u ve büyük veriyi yönetmedeki önemini ne kadar anladığınızı değerlendirmek için temel sorularla başlar.
Deneyimli bir mühendis olsanız bile, bu sorulara hazırlıklı olduğunuzdan emin olun.
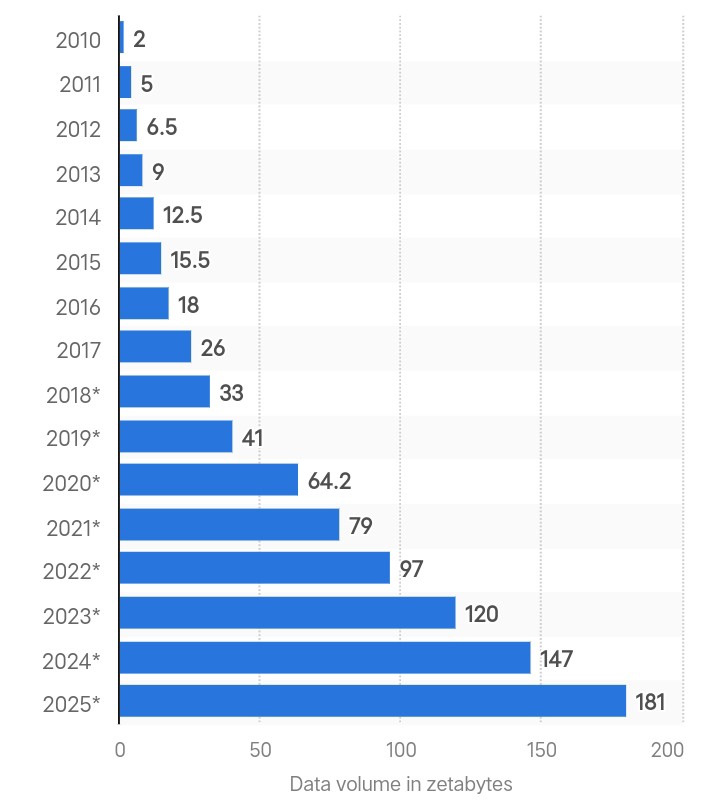
Zettabayt cinsinden küresel veri oluşturulması. Kaynak: Statista.
Büyük veri, yüksek hızda, birden fazla kaynaktan üretilen büyük miktarda karmaşık veriyi ifade eder. Küresel ölçekte oluşturulan toplam veri miktarı 2025'te 180 zettabayttı ve 2029'a kadar üçe katlanması öngörülüyor.
Veri üretimi hızlandıkça, geleneksel analiz yöntemleri gerçek zamanlı işlem ve veri güvenliği sağlayamaz. Bu yüzden şirketler, artan veri hacimlerini işlemek ve yönetmek için Hadoop gibi gelişmiş çerçeveler kullanır.
Büyük veri kariyerine başlamak istiyorsanız, büyük veri eğitimi rehberimize göz atın.
Hadoop, birden çok bilgisayara dağıtılmış büyük veri kümelerini işlemek için açık kaynaklı bir çerçevedir. Verileri, Hadoop Dağıtık Dosya Sistemi (HDFS) kullanarak küçük bloklar halinde birden fazla makineye depolar.
Hadoop ile bir kümeye daha fazla düğüm ekleyebilir ve pahalı donanım yükseltmelerine gerek kalmadan çok büyük verileri yönetebilirsiniz.
Google ve Facebook gibi büyük şirketler bile her gün terabayttan petabayta uzanan verileri yönetmek ve analiz etmek için Hadoop'a güveniyor.
Hadoop'un iki ana bileşeni şunlardır:
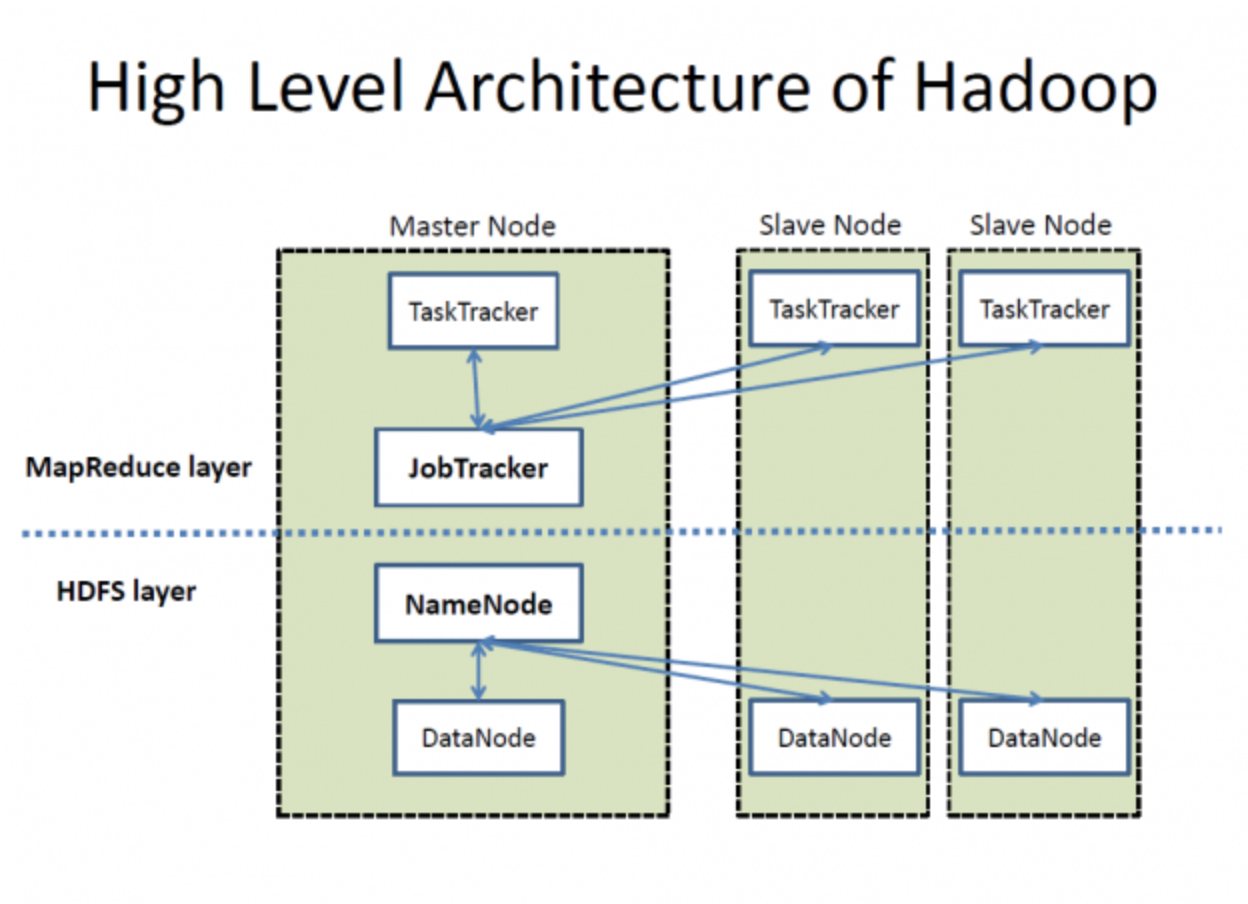
Hadoop'un üst düzey mimarisi. Kaynak: Wikimedia Commons
HDFS, yukarıdaki görselde görüldüğü gibi veri yönetimi için bir NameNode ve birden fazla DataNode'dan oluşur. Çalışma şekilleri şöyledir:
Hadoop 1.x'te MapReduce, JobTracker kullanarak kaynak yönetimi ve iş zamanlamasını yürütür. Ancak yavaş işleme önemli bir dezavantajdır.
Hadoop 2.0, bu sorunları gidermek için YARN'ı (Yet Another Resource Negotiator) tanıttı. YARN, kaynak yönetimi ve iş zamanlamasını ayrı bileşenlere ayırır; bu da ölçeklenebilirliği ve kaynak kullanımını iyileştirir. YARN'ın başlıca bileşenleri şunlardır:
YARN nasıl çalışır:
Orta düzey sorular, Hadoop çerçevesinin teknik ayrıntılarına hâkimiyetinizi ölçmeye daha çok odaklanır. Görüşmeci, Hadoop kümesi, zorlukları ve farklı sürümlerin karşılaştırması hakkında sorular sorabilir.
Hadoop kümesi, büyük veri kümelerini dağıtık şekilde depolamak ve işlemek için tasarlanmış, birbirine bağlı ana ve alt düğümlerden oluşan bir yapıdır. Küme mimarisi yüksek kullanılabilirlik, ölçeklenebilirlik ve hata toleransı sağlar.
Bir Hadoop Kümesinin Bileşenleri:
Bir Hadoop kümesi kurmanın iki temel yolu vardır:
Şirket İçi ve Bulut Tabanlı Kümelerin Karşılaştırması:
|
Özellik |
Şirket içi küme |
Bulut tabanlı küme |
|
Kurulum maliyeti |
Yüksek başlangıç yatırımı |
Kullandıkça öde modeli |
|
Ölçeklenebilirlik |
Fiziksel donanımla sınırlı |
Neredeyse sınırsız |
|
Bakım |
Şirket içi yönetim gerekir |
Bulut sağlayıcı tarafından yönetilir |
|
Esneklik |
Özelleştirilebilir donanım ve yazılım |
Önceden yapılandırılmış seçenekler |
|
Dağıtım süresi |
Daha uzun kurulum süresi |
Hızlı ve kolay dağıtım |
Belirli bir küme boyutu tercihi yoktur. Küme boyutu kolayca ölçeklenebilir ve tamamen depolama gereksinimlerine bağlıdır. Küçük şirketler yaklaşık 20 düğümlü kümelere güvenebilirken, Yahoo gibi işletmeler (veya eskiden) 40.000 düğüm içeren kadar büyük kümelerle çalışmaktadır.
Farklı sektörlerin özel veri analizi ve işleme ihtiyaçları vardır. Bu nedenle Hadoop, ekosisteminin bir parçası olarak bunlara yönelik çözümler sunan birçok proje yayınlamıştır. Hadoop projelerinin listesi tahmin ettiğinizden daha geniştir—ancak en temel olanlar şunlardır:
Hadoop çerçevesi, muazzam miktarda değerli veriyi yönetme ve işleme konusunda mükemmel olsa da bazı kritik zorluklar barındırır.
Bunları şu şekilde anlayalım:
HBase, büyük dosyalara hızlı erişim için tasarlanmış bir veritabanıdır. Verileri sütunlarda depolayarak ve benzersiz satır anahtarlarıyla indeksleyerek büyük veri kümelerini gerçek zamanlı olarak okumanıza ve yazmanıza olanak tanır.
Bu kurulum, gerektiği kadar düğüm ekleyebildiğimiz için büyük ve seyrek tablolar için hızlı veri getirimi ve verimli taramalar sağlar.
HBase üç bileşene sahiptir:
Aşağıdaki tablo her iki Hadoop sürümünü yan yana karşılaştırır:
|
Kriter |
Hadoop 1.x |
Hadoop 2.0 |
|
NameNode yönetimi |
Tek bir NameNode ad alanını yönetir |
Birden çok NameNode, HDFS federasyonu aracılığıyla ad alanlarını yönetir |
|
İşletim sistemi desteği |
Microsoft Windows desteği yok |
Microsoft desteği eklendi |
|
İş ve kaynak yönetimi |
İş ve kaynak yönetimi için JobTracker ve TaskTracker kullanır |
Bu görevleri ayırmak için YARN ile değiştirilmiştir |
|
Ölçeklenebilirlik |
Küme başına 4.000 düğüme kadar ölçeklenebilir |
Küme başına 10.000 düğüme kadar ölçeklenebilir |
|
DataNode boyutu |
64 MB DataNode boyutuna sahiptir |
Boyutu 128 MB'a iki katına çıkarmıştır |
|
Görev yürütme |
Yalnızca Map veya Reduce görevlerini çalıştırabilen slot'lar kullanır |
Her türlü görevi çalıştırabilen konteynerler kullanır |
Bir veri mühendisliği rolüne başvuruyorsanız, veri mühendisliği mülakat soruları hakkındaki kapsamlı makalemize göz atın.
Şimdi işin ilginçleştiği yere geldik. Bu mülakat soruları sizi ileri düzeyde test etmek için sorulur. Özellikle kıdemli mühendisler için önemlidir.
Hadoop 2.0'da Etkin NameNode dosya sistemi ad alanını yönetir ve istemcilerin dosyalara erişimini kontrol eder. Buna karşılık, Yedek NameNode bir yedektir ve Etkin NameNode arızalanırsa devralacak kadar bilgi tutar.
Bu yaklaşım, Hadoop 1.x'te yaygın olan tek hata noktası (SPOF) sorununu giderir.
HDFS, binlerce küçük dosyayı işlerken verimsizdir ve bu da gecikmeyi artırır. Bu nedenle dağıtık önbellek, salt okunur, arşiv ve jar dosyalarını depolamanıza ve bunları MapReduce görevleri için kullanılabilir hale getirmenize olanak tanır.
Diyelim ki MapReduce'ta 40 iş çalıştırmanız gerekiyor ve her iş HDFS'ten dosyaya erişmek zorunda. Gerçek ortamda bu sayı yüzlerce, hatta binlerce okumaya çıkabilir. Uygulama bu dosyaları HDFS'te sık aralıklarla bulacak ve bu da HDFS'i aşırı yükleyip performansını etkileyecektir.
Oysa dağıtık önbellek çok sayıda küçük dosyayı kaldırabilir ve erişim süresi ile işlem hızından ödün vermez.
Sağlama toplamları HDFS'te bozulmuş verileri tespit eder. Veri sisteme girdiğinde, checksum adı verilen küçük bir değer oluşturulur. Bir kullanıcı veri aktarımı istediğinde Hadoop checksum'u yeniden hesaplar. Yeni checksum orijinaliyle eşleşirse veri sağlamdır; eşleşmiyorsa bozuktur.
Hadoop için hata tespit kodu CRC-32'dir.
HDFS, güvenilirlik ve kullanılabilirlik sağlamak için kopyalama süreciyle (replication) hata toleransını sağlar. Kopyalama süreci şöyle işler:
Evet, MapReduce ile sıkıştırılmış dosyaları işlemek mümkündür. Hadoop birden çok sıkıştırma formatını destekler, ancak hepsi bölünebilir değildir.
MapReduce'un desteklediği formatlar şunlardır:
Bunların arasında yalnızca bzip2 bölünebilir bir formattır.
HDFS çok büyük dosyaları, her biri 128 MB olacak şekilde daha küçük parçalara böler. Örneğin, HDFS 1,28 GB'lık bir dosyayı on bloğa ayırır. Her blok daha sonra bir MapReduce işinde ayrı bir mapper tarafından işlenir. Ancak bir dosya bölünemezse tüm dosyayı tek bir mapper işler.
Bazı pozisyonlar, Hadoop ile Hive entegrasyonu konusunda uzmanlık gerektirir. Bu kadar spesifik bir rolde işe alım yöneticisi şu sorulara odaklanacaktır:
Hive, toplu işler ve veri analizleri gerçekleştiren bir veri ambarı sistemidir. Facebook tarafından, HDFS'te depolanan muazzam veri kümeleri üzerinde Java'ya bağımlı olmadan SQL benzeri sorgular çalıştırmak için geliştirilmiştir.
Hive ile verileri tablolara organize edebilir ve şemalar gibi metadataları depolamak için bir megastore kullanabiliriz. S3, Azure Data Lake Storage (ADLs) ve Google Cloud Storage gibi bir dizi depolama sistemini destekler.
Hive Metastore (HMS), metadata için merkezi bir veritabanıdır. HDFS nesne depolamasında tutulan tablolar, görünümler ve erişim izinleri hakkında bilgi içerir.
İki tür HIVE Metastore tablosu vardır:
/user/hive/warehouse değeriyle bulabiliriz. Hive, farklı uygulamalarda çok yönlülüğünü ve kullanılabilirliğini artırarak birden çok programlama diliyle entegrasyon için sağlam destek sunar:
HDFS ile entegrasyonu ve ölçeklenebilir mimarisi sayesinde Hive petabaytlarca veriyi işleyebilir. Hive'ın yönetebileceği veri boyutu için sabit bir üst sınır yoktur; bu da onu büyük veri işleme ve analitiği için güçlü bir araç yapar.
Hive, farklı veri gereksinimlerini karşılamak için zengin bir veri türü seti sunar:
Dahili veri türleri:
|
Kategori |
Veri türü |
Açıklama |
Örnek |
|
Sayısal türler |
TINYINT |
1 bayt işaretli tamsayı |
127 |
|
SMALLINT |
2 bayt işaretli tamsayı |
32767 |
|
|
INT |
4 bayt işaretli tamsayı |
2147483647 |
|
|
BIGINT |
8 bayt işaretli tamsayı |
9223372036854775807 |
|
|
FLOAT |
Tek duyarlıklı kayan nokta |
3.14 |
|
|
DOUBLE |
Çift duyarlıklı kayan nokta |
3.141592653589793 |
|
|
DECIMAL |
Keyfi duyarlıklı işaretli ondalık sayı |
1234567890.1234567890 |
|
|
Metin türleri |
STRING |
Değişken uzunluklu metin |
'Hello, World!' |
|
VARCHAR |
Belirli azami uzunluğa sahip değişken uzunluklu metin |
'Example' |
|
|
CHAR |
Sabit uzunluklu metin |
'A' |
|
|
Tarih/Saat türleri |
TIMESTAMP |
Saat dilimi dahil tarih ve saat |
'2023-01-01 12:34:56' |
|
DATE |
Saat olmadan tarih |
'2023-01-01' |
|
|
INTERVAL |
Zaman aralığı |
INTERVAL '1' DAY |
|
|
Diğer türler |
BOOLEAN |
Doğru veya yanlış değerini temsil eder |
TRUE |
|
BINARY |
Bayt dizisi |
0x1A2B3C |
Karmaşık Veri Türleri:
|
Veri Türü |
Açıklama |
Örnek |
|
ARRAY |
Sıralı öğe koleksiyonu |
ARRAY<STRING> ('apple', 'banana', 'cherry') |
|
MAP |
Anahtar-değer çiftlerinden oluşan koleksiyon |
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2) |
|
STRUCT |
Farklı veri türlerinden alan koleksiyonu |
STRUCT<name: STRING, age: INT> ('Alice', 30) |
|
UNIONTYPE |
Belirtilen türlerden herhangi birini tutabilir |
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three') |
Bu sorular, Hadoop'u gerçek yaşam problemlerini ele almak için kullanma becerinizi test eder. Veri mimarı rolü için başvuruyorsanız özellikle alakalıdır, ancak Hadoop bilgisi gerektiren herhangi bir mülakat sürecinde de sorulabilir.
Hadoop veriyi şu şekilde kopyalar:
Üç raflı (A, B ve C) bir HDFS kümesindeki Hadoop'un kopyalama stratejisi, yük dağılımını optimize etmek, hata toleransını artırmak ve ağ verimliliğini iyileştirmek üzere tasarlanmıştır. Bu sayede datafile.text performans ve güvenilirliği dengeleyecek şekilde çoğaltılır.
Hadoop'un LocalFileSystem içinde sağlama toplamları kullanmak veri bütünlüğünü şu şekilde sağlar:
.filename.crc dosyasında sağlama toplamlarını saklama.ChecksumException fırlatma.Bu adımları izleyerek uygulamanızın veri bütünlüğünü koruyabilir ve olası veri bozulmalarını hızla tespit edebilirsiniz.
Şunları yapabiliriz:
stderr'e yazdırmak için hata ayıklama ifadeleri kullanın.Bu adımları izleyerek büyük ölçekli Hadoop işlerinin hata ayıklamasını sistematik biçimde yapabilir, çıktıyı etkileyen olağan dışı durumları etkin şekilde izleyip çözebilirsiniz.
YARN kullanan bir Hadoop kümesi için bellek ayarlarını yaparken, performansı ve kaynak kullanımını optimize etmek için Hadoop daemonn'ları, sistem süreçleri ve NodeManager arasındaki bellek tahsisini dengelemek önemlidir.
NodeManager için bellek ayarlama:
MapReduce işleri için bellek ayarlama:
mapreduce.map.memory.mb'yi ayarlayın: Bu parametre, her bir map görevi için ayrılan bellek miktarını tanımlar. Map görevlerinizin bellek gereksinimlerine göre bu ayarı yapın.mapreduce.map.memory.mb'yi 2048 MB olarak ayarlamak, her map görevine 2 GB bellek ayrılması anlamına gelir.mapreduce.reduce.memory.mb'yi ayarlayın: Bu parametre, her bir reduce görevi için ayrılan bellek miktarını tanımlar. Reduce görevlerinizin bellek gereksinimlerine göre bu ayarı yapın.mapreduce.reduce.memory.mb'yi 4096 MB olarak ayarlamak, her reduce görevine 4 GB bellek ayrılması anlamına gelir.yarn-site.xml içinde yarn.nodemanager.resource.memory-mb gibi parametrelerle konteyner boyutunun uygun şekilde ayarlandığından emin olun; bu değer NodeManager'a ayrılan bellekle uyumlu olmalıdır.yarn.nodemanager.resource.memory-mb'yi 59.000 MB olarak ayarlayabilirsiniz.Bellek yapılandırmasının özeti:
|
Bileşen |
Yapılandırma |
Örnek Değerler |
|
NodeManager |
Toplam fiziksel bellek |
64.000 MB |
|
Hadoop daemon'ları için bellek |
3000 MB |
|
|
Sistem süreçleri için bellek |
2000 MB |
|
|
NodeManager için kullanılabilir bellek |
59.000 MB |
|
|
MapReduce map görevi |
mapreduce.map.memory.mb |
2048 MB |
|
MapReduce reduce görevi |
mapreduce.reduce.memory.mb |
4096 MB |
|
Konteyner boyutu |
yarn.nodemanager.resource.memory-mb |
59.000 MB |
Bu soruları anladıktan sonra temel terimleri bilmeli ve
gerçek hayattaki Hadoop uygulamalarının karmaşıklıklarına güçlü bir şekilde hâkim olmalısınız. Buna ek olarak, güncel kalmak ve mülakatlarda başarılı olmak için Hadoop üzerinde geliştirilen yeni projelere uyum sağlamalısınız.
Ayrıca, Hadoop'a kıyasla daha hızlı ve daha düşük gecikme sorunlarına sahip oldukları için Spark ve Flink gibi diğer büyük veri çerçeveleri hakkında bilginizi genişletebilirsiniz.
Ancak büyük veriyi ustalıkla öğrenmek için yapılandırılmış bir öğrenme yolu arıyorsanız, aşağıdaki kaynaklara göz atabilirsiniz:
Bu kurslarla veri mühendisliği ve büyük veri hakkında daha fazla bilgi edinin!
Kurs
Kurs
Program
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




