
初轮 HR 数据工程师面试题
在初轮 HR 面试中,HR 经理会询问您的工作经历以及您能为公司带来的价值。此阶段旨在评估您的背景、人际交往能力,以及与公司文化的整体匹配度。
1. 为什么您是该职位的最佳人选?
如果招聘经理选择与您进行电话面试,说明他们在您的履历中看到了亮点。自信作答,谈谈您的经验与职业成长。
面试前务必查看公司的资料与岗位描述。这将帮助您理解招聘方的诉求,并据此定制回答。
重点突出与职位要求相契合的具体技能与经验,如数据管道的设计与管理、建模以及ETL 流程。强调您在技能、经验和知识方面的独特组合如何让您脱颖而出。
2. 数据工程师的日常职责有哪些?
没有绝对标准答案,可结合以往工作经历并参考岗位描述来全面作答。一般而言,数据工程师的日常职责包括:
- 开发、测试与维护数据库。
- 基于业务需求创建数据解决方案。
- 数据获取与集成。
- 为 ETL 流程、建模、转换与服务开发、验证并维护数据管道。
- 在部分场景下,部署与管理机器学习模型。
- 通过清洗、校验与监控数据流来维护数据质量。
- 提升系统的可靠性、性能与质量。
- 遵循数据治理与安全规范,确保合规与数据完整性。
3. 作为数据工程师,您觉得最具挑战的是什么?
此题因人而异,但常见挑战包括:
- 紧跟技术快速演进的步伐,并集成新工具以提升数据系统的性能、安全性、可靠性与投资回报。
- 理解并落实复杂的数据治理与安全策略。
- 制定与管理灾难恢复计划,确保突发事件中的数据可用性与完整性。
- 在业务需求与技术约束之间权衡,并预判未来的数据需求。
- 高效处理海量数据,确保数据质量与一致性。
4. 您熟悉哪些数据工具或框架?是否有偏好的?
您的回答应基于亲身经验。熟悉现代工具与第三方集成有助于自信作答。可讨论如下工具:
- 数据库管理(如 MySQL、PostgreSQL、MongoDB)
- 数据仓库(如 Amazon Redshift、Google BigQuery、Snowflake)
- 数据编排(如 Apache Airflow、Prefect)
- 数据管道(如 Apache Kafka、Apache NiFi)
- 云管理(如 AWS、Google Cloud Platform、Microsoft Azure)
- 数据清洗、建模与转换(如 pandas、dbt、Spark)
- 批处理与实时处理(如 Apache Spark、Apache Flink)
请记住,此题并无标准答案。面试官旨在评估您的技能与经验。
5. 您如何跟进数据工程领域的最新趋势与进展?
此题旨在评估您对持续学习与保持专业前沿的投入。
您可以提及订阅行业简报、关注有影响力的博客、参与在线论坛与社区、参加网络研讨会与会议,以及学习在线课程。可重点说明您常用的资讯来源或平台。
6. 请描述一次您与跨职能团队合作完成项目的经历。
数据工程常与数据科学家、分析师和 IT 团队等多方协作。
分享一个成功协作的具体案例,强调您的沟通能力、理解不同视角的能力,以及您对项目成功的贡献。说明遇到的挑战,以及您如何克服并达成预期结果。
技术类数据工程师面试题
数据工程技术性极强,因此大多数面试流程都会涉及技术问答与演练。本节将涵盖不同类型的技术问题与答案,聚焦初级、Python、SQL、项目型与管理相关的问题。
初级数据工程师面试题
初级工程师面试侧重于工具、Python 与 SQL 查询,也可能涉及数据库管理与 ETL 流程的问题,包括编码挑战与带回家作业。
公司在招聘应届毕业生时,会确认您能否高效处理其数据与系统。
7. 您能解释与数据建模相关的设计模式吗?
主要有三种数据建模设计模式:星型、雪花型与银河型。
- 星型模式:由多个维度表连接至一个中心事实表。结构简单、易于理解,适合编写直接的查询。
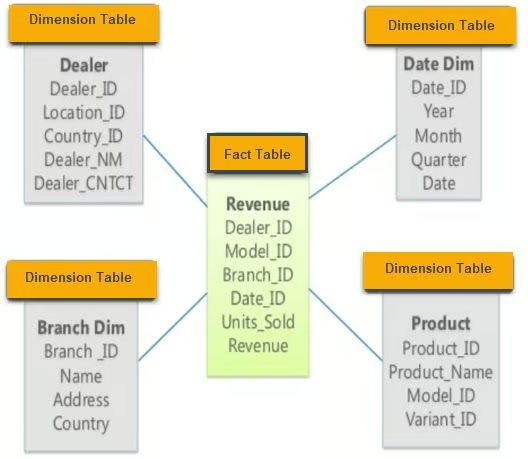
星型模式示例。图片来源 guru99
- 雪花型模式:星型模式的扩展,由事实表与多个维度表组成,并在维度上进一步规范化,形成类似雪花的结构。它可减少冗余并提升数据完整性。
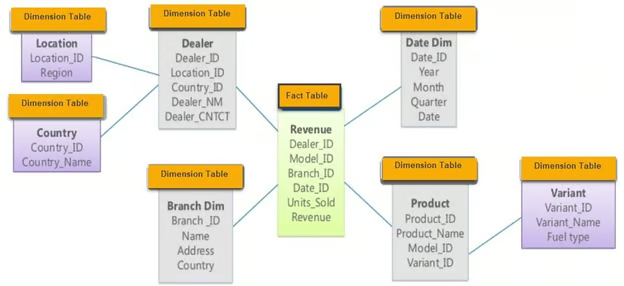
雪花型模式示例。图片来源 guru99
- 银河型模式:又称星座模式,包含两个或以上共享维度表的事实表。适用于需要多个事实表的复杂数据库系统。
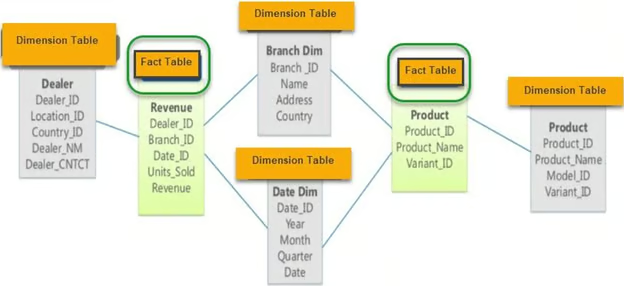
银河型模式示例。图片来源 guru99
8. 您使用过哪些 ETL 工具?最喜欢哪一个?为什么?
作答时请提及您熟练掌握的 ETL 工具,并说明为何在特定项目中选择这些工具。讨论各工具的优缺点,以及它们如何融入您的工作流。常见的开源工具包括:
- dbt(data build tool):非常适合在仓库中使用 SQL 进行数据转换。
- Apache Spark:擅长大规模与批量数据处理。
- Apache Kafka:用于实时数据管道与流式处理。
- Airbyte:开源数据集成工具,支持数据抽取与加载。
若需回顾 ETL 知识,建议学习Introduction to Data Engineering课程。
9. 什么是数据编排?可以使用哪些工具?
数据编排是自动化地从多源访问原始数据,并执行数据清洗、转换与建模等步骤,再将其服务于分析任务的过程。它确保数据在不同系统与处理阶段之间顺畅流动。
常见的数据编排工具包括:
- Apache Airflow:广泛用于调度与监控工作流。
- Prefect:注重数据流的现代编排工具。
- Dagster:为数据密集型工作负载设计的编排工具。
- AWS Glue:托管 ETL 服务,简化分析前的数据准备。
10. 分析工程您会用到哪些工具?
分析工程涉及对已处理数据进行转换、应用统计模型,并通过报表与仪表板可视化展示。
常见工具包括:
- dbt(data build tool):在仓库中用 SQL 进行数据转换。
- BigQuery:全托管、无服务器的数据仓库,适用于大规模分析。
- Postgres:强大的开源关系型数据库。
- Metabase:开源 BI 工具,可用易懂的形式展示数据答案。
- Google Data Studio:用于创建仪表板与可视化报告。
- Tableau:领先的数据可视化平台。
这些工具有助于获取、转换与可视化数据,从而提炼洞见并支持决策。
11. OLAP 与 OLTP 系统有何区别?
OLAP(联机分析处理)用于分析历史数据并支持复杂查询,针对读密集型工作负载进行优化,常用于数据仓库的商业智能任务。OLTP(联机事务处理)用于管理实时事务型数据,针对写密集型工作负载优化,应用于日常业务的操作型数据库。
两者的主要区别在于目的:OLAP 支持决策,OLTP 支持日常运营。
如仍有疑问,建议阅读OLTP 与 OLAP 对比一文。
Python 数据工程师面试题
由于多样性与丰富的生态,Python 是数据工程中最流行的语言之一,可用于数据处理、分析与自动化。以下是数据工程面试中可能遇到的部分 Python 相关问题。
12. 哪些 Python 库在数据处理方面最高效?
常用的数据处理库包括:
- pandas:适用于数据操作与分析,提供类似 DataFrame 的数据结构。
- NumPy:数值计算基础,支持大型多维数组与矩阵。
- Dask:支持并行计算,可用类似 pandas 的语法处理超内存数据。
- PySpark:Apache Spark 的 Python API,适用于大规模数据处理与实时分析。
各库各有优劣,选择取决于数据需求与任务规模。
13. 如何用 Python 进行网页爬取?
Python 爬虫通常包括以下步骤:
1. 使用 requests 访问网页:
import requests
from bs4 import BeautifulSoup
url = 'http://example.com'
response = requests.get(url)
soup = BeautifulSoup(response.text, 'html.parser')2. 用 BeautifulSoup 提取表格与信息:
tables = soup.find_all('table')3. 使用 pandas 转为结构化格式:
import pandas as pd
data = []
for table in tables:
rows = table.find_all('tr')
for row in rows:
cols = row.find_all('td')
cols = [ele.text.strip() for ele in cols]
data.append(cols)
df = pd.DataFrame(data)4. 用 pandas 与 NumPy 清洗数据:
df.dropna(inplace=True) # Drop missing values5. 将数据保存为 CSV:
df.to_csv('scraped_data.csv', index=False)在部分场景下,pandas.read_html 可简化流程:
df_list = pd.read_html('http://example.com')
df = df_list[0] # Assuming the table of interest is the first one14. 如何处理无法全部载入内存的大型数据集?
处理无法放入内存的数据需采用面向外存的工具与技术:
- Dask:支持并行计算,用类似 pandas 的语法处理超内存数据。
import dask.dataframe as dd
df = dd.read_csv('large_dataset.csv')- PySpark:支持分布式数据处理,适合大规模数据。
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName('data_processing').getOrCreate()
df = spark.read.csv('large_dataset.csv', header=True, inferSchema=True)- pandas 分块:按块读取大数据集。
import pandas as pd
chunk_size = 10000
for chunk in pd.read_csv('large_dataset.csv', chunksize=chunk_size):
process(chunk) # Replace with your processing function15. 如何确保 Python 代码高效并经过性能优化?
为确保 Python 代码高效,可考虑以下做法:
- 性能分析:使用
cProfile、line_profiler或memory_profiler定位瓶颈。
import cProfile
cProfile.run('your_function()')- 向量化:用
numpy或pandas的向量化操作替代循环。
import numpy as np
data = np.array([1, 2, 3, 4, 5])
result = data * 2 # Vectorized operation- 高效数据结构:根据场景选择合适的数据结构(如 list、set、dict)。
data_dict = {'key1': 'value1', 'key2': 'value2'} # Faster lookups compared to lists- 并行处理:对可并行的任务使用多线程或多进程。
from multiprocessing import Pool
def process_data(data_chunk):
# Your processing logic here
return processed_chunk
with Pool(processes=4) as pool:
results = pool.map(process_data, data_chunks)- 避免冗余计算:对昂贵操作的结果进行缓存以便复用。
from functools import lru_cache
@lru_cache(maxsize=None)
def expensive_computation(x):
# Perform expensive computation
return result16. 您如何确保数据管道中的数据完整性与质量?
数据完整性与质量对可靠的数据工程至关重要。最佳实践包括:
- 数据校验:在数据管道的各阶段实施格式、取值范围与一致性检查。
def validate_data(df):
assert df['age'].min() >= 0, "Age cannot be negative"
assert df['salary'].dtype == 'float64', "Salary should be a float"
# Additional checks...- 数据清洗:用
pandas等库进行缺失值处理、去重与纠错。
df.dropna(inplace=True) # Drop missing values
df.drop_duplicates(inplace=True) # Remove duplicates- 自动化测试:用
pytest等框架为数据处理函数编写单元测试。
import pytest
def test_clean_data():
raw_data = pd.DataFrame({'age': [25, -3], 'salary': ['50k', '60k']})
clean_data = clean_data_function(raw_data)
assert clean_data['age'].min() >= 0
assert clean_data['salary'].dtype == 'float64'- 监控与告警:为数据管道设置监控,检测异常并在质量问题出现时发出告警。
from airflow import DAG
from airflow.operators.dummy_operator import DummyOperator
from airflow.operators.email_operator import EmailOperator
# Define your DAG and tasks...17. 您如何处理数据集中的缺失值?
处理缺失数据是数据工程的常见任务。方法包括:
- 删除:若缺失数据不具重要性,可直接删除行或列。
df.dropna(inplace=True)- 填补:用统计量(均值、中位数)或更复杂的方法(如 KNN 插补)填补缺失值。
df['column'].fillna(df['column'].mean(), inplace=True)- 指示变量:新增指示变量标明哪些值缺失。
df['column_missing'] = df['column'].isnull().astype(int)- 基于模型的插补:使用预测建模估计缺失值。
from sklearn.impute import KNNImputer
imputer = KNNImputer(n_neighbors=5)
df = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)18. 在 Python 中抓取数据时如何处理 API 速率限制?
应对 API 速率限制可采用以下策略:
- 退避重试:触达限额时使用指数退避策略。
- 分页:利用 API 的分页选项分批获取数据。
- 缓存:缓存响应以避免重复调用。
示例(使用 Python 的 time 与 requests):
import time
import requests
def fetch_data_with_rate_limit(url):
for attempt in range(5): # Retry up to 5 times
response = requests.get(url)
if response.status_code == 429: # Too many requests
time.sleep(2 ** attempt) # Exponential backoff
else:
return response.json()
raise Exception("Rate limit exceeded")Python 无疑是数据工程中最重要的语言之一。您可通过我们的Data Engineer in Python学习路径提升技能,涵盖现代数据工程概念、编程语言、工具与框架。
SQL 数据工程师面试题
SQL 编码阶段是数据工程招聘流程中的重要部分。练习多种简单与复杂脚本有助于备考。面试官可能要求您编写用于数据分析、公共表表达式、排序、添加小计与临时函数的查询。
19. SQL 中的公共表表达式(CTE)是什么?
CTE 用于简化复杂连接与子查询,提升可读性与可维护性。以下示例展示一个 CTE,显示所有主修理科且成绩为 A 的学生:
SELECT *
FROM class
WHERE id IN (
SELECT DISTINCT id
FROM students
WHERE grade = "A"
AND major = "Science"
);使用 CTE,查询可改写为:
WITH temp AS (
SELECT id
FROM students
WHERE grade = "A"
AND major = "Science"
)
SELECT *
FROM class
WHERE id IN (SELECT id FROM temp);CTE 可用于更复杂的问题,并可串联多个 CTE。
20. 如何在 SQL 中为数据排名?
数据工程师常基于销售额、利润等指标进行排名。RANK() 函数可基于特定列进行排名:
SELECT
id,
sales,
RANK() OVER (ORDER BY sales DESC) AS rank
FROM bill;或者使用 DENSE_RANK(),在值相同时不会跳过名次。
21. 能否创建一个简单的临时函数并在 SQL 查询中使用?
与 Python 类似,SQL 中也可创建函数,使查询更优雅并避免重复的 CASE 语句。以下是临时函数 get_gender 的示例:
CREATE TEMPORARY FUNCTION get_gender(type VARCHAR) RETURNS VARCHAR AS (
CASE
WHEN type = "M" THEN "male"
WHEN type = "F" THEN "female"
ELSE "n/a"
END
);
SELECT
name,
get_gender(type) AS gender
FROM class;这种方式可让 SQL 代码更简洁、易维护。
22. 如何在 SQL 中添加小计?
可通过 GROUP BY 与 ROLLUP() 实现。示例:
SELECT
department,
product,
SUM(sales) AS total_sales
FROM sales_data
GROUP BY ROLLUP(department, product);该查询将返回各部门小计以及末尾的总计。
23. 如何在 SQL 中处理缺失数据?
为维护数据完整性,处理缺失数据至关重要。常见方法包括:
- 使用
COALESCE():返回列表中的第一个非空值。
SELECT id, COALESCE(salary, 0) AS salary FROM employees;- 使用
CASE语句:按条件处理缺失值。
SELECT id,
CASE
WHEN salary IS NULL THEN 0
ELSE salary
END AS salary
FROM employees;24. 如何在 SQL 中进行数据聚合?
数据聚合涉及使用 SUM()、AVG()、COUNT()、MIN() 与 MAX() 等函数。示例:
SELECT department,
SUM(salary) AS total_salary,
AVG(salary) AS average_salary,
COUNT(*) AS employee_count
FROM employees
GROUP BY department;25. 如何优化 SQL 查询以提升性能?
可采用以下方式优化查询:
- 在常用查询列上建立索引以加速查找。
- 避免使用
SELECT *,只选择所需列。 - 合理使用连接,避免不必要的连接。
- 在合适场景下用 CTE 替代子查询进行优化。
- 分析执行计划以定位瓶颈。例如:
EXPLAIN ANALYZE
SELECT customer_id, COUNT(order_id)
FROM orders
GROUP BY customer_id;通过解题练习巩固 SQL 概念最为有效。您可参加 DataCamp 的Data Analysis in SQL测评(需登录账号)。
项目相关的数据工程师面试题
在通用面试轮次之后,通常会进入技术阶段,包括编码挑战、问题求解、白板数据库系统设计、带回家考试与分析问题。
该阶段可能较为高强度,熟悉常见的数据工程面试题与答案有助于您脱颖而出。
26. 请从头到尾介绍一个您参与的项目。
如果您以学生或职场身份做过数据工程项目,此题应能较为自然地回答。当然,提前准备总是有益。可按以下结构作答:
- 介绍与业务问题:
- 先说明项目背景,描述要解决的业务问题与项目目标。
- 示例:“本项目旨在优化 TLC Trip Record 数据的处理管道,提升分析团队的查询性能与数据准确性。”
- 数据摄取:
- 描述如何访问与摄取原始数据。
- 示例:“我们使用 GCP、Airflow 与 PostgreSQL 摄取原始的 TLC Trip Record 数据,确保来自多源的数据可靠接入。”
- 数据处理与转换:
- 说明清洗、转换与结构化数据的步骤。
- 示例:“批处理采用 Apache Spark,实时流用 Apache Kafka 处理转换。数据经清洗、校验并转为适于分析的结构化格式。”
- 数据存储与仓库:
- 讨论所用的数据存储方案及其选择理由。
- 示例:“处理后的数据存放在 Google BigQuery,提供可扩展且高效的数据仓库方案。Airflow 用于管理数据工作流。”
- 分析工程:
- 强调用于分析的工具与方法。
- 示例:“我们使用 dbt、BigQuery、PostgreSQL、Google Data Studio 与 Metabase 进行分析工程,构建稳健的数据模型并产出有洞见的报表与仪表板。”
- 部署与云环境:
- 提及部署策略与云基础设施。
- 示例:“项目整体基于 GCP、Terraform 与 Docker 部署,确保云环境的可扩展性与可靠性。”
- 挑战与解决方案:
- 讨论遇到的挑战及应对方式。
- 示例:“主要挑战是实时高吞吐数据处理。我们通过优化 Kafka 流任务与高效的 Spark 转换来应对。”
- 结果与影响:
- 最后描述项目成果与影响。
- 示例:“项目显著提升分析团队的查询性能与数据准确性,加快决策速度并提升洞察质量。”
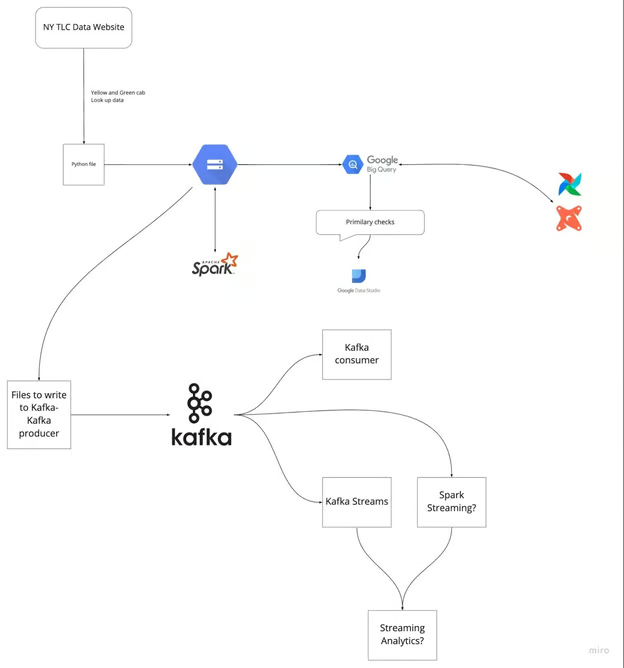
图片来源 DataTalksClub/data-engineering-zoomcamp
提前回顾最近参与的五个项目能帮助您在面试中不至于卡壳。明确问题陈述与所用方案,并练习清晰、简明地阐述每一步。
数据工程经理面试题
对于工程经理岗位,问题通常涉及决策、业务理解、数据集的整理与维护、合规与安全策略等。
27. 数据仓库与操作型数据库有何区别?
数据仓库服务于历史数据的分析与决策,支持高强度的分析型处理(如 OLAP)。数据仓库面向复杂查询、优化读操作,通常支持较少的并发用户,并高效检索大量数据。
操作型数据库管理系统(OLTP)用于实时管理动态数据,支持成千上万客户端的高并发事务处理,适用于日常运营。其数据通常为当前、最新的业务交易与运营信息,优化写操作与快速查询。
28. 为什么所有使用数据系统的公司都需要灾难恢复计划?
灾难管理是数据工程经理的职责之一。灾难恢复计划可确保在网络攻击、硬件故障、自然灾害或其他灾难性事件发生时,数据系统得以恢复并持续运行。关键要点包括:
- 实时备份:定期将文件与数据库备份至安全的异地存储。
- 数据冗余:在不同地域实施数据副本以确保可用性。
- 安全策略:建立监控、追踪与限制进出站流量的策略,以防数据泄露。
- 恢复流程:制定详细的恢复流程,快速高效地恢复数据与系统,尽量减少停机。
- 测试与演练:定期通过模拟与演练验证灾备方案的有效性,并据此调整优化。
29. 带领数据工程团队时,您如何进行决策?
数据工程经理的决策需在技术考量与业务目标之间平衡。常见方法包括:
- 数据驱动:以数据分析为依据,避免凭直觉决策。
- 利益相关者协作:与相关方紧密合作,理解业务需求,使数据工程工作与公司目标保持一致。
- 风险评估:评估潜在风险及其影响,并制定缓解策略。
- 敏捷方法:采用敏捷实践以应对需求变化,并逐步交付价值。
- 指导与发展:通过指导与培训支持团队成长,营造合作氛围。
30. 在数据工程项目中,您如何确保遵守数据保护法规?
合规实践包括:
- 理解法规:持续跟进 GDPR、CCPA、HIPAA 等数据保护法规。
- 数据治理框架:实施健全的数据治理框架,涵盖隐私、安全与访问控制策略。
- 数据加密:对静态与传输中的敏感数据进行加密,防止未授权访问。
- 访问控制:实施严格的访问控制,确保仅授权人员可访问敏感数据。
- 审计与监控:定期进行审计并监控数据访问与使用,及时发现并处理合规问题。
31. 请描述一个您管理过的具有挑战性的 数据工程项目。
讨论挑战性项目时,可聚焦以下方面:
- 项目范围与目标:清晰界定项目目标与要解决的业务问题。
- 遇到的挑战:如技术限制、资源约束或利益相关者协同等具体挑战。
- 策略与方案:说明您如何应对,包括技术方案、团队管理实践与相关方沟通。
- 成果与影响:强调成功结果与业务影响,如提升数据质量、增强系统性能或提高运营效率。
32. 您如何评估与落地新的数据技术?
评估与实施新技术通常包括:
- 市场调研:紧跟数据工程技术的最新进展与趋势。
- 概念验证(PoC):开展 PoC 以在您的业务环境中验证可行性与收益。
- 成本收益分析:评估采用新技术的成本、收益与潜在投资回报。
- 争取支持:向利益相关者呈现结论与建议,争取支持与资源。
- 实施规划:制定包含时间表、资源分配与风险管理的详细计划。
- 培训与支持:为团队提供培训与支持,确保顺利过渡。
33. 在快节奏环境中,您如何为任务与项目排定优先级?
一种有效方法是依据其对业务目标的影响与紧迫性进行排序。您可以使用艾森豪威尔矩阵将任务分为四象限:紧急且重要、重要但不紧急、紧急但不重要、两者皆非。此外,与利益相关者沟通以对齐优先级,确保团队聚焦高价值活动。
FAANG 数据工程师面试题
本节我们探讨 Facebook、Amazon 与 Google 的数据工程管理者最常问的面试题。
Facebook 数据工程师面试题
34. 为什么在 Kafka 中要使用集群?有什么好处?
Kafka 集群由多个 broker 组成,将数据分布在多实例上。此架构提供可扩展性与容错性,且无停机。如果主集群故障,其他 Kafka 集群仍可提供相同服务,确保高可用性。
Kafka 集群架构包含主题(Topics)、代理(Brokers)、ZooKeeper、生产者(Producers)与消费者(Consumers)。它可高效处理大数据应用中的数据流,支撑稳健的数据驱动应用。
35. Apache Airflow 解决了哪些问题?
Apache Airflow 可管理与调度分析工作流、数据仓库管理以及数据转换与建模的管道。它提供:
- 管道管理:定义、调度与监控工作流的平台。
- 集中化日志:在一处查看执行日志。
- 错误处理:通过回调向 Slack、Discord 等平台发送失败告警。
- 用户界面:友好的 UI 便于管理与可视化工作流。
- 集成:与多种工具与系统的强大集成能力。
- 开源:免费使用,并有广泛社区支持。
Amazon 数据工程师面试题
36. 给定一个字符串形式的 IP 地址,如何判断其是否有效?
要判断 IP 地址有效性,可按“.”分割字符串并对各段进行多重校验。以下是 Python 函数示例:
def is_valid(ip):
ip = ip.split(".")
for i in ip:
if len(i) > 3 or int(i) < 0 or int(i) > 255:
return False
if len(i) > 1 and int(i) == 0:
return False
if len(i) > 1 and int(i) != 0 and i[0] == '0':
return False
return True
A = "255.255.11.135"
B = "255.050.11.5345"
print(is_valid(A)) # True
print(is_valid(B)) # False37. Hadoop 有哪些运行模式?
Hadoop 主要有三种模式:
- 单机模式(Standalone):用于调试。不使用 HDFS,依赖本地文件系统进行输入输出。
- 伪分布式模式(Pseudo-distributed):单节点集群,NameNode 与 DataNode 位于同一台机器。主要用于测试与开发。
- 完全分布式模式(Fully distributed):生产就绪模式,数据分布在多节点,主(NameNode)与从(DataNode)守护进程分别在不同节点上。
Google 数据工程师面试题
38. 在 SQL 查询中如何处理重复数据点?
处理重复可使用 DISTINCT 关键字,或结合 ROWID 与 MAX/MIN 删除重复行。示例:
使用 DISTINCT:
SELECT DISTINCT Name, ADDRESS
FROM CUSTOMERS
ORDER BY Name;使用 ROWID 删除重复:
DELETE FROM Employee
WHERE ROWID NOT IN (
SELECT MAX(ROWID)
FROM Employee
GROUP BY Name, ADDRESS
);39. 给定一个包含 n-1 个整数的列表,整数范围为 1 到 n,列表中无重复,有一个整数缺失。请写出高效代码找出缺失的整数。
这一常见编码题可用数学方法解决:
def search_missing_number(list_num):
n = len(list_num)
# Check if the first or last number is missing
if list_num[0] != 1:
return 1
if list_num[-1] != n + 1:
return n + 1
# Calculate the sum of the first n+1 natural numbers
total = (n + 1) * (n + 2) // 2
# Calculate the sum of all elements in the list
sum_of_L = sum(list_num)
# Return the difference, which is the missing number
return total - sum_of_L
# Validation
num_list = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 13]
print("The missing number is", search_missing_number(num_list)) # The missing number is 12如何准备数据工程师面试
在参加面试前,您应回顾数据工程中的各类概念与常用术语。以下是重点关注领域:
- 精通 SQL:练习创建、修改与管理数据库;同时熟练掌握数据分析、建模与转换。
- 攻克编码挑战:练习 Python、Scala 或 C++ 的编程挑战。多数公司会通过带回家作业与现场编码考察编程能力。
- 设计 ETL 管道:练习创建数据、ETL 或交付管道。您需理解如何测试、验证、扩展与维护数据管道。
- 分析工程:练习数据加载、转换与分析。学习为数据质量与系统性能搭建仪表板。
- 回顾潜在问题:通过模拟题备战面试。简单的 Google 搜索即可找到数百道题。
- 了解现代数据工程工具:即使缺乏实战经验,也应了解其工作原理及与其他工具的集成方式。公司总在寻找更高性能且更低成本的工具。
- 学习批处理与流处理:Apache Spark 用于批处理,Apache Kafka 用于流式处理。这些工具需求旺盛,有助于进入顶尖公司。
- 环境:面试官可能会问到云计算(GCP、AWS、Azure)、Docker、脚本、Terraform 与 Kubernetes。您可以用这些工具搭建云端或本地的计算与存储资源。理解这些技术并将其融入作品集项目是良好实践。
准备数据工程面试虽具挑战,但借助合适资源与充分练习,您能脱颖而出、收获理想职位。进一步提升技能与知识,推荐如下资源:
- Understanding Data Engineering:全面理解数据工程的概念与原理。
- Data Engineer in Python:通过该职业路径掌握以 Python 为核心的数据工程要点、工具与框架。
- Database Design:学习数据库设计基础,构建高效、可扩展的数据库。
充分利用这些课程夯实基础,在数据工程职业道路上领先一步。祝您面试顺利!
FAQs
数据工程师面试通常包含哪些环节?
您可以预期经历:HR 电话筛选、技术电话面、带回家作业、编码挑战、现场面试、白板数据库与系统设计、SQL 面试,最后是考察文化契合度的“高层”面试。
有的公司只有三轮,有的则多达九轮。许多组织会设置较高的门槛,从各个层面考察候选人。
数据工程师是否紧缺?
是的,凡是产生数据的公司都需要数据工程师来创建管道、管理并将数据交付给各部门。到 2025 年,我们每天将产生 463 EB 的数据,届时需要越来越多的工程师来抽取、转换与管理数据管道与系统——weforum.org。
数据工程师需要写代码吗?
是的,从事 IT 的人都应学习编程,即便是管理者。对数据工程师而言,Python、SQL、Docker、Yaml 与 Bash 是必要的编程语言/技术。它们用于基础设施即代码、管道、数据库管理、流处理、网页爬取、数据处理、建模与分析。
数据分析师与数据工程师有何区别?
数据工程师负责为数据分析师收集、转换并准备数据,从而提取有价值的业务洞见。数据工程师管理整个数据库系统,并确保为分析任务(如分析报告、仪表板、客户研究与预测)提供高质量数据。
数据工程师的实际工作是什么?
从多源获取数据,创建、验证并维护数据管道;通过算法转换数据;开展分析工程;确保遵循数据治理与安全合规;维护整套数据库系统。他们负责为公司各部门提供高质量的数据流。您可以阅读What is Data Engineering?一文以进一步了解数据工程。
成为数据工程师需要哪些技能?
您需要掌握编程、数据仓库、ETL(抽取-转换-加载)、SQL 查询、数据分析与建模、批判性思维与沟通能力。数据工程通过实践以及解决现场复杂挑战来习得。我们的数据工程认证是构建技能并获得数据工程岗位的理想选择。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
数据工程已成为科技行业中最重要的岗位之一,为全球公司的数据基础设施提供支撑。随着企业越来越依赖数据驱动的决策,对熟练数据工程师的需求持续增长。
如果您正在准备数据工程面试,需要熟悉通用与技术类问题,以评估您的经验、解决问题的能力以及技术技能。
在本文中,我们提供一份全面指南,帮助您为数据工程面试的不同阶段做好准备,从最初的 HR 筛选到深入的技术评估。