Les experts Hadoop développent des applications et analysent des données en constante évolution afin d'obtenir des informations pertinentes et de garantir la sécurité des données. C'est pourquoi les responsables du recrutement ont des critères stricts pour trouver le candidat idéal pour le poste et peuvent vous poser toutes sortes de questions, des plus basiques aux plus avancées.
Dans cet article, nous avons rassemblé les 24 questions et réponses les plus fréquemment posées lors d'entretiens d'embauche concernant Hadoop.
Cet article a pour objectif de vous aider à vous préparer de manière approfondie à votre prochain entretien d'embauche dans le domaine du big data. Il couvre les concepts fondamentaux et les scénarios avancés. Que vous soyez débutant ou professionnel expérimenté, vous trouverez des informations précieuses et pratiques qui vous permettront de renforcer votre confiance et d'augmenter vos chances de réussite.
Questions d'entretien de base sur Hadoop
Les recruteurs commencent généralement l'entretien en posant des questions fondamentales afin d'évaluer votre compréhension de Hadoop et son importance dans la gestion des mégadonnées.
Même si vous êtes un ingénieur expérimenté, assurez-vous d'avoir répondu à ces questions.
1. Qu'est-ce que le big data ?
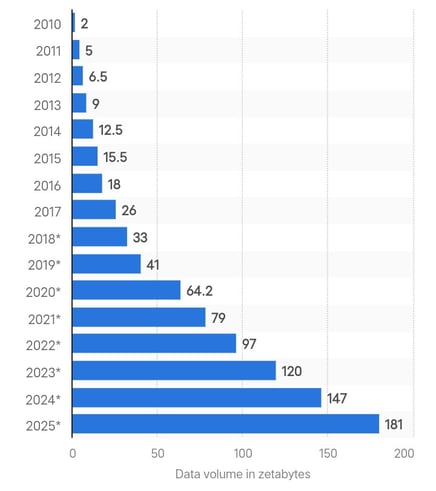
Création mondiale de données en zettaoctets. Source : Statista.
Le terme « mégadonnées » désigne les quantités considérables de données complexes générées à grande vitesse à partir de multiples sources. La quantité totale de données créées à l'échelle mondiale s'élevait à 180 zettaoctets en 2025 et devrait tripler d'ici 2029.
À mesure que la génération de données s'accélère, les méthodes d'analyse traditionnelles ne seront plus en mesure d'assurer le traitement en temps réel et la sécurité des données. C'est pourquoi les entreprises utilisent des infrastructures avancées telles que Hadoop pour traiter et gérer des volumes de données croissants.
Si vous souhaitez débuter votre carrière dans le domaine du big data, veuillez consulter notre guide sur les formations en big data.
Hadoop est un framework open source permettant de traiter de grands ensembles de données répartis sur plusieurs ordinateurs. Il stocke les données sur plusieurs machines sous forme de petits blocs à l'aide du système de fichiers distribués Hadoop (HDFS).
Avec Hadoop, il est possible d'ajouter des nœuds à un cluster et de traiter de grandes quantités de données sans avoir à procéder à des mises à niveau matérielles coûteuses.
Même de grandes entreprises telles que Google et Facebook s'appuient sur Hadoop pour gérer et analyser des téraoctets, voire des pétaoctets, de données quotidiennes.
3. Quels sont les deux principaux composants de Hadoop ?
Voici les deux principaux composants de Hadoop :
- Système de fichiers distribués Hadoop (HDFS) : Il gère le stockage des données en divisant les fichiers volumineux en blocs, chacun d'une taille par défaut de 128 Mo, et les distribue sur plusieurs nœuds d'un cluster.
- MapReduce : Il s'agit d'un modèle de programmation sur lequel Hadoop s'appuie pour le traitement des données. Il s'agit d'un processus en deux phases comprenant la cartographie et la réduction des tâches. Le mappage consiste à prendre les données et à les convertir en un autre ensemble de données. Le réducteur utilise les paires de valeurs générées par la tâche de mappage comme données d'entrée et les combine en paires plus petites. L'objectif est de les traiter dans une fonction de réduction définie par l'utilisateur.
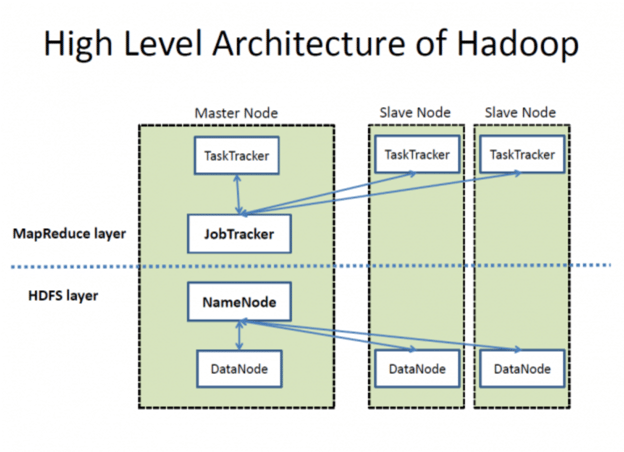
Architecture de haut niveau de Hadoop. Source : Wikimedia Commons
4. Veuillez définir le rôle de NameNode et DataNode dans Hadoop.
HDFS se compose d'un NameNode et de plusieurs DataNodes pour la gestion des données, comme illustré dans l'image ci-dessus. Voici comment ils fonctionnent :
- En tant que serveur principal dans HDFS, NameNode gère des opérations telles que l'ouverture, la fermeture et le renommage de fichiers. Il conserve les métadonnées relatives aux autorisations et à l'emplacement des blocs.
- Les DataNodes, quant à eux, agissent comme des nœuds de travail pour stocker les blocs de données réels d'un fichier. Lorsqu'un client doit lire ou écrire des données, il obtient l'emplacement des blocs de données à partir des NameNodes. Par la suite, le client communique directement avec les DataNodes concernés afin d'effectuer les opérations requises.
5. Veuillez expliquer le rôle de Hadoop YARN.
Dans Hadoop 1.x, MapReduce gère la gestion des ressources et la planification des tâches à l'aide de JobTracker. Cependant, la lenteur du traitement constitue un inconvénient majeur.
Hadoop 2.0 a introduit YARN (Yet Another Resource Negotiator) afin de résoudre ces problèmes. YARN sépare la gestion des ressources et la planification des tâches en composants distincts, ce qui améliore l'évolutivité et l'utilisation des ressources. Les principaux composants de YARN sont les suivants :
- ResourceManager (RM): Gère les ressources à travers le cluster.
- s sur NodeManager (NM): Gère les ressources et surveille les nœuds individuels.
- ApplicationMaster (AM): Gère le cycle de vie des applications, y compris leurs besoins en ressources et leur exécution.
Fonctionnement de YARN :
- s relatives à la soumission de tâches: Le client soumet une demande au cluster YARN.
- Allocation des ressources: Le ResourceManager commence à allouer les ressources en coordination avec l'ApplicationMaster.
- s relatives à l'inscription à ApplicationMaster: ApplicationMaster s'enregistre auprès de ResourceManager.
- Négociation de conteneurs: ApplicationMaster négocie les ressources (conteneurs) auprès de ResourceManager.
- Lancement du conteneur: Une fois les ressources allouées, ApplicationMaster demande aux NodeManagers de lancer les conteneurs.
- s d'exécution de l'application: Le code de l'application est exécuté dans les conteneurs alloués.
Questions d'entretien de niveau intermédiaire sur Hadoop
Les questions intermédiaires sont davantage axées sur l'évaluation de vos connaissances techniques du cadre Hadoop. L'intervieweur peut vous interroger sur le cluster Hadoop, ses défis et la comparaison entre différentes versions.
6. Qu'est-ce qu'un cluster Hadoop, et existe-t-il une taille de cluster spécifique que les entreprises privilégient ?
Un cluster Hadoop est un ensemble de nœuds maîtres et esclaves interconnectés, conçu pour stocker et traiter de grands ensembles de données de manière distribuée. L'architecture en cluster garantit une haute disponibilité, une évolutivité et une tolérance aux pannes.
Composants d'un cluster Hadoop :
- s des nœuds maîtres: Ces nœuds gèrent les ressources du cluster et le système de fichiers distribué. Les composants clés comprennent :
- s sur NameNode: Gère l'espace de noms du système de fichiers distribués Hadoop (HDFS) et contrôle l'accès aux fichiers par les clients.
- ResourceManager: Gère l'allocation des ressources pour l'exécution des applications.
- Nœuds esclaves: Ces nœuds sont chargés de stocker les données et d'effectuer des calculs. Les composants clés comprennent :
- s sur DataNode: Stocke les blocs de données réels dans HDFS.
- s sur NodeManager: Gère l'exécution des conteneurs sur le nœud.
Il existe deux méthodes principales pour configurer un cluster Hadoop :
- s relatives aux clusters sur site: Veuillez utiliser des composants matériels standard pour constituer votre cluster. Cette approche peut être rentable et personnalisable en fonction des exigences spécifiques.
- de cluster basé sur le cloud: Nous vous recommandons d'opter pour des services basés sur le cloud tels qu'Amazon EMR, Google Cloud Dataproc ou Azure HDInsight. Cette méthode offre flexibilité, évolutivité et réduction des frais généraux de gestion.
Comparaison entre les clusters sur site et les clusters basés sur le cloud :
|
Caractéristique
|
Cluster sur site
|
Cluster basé sur le cloud
|
|
Frais d'installation
|
Investissement initial plus élevé
|
Modèle de paiement à l'utilisation
|
|
Évolutivité
|
Limité par le matériel physique
|
Pratiquement illimité
|
|
Entretien
|
Nécessite une gestion interne
|
Géré par le fournisseur de services cloud
|
|
Flexibilité
|
Matériel et logiciels personnalisables
|
Options préconfigurées
|
|
Durée de déploiement
|
Temps de configuration prolongé
|
Déploiement rapide et simple
|
Il n'y a pas de préférence particulière quant à la taille des clusters. La taille du cluster est facilement modulable et dépend entièrement des besoins en matière de stockage. Les petites entreprises peuvent s'appuyer sur des clusters d'environ 20 nœuds, tandis que des sociétés telles que Yahoo fonctionnent (ou fonctionnaient) sur des clusters pouvant contenir jusqu'à 40 000 nœuds.
7. Quels sont les projets de l'écosystème Hadoop ?
Les différents secteurs ont des besoins spécifiques en matière d'analyse et de traitement des données. Hadoop a donc lancé de nombreux projets afin de fournir des solutions adaptées à ces besoins dans le cadre de son écosystème. La liste des projets Hadoop est plus longue que vous ne pouvez l'imaginer, mais voici les plus importants :
- s MapReduce: Modèle de programmation pour le traitement de grands ensembles de données à l'aide d'un algorithme parallèle et distribué.
- s sur Apache Hive: Une infrastructure d'entrepôt de données pour la synthèse, la requête et l'analyse de données à l'aide de HiveQL.
- s Apache HBase: Un magasin de données volumineuses évolutif offrant un accès en lecture/écriture en temps réel à des ensembles de données de grande taille.
- s sur Apache Pig: Une plateforme de haut niveau pour la création de programmes MapReduce avec Pig Latin.
- s sur Apache Sqoop: Un outil permettant de transférer des données en masse entre Hadoop et des bases de données structurées telles que les bases de données relationnelles.
- s sur Apache Flume: Un service permettant de collecter, d'agréger et de transférer efficacement de grandes quantités de données de journaux.
- s sur Apache Oozie: Système de planification des flux de travail pour gérer les tâches Hadoop et leurs dépendances.
- Apache Zookeeper: Service centralisé pour la gestion des informations de configuration et la synchronisation distribuée.
- s sur Apache Spark: Système de calcul en grappe rapide et polyvalent avec traitement en mémoire.
- s sur Apache Storm: Système de calcul en temps réel pour le traitement de flux de données volumineux.
- s sur Apache Kafka: Une plateforme de streaming distribuée pour la gestion des flux de données en temps réel.
8. Quels sont les défis courants liés à Hadoop ?
Bien que le framework Hadoop soit remarquable pour gérer et traiter d'énormes quantités de données précieuses, il présente certains défis importants.
Comprenons-les :
- Le principal problème avec Hadoop est que son NameNode présente un point de défaillance unique, ce qui entraîne une perte de données en cas de panne.
- Hadoop est susceptible de présenter des vulnérabilités en matière de sécurité. Vous ne pouvez pas contrôler directement vos données et il n'y a aucun moyen de savoir si elles sont utilisées à mauvais escient.
- Le framework MapReduce de Hadoop traite les données par lots et ne prend pas en charge le traitement des données en temps réel.
- Ce cadre fonctionne efficacement avec des données de grande capacité, mais ne peut pas traiter les fichiers de petite taille. Lorsque les données sont plus petites que la taille de bloc HDFS par défaut, cela surcharge le NameNode et entraîne des problèmes de latence.
9. Qu'est-ce que HBase et quel est le rôle de ses composants ?
HBase est une base de données conçue pour permettre un accès rapide à des fichiers volumineux. Il vous permet de lire et d'écrire de grands ensembles de données en temps réel en stockant les données dans des colonnes et en les indexant à l'aide de clés de ligne uniques.
Cette configuration permet une récupération rapide des données et des analyses efficaces, ce qui convient aux tableaux volumineux et peu peuplés, car nous pouvons ajouter autant de nœuds que nécessaire.
HBase comprend trois composants :
- Maître : Il gère les serveurs régionaux et est chargé de créer et de supprimer des tableaux.
- Serveur régional : Il traite les demandes de lecture et d'écriture et gère les divisions régionales.
- ZooKeeper: Il assure la gestion de l'état du cluster et gère les affectations des serveurs.
10. Quelles sont les différences entre Hadoop 2.0 et Hadoop 1.x ?
Ce tableau compare les deux versions de Hadoop côte à côte :
|
Critères
|
Hadoop 1.x
|
Hadoop 2.0
|
|
Gestion du NameNode
|
Un seul NameNode gère l'espace de noms.
|
Plusieurs NameNodes gèrent les espaces de noms via la fédération HDFS.
|
|
Prise en charge du système d'exploitation
|
Il n'y a pas de prise en charge pour Microsoft Windows.
|
Ajout de la prise en charge de Microsoft
|
|
Gestion des tâches et des ressources
|
Utilise JobTracker et TaskTracker pour la gestion des tâches et des ressources.
|
Les avons remplacés par YARN afin de séparer les deux tâches.
|
|
Évolutivité
|
Peut évoluer jusqu'à 4 000 nœuds par cluster
|
Peut évoluer jusqu'à 10 000 nœuds par cluster
|
|
Taille du DataNode
|
Dispose d'une taille DataNode de 64 Mo.
|
A doublé la taille pour atteindre 128 Mo.
|
|
Exécution des tâches
|
Utilise des emplacements pouvant exécuter des tâches Map ou Reduce.
|
Utilise des conteneurs capables d'exécuter n'importe quelle tâche.
|
Si vous postulez à un poste d'ingénieur de données, veuillez consulter notre article complet sur les questions d'entretien relatives à l'ingénierie des données.
Questions d'entretien avancées sur Hadoop
C'est là que les choses deviennent intéressantes. Ces questions d'entretien sont posées afin d'évaluer vos compétences à un niveau avancé. Ces questions revêtent une importance particulière pour les ingénieurs seniors.
11. Quel est le concept de NameNode actif et de NameNode de secours dans Hadoop 2.0 ?
Dans Hadoop 2.0, le NameNode actif gère l'espace de noms du système de fichiers et contrôle l'accès des clients aux fichiers. Au contraire, le Standby NameNode est une sauvegarde et conserve suffisamment d'informations pour prendre le relais en cas de défaillance du NameNode actif.
Ceci résout le problème du point de défaillance unique (SPOF), courant dans Hadoop 1. x.
12. Quel est l'objectif du cache distribué dans Hadoop ? Pourquoi HDFS ne peut-il pas lire les fichiers de petite taille ?
HDFS n'est pas efficace pour traiter des milliers de petits fichiers, ce qui entraîne une augmentation de la latence. C'est pourquoi le cache distribué vous permet de stocker des fichiers en lecture seule, des fichiers d'archive et des fichiers jar, et de les rendre disponibles pour les tâches dans MapReduce.
Supposons que vous deviez exécuter 40 tâches dans MapReduce et que chaque tâche doive accéder au fichier depuis HDFS. En temps réel, ce nombre peut atteindre des centaines, voire des milliers de lectures. L'application localisera fréquemment ces fichiers dans HDFS, ce qui surchargera HDFS et affectera ses performances.
Cependant, un cache distribué peut gérer un grand nombre de fichiers de petite taille sans compromettre le temps d'accès ni la vitesse de traitement.
13. Veuillez expliquer le rôle de la somme de contrôle dans la détection des données corrompues. Veuillez également définir le code standard de détection des erreurs.
Les sommes de contrôle permettent d'identifier les données corrompues dans HDFS. Lorsque les données sont introduites dans le système, elles génèrent une petite valeur appelée « somme de contrôle ». Hadoop recalcule la somme de contrôle lorsqu'un utilisateur demande un transfert de données. Si la nouvelle somme de contrôle correspond à l'originale, les données sont intactes ; dans le cas contraire, elles sont corrompues.
Le code de détection d'erreur pour Hadoop est CRC-32.
HDFS assure la tolérance aux pannes grâce à un processus de réplication qui garantit la fiabilité et la disponibilité. Voici comment fonctionne le processus de réplication :
- Distribution initiale des blocs : Lorsqu'un fichier est enregistré, HDFS le divise en blocs et les attribue à différents DataNodes. Par exemple, un fichier divisé en blocs A, B et C peut être stocké sur les nœuds de données A1, B2 et C3.
- Réplication : Chaque DataNode contenant un bloc réplique ce bloc vers les autres DataNodes du cluster. Par exemple, le DataNode A1, qui contient le bloc A, créera des copies supplémentaires sur d'autres DataNodes, tels que D1 et D2. Cela signifie que si A1 tombe en panne, les copies de A1 sur D1 et D2 seront disponibles.
- Gestion des défaillances : Si le DataNode D1 tombe en panne, il est possible de récupérer les blocs requis (B et C) à partir d'autres DataNodes tels que B2 et C3.
Oui, il est possible de traiter des fichiers compressés avec MapReduce. Hadoop prend en charge plusieurs formats de compression, mais tous ne sont pas divisibles.
Voici les formats pris en charge par MapReduce :
- DÉFLATION
- gzip
- bzip2
- LZO
- LZ4
- Vif
Parmi tous ces formats, bzip2 est le seul format fractionnable.
HDFS divise les fichiers de très grande taille en parties plus petites, chacune d'une taille de 128 Mo. Par exemple, HDFS divisera un fichier de 1,28 Go en dix blocs. Chaque bloc est ensuite traité par un mappeur distinct dans une tâche MapReduce. Cependant, si un fichier ne peut pas être divisé, un seul mappeur traite l'intégralité du fichier.
Questions d'entretien Hive
Certains postes requièrent une expertise dans l'intégration de Hive avec Hadoop. Dans le cadre d'un poste aussi spécifique, le responsable du recrutement se concentrera sur les questions suivantes :
16. Définir Hive.
Hive est un système d'entrepôt de données qui exécute des tâches par lots et des analyses de données. Il a été développé par Facebook pour exécuter des requêtes de type SQL sur des ensembles de données volumineux stockés dans HDFS sans dépendre de Java.
Avec Hive, nous pouvons organiser les données dans des tableaux et utiliser un mégastore pour stocker des métadonnées telles que des schémas. Il prend en charge une gamme de systèmes de stockage, tels que S3, Azure Data Lake Storage (ADL) et Google Cloud Storage.
Le Hive Metastore (HMS) est une base de données centralisée pour les métadonnées. Il contient des informations sur les tables, les vues et les autorisations d'accès stockées dans le stockage d'objets HDFS.
Il existe deux types de tables HIVE Metastore :
- Métastore géré : HIVE stocke et gère ce tableau dans le service JVM de Hive. Nous pouvons localiser ces tableaux en utilisant cette valeur par défaut :
/user/hive/warehouse.
- Métastore externe : Ces tableaux fonctionnent sur une JVM externe. Par conséquent, toute modification apportée aux métadonnées de Hive n'affecte pas les données stockées dans ces tableaux.
18. Quels langages de programmation Hive prend-il en charge ?
Hive offre une prise en charge solide pour l'intégration avec plusieurs langages de programmation, ce qui améliore sa polyvalence et sa facilité d'utilisation dans différentes applications :
- Python: Analyse de données et apprentissage automatique.
- Java : Applications d'entreprise et traitement de données personnalisé.
- C++ : Applications critiques en termes de performances et SerDes personnalisés.
- PHP: Applications Web permettant d'accéder aux données Hive.
19. Quelle est la taille maximale de données que Hive peut gérer ?
Grâce à son intégration avec HDFS et à son architecture évolutive, Hive est capable de traiter des pétaoctets de données. Il n'y a pas de limite supérieure fixe à la taille des données que Hive peut gérer, ce qui en fait un outil puissant pour le traitement et l'analyse des mégadonnées.
20. Combien de types de données existe-t-il dans Hive ?
Hive propose un ensemble complet de types de données pour répondre à différentes exigences en matière de données :
- Types de données intégrés : Numérique, chaîne de caractères, date/heure et divers pour le stockage de données de base.
- Types de données complexes : ARRAY, MAP, STRUCT et UNIONTYPE pour des représentations de données plus avancées et structurées.
Types de données intégrés :
|
Catégorie
|
Type de données
|
Description
|
Exemple
|
|
Types numériques
|
TINYINT
|
entier signé à 1 octet
|
127
|
| |
SMALLINT
|
entier signé à 2 octets
|
32767
|
| |
INT
|
Entier signé de 4 octets
|
2147483647
|
| |
BIGINT
|
Entier signé de 8 octets
|
9223372036854775807
|
| |
FLOAT
|
Précision simple en virgule flottante
|
3,14
|
| |
DOUBLE
|
Double précision en virgule flottante
|
3.141592653589793
|
| |
DÉCIMAL
|
Nombre décimal signé à précision arbitraire
|
1234567890.1234567890
|
|
Types de chaînes
|
STRING
|
Chaîne de longueur variable
|
Bonjour, tout le monde !
|
| |
VARCHAR
|
Chaîne de longueur variable avec longueur maximale spécifiée
|
« Exemple »
|
| |
CHAR
|
Chaîne de longueur fixe
|
'A'
|
|
Types Date/Heure
|
TIMESTAMP
|
Date et heure, y compris le fuseau horaire
|
'2023-01-01 12:34:56'
|
| |
DATE
|
Date sans heure
|
'2023-01-01'
|
| |
INTERVAL
|
Intervalle de temps
|
INTERVALLE « 1 » JOUR
|
|
Types divers
|
BOOLÉEN
|
Représente vrai ou faux
|
VRAI
|
| |
BINAIRE
|
Séquence d'octets
|
0x1A2B3C
|
Types de données complexes :
|
Type de données
|
Description
|
Exemple
|
|
ARRAY
|
Collection ordonnée d'éléments
|
ARRAY<STRING> ('pomme', 'banane', 'cerise')
|
|
MAP
|
Collection de paires clé-valeur
|
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
|
|
STRUCT
|
Ensemble de champs de différents types de données
|
STRUCT<nom : STRING, âge : INT> (« Alice », 30 ans)
|
|
UNIONTYPE
|
Peut contenir l'un des types spécifiés
|
UNIONTYPE<INT, DOUBLE, STRING> (1, 2,0, « trois »)
|
Questions d'entretien Hadoop basées sur des scénarios pour les ingénieurs Big Data
Ces questions évaluent votre capacité à utiliser Hadoop pour résoudre des problèmes concrets. Ces questions sont particulièrement pertinentes si vous postulez à un poste d'architecte de données, mais elles peuvent être posées lors de tout entretien d'embauche nécessitant des connaissances en Hadoop.
Voici comment Hadoop procède à la réplication des données :
- Première réplique sur le rack A : Hadoop place la réplique initiale sur un nœud choisi aléatoirement dans le rack A. Cette décision minimise la latence d'écriture en sélectionnant un nœud local ou proche.
- Deuxième réplique sur le rack B : La deuxième réplique est placée sur un nœud dans un rack différent, tel que le rack B. Cela garantit que les données ne seront pas perdues en cas de défaillance du rack A, améliorant ainsi la tolérance aux pannes.
- Troisième réplique sur le rack B : La troisième réplique est placée sur un autre nœud du rack B. Le fait de la placer sur le même rack que la deuxième permet d'équilibrer la charge réseau entre les racks et de réduire le trafic inter-racks.
La stratégie de réplication de Hadoop dans un cluster HDFS comprenant trois racks (A, B et C) est conçue pour optimiser la répartition de la charge, renforcer la tolérance aux pannes et améliorer l'efficacité du réseau. De cette manière, l'datafile.text est reproduite de manière à équilibrer performances et fiabilité.
L'utilisation de sommes de contrôle dans l' LocalFileSystem de Hadoop garantit l'intégrité des données en :
- Génération des sommes de contrôle : Création automatique de sommes de contrôle pour les blocs de données lors de l'écriture de fichiers.
- Stockage des sommes de contrôle : Enregistrement des sommes de contrôle dans un fichier caché nommé «
.filename.crc » situé dans le même répertoire.
- Vérification des sommes de contrôle : Comparaison des sommes de contrôle enregistrées avec les données réelles lors des lectures.
- Détection des incohérences :
ChecksumException Signaler toute anomalie en cas de divergences.
En suivant ces étapes, nous pouvons garantir que votre application préserve l'intégrité des données et détecte rapidement toute corruption potentielle des données.
Voici ce que nous pouvons réaliser :
- Problèmes potentiels liés aux journaux : Veuillez utiliser les instructions de débogage pour consigner les problèmes potentiels dans
stderr.
- Mettre à jour le statut de la tâche : Veuillez inclure les emplacements des journaux d'erreurs dans les messages d'état des tâches.
- Compteurs personnalisés : Mettre en place des compteurs pour suivre et analyser les conditions inhabituelles.
- Débogage de la sortie de la carte : Veuillez enregistrer les informations de débogage dans la sortie de la carte.
- Programme d'analyse des journaux : Veuillez créer un programme MapReduce pour l'analyse détaillée des journaux.
En suivant ces étapes, nous pouvons systématiquement déboguer les tâches Hadoop à grande échelle et suivre et résoudre efficacement les cas inhabituels affectant le résultat.
Lors de la configuration des paramètres de mémoire pour un cluster Hadoop à l'aide de YARN, il est essentiel d'équilibrer l'allocation de mémoire entre les démons Hadoop, les processus système et le NodeManager afin d'optimiser les performances et l'utilisation des ressources.
Configuration de la mémoire pour NodeManager :
- Veuillez calculer la mémoire physique totale du nœud : Déterminez la mémoire physique totale disponible sur chaque nœud du cluster. Par exemple, si un nœud dispose de 64 Go de RAM, sa mémoire physique totale est de 64 000 Mo.
- Déduire la mémoire pour les démons Hadoop : Allouez de la mémoire aux démons Hadoop s'exécutant sur le nœud, tels que DataNode et NodeManager. En général, 1 000 à 2 000 Mo par démon sont suffisants. Par exemple, si vous allouez 1 500 Mo à DataNode et 1 500 Mo à NodeManager, il est nécessaire de réserver 3 000 Mo.
- Réserver de la mémoire pour les processus système : Réservez de la mémoire pour les autres processus système et services d'arrière-plan afin de garantir le bon fonctionnement du système d'exploitation et des services essentiels. Une réservation type peut être de 2 Go (2000 Mo).
- Allouer la mémoire restante pour NodeManager : Soustrayez la mémoire réservée aux démons Hadoop et aux processus système de la mémoire physique totale afin de déterminer la mémoire disponible que NodeManager peut allouer aux conteneurs.
Configuration de la mémoire pour les tâches MapReduce :
- Veuillez ajuster l'
mapreduce.map.memory.mb: Ce paramètre définit la quantité de mémoire allouée à chaque tâche de mappage. Veuillez ajuster ce paramètre en fonction des besoins en mémoire de vos tâches cartographiques.
- Par exemple, définir
mapreduce.map.memory.mb sur 2048 Mo signifie que chaque tâche de mappage se verra allouer 2 Go de mémoire.
- Veuillez ajuster l'
mapreduce.reduce.memory.mb: Ce paramètre définit la quantité de mémoire allouée à chaque tâche de réduction. Veuillez ajuster ce paramètre en fonction des besoins en mémoire de vos tâches de réduction.
- Par exemple, définir
mapreduce.reduce.memory.mb sur 4096 Mo signifie que chaque tâche de réduction se verra allouer 4 Go de mémoire.
- Configurer la taille du conteneur : Veuillez vous assurer que la taille du conteneur est correctement définie dans
yarn-site.xml à l'aide de paramètres tels que yarn.nodemanager.resource.memory-mb, qui doivent correspondre à la mémoire allouée au NodeManager.
- Par exemple, si le NodeManager dispose de 59 000 Mo, vous pouvez définir
yarn.nodemanager.resource.memory-mb sur 59 000 Mo.
Résumé de la configuration de la mémoire :
|
Composant
|
Configuration
|
Exemples de valeurs
|
|
NodeManager
|
Mémoire physique totale
|
64 000 MO
|
| |
Mémoire pour les démons Hadoop
|
3000 MO
|
| |
Mémoire pour les processus système
|
2000 MO
|
| |
Mémoire disponible pour NodeManager
|
59 000 MO
|
|
Tâche de cartographie MapReduce
|
mapreduce.map.memory.mb
|
2048 MO
|
|
Tâche de réduction MapReduce
|
mapreduce.reduce.memory.mb
|
4096 MO
|
|
Taille du conteneur
|
yarn.nodemanager.resource.memory-mb
|
59 000 MO
|
Conclusions finales
Après avoir compris ces questions, vous devriez connaître les termes de base et avoir une
Maîtrise approfondie des complexités des applications Hadoop dans la vie réelle. De plus, il est nécessaire de vous adapter aux nouveaux projets développés sur Hadoop afin de rester compétitif et de réussir vos entretiens.
Vous pouvez également approfondir vos connaissances sur d'autres frameworks Big Data, tels que Spark et Flink, car ils sont rapides et présentent moins de problèmes de latence que Hadoop.
Si vous recherchez un parcours d'apprentissage structuré pour maîtriser le big data, vous pouvez consulter les ressources suivantes :
- Principes fondamentaux du Big Data avec PySpark: Ce cours constitue un excellent point de départ pour acquérir les bases du traitement des mégadonnées avec PySpark.
- Le Big Data avec PySpark: Ce cursus offre une introduction complète aux concepts du big data à l'aide de PySpark, couvrant des aspects tels que la manipulation des données, l'apprentissage automatique, et bien plus encore.




Les experts Hadoop développent des applications et analysent des données en constante évolution afin d'obtenir des informations pertinentes et de garantir la sécurité des données. C'est pourquoi les responsables du recrutement ont des critères stricts pour trouver le candidat idéal pour le poste et peuvent vous poser toutes sortes de questions, des plus basiques aux plus avancées.
Dans cet article, nous avons rassemblé les 24 questions et réponses les plus fréquemment posées lors d'entretiens d'embauche concernant Hadoop.
Cet article a pour objectif de vous aider à vous préparer de manière approfondie à votre prochain entretien d'embauche dans le domaine du big data. Il couvre les concepts fondamentaux et les scénarios avancés. Que vous soyez débutant ou professionnel expérimenté, vous trouverez des informations précieuses et pratiques qui vous permettront de renforcer votre confiance et d'augmenter vos chances de réussite.
Questions d'entretien de base sur Hadoop
Les recruteurs commencent généralement l'entretien en posant des questions fondamentales afin d'évaluer votre compréhension de Hadoop et son importance dans la gestion des mégadonnées.
Même si vous êtes un ingénieur expérimenté, assurez-vous d'avoir répondu à ces questions.
1. Qu'est-ce que le big data ?
Création mondiale de données en zettaoctets. Source : Statista.
Le terme « mégadonnées » désigne les quantités considérables de données complexes générées à grande vitesse à partir de multiples sources. La quantité totale de données créées à l'échelle mondiale s'élevait à 180 zettaoctets en 2025 et devrait tripler d'ici 2029.
À mesure que la génération de données s'accélère, les méthodes d'analyse traditionnelles ne seront plus en mesure d'assurer le traitement en temps réel et la sécurité des données. C'est pourquoi les entreprises utilisent des infrastructures avancées telles que Hadoop pour traiter et gérer des volumes de données croissants.
Si vous souhaitez débuter votre carrière dans le domaine du big data, veuillez consulter notre guide sur les formations en big data.
2. Qu'est-ce que Hadoop et comment résout-il le problème du big data ?
Hadoop est un framework open source permettant de traiter de grands ensembles de données répartis sur plusieurs ordinateurs. Il stocke les données sur plusieurs machines sous forme de petits blocs à l'aide du système de fichiers distribués Hadoop (HDFS).
Avec Hadoop, il est possible d'ajouter des nœuds à un cluster et de traiter de grandes quantités de données sans avoir à procéder à des mises à niveau matérielles coûteuses.
Même de grandes entreprises telles que Google et Facebook s'appuient sur Hadoop pour gérer et analyser des téraoctets, voire des pétaoctets, de données quotidiennes.
3. Quels sont les deux principaux composants de Hadoop ?
Voici les deux principaux composants de Hadoop :
Architecture de haut niveau de Hadoop. Source : Wikimedia Commons
4. Veuillez définir le rôle de NameNode et DataNode dans Hadoop.
HDFS se compose d'un NameNode et de plusieurs DataNodes pour la gestion des données, comme illustré dans l'image ci-dessus. Voici comment ils fonctionnent :
5. Veuillez expliquer le rôle de Hadoop YARN.
Dans Hadoop 1.x, MapReduce gère la gestion des ressources et la planification des tâches à l'aide de JobTracker. Cependant, la lenteur du traitement constitue un inconvénient majeur.
Hadoop 2.0 a introduit YARN (Yet Another Resource Negotiator) afin de résoudre ces problèmes. YARN sépare la gestion des ressources et la planification des tâches en composants distincts, ce qui améliore l'évolutivité et l'utilisation des ressources. Les principaux composants de YARN sont les suivants :
Fonctionnement de YARN :
Questions d'entretien de niveau intermédiaire sur Hadoop
Les questions intermédiaires sont davantage axées sur l'évaluation de vos connaissances techniques du cadre Hadoop. L'intervieweur peut vous interroger sur le cluster Hadoop, ses défis et la comparaison entre différentes versions.
6. Qu'est-ce qu'un cluster Hadoop, et existe-t-il une taille de cluster spécifique que les entreprises privilégient ?
Un cluster Hadoop est un ensemble de nœuds maîtres et esclaves interconnectés, conçu pour stocker et traiter de grands ensembles de données de manière distribuée. L'architecture en cluster garantit une haute disponibilité, une évolutivité et une tolérance aux pannes.
Composants d'un cluster Hadoop :
Il existe deux méthodes principales pour configurer un cluster Hadoop :
Comparaison entre les clusters sur site et les clusters basés sur le cloud :
Caractéristique
Cluster sur site
Cluster basé sur le cloud
Frais d'installation
Investissement initial plus élevé
Modèle de paiement à l'utilisation
Évolutivité
Limité par le matériel physique
Pratiquement illimité
Entretien
Nécessite une gestion interne
Géré par le fournisseur de services cloud
Flexibilité
Matériel et logiciels personnalisables
Options préconfigurées
Durée de déploiement
Temps de configuration prolongé
Déploiement rapide et simple
Il n'y a pas de préférence particulière quant à la taille des clusters. La taille du cluster est facilement modulable et dépend entièrement des besoins en matière de stockage. Les petites entreprises peuvent s'appuyer sur des clusters d'environ 20 nœuds, tandis que des sociétés telles que Yahoo fonctionnent (ou fonctionnaient) sur des clusters pouvant contenir jusqu'à 40 000 nœuds.
7. Quels sont les projets de l'écosystème Hadoop ?
Les différents secteurs ont des besoins spécifiques en matière d'analyse et de traitement des données. Hadoop a donc lancé de nombreux projets afin de fournir des solutions adaptées à ces besoins dans le cadre de son écosystème. La liste des projets Hadoop est plus longue que vous ne pouvez l'imaginer, mais voici les plus importants :
8. Quels sont les défis courants liés à Hadoop ?
Bien que le framework Hadoop soit remarquable pour gérer et traiter d'énormes quantités de données précieuses, il présente certains défis importants.
Comprenons-les :
9. Qu'est-ce que HBase et quel est le rôle de ses composants ?
HBase est une base de données conçue pour permettre un accès rapide à des fichiers volumineux. Il vous permet de lire et d'écrire de grands ensembles de données en temps réel en stockant les données dans des colonnes et en les indexant à l'aide de clés de ligne uniques.
Cette configuration permet une récupération rapide des données et des analyses efficaces, ce qui convient aux tableaux volumineux et peu peuplés, car nous pouvons ajouter autant de nœuds que nécessaire.
HBase comprend trois composants :
10. Quelles sont les différences entre Hadoop 2.0 et Hadoop 1.x ?
Ce tableau compare les deux versions de Hadoop côte à côte :
Critères
Hadoop 1.x
Hadoop 2.0
Gestion du NameNode
Un seul NameNode gère l'espace de noms.
Plusieurs NameNodes gèrent les espaces de noms via la fédération HDFS.
Prise en charge du système d'exploitation
Il n'y a pas de prise en charge pour Microsoft Windows.
Ajout de la prise en charge de Microsoft
Gestion des tâches et des ressources
Utilise JobTracker et TaskTracker pour la gestion des tâches et des ressources.
Les avons remplacés par YARN afin de séparer les deux tâches.
Évolutivité
Peut évoluer jusqu'à 4 000 nœuds par cluster
Peut évoluer jusqu'à 10 000 nœuds par cluster
Taille du DataNode
Dispose d'une taille DataNode de 64 Mo.
A doublé la taille pour atteindre 128 Mo.
Exécution des tâches
Utilise des emplacements pouvant exécuter des tâches Map ou Reduce.
Utilise des conteneurs capables d'exécuter n'importe quelle tâche.
Si vous postulez à un poste d'ingénieur de données, veuillez consulter notre article complet sur les questions d'entretien relatives à l'ingénierie des données.
Questions d'entretien avancées sur Hadoop
C'est là que les choses deviennent intéressantes. Ces questions d'entretien sont posées afin d'évaluer vos compétences à un niveau avancé. Ces questions revêtent une importance particulière pour les ingénieurs seniors.
11. Quel est le concept de NameNode actif et de NameNode de secours dans Hadoop 2.0 ?
Dans Hadoop 2.0, le NameNode actif gère l'espace de noms du système de fichiers et contrôle l'accès des clients aux fichiers. Au contraire, le Standby NameNode est une sauvegarde et conserve suffisamment d'informations pour prendre le relais en cas de défaillance du NameNode actif.
Ceci résout le problème du point de défaillance unique (SPOF), courant dans Hadoop 1. x.
12. Quel est l'objectif du cache distribué dans Hadoop ? Pourquoi HDFS ne peut-il pas lire les fichiers de petite taille ?
HDFS n'est pas efficace pour traiter des milliers de petits fichiers, ce qui entraîne une augmentation de la latence. C'est pourquoi le cache distribué vous permet de stocker des fichiers en lecture seule, des fichiers d'archive et des fichiers jar, et de les rendre disponibles pour les tâches dans MapReduce.
Supposons que vous deviez exécuter 40 tâches dans MapReduce et que chaque tâche doive accéder au fichier depuis HDFS. En temps réel, ce nombre peut atteindre des centaines, voire des milliers de lectures. L'application localisera fréquemment ces fichiers dans HDFS, ce qui surchargera HDFS et affectera ses performances.
Cependant, un cache distribué peut gérer un grand nombre de fichiers de petite taille sans compromettre le temps d'accès ni la vitesse de traitement.
13. Veuillez expliquer le rôle de la somme de contrôle dans la détection des données corrompues. Veuillez également définir le code standard de détection des erreurs.
Les sommes de contrôle permettent d'identifier les données corrompues dans HDFS. Lorsque les données sont introduites dans le système, elles génèrent une petite valeur appelée « somme de contrôle ». Hadoop recalcule la somme de contrôle lorsqu'un utilisateur demande un transfert de données. Si la nouvelle somme de contrôle correspond à l'originale, les données sont intactes ; dans le cas contraire, elles sont corrompues.
Le code de détection d'erreur pour Hadoop est CRC-32.
14. Comment HDFS assure-t-il la tolérance aux pannes ?
HDFS assure la tolérance aux pannes grâce à un processus de réplication qui garantit la fiabilité et la disponibilité. Voici comment fonctionne le processus de réplication :
15. Est-il possible de traiter un fichier compressé avec MapReduce ? Si oui, quels formats sont pris en charge et peuvent-ils être fractionnés ?
Oui, il est possible de traiter des fichiers compressés avec MapReduce. Hadoop prend en charge plusieurs formats de compression, mais tous ne sont pas divisibles.
Voici les formats pris en charge par MapReduce :
Parmi tous ces formats, bzip2 est le seul format fractionnable.
HDFS divise les fichiers de très grande taille en parties plus petites, chacune d'une taille de 128 Mo. Par exemple, HDFS divisera un fichier de 1,28 Go en dix blocs. Chaque bloc est ensuite traité par un mappeur distinct dans une tâche MapReduce. Cependant, si un fichier ne peut pas être divisé, un seul mappeur traite l'intégralité du fichier.
Questions d'entretien Hive
Certains postes requièrent une expertise dans l'intégration de Hive avec Hadoop. Dans le cadre d'un poste aussi spécifique, le responsable du recrutement se concentrera sur les questions suivantes :
16. Définir Hive.
Hive est un système d'entrepôt de données qui exécute des tâches par lots et des analyses de données. Il a été développé par Facebook pour exécuter des requêtes de type SQL sur des ensembles de données volumineux stockés dans HDFS sans dépendre de Java.
Avec Hive, nous pouvons organiser les données dans des tableaux et utiliser un mégastore pour stocker des métadonnées telles que des schémas. Il prend en charge une gamme de systèmes de stockage, tels que S3, Azure Data Lake Storage (ADL) et Google Cloud Storage.
17. Qu'est-ce qu'un Hive Metastore (HMS) ? Comment distingueriez-vous un métastore géré d'un métastore externe ?
Le Hive Metastore (HMS) est une base de données centralisée pour les métadonnées. Il contient des informations sur les tables, les vues et les autorisations d'accès stockées dans le stockage d'objets HDFS.
Il existe deux types de tables HIVE Metastore :
/user/hive/warehouse.18. Quels langages de programmation Hive prend-il en charge ?
Hive offre une prise en charge solide pour l'intégration avec plusieurs langages de programmation, ce qui améliore sa polyvalence et sa facilité d'utilisation dans différentes applications :
19. Quelle est la taille maximale de données que Hive peut gérer ?
Grâce à son intégration avec HDFS et à son architecture évolutive, Hive est capable de traiter des pétaoctets de données. Il n'y a pas de limite supérieure fixe à la taille des données que Hive peut gérer, ce qui en fait un outil puissant pour le traitement et l'analyse des mégadonnées.
20. Combien de types de données existe-t-il dans Hive ?
Hive propose un ensemble complet de types de données pour répondre à différentes exigences en matière de données :
Types de données intégrés :
Catégorie
Type de données
Description
Exemple
Types numériques
TINYINT
entier signé à 1 octet
127
SMALLINT
entier signé à 2 octets
32767
INT
Entier signé de 4 octets
2147483647
BIGINT
Entier signé de 8 octets
9223372036854775807
FLOAT
Précision simple en virgule flottante
3,14
DOUBLE
Double précision en virgule flottante
3.141592653589793
DÉCIMAL
Nombre décimal signé à précision arbitraire
1234567890.1234567890
Types de chaînes
STRING
Chaîne de longueur variable
Bonjour, tout le monde !
VARCHAR
Chaîne de longueur variable avec longueur maximale spécifiée
« Exemple »
CHAR
Chaîne de longueur fixe
'A'
Types Date/Heure
TIMESTAMP
Date et heure, y compris le fuseau horaire
'2023-01-01 12:34:56'
DATE
Date sans heure
'2023-01-01'
INTERVAL
Intervalle de temps
INTERVALLE « 1 » JOUR
Types divers
BOOLÉEN
Représente vrai ou faux
VRAI
BINAIRE
Séquence d'octets
0x1A2B3C
Types de données complexes :
Type de données
Description
Exemple
ARRAY
Collection ordonnée d'éléments
ARRAY<STRING> ('pomme', 'banane', 'cerise')
MAP
Collection de paires clé-valeur
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
STRUCT
Ensemble de champs de différents types de données
STRUCT<nom : STRING, âge : INT> (« Alice », 30 ans)
UNIONTYPE
Peut contenir l'un des types spécifiés
UNIONTYPE<INT, DOUBLE, STRING> (1, 2,0, « trois »)
Questions d'entretien Hadoop basées sur des scénarios pour les ingénieurs Big Data
Ces questions évaluent votre capacité à utiliser Hadoop pour résoudre des problèmes concrets. Ces questions sont particulièrement pertinentes si vous postulez à un poste d'architecte de données, mais elles peuvent être posées lors de tout entretien d'embauche nécessitant des connaissances en Hadoop.
21. Vous configurez un cluster HDFS avec le système de réplication de Hadoop. Le cluster comprend trois racks : A, B et C. Veuillez expliquer comment Hadoop répliquera un fichier nommé datafile.text.
Voici comment Hadoop procède à la réplication des données :
La stratégie de réplication de Hadoop dans un cluster HDFS comprenant trois racks (A, B et C) est conçue pour optimiser la répartition de la charge, renforcer la tolérance aux pannes et améliorer l'efficacité du réseau. De cette manière, l'
datafile.textest reproduite de manière à équilibrer performances et fiabilité.22. Vous travaillez sur une application basée sur Hadoop qui interagit avec des fichiers à l'aide de LocalFileSystem. Comment allez-vous gérer l'intégrité des données à l'aide d'une somme de contrôle ?
L'utilisation de sommes de contrôle dans l'
LocalFileSystemde Hadoop garantit l'intégrité des données en :.filename.crc» situé dans le même répertoire.ChecksumExceptionSignaler toute anomalie en cas de divergences.En suivant ces étapes, nous pouvons garantir que votre application préserve l'intégrité des données et détecte rapidement toute corruption potentielle des données.
23. Supposons que vous déboguez une tâche Hadoop à grande échelle répartie sur plusieurs nœuds et que des cas inhabituels affectent le résultat. Comment réagiriez-vous dans une telle situation ?
Voici ce que nous pouvons réaliser :
stderr.En suivant ces étapes, nous pouvons systématiquement déboguer les tâches Hadoop à grande échelle et suivre et résoudre efficacement les cas inhabituels affectant le résultat.
24. Vous configurez les paramètres de mémoire d'un cluster Hadoop à l'aide de YARN. Veuillez expliquer comment vous configureriez la mémoire pour les tâches NodeManager et MapReduce.
Lors de la configuration des paramètres de mémoire pour un cluster Hadoop à l'aide de YARN, il est essentiel d'équilibrer l'allocation de mémoire entre les démons Hadoop, les processus système et le NodeManager afin d'optimiser les performances et l'utilisation des ressources.
Configuration de la mémoire pour NodeManager :
Configuration de la mémoire pour les tâches MapReduce :
mapreduce.map.memory.mb: Ce paramètre définit la quantité de mémoire allouée à chaque tâche de mappage. Veuillez ajuster ce paramètre en fonction des besoins en mémoire de vos tâches cartographiques.mapreduce.map.memory.mbsur 2048 Mo signifie que chaque tâche de mappage se verra allouer 2 Go de mémoire.mapreduce.reduce.memory.mb: Ce paramètre définit la quantité de mémoire allouée à chaque tâche de réduction. Veuillez ajuster ce paramètre en fonction des besoins en mémoire de vos tâches de réduction.mapreduce.reduce.memory.mbsur 4096 Mo signifie que chaque tâche de réduction se verra allouer 4 Go de mémoire.yarn-site.xmlà l'aide de paramètres tels queyarn.nodemanager.resource.memory-mb, qui doivent correspondre à la mémoire allouée au NodeManager.yarn.nodemanager.resource.memory-mbsur 59 000 Mo.Résumé de la configuration de la mémoire :
Composant
Configuration
Exemples de valeurs
NodeManager
Mémoire physique totale
64 000 MO
Mémoire pour les démons Hadoop
3000 MO
Mémoire pour les processus système
2000 MO
Mémoire disponible pour NodeManager
59 000 MO
Tâche de cartographie MapReduce
mapreduce.map.memory.mb
2048 MO
Tâche de réduction MapReduce
mapreduce.reduce.memory.mb
4096 MO
Taille du conteneur
yarn.nodemanager.resource.memory-mb
59 000 MO
Conclusions finales
Après avoir compris ces questions, vous devriez connaître les termes de base et avoir une
Maîtrise approfondie des complexités des applications Hadoop dans la vie réelle. De plus, il est nécessaire de vous adapter aux nouveaux projets développés sur Hadoop afin de rester compétitif et de réussir vos entretiens.
Vous pouvez également approfondir vos connaissances sur d'autres frameworks Big Data, tels que Spark et Flink, car ils sont rapides et présentent moins de problèmes de latence que Hadoop.
Si vous recherchez un parcours d'apprentissage structuré pour maîtriser le big data, vous pouvez consulter les ressources suivantes :