Gli esperti di Hadoop scrivono applicazioni e analizzano dati in continuo cambiamento per ottenere insight e mantenere la sicurezza dei dati. Per questo i responsabili delle assunzioni hanno criteri rigorosi per trovare la persona più adatta e possono chiederti di tutto, dalle basi agli aspetti avanzati.
In questo articolo abbiamo raccolto le 24 domande e risposte su Hadoop più comuni ai colloqui.
Questo articolo ti aiuterà a prepararti a fondo per il tuo prossimo colloquio nell’ambito dei big data. Copre concetti fondamentali e scenari avanzati. Che tu sia all’inizio o un professionista esperto, troverai spunti preziosi e indicazioni pratiche per aumentare la fiducia e migliorare le tue possibilità di successo.
Domande di base su Hadoop
Di solito i colloqui iniziano con domande di base per valutare la tua comprensione di Hadoop e la sua rilevanza nella gestione dei big data.
Anche se sei un ingegnere esperto, assicurati di avere chiari questi argomenti.
1. Che cosa sono i big data?
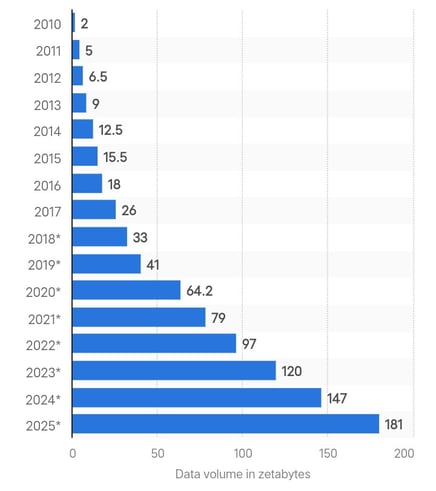
Creazione di dati globali in zettabyte. Fonte: Statista.
Big data indica enormi quantità di dati complessi generati ad alta velocità da più fonti. Il totale dei dati creati a livello globale è stato di 180 zettabyte nel 2025 e si prevede che triplicherà entro il 2029.
Con l’accelerazione della generazione dei dati, i metodi tradizionali di analisi non riescono a garantire elaborazione in tempo reale e sicurezza. Ecco perché le aziende usano framework avanzati come Hadoop per elaborare e gestire volumi di dati in crescita.
Se vuoi iniziare una carriera nei big data, dai un’occhiata alla nostra guida alla formazione sui big data.
2. Che cos’è Hadoop e come risolve il problema dei big data?
Hadoop è un framework open-source per la gestione di grandi dataset distribuiti su più computer. Archivia i dati su più macchine come blocchi di piccole dimensioni tramite l’Hadoop Distributed File System (HDFS).
Con Hadoop puoi aggiungere altri nodi a un cluster e gestire molti dati senza costosi upgrade dell’hardware.
Anche grandi aziende come Google e Facebook si affidano a Hadoop per gestire e analizzare da terabyte a petabyte di dati quotidiani.
3. Quali sono i due componenti principali di Hadoop?
I due componenti principali di Hadoop sono:
- Hadoop Distributed File System (HDFS): gestisce l’archiviazione suddividendo i file grandi in chunk di dimensione a blocchi, ciascuno da 128 MB per impostazione predefinita, e distribuendoli su più nodi in un cluster.
- MapReduce: è il modello di programmazione su cui Hadoop fa affidamento per l’elaborazione dei dati. Consiste in due fasi: mapping e reducing. Il mapping prende i dati e li converte in un altro insieme di dati. Il reducer prende le coppie chiave-valore in output dal job di mappa come input e le combina in coppie più piccole, per poi elaborarle con una funzione di reduce definita dall’utente.
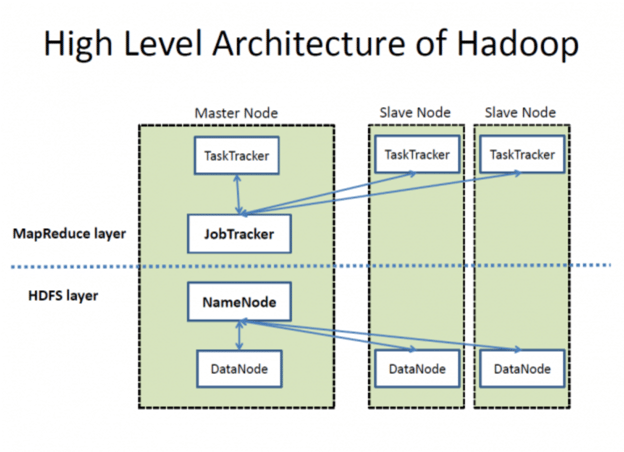
Architettura di alto livello di Hadoop. Fonte: Wikimedia Commons
4. Definisci il ruolo di NameNode e DataNode in Hadoop.
HDFS è composto da un NameNode e più DataNode per la gestione dei dati, come si vede nell’immagine sopra. Ecco come funzionano:
- Come server master in HDFS, il NameNode gestisce operazioni come apertura, chiusura e rinomina dei file. Mantiene i metadati dei permessi e la posizione dei blocchi.
- I DataNode, invece, agiscono come nodi worker per archiviare i blocchi di dati reali di un file. Quando un client deve leggere o scrivere dati, ottiene la posizione dei blocchi dal NameNode. Dopo di che, il client comunica direttamente con i DataNode pertinenti per eseguire le operazioni richieste.
5. Spiega il ruolo di Hadoop YARN.
In Hadoop 1.x, MapReduce gestisce la gestione delle risorse e la schedulazione dei job tramite JobTracker. Tuttavia, la lentezza di elaborazione è un notevole svantaggio.
Hadoop 2.0 ha introdotto YARN (Yet Another Resource Negotiator) per affrontare questi problemi. YARN disaccoppia gestione delle risorse e schedulazione dei job in componenti separati, migliorando scalabilità e utilizzo delle risorse. I componenti principali di YARN sono:
- ResourceManager (RM): gestisce le risorse nel cluster.
- NodeManager (NM): gestisce le risorse e il monitoraggio dei singoli nodi.
- ApplicationMaster (AM): gestisce il ciclo di vita delle applicazioni, incluse le loro necessità di risorse e l’esecuzione.
Come funziona YARN:
- Invio del job: il client invia un’applicazione al cluster YARN.
- Allocazione delle risorse: il ResourceManager inizia ad allocare le risorse coordinandosi con l’ApplicationMaster.
- Registrazione dell’ApplicationMaster: l’ApplicationMaster si registra presso il ResourceManager.
- Negoziazione dei container: l’ApplicationMaster negozia risorse (container) con il ResourceManager.
- Avvio dei container: una volta assegnate le risorse, l’ApplicationMaster indica ai NodeManager di avviare i container.
- Esecuzione dell’applicazione: il codice dell’applicazione viene eseguito all’interno dei container assegnati.
Domande intermedie su Hadoop
Le domande intermedie mirano maggiormente a valutare la tua conoscenza degli aspetti tecnici del framework Hadoop. Il selezionatore può chiederti del cluster Hadoop, delle sue sfide e del confronto tra diverse versioni.
6. Che cos’è un cluster Hadoop e c’è una dimensione di cluster preferita dalle aziende?
Un cluster Hadoop è un insieme di nodi master e slave interconnessi progettato per archiviare ed elaborare grandi dataset in modo distribuito. L’architettura del cluster garantisce alta disponibilità, scalabilità e tolleranza ai guasti.
Componenti di un cluster Hadoop:
- Nodi master: questi nodi gestiscono le risorse del cluster e il file system distribuito. Componenti chiave:
- NameNode: gestisce lo spazio dei nomi (namespace) di HDFS e regola l’accesso ai file da parte dei client.
- ResourceManager: gestisce l’allocazione delle risorse per l’esecuzione delle applicazioni.
- Nodi slave: questi nodi sono responsabili dell’archiviazione dei dati e dell’esecuzione dei calcoli. Componenti chiave:
- DataNode: archivia i blocchi di dati reali in HDFS.
- NodeManager: gestisce l’esecuzione dei container sul nodo.
Ci sono due modi principali per configurare un cluster Hadoop:
- Cluster on-premises: usa hardware commodity per costruire il cluster. Questa soluzione può essere conveniente e personalizzabile in base a requisiti specifici.
- Cluster basato su cloud: opta per servizi cloud come Amazon EMR, Google Cloud Dataproc o Azure HDInsight. Questo metodo offre flessibilità, scalabilità e minore onere gestionale.
Confronto tra cluster on-premises e basati su cloud:
|
Caratteristica
|
Cluster on-premises
|
Cluster basato su cloud
|
|
Costo di setup
|
Investimento iniziale più elevato
|
Modello pay-as-you-go
|
|
Scalabilità
|
Limitata dall’hardware fisico
|
Praticamente illimitata
|
|
Manutenzione
|
Richiede gestione interna
|
Gestita dal provider cloud
|
|
Flessibilità
|
Hardware e software personalizzabili
|
Opzioni preconfigurate
|
|
Tempo di deployment
|
Tempi di setup più lunghi
|
Deployment rapido e semplice
|
Non esiste una dimensione di cluster preferita in assoluto. La dimensione del cluster è facilmente scalabile e dipende interamente dai requisiti di storage. Le piccole aziende possono usare cluster con circa 20 nodi, mentre realtà come Yahoo operano (o operavano) con cluster estesi fino a 40.000 nodi.
7. Quali sono alcuni progetti dell’ecosistema Hadoop?
Settori diversi hanno esigenze specifiche di analisi ed elaborazione dei dati. Per questo Hadoop ha rilasciato molti progetti come parte del suo ecosistema per offrire soluzioni ad hoc. L’elenco dei progetti Hadoop è più ampio di quanto immagini, ma ecco i più importanti:
- MapReduce: un modello di programmazione per l’elaborazione di grandi dataset con un algoritmo distribuito e parallelo.
- Apache Hive: infrastruttura di data warehouse per riepilogo, query e analisi dei dati tramite HiveQL.
- Apache HBase: archivio dati scalabile per accesso in lettura/scrittura in tempo reale a grandi dataset.
- Apache Pig: piattaforma di alto livello per creare programmi MapReduce con Pig Latin.
- Apache Sqoop: strumento per trasferire grandi quantità di dati tra Hadoop e archivi strutturati come i database relazionali.
- Apache Flume: servizio per raccogliere, aggregare e spostare in modo efficiente grandi quantità di log.
- Apache Oozie: sistema di schedulazione dei workflow per gestire i job Hadoop e le loro dipendenze.
- Apache Zookeeper: servizio centralizzato per mantenere informazioni di configurazione e fornire sincronizzazione distribuita.
- Apache Spark: sistema di calcolo su cluster veloce e generico con elaborazione in memoria.
- Apache Storm: sistema di calcolo in tempo reale per l’elaborazione di grandi flussi di dati.
- Apache Kafka: piattaforma di streaming distribuita per la gestione di feed di dati in tempo reale.
8. Quali sono alcune sfide comuni con Hadoop?
Anche se il framework Hadoop è eccellente nella gestione e nell’elaborazione di enormi quantità di dati preziosi, presenta alcune sfide critiche.
Vediamole:
- Il problema maggiore di Hadoop è che il NameNode rappresenta un single point of failure, che può causare perdita di dati in caso di guasto.
- Hadoop è vulnerabile a minacce alla sicurezza. Non puoi controllare direttamente i tuoi dati e non c’è modo di sapere se vengono usati in modo improprio.
- Il framework MapReduce di Hadoop elabora i dati in batch e non supporta l’elaborazione in tempo reale.
- Questo framework funziona bene con dati di grande capacità ma non è adatto a file piccoli. Quando i dati sono più piccoli della dimensione di blocco predefinita di HDFS, sovraccaricano il NameNode e causano problemi di latenza.
9. Che cos’è HBase e qual è il ruolo dei suoi componenti?
HBase è un database progettato per un accesso rapido a file di grandi dimensioni. Consente di leggere e scrivere grandi dataset in tempo reale archiviando i dati per colonne e indicizzandoli con chiavi di riga univoche.
Questa configurazione consente recuperi rapidi e scan efficienti, risultando adatta a tabelle grandi e scarsamente popolate, perché possiamo aggiungere tutti i nodi necessari.
HBase ha tre componenti:
- HMaster: gestisce i region server ed è responsabile della creazione e rimozione delle tabelle.
- Region server: gestisce le richieste di lettura e scrittura e gli split delle regioni.
- ZooKeeper: mantiene lo stato del cluster e gestisce l’assegnazione dei server
10. Cosa differenzia Hadoop 2.0 da Hadoop 1.x?
Questa tabella confronta affiancate le due versioni di Hadoop:
|
Criterio
|
Hadoop 1.x
|
Hadoop 2.0
|
|
Gestione del NameNode
|
Un singolo NameNode gestisce il namespace
|
Più NameNode gestiscono i namespace tramite federazione HDFS
|
|
Supporto del sistema operativo
|
Nessun supporto per Microsoft Windows
|
Aggiunto supporto per Microsoft
|
|
Gestione dei job e delle risorse
|
Usa JobTracker e TaskTracker per gestione job e risorse
|
Sostituiti con YARN per separare i due compiti
|
|
Scalabilità
|
Può scalare fino a 4.000 nodi per cluster
|
Può scalare fino a 10.000 nodi per cluster
|
|
Dimensione del DataNode
|
Dimensione del DataNode di 64 MB
|
Dimensione raddoppiata a 128 MB
|
|
Esecuzione dei task
|
Usa slot che possono eseguire task Map o Reduce
|
Usa container che possono eseguire qualsiasi task
|
Se ti stai candidando per un ruolo di data engineering, dai un’occhiata al nostro articolo completo sulle domande di colloquio di data engineering.
Domande avanzate su Hadoop
Ora si fa interessante. Queste domande vengono poste per metterti alla prova a un livello avanzato. Sono particolarmente importanti per gli ingegneri senior.
11. Qual è il concetto di NameNode attivo e NameNode di standby in Hadoop 2.0?
In Hadoop 2.0, il NameNode attivo gestisce lo spazio dei nomi del file system e controlla l’accesso dei client ai file. Al contrario, il NameNode di standby è un backup e mantiene informazioni sufficienti per subentrare se quello attivo fallisce.
Questo affronta il problema del single point of failure (SPOF), comune in Hadoop 1.x.
12. Qual è lo scopo della cache distribuita in Hadoop? Perché HDFS non legge i file piccoli?
HDFS è inefficiente nell’elaborare migliaia di file piccoli, con conseguente aumento della latenza. Per questo la cache distribuita consente di archiviare file in sola lettura, archivi e file jar e di renderli disponibili ai task in MapReduce.
Supponiamo di dover eseguire 40 job in MapReduce e che ciascun job debba accedere al file da HDFS. Nella pratica questo numero può crescere fino a centinaia o migliaia di letture. L’applicazione cercherà frequentemente questi file in HDFS, sovraccaricandolo e compromettendone le prestazioni.
Una cache distribuita, invece, può gestire molti file di piccole dimensioni senza compromettere i tempi di accesso e la velocità di elaborazione.
13. Spiega il ruolo del checksum nel rilevare dati corrotti. Indica anche il codice standard di rilevamento errori.
I checksum identificano i dati corrotti in HDFS. Quando i dati entrano nel sistema, viene creato un piccolo valore chiamato checksum. Hadoop ricalcola il checksum quando un utente richiede il trasferimento dei dati. Se il nuovo checksum coincide con l’originale, i dati sono integri; in caso contrario, sono corrotti.
Il codice di rilevamento errori per Hadoop è CRC-32.
14. Come ottiene HDFS la tolleranza ai guasti?
HDFS ottiene la tolleranza ai guasti tramite un processo di replica che garantisce affidabilità e disponibilità. Ecco come funziona la replica:
- Distribuzione iniziale dei blocchi: quando un file viene salvato, HDFS lo divide in blocchi e li assegna a diversi DataNode. Ad esempio, un file diviso in blocchi A, B e C potrebbe essere archiviato sui DataNode A1, B2 e C3.
- Replica: ogni DataNode che detiene un blocco replica quel blocco su altri DataNode del cluster. Ad esempio, il DataNode A1, che contiene il blocco A, creerà copie aggiuntive su altri DataNode, come D1 e D2. Ciò significa che se A1 si arresta, saranno disponibili le copie su D1 e D2.
- Gestione dei guasti: se il DataNode D1 fallisce, puoi recuperare i blocchi necessari (B e C) da altri DataNode come B2 e C3.
Sì, è possibile elaborare file compressi con MapReduce. Hadoop supporta vari formati di compressione, ma non tutti sono splittabili.
Di seguito i formati supportati da MapReduce:
- DEFLATE
- gzip
- bzip2
- LZO
- LZ4
- Snappy
Tra questi, bzip2 è l’unico formato splittabile.
HDFS divide i file molto grandi in parti più piccole, ciascuna da 128 MB. Ad esempio, HDFS suddividerà un file da 1,28 GB in dieci blocchi. Ogni blocco viene quindi elaborato da un mapper separato in un job MapReduce. Ma se un file non è splittabile, un singolo mapper gestisce l’intero file.
Domande su Hive
Alcuni ruoli richiedono competenze nell’integrazione di Hive con Hadoop. In una posizione così specifica, il selezionatore si concentrerà su queste domande:
16. Definisci Hive.
Hive è un sistema di data warehouse che esegue job batch e analisi dei dati. È stato sviluppato da Facebook per eseguire query in stile SQL su dataset massivi archiviati in HDFS senza dover dipendere da Java.
Con Hive possiamo organizzare i dati in tabelle e usare un metastore per archiviare metadati come gli schemi. Supporta diversi sistemi di storage, come S3, Azure Data Lake Storage (ADLS) e Google Cloud Storage.
L’Hive Metastore (HMS) è un database centralizzato per i metadati. Contiene informazioni su tabelle, viste e permessi di accesso archiviati nello storage a oggetti di HDFS.
Esistono due tipi di tabelle del Metastore di HIVE:
- Managed Metastore: HIVE archivia e gestisce questa tabella nella JVM del servizio Hive. Possiamo trovare queste tabelle con il valore predefinito
/user/hive/warehouse.
- External Metastore: queste tabelle vengono eseguite su una JVM esterna. Quindi, qualsiasi modifica ai metadati di Hive non influisce sui dati archiviati in queste tabelle.
18. Quali linguaggi di programmazione supporta Hive?
Hive offre un solido supporto per l’integrazione con più linguaggi di programmazione, aumentando versatilità e usabilità in applicazioni differenti:
- Python: analisi dei dati e machine learning.
- Java: applicazioni enterprise ed elaborazioni dati personalizzate.
- C++: applicazioni critiche per le prestazioni e SerDe personalizzati.
- PHP: applicazioni web che accedono ai dati in Hive.
19. Qual è la dimensione massima di dati che Hive può gestire?
Grazie all’integrazione con HDFS e all’architettura scalabile, Hive può gestire petabyte di dati. Non esiste un limite massimo fisso alla quantità di dati che Hive può gestire, il che lo rende uno strumento potente per l’elaborazione e l’analisi dei big data.
20. Quanti tipi di dato esistono in Hive?
Hive offre un ricco set di tipi di dato per gestire esigenze diverse:
- Tipi di dato incorporati: Numerici, Stringa, Data/Ora e vari per l’archiviazione di base.
- Tipi di dato complessi: ARRAY, MAP, STRUCT e UNIONTYPE per rappresentazioni più avanzate e strutturate.
Tipi di dato incorporati:
|
Categoria
|
Tipo di dato
|
Descrizione
|
Esempio
|
|
Tipi numerici
|
TINYINT
|
Intero con segno a 1 byte
|
127
|
| |
SMALLINT
|
Intero con segno a 2 byte
|
32767
|
| |
INT
|
Intero con segno a 4 byte
|
2147483647
|
| |
BIGINT
|
Intero con segno a 8 byte
|
9223372036854775807
|
| |
FLOAT
|
Virgola mobile a precisione singola
|
3.14
|
| |
DOUBLE
|
Virgola mobile a doppia precisione
|
3.141592653589793
|
| |
DECIMAL
|
Numero decimale con segno a precisione arbitraria
|
1234567890.1234567890
|
|
Tipi stringa
|
STRING
|
Stringa a lunghezza variabile
|
'Hello, World!'
|
| |
VARCHAR
|
Stringa a lunghezza variabile con lunghezza massima specificata
|
'Example'
|
| |
CHAR
|
Stringa a lunghezza fissa
|
'A'
|
|
Tipi Data/Ora
|
TIMESTAMP
|
Data e ora, inclusi fuso orario
|
'2023-01-01 12:34:56'
|
| |
DATE
|
Data senza ora
|
'2023-01-01'
|
| |
INTERVAL
|
Intervallo temporale
|
INTERVAL '1' DAY
|
|
Tipi vari
|
BOOLEAN
|
Rappresenta vero o falso
|
TRUE
|
| |
BINARY
|
Sequenza di byte
|
0x1A2B3C
|
Tipi di dato complessi:
|
Tipo di dato
|
Descrizione
|
Esempio
|
|
ARRAY
|
Collezione ordinata di elementi
|
ARRAY<STRING> ('apple', 'banana', 'cherry')
|
|
MAP
|
Collezione di coppie chiave-valore
|
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
|
|
STRUCT
|
Collezione di campi di tipi diversi
|
STRUCT<name: STRING, age: INT> ('Alice', 30)
|
|
UNIONTYPE
|
Può contenere uno tra più tipi specificati
|
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three')
|
Domande su Hadoop basate su scenari per Big Data Engineer
Queste domande mettono alla prova la tua capacità di usare Hadoop per affrontare problemi reali. Sono particolarmente pertinenti se ti candidi per un ruolo di data architect, ma possono essere poste in qualsiasi iter di selezione che richieda conoscenze di Hadoop.
21. Stai configurando un cluster HDFS con il sistema di replica di Hadoop. Il cluster ha tre rack: A, B e C. Spiega come Hadoop replicherà un file chiamato datafile.text.
Ecco come Hadoop replicherà i dati:
- Prima replica sul rack A: Hadoop colloca la replica iniziale su un nodo scelto casualmente nel rack A. Questa decisione riduce la latenza in scrittura selezionando un nodo locale o vicino.
- Seconda replica sul rack B: la seconda replica viene collocata su un nodo in un rack diverso, ad esempio il rack B. Questo assicura che i dati non vadano persi se il rack A fallisce, migliorando la tolleranza ai guasti.
- Terza replica sul rack B: la terza replica viene collocata su un altro nodo all’interno del rack B. Posizionarla nello stesso rack della seconda aiuta a bilanciare il carico di rete tra i rack e a ridurre il traffico inter-rack.
La strategia di replica di Hadoop in un cluster HDFS con tre rack (A, B e C) è progettata per ottimizzare la distribuzione del carico, aumentare la tolleranza ai guasti e migliorare l’efficienza della rete. In questo modo, datafile.text viene replicato bilanciando prestazioni e affidabilità.
22. Stai lavorando su un’applicazione basata su Hadoop che interagisce con i file usando LocalFileSystem. Come gestirai l’integrità dei dati con un checksum?
Usare i checksum nel LocalFileSystem di Hadoop garantisce l’integrità dei dati mediante:
- Generazione dei checksum: creazione automatica dei checksum per i chunk di dati durante la scrittura dei file.
- Archiviazione dei checksum: salvataggio dei checksum in un file nascosto
.filename.crc nella stessa directory.
- Verifica dei checksum: confronto dei checksum archiviati con i dati effettivi in lettura.
- Rilevamento delle discrepanze: generazione di
ChecksumException in caso di incongruenze.
Seguendo questi passaggi, possiamo garantire che l’applicazione mantenga l’integrità dei dati e rilevi tempestivamente eventuali corruzioni.
23. Supponiamo che tu stia effettuando il debug di un job Hadoop su larga scala distribuito su più nodi e ci siano casi insoliti che influenzano l’output. Come gestiresti la situazione?
Ecco cosa possiamo fare:
- Registrare i potenziali problemi: usa istruzioni di debug per scrivere i potenziali problemi su
stderr.
- Aggiornare lo stato dei task: includi le posizioni dei log di errore nei messaggi di stato dei task.
- Contatori personalizzati: implementa contatori per tracciare e analizzare condizioni insolite.
- Debug dell’output delle mappe: scrivi informazioni di debug nell’output della map.
- Programma di analisi dei log: crea un programma MapReduce per un’analisi dettagliata dei log.
Seguendo questi passaggi, possiamo effettuare il debug in modo sistematico dei job Hadoop su larga scala e tracciare e risolvere efficacemente i casi insoliti che influiscono sull’output.
24. Stai calcolando le impostazioni di memoria per un cluster Hadoop che usa YARN. Spiega come imposteresti la memoria per il NodeManager e per i job MapReduce.
Quando configuri le impostazioni di memoria per un cluster Hadoop con YARN, è importante bilanciare l’allocazione tra demoni di Hadoop, processi di sistema e NodeManager per ottimizzare prestazioni e utilizzo delle risorse.
Impostazione della memoria per il NodeManager:
- Calcolare la memoria fisica totale del nodo: determina la memoria fisica totale disponibile su ciascun nodo del cluster. Ad esempio, se un nodo ha 64 GB di RAM, la memoria fisica totale è 64.000 MB.
- Detrarre la memoria per i demoni Hadoop: alloca memoria per i demoni Hadoop in esecuzione sul nodo, come DataNode e NodeManager. In genere, 1000-2000 MB per demone sono sufficienti. Ad esempio, se allochi 1500 MB ciascuno per DataNode e NodeManager, devi riservare 3000 MB.
- Riservare memoria per i processi di sistema: metti da parte memoria per altri processi di sistema e servizi in background per assicurare il corretto funzionamento del sistema operativo e dei servizi essenziali. Una riserva tipica può essere 2 GB (2000 MB).
- Allocare la memoria rimanente al NodeManager: sottrai la memoria riservata ai demoni Hadoop e ai processi di sistema dalla memoria fisica totale per determinare la memoria disponibile per il NodeManager da assegnare ai container.
Impostazione della memoria per i job MapReduce:
- Regolare
mapreduce.map.memory.mb: questo parametro definisce la quantità di memoria assegnata a ciascun task di map. Regola l’impostazione in base ai requisiti di memoria dei tuoi task di map.
- Ad esempio, impostare
mapreduce.map.memory.mb a 2048 MB significa che ogni task di map avrà 2 GB di memoria.
- Regolare
mapreduce.reduce.memory.mb: questo parametro definisce la quantità di memoria assegnata a ciascun task di reduce. Regola l’impostazione in base ai requisiti di memoria dei tuoi task di reduce.
- Ad esempio, impostare
mapreduce.reduce.memory.mb a 4096 MB significa che ogni task di reduce avrà 4 GB di memoria.
- Configurare la dimensione dei container: assicurati che la dimensione dei container sia impostata correttamente in
yarn-site.xml con parametri come yarn.nodemanager.resource.memory-mb, che dovrebbe essere allineata alla memoria assegnata al NodeManager.
- Per esempio, se il NodeManager ha 59.000 MB disponibili, potresti impostare
yarn.nodemanager.resource.memory-mb a 59.000 MB.
Riepilogo della configurazione della memoria:
|
Componente
|
Configurazione
|
Valori di esempio
|
|
NodeManager
|
Memoria fisica totale
|
64.000 MB
|
| |
Memoria per i demoni Hadoop
|
3000 MB
|
| |
Memoria per i processi di sistema
|
2000 MB
|
| |
Memoria disponibile per il NodeManager
|
59.000 MB
|
|
Task map di MapReduce
|
mapreduce.map.memory.mb
|
2048 MB
|
|
Task reduce di MapReduce
|
mapreduce.reduce.memory.mb
|
4096 MB
|
|
Dimensione dei container
|
yarn.nodemanager.resource.memory-mb
|
59.000 MB
|
Considerazioni finali
Dopo aver compreso queste domande, dovresti conoscere i termini di base e avere una
solida padronanza delle complessità delle applicazioni Hadoop reali. Inoltre, devi saper adattarti ai nuovi progetti basati su Hadoop per restare rilevante e brillare ai colloqui.
Puoi anche ampliare le tue conoscenze su altri framework per big data, come Spark e Flink, perché sono veloci e presentano minori problemi di latenza rispetto a Hadoop.
Se però cerchi un percorso strutturato per padroneggiare i big data, puoi consultare le seguenti risorse:
- Big Data Fundamentals with PySpark: questo corso è un ottimo punto di partenza per apprendere le basi dell’elaborazione dei big data con PySpark.
- Big Data with PySpark: questo percorso offre un’introduzione completa ai concetti di big data usando PySpark, coprendo aspetti come manipolazione dei dati, machine learning e altro.





Gli esperti di Hadoop scrivono applicazioni e analizzano dati in continuo cambiamento per ottenere insight e mantenere la sicurezza dei dati. Per questo i responsabili delle assunzioni hanno criteri rigorosi per trovare la persona più adatta e possono chiederti di tutto, dalle basi agli aspetti avanzati.
In questo articolo abbiamo raccolto le 24 domande e risposte su Hadoop più comuni ai colloqui.
Questo articolo ti aiuterà a prepararti a fondo per il tuo prossimo colloquio nell’ambito dei big data. Copre concetti fondamentali e scenari avanzati. Che tu sia all’inizio o un professionista esperto, troverai spunti preziosi e indicazioni pratiche per aumentare la fiducia e migliorare le tue possibilità di successo.
Domande di base su Hadoop
Di solito i colloqui iniziano con domande di base per valutare la tua comprensione di Hadoop e la sua rilevanza nella gestione dei big data.
Anche se sei un ingegnere esperto, assicurati di avere chiari questi argomenti.
1. Che cosa sono i big data?
Creazione di dati globali in zettabyte. Fonte: Statista.
Big data indica enormi quantità di dati complessi generati ad alta velocità da più fonti. Il totale dei dati creati a livello globale è stato di 180 zettabyte nel 2025 e si prevede che triplicherà entro il 2029.
Con l’accelerazione della generazione dei dati, i metodi tradizionali di analisi non riescono a garantire elaborazione in tempo reale e sicurezza. Ecco perché le aziende usano framework avanzati come Hadoop per elaborare e gestire volumi di dati in crescita.
Se vuoi iniziare una carriera nei big data, dai un’occhiata alla nostra guida alla formazione sui big data.
2. Che cos’è Hadoop e come risolve il problema dei big data?
Hadoop è un framework open-source per la gestione di grandi dataset distribuiti su più computer. Archivia i dati su più macchine come blocchi di piccole dimensioni tramite l’Hadoop Distributed File System (HDFS).
Con Hadoop puoi aggiungere altri nodi a un cluster e gestire molti dati senza costosi upgrade dell’hardware.
Anche grandi aziende come Google e Facebook si affidano a Hadoop per gestire e analizzare da terabyte a petabyte di dati quotidiani.
3. Quali sono i due componenti principali di Hadoop?
I due componenti principali di Hadoop sono:
Architettura di alto livello di Hadoop. Fonte: Wikimedia Commons
4. Definisci il ruolo di NameNode e DataNode in Hadoop.
HDFS è composto da un NameNode e più DataNode per la gestione dei dati, come si vede nell’immagine sopra. Ecco come funzionano:
5. Spiega il ruolo di Hadoop YARN.
In Hadoop 1.x, MapReduce gestisce la gestione delle risorse e la schedulazione dei job tramite JobTracker. Tuttavia, la lentezza di elaborazione è un notevole svantaggio.
Hadoop 2.0 ha introdotto YARN (Yet Another Resource Negotiator) per affrontare questi problemi. YARN disaccoppia gestione delle risorse e schedulazione dei job in componenti separati, migliorando scalabilità e utilizzo delle risorse. I componenti principali di YARN sono:
Come funziona YARN:
Domande intermedie su Hadoop
Le domande intermedie mirano maggiormente a valutare la tua conoscenza degli aspetti tecnici del framework Hadoop. Il selezionatore può chiederti del cluster Hadoop, delle sue sfide e del confronto tra diverse versioni.
6. Che cos’è un cluster Hadoop e c’è una dimensione di cluster preferita dalle aziende?
Un cluster Hadoop è un insieme di nodi master e slave interconnessi progettato per archiviare ed elaborare grandi dataset in modo distribuito. L’architettura del cluster garantisce alta disponibilità, scalabilità e tolleranza ai guasti.
Componenti di un cluster Hadoop:
Ci sono due modi principali per configurare un cluster Hadoop:
Confronto tra cluster on-premises e basati su cloud:
Caratteristica
Cluster on-premises
Cluster basato su cloud
Costo di setup
Investimento iniziale più elevato
Modello pay-as-you-go
Scalabilità
Limitata dall’hardware fisico
Praticamente illimitata
Manutenzione
Richiede gestione interna
Gestita dal provider cloud
Flessibilità
Hardware e software personalizzabili
Opzioni preconfigurate
Tempo di deployment
Tempi di setup più lunghi
Deployment rapido e semplice
Non esiste una dimensione di cluster preferita in assoluto. La dimensione del cluster è facilmente scalabile e dipende interamente dai requisiti di storage. Le piccole aziende possono usare cluster con circa 20 nodi, mentre realtà come Yahoo operano (o operavano) con cluster estesi fino a 40.000 nodi.
7. Quali sono alcuni progetti dell’ecosistema Hadoop?
Settori diversi hanno esigenze specifiche di analisi ed elaborazione dei dati. Per questo Hadoop ha rilasciato molti progetti come parte del suo ecosistema per offrire soluzioni ad hoc. L’elenco dei progetti Hadoop è più ampio di quanto immagini, ma ecco i più importanti:
8. Quali sono alcune sfide comuni con Hadoop?
Anche se il framework Hadoop è eccellente nella gestione e nell’elaborazione di enormi quantità di dati preziosi, presenta alcune sfide critiche.
Vediamole:
9. Che cos’è HBase e qual è il ruolo dei suoi componenti?
HBase è un database progettato per un accesso rapido a file di grandi dimensioni. Consente di leggere e scrivere grandi dataset in tempo reale archiviando i dati per colonne e indicizzandoli con chiavi di riga univoche.
Questa configurazione consente recuperi rapidi e scan efficienti, risultando adatta a tabelle grandi e scarsamente popolate, perché possiamo aggiungere tutti i nodi necessari.
HBase ha tre componenti:
10. Cosa differenzia Hadoop 2.0 da Hadoop 1.x?
Questa tabella confronta affiancate le due versioni di Hadoop:
Criterio
Hadoop 1.x
Hadoop 2.0
Gestione del NameNode
Un singolo NameNode gestisce il namespace
Più NameNode gestiscono i namespace tramite federazione HDFS
Supporto del sistema operativo
Nessun supporto per Microsoft Windows
Aggiunto supporto per Microsoft
Gestione dei job e delle risorse
Usa JobTracker e TaskTracker per gestione job e risorse
Sostituiti con YARN per separare i due compiti
Scalabilità
Può scalare fino a 4.000 nodi per cluster
Può scalare fino a 10.000 nodi per cluster
Dimensione del DataNode
Dimensione del DataNode di 64 MB
Dimensione raddoppiata a 128 MB
Esecuzione dei task
Usa slot che possono eseguire task Map o Reduce
Usa container che possono eseguire qualsiasi task
Se ti stai candidando per un ruolo di data engineering, dai un’occhiata al nostro articolo completo sulle domande di colloquio di data engineering.
Domande avanzate su Hadoop
Ora si fa interessante. Queste domande vengono poste per metterti alla prova a un livello avanzato. Sono particolarmente importanti per gli ingegneri senior.
11. Qual è il concetto di NameNode attivo e NameNode di standby in Hadoop 2.0?
In Hadoop 2.0, il NameNode attivo gestisce lo spazio dei nomi del file system e controlla l’accesso dei client ai file. Al contrario, il NameNode di standby è un backup e mantiene informazioni sufficienti per subentrare se quello attivo fallisce.
Questo affronta il problema del single point of failure (SPOF), comune in Hadoop 1.x.
12. Qual è lo scopo della cache distribuita in Hadoop? Perché HDFS non legge i file piccoli?
HDFS è inefficiente nell’elaborare migliaia di file piccoli, con conseguente aumento della latenza. Per questo la cache distribuita consente di archiviare file in sola lettura, archivi e file jar e di renderli disponibili ai task in MapReduce.
Supponiamo di dover eseguire 40 job in MapReduce e che ciascun job debba accedere al file da HDFS. Nella pratica questo numero può crescere fino a centinaia o migliaia di letture. L’applicazione cercherà frequentemente questi file in HDFS, sovraccaricandolo e compromettendone le prestazioni.
Una cache distribuita, invece, può gestire molti file di piccole dimensioni senza compromettere i tempi di accesso e la velocità di elaborazione.
13. Spiega il ruolo del checksum nel rilevare dati corrotti. Indica anche il codice standard di rilevamento errori.
I checksum identificano i dati corrotti in HDFS. Quando i dati entrano nel sistema, viene creato un piccolo valore chiamato checksum. Hadoop ricalcola il checksum quando un utente richiede il trasferimento dei dati. Se il nuovo checksum coincide con l’originale, i dati sono integri; in caso contrario, sono corrotti.
Il codice di rilevamento errori per Hadoop è CRC-32.
14. Come ottiene HDFS la tolleranza ai guasti?
HDFS ottiene la tolleranza ai guasti tramite un processo di replica che garantisce affidabilità e disponibilità. Ecco come funziona la replica:
15. Puoi elaborare un file compresso con MapReduce? Se sì, quali formati supporta e sono splittabili?
Sì, è possibile elaborare file compressi con MapReduce. Hadoop supporta vari formati di compressione, ma non tutti sono splittabili.
Di seguito i formati supportati da MapReduce:
Tra questi, bzip2 è l’unico formato splittabile.
HDFS divide i file molto grandi in parti più piccole, ciascuna da 128 MB. Ad esempio, HDFS suddividerà un file da 1,28 GB in dieci blocchi. Ogni blocco viene quindi elaborato da un mapper separato in un job MapReduce. Ma se un file non è splittabile, un singolo mapper gestisce l’intero file.
Domande su Hive
Alcuni ruoli richiedono competenze nell’integrazione di Hive con Hadoop. In una posizione così specifica, il selezionatore si concentrerà su queste domande:
16. Definisci Hive.
Hive è un sistema di data warehouse che esegue job batch e analisi dei dati. È stato sviluppato da Facebook per eseguire query in stile SQL su dataset massivi archiviati in HDFS senza dover dipendere da Java.
Con Hive possiamo organizzare i dati in tabelle e usare un metastore per archiviare metadati come gli schemi. Supporta diversi sistemi di storage, come S3, Azure Data Lake Storage (ADLS) e Google Cloud Storage.
17. Che cos’è l’Hive Metastore (HMS)? Come distingueresti un Managed Metastore da un External Metastore?
L’Hive Metastore (HMS) è un database centralizzato per i metadati. Contiene informazioni su tabelle, viste e permessi di accesso archiviati nello storage a oggetti di HDFS.
Esistono due tipi di tabelle del Metastore di HIVE:
/user/hive/warehouse.18. Quali linguaggi di programmazione supporta Hive?
Hive offre un solido supporto per l’integrazione con più linguaggi di programmazione, aumentando versatilità e usabilità in applicazioni differenti:
19. Qual è la dimensione massima di dati che Hive può gestire?
Grazie all’integrazione con HDFS e all’architettura scalabile, Hive può gestire petabyte di dati. Non esiste un limite massimo fisso alla quantità di dati che Hive può gestire, il che lo rende uno strumento potente per l’elaborazione e l’analisi dei big data.
20. Quanti tipi di dato esistono in Hive?
Hive offre un ricco set di tipi di dato per gestire esigenze diverse:
Tipi di dato incorporati:
Categoria
Tipo di dato
Descrizione
Esempio
Tipi numerici
TINYINT
Intero con segno a 1 byte
127
SMALLINT
Intero con segno a 2 byte
32767
INT
Intero con segno a 4 byte
2147483647
BIGINT
Intero con segno a 8 byte
9223372036854775807
FLOAT
Virgola mobile a precisione singola
3.14
DOUBLE
Virgola mobile a doppia precisione
3.141592653589793
DECIMAL
Numero decimale con segno a precisione arbitraria
1234567890.1234567890
Tipi stringa
STRING
Stringa a lunghezza variabile
'Hello, World!'
VARCHAR
Stringa a lunghezza variabile con lunghezza massima specificata
'Example'
CHAR
Stringa a lunghezza fissa
'A'
Tipi Data/Ora
TIMESTAMP
Data e ora, inclusi fuso orario
'2023-01-01 12:34:56'
DATE
Data senza ora
'2023-01-01'
INTERVAL
Intervallo temporale
INTERVAL '1' DAY
Tipi vari
BOOLEAN
Rappresenta vero o falso
TRUE
BINARY
Sequenza di byte
0x1A2B3C
Tipi di dato complessi:
Tipo di dato
Descrizione
Esempio
ARRAY
Collezione ordinata di elementi
ARRAY<STRING> ('apple', 'banana', 'cherry')
MAP
Collezione di coppie chiave-valore
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
STRUCT
Collezione di campi di tipi diversi
STRUCT<name: STRING, age: INT> ('Alice', 30)
UNIONTYPE
Può contenere uno tra più tipi specificati
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three')
Domande su Hadoop basate su scenari per Big Data Engineer
Queste domande mettono alla prova la tua capacità di usare Hadoop per affrontare problemi reali. Sono particolarmente pertinenti se ti candidi per un ruolo di data architect, ma possono essere poste in qualsiasi iter di selezione che richieda conoscenze di Hadoop.
21. Stai configurando un cluster HDFS con il sistema di replica di Hadoop. Il cluster ha tre rack: A, B e C. Spiega come Hadoop replicherà un file chiamato datafile.text.
Ecco come Hadoop replicherà i dati:
La strategia di replica di Hadoop in un cluster HDFS con tre rack (A, B e C) è progettata per ottimizzare la distribuzione del carico, aumentare la tolleranza ai guasti e migliorare l’efficienza della rete. In questo modo,
datafile.textviene replicato bilanciando prestazioni e affidabilità.22. Stai lavorando su un’applicazione basata su Hadoop che interagisce con i file usando LocalFileSystem. Come gestirai l’integrità dei dati con un checksum?
Usare i checksum nel
LocalFileSystemdi Hadoop garantisce l’integrità dei dati mediante:.filename.crcnella stessa directory.ChecksumExceptionin caso di incongruenze.Seguendo questi passaggi, possiamo garantire che l’applicazione mantenga l’integrità dei dati e rilevi tempestivamente eventuali corruzioni.
23. Supponiamo che tu stia effettuando il debug di un job Hadoop su larga scala distribuito su più nodi e ci siano casi insoliti che influenzano l’output. Come gestiresti la situazione?
Ecco cosa possiamo fare:
stderr.Seguendo questi passaggi, possiamo effettuare il debug in modo sistematico dei job Hadoop su larga scala e tracciare e risolvere efficacemente i casi insoliti che influiscono sull’output.
24. Stai calcolando le impostazioni di memoria per un cluster Hadoop che usa YARN. Spiega come imposteresti la memoria per il NodeManager e per i job MapReduce.
Quando configuri le impostazioni di memoria per un cluster Hadoop con YARN, è importante bilanciare l’allocazione tra demoni di Hadoop, processi di sistema e NodeManager per ottimizzare prestazioni e utilizzo delle risorse.
Impostazione della memoria per il NodeManager:
Impostazione della memoria per i job MapReduce:
mapreduce.map.memory.mb: questo parametro definisce la quantità di memoria assegnata a ciascun task di map. Regola l’impostazione in base ai requisiti di memoria dei tuoi task di map.mapreduce.map.memory.mba 2048 MB significa che ogni task di map avrà 2 GB di memoria.mapreduce.reduce.memory.mb: questo parametro definisce la quantità di memoria assegnata a ciascun task di reduce. Regola l’impostazione in base ai requisiti di memoria dei tuoi task di reduce.mapreduce.reduce.memory.mba 4096 MB significa che ogni task di reduce avrà 4 GB di memoria.yarn-site.xmlcon parametri comeyarn.nodemanager.resource.memory-mb, che dovrebbe essere allineata alla memoria assegnata al NodeManager.yarn.nodemanager.resource.memory-mba 59.000 MB.Riepilogo della configurazione della memoria:
Componente
Configurazione
Valori di esempio
NodeManager
Memoria fisica totale
64.000 MB
Memoria per i demoni Hadoop
3000 MB
Memoria per i processi di sistema
2000 MB
Memoria disponibile per il NodeManager
59.000 MB
Task map di MapReduce
mapreduce.map.memory.mb
2048 MB
Task reduce di MapReduce
mapreduce.reduce.memory.mb
4096 MB
Dimensione dei container
yarn.nodemanager.resource.memory-mb
59.000 MB
Considerazioni finali
Dopo aver compreso queste domande, dovresti conoscere i termini di base e avere una
solida padronanza delle complessità delle applicazioni Hadoop reali. Inoltre, devi saper adattarti ai nuovi progetti basati su Hadoop per restare rilevante e brillare ai colloqui.
Puoi anche ampliare le tue conoscenze su altri framework per big data, come Spark e Flink, perché sono veloci e presentano minori problemi di latenza rispetto a Hadoop.
Se però cerchi un percorso strutturato per padroneggiare i big data, puoi consultare le seguenti risorse: