Chuyên gia Hadoop viết ứng dụng và phân tích dữ liệu liên tục thay đổi để rút ra insight và duy trì bảo mật dữ liệu. Vì vậy, nhà tuyển dụng đặt ra tiêu chí khắt khe để tìm người phù hợp nhất cho vị trí và có thể hỏi bạn từ những điều cơ bản đến nâng cao.
Trong bài viết này, chúng tôi đã tổng hợp 24 câu hỏi và đáp án phỏng vấn Hadoop thường gặp nhất.
Bài viết này được thiết kế để giúp bạn chuẩn bị kỹ lưỡng cho buổi phỏng vấn việc làm big data tiếp theo. Nội dung bao quát từ khái niệm nền tảng đến các kịch bản nâng cao. Dù bạn là người mới bắt đầu hay đã có kinh nghiệm, bạn sẽ tìm thấy những insight hữu ích và thông tin thực tiễn để tăng sự tự tin và cải thiện cơ hội thành công.
Câu hỏi phỏng vấn Hadoop cơ bản
Người phỏng vấn thường bắt đầu bằng các câu hỏi cơ bản để đánh giá mức độ hiểu biết của bạn về Hadoop và vai trò của nó trong quản trị dữ liệu lớn.
Ngay cả khi bạn là kỹ sư dày dạn, hãy đảm bảo bạn nắm vững những câu hỏi này.
1. Dữ liệu lớn (big data) là gì?
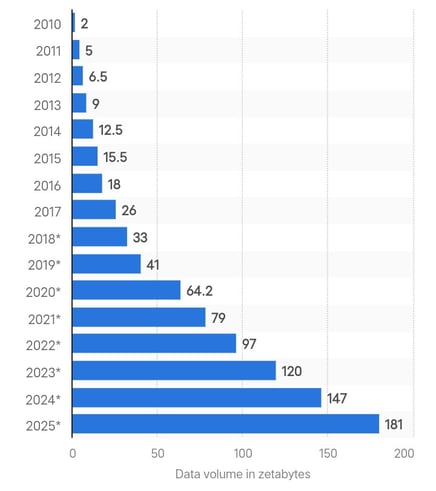
Lượng dữ liệu tạo ra toàn cầu tính bằng Zettabyte. Nguồn: Statista.
Big data đề cập đến lượng dữ liệu khổng lồ, phức tạp, được tạo ra với tốc độ cao từ nhiều nguồn khác nhau. Tổng lượng dữ liệu được tạo ra trên toàn cầu là 180 zettabyte vào năm 2025 và dự kiến sẽ tăng gấp ba vào năm 2029.
Khi việc tạo dữ liệu tăng tốc, các phương pháp phân tích truyền thống sẽ không đáp ứng được xử lý thời gian thực và bảo mật dữ liệu. Đó là lý do các công ty sử dụng những framework tiên tiến như Hadoop để xử lý và quản lý khối lượng dữ liệu ngày càng tăng.
Nếu bạn muốn bắt đầu sự nghiệp trong lĩnh vực big data, hãy xem hướng dẫn về đào tạo big data của chúng tôi.
2. Hadoop là gì và nó giải quyết bài toán big data như thế nào?
Hadoop là một framework mã nguồn mở để xử lý các bộ dữ liệu lớn được phân tán trên nhiều máy tính. Nó lưu trữ dữ liệu trên nhiều máy dưới dạng các khối nhỏ bằng Hệ thống Tệp Phân tán Hadoop (HDFS).
Với Hadoop, bạn có thể thêm nhiều nút vào cụm và xử lý lượng dữ liệu lớn mà không cần nâng cấp phần cứng đắt đỏ.
Ngay cả các công ty lớn như Google và Facebook cũng dựa vào Hadoop để quản lý và phân tích dữ liệu hàng ngày từ terabyte đến petabyte.
3. Hai thành phần chính của Hadoop là gì?
Hai thành phần chính của Hadoop gồm:
- Hadoop Distributed File System (HDFS): Quản lý lưu trữ dữ liệu bằng cách chia nhỏ các tệp lớn thành các khối kích thước block, mặc định mỗi khối là 128 MB, và phân phối chúng trên nhiều nút trong cụm.
- MapReduce: Mô hình lập trình mà Hadoop dựa vào để xử lý dữ liệu. Đây là quy trình hai giai đoạn gồm công việc map và reduce. Giai đoạn map nhận dữ liệu và chuyển đổi nó thành một tập dữ liệu khác. Giai đoạn reduce nhận các cặp giá trị đầu ra từ map làm đầu vào và kết hợp chúng thành các cặp nhỏ hơn. Mục tiêu là xử lý chúng bằng hàm reduce do người dùng định nghĩa.
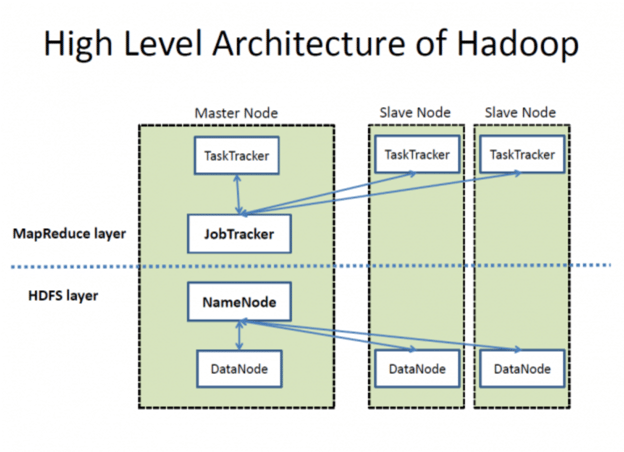
Kiến trúc cấp cao của Hadoop. Nguồn: Wikimedia Commons
4. Định nghĩa vai trò của NameNode và DataNode trong Hadoop.
HDFS gồm một NameNode và nhiều DataNode để quản lý dữ liệu, như minh họa ở hình trên. Cách chúng hoạt động:
- Là máy chủ chủ trong HDFS, NameNode xử lý các thao tác như mở, đóng và đổi tên tệp. Nó duy trì siêu dữ liệu về quyền truy cập và vị trí các khối.
- DataNode đóng vai trò là các nút công nhân để lưu trữ các khối dữ liệu thực tế của tệp. Khi khách hàng cần đọc hoặc ghi dữ liệu, họ nhận vị trí các khối dữ liệu từ NameNode. Sau đó, khách hàng giao tiếp trực tiếp với các DataNode liên quan để thực hiện thao tác cần thiết.
5. Giải thích vai trò của Hadoop YARN.
Trong Hadoop 1.x, MapReduce quản lý tài nguyên và lập lịch công việc bằng JobTracker. Tuy nhiên, điểm yếu lớn là tốc độ xử lý chậm.
Hadoop 2.0 giới thiệu YARN (Yet Another Resource Negotiator) để giải quyết các vấn đề này. YARN tách quản lý tài nguyên và lập lịch công việc thành các thành phần riêng, giúp cải thiện khả năng mở rộng và sử dụng tài nguyên. Các thành phần chính của YARN là:
- ResourceManager (RM): Quản lý tài nguyên trên toàn cụm.
- NodeManager (NM): Quản lý tài nguyên và giám sát từng nút.
- ApplicationMaster (AM): Quản lý vòng đời ứng dụng, bao gồm nhu cầu tài nguyên và việc thực thi.
Cách YARN hoạt động:
- Nộp job: Khách hàng gửi một ứng dụng lên cụm YARN.
- Phân bổ tài nguyên: ResourceManager bắt đầu phân bổ tài nguyên bằng cách phối hợp với ApplicationMaster.
- Đăng ký ApplicationMaster: ApplicationMaster tự đăng ký với ResourceManager.
- Thương lượng container: ApplicationMaster thương lượng tài nguyên (container) từ ResourceManager.
- Khởi chạy container: Khi tài nguyên được cấp, ApplicationMaster chỉ đạo các NodeManager khởi chạy container.
- Thực thi ứng dụng: Mã ứng dụng được thực thi trong các container đã cấp phát.
Câu hỏi phỏng vấn Hadoop trung cấp
Các câu hỏi trung cấp tập trung hơn vào việc đánh giá hiểu biết của bạn về các khía cạnh kỹ thuật của framework Hadoop. Người phỏng vấn có thể hỏi về cụm Hadoop, các thách thức của nó và so sánh các phiên bản khác nhau.
6. Cụm Hadoop là gì và có kích thước cụm cụ thể nào mà các công ty ưa chuộng không?
Cụm Hadoop là tập hợp các nút chủ và nút phụ được kết nối với nhau, được thiết kế để lưu trữ và xử lý các bộ dữ liệu lớn theo cách phân tán. Kiến trúc cụm đảm bảo tính sẵn sàng cao, khả năng mở rộng và chịu lỗi.
Thành phần của cụm Hadoop:
- Nút chủ: Quản lý tài nguyên của cụm và hệ thống tệp phân tán. Các thành phần chính gồm:
- NameNode: Quản lý không gian tên của HDFS và điều tiết quyền truy cập tệp của khách hàng.
- ResourceManager: Quản lý phân bổ tài nguyên để chạy ứng dụng.
- Nút phụ: Chịu trách nhiệm lưu trữ dữ liệu và thực hiện tính toán. Các thành phần chính gồm:
- DataNode: Lưu trữ các khối dữ liệu thực trong HDFS.
- NodeManager: Quản lý việc thực thi container trên nút.
Có hai cách chính để thiết lập cụm Hadoop:
- Cụm on-premises: Dùng phần cứng phổ thông để xây dựng cụm. Cách tiếp cận này có thể tiết kiệm chi phí và tùy biến theo yêu cầu cụ thể.
- Cụm trên đám mây: Chọn các dịch vụ đám mây như Amazon EMR, Google Cloud Dataproc hoặc Azure HDInsight. Cách này mang lại tính linh hoạt, khả năng mở rộng và giảm gánh nặng quản trị.
So sánh cụm on-premises và cụm đám mây:
|
Tính năng
|
Cụm on-premises
|
Cụm đám mây
|
|
Chi phí thiết lập
|
Đầu tư ban đầu cao
|
Mô hình trả theo mức dùng
|
|
Khả năng mở rộng
|
Giới hạn bởi phần cứng vật lý
|
Gần như không giới hạn
|
|
Bảo trì
|
Cần đội ngũ nội bộ quản lý
|
Do nhà cung cấp đám mây quản lý
|
|
Tính linh hoạt
|
Tùy biến phần cứng và phần mềm
|
Tùy chọn cấu hình sẵn
|
|
Thời gian triển khai
|
Thời gian thiết lập lâu hơn
|
Triển khai nhanh và dễ
|
Không có kích thước cụm ưa thích cố định. Kích thước cụm dễ mở rộng và hoàn toàn phụ thuộc vào nhu cầu lưu trữ. Doanh nghiệp nhỏ có thể dùng cụm khoảng 20 nút, trong khi các doanh nghiệp như Yahoo vận hành (hoặc từng vận hành) các cụm lớn tới 40.000 nút.
7. Một số dự án trong hệ sinh thái Hadoop là gì?
Các ngành khác nhau có nhu cầu phân tích và xử lý dữ liệu riêng. Vì vậy, Hadoop đã phát hành nhiều dự án trong hệ sinh thái để đáp ứng các nhu cầu đó. Danh sách dự án Hadoop rộng hơn bạn tưởng—nhưng đây là những cái cốt lõi:
- MapReduce: Mô hình lập trình để xử lý các bộ dữ liệu lớn bằng thuật toán song song, phân tán.
- Apache Hive: Hạ tầng kho dữ liệu để tổng hợp, truy vấn và phân tích dữ liệu bằng HiveQL.
- Apache HBase: Kho dữ liệu lớn có khả năng mở rộng, cung cấp truy cập đọc/ghi thời gian thực vào các bộ dữ liệu lớn.
- Apache Pig: Nền tảng cấp cao để tạo chương trình MapReduce với Pig Latin.
- Apache Sqoop: Công cụ chuyển dữ liệu khối lượng lớn giữa Hadoop và các kho dữ liệu có cấu trúc như cơ sở dữ liệu quan hệ.
- Apache Flume: Dịch vụ thu thập, tổng hợp và chuyển lượng lớn dữ liệu log một cách hiệu quả.
- Apache Oozie: Hệ thống lập lịch workflow để quản lý các job Hadoop và quan hệ phụ thuộc của chúng.
- Apache Zookeeper: Dịch vụ tập trung để lưu giữ thông tin cấu hình và cung cấp đồng bộ phân tán.
- Apache Spark: Hệ thống tính toán cụm tổng quát, tốc độ cao với xử lý trong bộ nhớ.
- Apache Storm: Hệ thống tính toán thời gian thực để xử lý các luồng dữ liệu lớn.
- Apache Kafka: Nền tảng streaming phân tán để xử lý các nguồn dữ liệu thời gian thực.
8. Một số thách thức thường gặp với Hadoop là gì?
Mặc dù framework Hadoop rất giỏi quản lý và xử lý lượng dữ liệu khổng lồ có giá trị, nó vẫn đặt ra vài thách thức quan trọng.
Hãy cùng tìm hiểu:
- Vấn đề lớn nhất với Hadoop là NameNode có điểm lỗi đơn (single point of failure), gây mất dữ liệu nếu xảy ra lỗi.
- Hadoop dễ bị đe dọa bảo mật. Bạn không thể kiểm soát trực tiếp dữ liệu của mình, và không có cách nào biết nó có bị lạm dụng hay không.
- Framework MapReduce của Hadoop xử lý dữ liệu theo lô và không hỗ trợ xử lý dữ liệu thời gian thực.
- Framework này hoạt động tốt với dữ liệu dung lượng lớn nhưng không xử lý tốt tệp nhỏ. Khi dữ liệu nhỏ hơn kích thước block mặc định của HDFS, nó gây quá tải NameNode và dẫn đến độ trễ.
9. HBase là gì và vai trò các thành phần của nó?
HBase là cơ sở dữ liệu được thiết kế để truy cập nhanh các tệp lớn. Nó cho phép đọc/ghi các bộ dữ liệu lớn theo thời gian thực bằng cách lưu trữ dữ liệu theo cột và lập chỉ mục bằng khóa hàng (row key) duy nhất.
Thiết kế này cho phép truy xuất dữ liệu nhanh và quét hiệu quả, phù hợp với các bảng lớn và thưa vì có thể thêm bao nhiêu nút tùy cần.
HBase có ba thành phần:
- HMaster: Quản lý các region server và chịu trách nhiệm tạo, xóa bảng.
- Region server: Xử lý yêu cầu đọc và ghi, quản lý việc tách (split) region.
- ZooKeeper: Duy trì trạng thái cụm và quản lý việc gán máy chủ
10. Điều gì khiến Hadoop 2.0 khác với Hadoop 1.x?
Bảng sau so sánh hai phiên bản Hadoop cạnh nhau:
|
Tiêu chí
|
Hadoop 1.x
|
Hadoop 2.0
|
|
Quản lý NameNode
|
Một NameNode duy nhất quản lý không gian tên
|
Nhiều NameNode xử lý không gian tên thông qua liên bang HDFS (HDFS federation)
|
|
Hỗ trợ hệ điều hành
|
Không hỗ trợ Microsoft Windows
|
Bổ sung hỗ trợ cho Microsoft
|
|
Quản lý job và tài nguyên
|
Dùng JobTracker và TaskTracker để quản lý job và tài nguyên
|
Thay bằng YARN để tách hai nhiệm vụ này
|
|
Khả năng mở rộng
|
Có thể mở rộng đến 4.000 nút mỗi cụm
|
Có thể mở rộng đến 10.000 nút mỗi cụm
|
|
Kích thước DataNode
|
Kích thước DataNode là 64 MB
|
Tăng gấp đôi lên 128 MB
|
|
Thực thi tác vụ
|
Dùng slot chỉ chạy được tác vụ Map hoặc Reduce
|
Dùng container có thể chạy bất kỳ tác vụ nào
|
Nếu bạn ứng tuyển vị trí kỹ sư dữ liệu, hãy xem bài viết tổng hợp về các câu hỏi phỏng vấn kỹ sư dữ liệu.
Câu hỏi phỏng vấn Hadoop nâng cao
Đến đây mới là phần thú vị. Những câu hỏi phỏng vấn này kiểm tra bạn ở cấp độ nâng cao, đặc biệt quan trọng với các kỹ sư cấp cao.
11. Khái niệm Active NameNode và Standby NameNode trong Hadoop 2.0 là gì?
Trong Hadoop 2.0, Active NameNode quản lý không gian tên hệ thống tệp và kiểm soát quyền truy cập tệp của khách hàng. Ngược lại, Standby NameNode là bản dự phòng và duy trì đủ thông tin để tiếp quản nếu Active NameNode gặp sự cố.
Điều này khắc phục vấn đề điểm lỗi đơn (SPOF) thường gặp ở Hadoop 1.x.
12. Mục đích của distributed cache trong Hadoop là gì? Vì sao HDFS không đọc tệp nhỏ?
HDFS kém hiệu quả khi xử lý hàng nghìn tệp nhỏ, dẫn đến độ trễ tăng. Vì vậy distributed cache cho phép bạn lưu trữ các tệp chỉ đọc, archive và jar và cung cấp chúng cho các tác vụ trong MapReduce.
Giả sử bạn cần chạy 40 job MapReduce và mỗi job cần truy cập tệp từ HDFS. Trong thực tế, con số này có thể tăng lên hàng trăm hoặc hàng nghìn lượt đọc. Ứng dụng sẽ thường xuyên định vị các tệp này trong HDFS, gây quá tải HDFS và ảnh hưởng hiệu năng.
Tuy nhiên, distributed cache có thể xử lý nhiều tệp kích thước nhỏ mà không ảnh hưởng thời gian truy cập và tốc độ xử lý.
13. Giải thích vai trò của checksum trong phát hiện dữ liệu hỏng. Đồng thời nêu mã phát hiện lỗi tiêu chuẩn.
Checksum giúp nhận diện dữ liệu bị hỏng trong HDFS. Khi dữ liệu vào hệ thống, nó tạo ra một giá trị nhỏ gọi là checksum. Hadoop tính lại checksum khi người dùng yêu cầu truyền dữ liệu. Nếu checksum mới khớp với bản gốc, dữ liệu còn nguyên vẹn; nếu không, dữ liệu đã hỏng.
Mã phát hiện lỗi cho Hadoop là CRC-32.
14. HDFS đạt tính chịu lỗi như thế nào?
HDFS đạt tính chịu lỗi thông qua quy trình sao chép, đảm bảo độ tin cậy và sẵn sàng. Cách quy trình sao chép hoạt động:
- Phân phối khối ban đầu: Khi tệp được lưu, HDFS chia nhỏ thành các khối và gán cho các DataNode khác nhau. Ví dụ, tệp chia thành các khối A, B và C có thể được lưu trên DataNode A1, B2 và C3.
- Sao chép: Mỗi DataNode giữ một khối sẽ sao chép khối đó sang các DataNode khác trong cụm. Chẳng hạn DataNode A1, giữ khối A, sẽ tạo bản sao bổ sung trên các DataNode khác như D1 và D2. Nghĩa là nếu A1 gặp sự cố, các bản sao của A trên D1 và D2 vẫn sẵn sàng.
- Xử lý lỗi: Nếu DataNode D1 hỏng, bạn có thể truy xuất các khối cần thiết (B và C) từ các DataNode khác như B2 và C3.
15. Bạn có thể xử lý tệp nén với MapReduce không? Nếu có, hỗ trợ các định dạng nào và chúng có thể tách (splittable) không?
Có, có thể xử lý tệp nén với MapReduce. Hadoop hỗ trợ nhiều định dạng nén, nhưng không phải tất cả đều có thể tách.
Các định dạng MapReduce hỗ trợ gồm:
- DEFLATE
- gzip
- bzip2
- LZO
- LZ4
- Snappy
Trong số này, chỉ bzip2 là định dạng có thể tách.
HDFS chia các tệp rất lớn thành những phần nhỏ hơn, mỗi phần 128 MB. Ví dụ, HDFS sẽ chia một tệp 1,28 GB thành mười khối. Mỗi khối sau đó được xử lý bởi một mapper riêng trong job MapReduce. Nhưng nếu tệp không thể tách, một mapper duy nhất sẽ xử lý toàn bộ tệp.
Câu hỏi phỏng vấn Hive
Một số công việc yêu cầu chuyên môn tích hợp Hive với Hadoop. Ở vai trò cụ thể như vậy, nhà tuyển dụng sẽ tập trung vào các câu hỏi sau:
16. Định nghĩa Hive.
Hive là hệ thống kho dữ liệu thực hiện các job xử lý theo lô và phân tích dữ liệu. Nó được Facebook phát triển để chạy các truy vấn dạng SQL trên các bộ dữ liệu khổng lồ lưu trữ trong HDFS mà không phải dựa vào Java.
Với Hive, chúng ta có thể tổ chức dữ liệu theo bảng và dùng metastore để lưu metadata như schema. Nó hỗ trợ nhiều hệ thống lưu trữ như S3, Azure Data Lake Storage (ADLs) và Google Cloud Storage.
Hive Metastore (HMS) là cơ sở dữ liệu tập trung cho metadata. Nó chứa thông tin về bảng, view và quyền truy cập được lưu trong lưu trữ đối tượng HDFS.
Có hai loại bảng trong HIVE Metastore:
- Managed Metastore: HIVE lưu trữ và quản lý bảng này trong Hive service JVM. Chúng ta có thể tìm các bảng này bằng giá trị mặc định
/user/hive/warehouse.
- External Metastore: Các bảng này chạy trên JVM bên ngoài. Do đó, bất kỳ thay đổi nào trong metadata của Hive sẽ không ảnh hưởng đến dữ liệu lưu trong các bảng này.
18. Hive hỗ trợ những ngôn ngữ lập trình nào?
Hive cung cấp hỗ trợ mạnh mẽ để tích hợp với nhiều ngôn ngữ lập trình, tăng tính linh hoạt và khả dụng trong các ứng dụng khác nhau:
- Python: Phân tích dữ liệu và machine learning.
- Java: Ứng dụng doanh nghiệp và xử lý dữ liệu tùy chỉnh.
- C++: Ứng dụng đòi hỏi hiệu năng cao và SerDes tùy chỉnh.
- PHP: Ứng dụng web truy cập dữ liệu Hive.
19. Kích thước dữ liệu tối đa Hive có thể xử lý là bao nhiêu?
Nhờ tích hợp với HDFS và kiến trúc có khả năng mở rộng, Hive có thể xử lý dữ liệu ở mức petabyte. Không có giới hạn trên cố định về kích thước dữ liệu mà Hive có thể quản lý, khiến nó trở thành công cụ mạnh mẽ cho xử lý và phân tích big data.
20. Hive có bao nhiêu kiểu dữ liệu?
Hive cung cấp bộ kiểu dữ liệu phong phú để đáp ứng các yêu cầu dữ liệu khác nhau:
- Kiểu dựng sẵn: Numeric, String, Date/Time và các kiểu khác cho lưu trữ dữ liệu cơ bản.
- Kiểu phức tạp: ARRAY, MAP, STRUCT và UNIONTYPE cho các biểu diễn dữ liệu có cấu trúc, nâng cao.
Kiểu dữ liệu dựng sẵn:
|
Nhóm
|
Kiểu dữ liệu
|
Mô tả
|
Ví dụ
|
|
Kiểu số
|
TINYINT
|
Số nguyên có dấu 1 byte
|
127
|
| |
SMALLINT
|
Số nguyên có dấu 2 byte
|
32767
|
| |
INT
|
Số nguyên có dấu 4 byte
|
2147483647
|
| |
BIGINT
|
Số nguyên có dấu 8 byte
|
9223372036854775807
|
| |
FLOAT
|
Số thực dấu phẩy động đơn chính xác
|
3.14
|
| |
DOUBLE
|
Số thực dấu phẩy động kép chính xác
|
3.141592653589793
|
| |
DECIMAL
|
Số thập phân có dấu, độ chính xác tùy ý
|
1234567890.1234567890
|
|
Kiểu chuỗi
|
STRING
|
Chuỗi độ dài biến đổi
|
'Hello, World!'
|
| |
VARCHAR
|
Chuỗi độ dài biến đổi với độ dài tối đa chỉ định
|
'Example'
|
| |
CHAR
|
Chuỗi độ dài cố định
|
'A'
|
|
Kiểu ngày/giờ
|
TIMESTAMP
|
Ngày và giờ, bao gồm múi giờ
|
'2023-01-01 12:34:56'
|
| |
DATE
|
Ngày không có thời gian
|
'2023-01-01'
|
| |
INTERVAL
|
Khoảng thời gian
|
INTERVAL '1' DAY
|
|
Các kiểu khác
|
BOOLEAN
|
Đại diện cho đúng hoặc sai
|
TRUE
|
| |
BINARY
|
Dãy byte
|
0x1A2B3C
|
Kiểu dữ liệu phức tạp:
|
Kiểu dữ liệu
|
Mô tả
|
Ví dụ
|
|
ARRAY
|
Tập hợp có thứ tự các phần tử
|
ARRAY<STRING> ('apple', 'banana', 'cherry')
|
|
MAP
|
Tập hợp các cặp khóa-giá trị
|
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
|
|
STRUCT
|
Tập hợp các trường với kiểu dữ liệu khác nhau
|
STRUCT<name: STRING, age: INT> ('Alice', 30)
|
|
UNIONTYPE
|
Có thể chứa một trong nhiều kiểu chỉ định
|
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three')
|
Câu hỏi phỏng vấn Hadoop theo kịch bản cho Kỹ sư Big Data
Những câu hỏi này kiểm tra khả năng bạn sử dụng Hadoop để xử lý vấn đề thực tế. Chúng đặc biệt phù hợp nếu bạn ứng tuyển vai trò kiến trúc sư dữ liệu nhưng cũng có thể xuất hiện ở bất kỳ quy trình phỏng vấn nào yêu cầu kiến thức Hadoop.
21. Bạn đang thiết lập cụm HDFS với hệ thống sao chép của Hadoop. Cụm có ba rack: A, B và C. Hãy giải thích cách Hadoop sẽ sao chép tệp tên là datafile.text.
Cách Hadoop sao chép dữ liệu như sau:
- Bản sao thứ nhất trên rack A: Hadoop đặt bản sao đầu tiên trên một nút được chọn ngẫu nhiên trong rack A. Quyết định này giảm độ trễ ghi bằng cách chọn nút cục bộ hoặc gần kề.
- Bản sao thứ hai trên rack B: Bản sao thứ hai được đặt trên một nút ở rack khác, chẳng hạn rack B. Điều này đảm bảo dữ liệu không bị mất nếu rack A gặp sự cố, tăng khả năng chịu lỗi.
- Bản sao thứ ba trên rack B: Bản sao thứ ba được đặt trên một nút khác trong rack B. Đặt cùng rack với bản sao thứ hai giúp cân bằng tải mạng giữa các rack và giảm lưu lượng liên rack.
Chiến lược sao chép của Hadoop trong cụm HDFS có ba rack (A, B và C) được thiết kế để tối ưu phân phối tải, nâng cao khả năng chịu lỗi và cải thiện hiệu quả mạng. Nhờ vậy, datafile.text được sao chép theo cách cân bằng hiệu năng và độ tin cậy.
22. Bạn đang làm việc trên một ứng dụng dựa trên Hadoop tương tác với tệp bằng LocalFileSystem. Bạn sẽ xử lý tính toàn vẹn dữ liệu với checksum như thế nào?
Sử dụng checksum trong LocalFileSystem của Hadoop đảm bảo toàn vẹn dữ liệu bằng cách:
- Tạo checksum: Tự động tạo checksum cho các khối dữ liệu khi ghi tệp.
- Lưu checksum: Lưu checksum trong tệp ẩn
.filename.crc cùng thư mục.
- Xác minh checksum: So sánh checksum đã lưu với dữ liệu thực khi đọc.
- Phát hiện sai lệch: Ném
ChecksumException nếu có chênh lệch.
Bằng cách làm theo các bước này, chúng ta có thể đảm bảo ứng dụng duy trì tính toàn vẹn dữ liệu và phát hiện kịp thời mọi hỏng hóc dữ liệu tiềm ẩn.
23. Giả sử bạn đang gỡ lỗi một job Hadoop quy mô lớn chạy trên nhiều nút và có các trường hợp bất thường ảnh hưởng đầu ra. Bạn sẽ xử lý thế nào?
Chúng ta có thể làm như sau:
- Ghi log các vấn đề tiềm ẩn: Dùng câu lệnh debug để ghi log vấn đề tiềm ẩn vào
stderr.
- Cập nhật trạng thái tác vụ: Đưa vị trí log lỗi vào thông điệp trạng thái tác vụ.
- Bộ đếm tùy chỉnh: Triển khai các counter để theo dõi và phân tích các điều kiện bất thường.
- Gỡ lỗi đầu ra map: Ghi thông tin debug vào đầu ra của map.
- Chương trình phân tích log: Tạo một chương trình MapReduce để phân tích log chi tiết.
Bằng cách này, chúng ta có thể gỡ lỗi có hệ thống các job Hadoop quy mô lớn và theo dõi, khắc phục hiệu quả những trường hợp bất thường ảnh hưởng kết quả.
24. Bạn đang tính toán thiết lập bộ nhớ cho cụm Hadoop dùng YARN. Hãy giải thích cách bạn đặt bộ nhớ cho NodeManager và các job MapReduce.
Khi cấu hình bộ nhớ cho cụm Hadoop dùng YARN, điều quan trọng là cân bằng phân bổ bộ nhớ giữa các daemon của Hadoop, tiến trình hệ thống và NodeManager để tối ưu hiệu năng và sử dụng tài nguyên.
Đặt bộ nhớ cho NodeManager:
- Tính tổng bộ nhớ vật lý của nút: Xác định tổng bộ nhớ vật lý có sẵn trên mỗi nút trong cụm. Ví dụ, nếu một nút có 64 GB RAM, tổng bộ nhớ vật lý là 64.000 MB.
- Trừ bộ nhớ cho các daemon Hadoop: Phân bổ bộ nhớ cho các daemon Hadoop chạy trên nút như DataNode và NodeManager. Thường 1.000 đến 2.000 MB mỗi daemon là đủ. Chẳng hạn, nếu bạn cấp 1.500 MB cho mỗi DataNode và NodeManager, hãy dự trữ 3.000 MB.
- Dự phòng bộ nhớ cho tiến trình hệ thống: Dành riêng bộ nhớ cho các tiến trình hệ thống và dịch vụ nền khác để hệ điều hành và dịch vụ thiết yếu chạy mượt. Mức dự phòng điển hình là 2 GB (2.000 MB).
- Phần còn lại cho NodeManager: Trừ phần dự phòng cho daemon Hadoop và tiến trình hệ thống khỏi tổng bộ nhớ vật lý để xác định bộ nhớ còn lại mà NodeManager có thể cấp cho container.
Đặt bộ nhớ cho các job MapReduce:
- Điều chỉnh
mapreduce.map.memory.mb: Tham số này xác định lượng bộ nhớ cấp cho mỗi tác vụ map. Điều chỉnh dựa trên nhu cầu bộ nhớ của tác vụ map.
- Ví dụ, đặt
mapreduce.map.memory.mb là 2048 MB nghĩa là mỗi tác vụ map được cấp 2 GB bộ nhớ.
- Điều chỉnh
mapreduce.reduce.memory.mb: Tham số này xác định lượng bộ nhớ cấp cho mỗi tác vụ reduce. Điều chỉnh theo nhu cầu bộ nhớ của tác vụ reduce.
- Ví dụ, đặt
mapreduce.reduce.memory.mb là 4096 MB nghĩa là mỗi tác vụ reduce được cấp 4 GB bộ nhớ.
- Cấu hình kích thước container: Đảm bảo kích thước container được đặt phù hợp trong
yarn-site.xml với các tham số như yarn.nodemanager.resource.memory-mb, phù hợp với bộ nhớ cấp cho NodeManager.
- Ví dụ, nếu NodeManager có 59.000 MB sẵn có, bạn có thể đặt
yarn.nodemanager.resource.memory-mb là 59.000 MB.
Tóm tắt cấu hình bộ nhớ:
|
Thành phần
|
Cấu hình
|
Giá trị ví dụ
|
|
NodeManager
|
Tổng bộ nhớ vật lý
|
64.000 MB
|
| |
Bộ nhớ cho daemon Hadoop
|
3.000 MB
|
| |
Bộ nhớ cho tiến trình hệ thống
|
2.000 MB
|
| |
Bộ nhớ còn lại cho NodeManager
|
59.000 MB
|
|
Tác vụ map của MapReduce
|
mapreduce.map.memory.mb
|
2048 MB
|
|
Tác vụ reduce của MapReduce
|
mapreduce.reduce.memory.mb
|
4096 MB
|
|
Kích thước container
|
yarn.nodemanager.resource.memory-mb
|
59.000 MB
|
Kết luận
Sau khi nắm các câu hỏi này, bạn sẽ hiểu các thuật ngữ cơ bản và có
năng lực vững vàng với những phức tạp của các ứng dụng Hadoop trong thực tế. Bên cạnh đó, bạn cần thích ứng với các dự án mới xây dựng trên Hadoop để luôn phù hợp và chinh phục các buổi phỏng vấn.
Bạn cũng có thể mở rộng kiến thức về các framework big data khác như Spark và Flink, vì chúng nhanh và có độ trễ thấp hơn Hadoop.
Nếu bạn đang tìm một lộ trình học có cấu trúc để làm chủ big data, hãy tham khảo các tài nguyên sau:
- Big Data Fundamentals with PySpark: Khóa học khởi đầu tuyệt vời để học những kiến thức cơ bản về xử lý big data với PySpark.
- Big Data with PySpark: Lộ trình cung cấp giới thiệu toàn diện về các khái niệm big data bằng PySpark, bao gồm thao tác dữ liệu, machine learning và hơn thế nữa.


Chuyên gia Hadoop viết ứng dụng và phân tích dữ liệu liên tục thay đổi để rút ra insight và duy trì bảo mật dữ liệu. Vì vậy, nhà tuyển dụng đặt ra tiêu chí khắt khe để tìm người phù hợp nhất cho vị trí và có thể hỏi bạn từ những điều cơ bản đến nâng cao.
Trong bài viết này, chúng tôi đã tổng hợp 24 câu hỏi và đáp án phỏng vấn Hadoop thường gặp nhất.
Bài viết này được thiết kế để giúp bạn chuẩn bị kỹ lưỡng cho buổi phỏng vấn việc làm big data tiếp theo. Nội dung bao quát từ khái niệm nền tảng đến các kịch bản nâng cao. Dù bạn là người mới bắt đầu hay đã có kinh nghiệm, bạn sẽ tìm thấy những insight hữu ích và thông tin thực tiễn để tăng sự tự tin và cải thiện cơ hội thành công.
Câu hỏi phỏng vấn Hadoop cơ bản
Người phỏng vấn thường bắt đầu bằng các câu hỏi cơ bản để đánh giá mức độ hiểu biết của bạn về Hadoop và vai trò của nó trong quản trị dữ liệu lớn.
Ngay cả khi bạn là kỹ sư dày dạn, hãy đảm bảo bạn nắm vững những câu hỏi này.
1. Dữ liệu lớn (big data) là gì?
Lượng dữ liệu tạo ra toàn cầu tính bằng Zettabyte. Nguồn: Statista.
Big data đề cập đến lượng dữ liệu khổng lồ, phức tạp, được tạo ra với tốc độ cao từ nhiều nguồn khác nhau. Tổng lượng dữ liệu được tạo ra trên toàn cầu là 180 zettabyte vào năm 2025 và dự kiến sẽ tăng gấp ba vào năm 2029.
Khi việc tạo dữ liệu tăng tốc, các phương pháp phân tích truyền thống sẽ không đáp ứng được xử lý thời gian thực và bảo mật dữ liệu. Đó là lý do các công ty sử dụng những framework tiên tiến như Hadoop để xử lý và quản lý khối lượng dữ liệu ngày càng tăng.
Nếu bạn muốn bắt đầu sự nghiệp trong lĩnh vực big data, hãy xem hướng dẫn về đào tạo big data của chúng tôi.
2. Hadoop là gì và nó giải quyết bài toán big data như thế nào?
Hadoop là một framework mã nguồn mở để xử lý các bộ dữ liệu lớn được phân tán trên nhiều máy tính. Nó lưu trữ dữ liệu trên nhiều máy dưới dạng các khối nhỏ bằng Hệ thống Tệp Phân tán Hadoop (HDFS).
Với Hadoop, bạn có thể thêm nhiều nút vào cụm và xử lý lượng dữ liệu lớn mà không cần nâng cấp phần cứng đắt đỏ.
Ngay cả các công ty lớn như Google và Facebook cũng dựa vào Hadoop để quản lý và phân tích dữ liệu hàng ngày từ terabyte đến petabyte.
3. Hai thành phần chính của Hadoop là gì?
Hai thành phần chính của Hadoop gồm:
Kiến trúc cấp cao của Hadoop. Nguồn: Wikimedia Commons
4. Định nghĩa vai trò của NameNode và DataNode trong Hadoop.
HDFS gồm một NameNode và nhiều DataNode để quản lý dữ liệu, như minh họa ở hình trên. Cách chúng hoạt động:
5. Giải thích vai trò của Hadoop YARN.
Trong Hadoop 1.x, MapReduce quản lý tài nguyên và lập lịch công việc bằng JobTracker. Tuy nhiên, điểm yếu lớn là tốc độ xử lý chậm.
Hadoop 2.0 giới thiệu YARN (Yet Another Resource Negotiator) để giải quyết các vấn đề này. YARN tách quản lý tài nguyên và lập lịch công việc thành các thành phần riêng, giúp cải thiện khả năng mở rộng và sử dụng tài nguyên. Các thành phần chính của YARN là:
Cách YARN hoạt động:
Câu hỏi phỏng vấn Hadoop trung cấp
Các câu hỏi trung cấp tập trung hơn vào việc đánh giá hiểu biết của bạn về các khía cạnh kỹ thuật của framework Hadoop. Người phỏng vấn có thể hỏi về cụm Hadoop, các thách thức của nó và so sánh các phiên bản khác nhau.
6. Cụm Hadoop là gì và có kích thước cụm cụ thể nào mà các công ty ưa chuộng không?
Cụm Hadoop là tập hợp các nút chủ và nút phụ được kết nối với nhau, được thiết kế để lưu trữ và xử lý các bộ dữ liệu lớn theo cách phân tán. Kiến trúc cụm đảm bảo tính sẵn sàng cao, khả năng mở rộng và chịu lỗi.
Thành phần của cụm Hadoop:
Có hai cách chính để thiết lập cụm Hadoop:
So sánh cụm on-premises và cụm đám mây:
Tính năng
Cụm on-premises
Cụm đám mây
Chi phí thiết lập
Đầu tư ban đầu cao
Mô hình trả theo mức dùng
Khả năng mở rộng
Giới hạn bởi phần cứng vật lý
Gần như không giới hạn
Bảo trì
Cần đội ngũ nội bộ quản lý
Do nhà cung cấp đám mây quản lý
Tính linh hoạt
Tùy biến phần cứng và phần mềm
Tùy chọn cấu hình sẵn
Thời gian triển khai
Thời gian thiết lập lâu hơn
Triển khai nhanh và dễ
Không có kích thước cụm ưa thích cố định. Kích thước cụm dễ mở rộng và hoàn toàn phụ thuộc vào nhu cầu lưu trữ. Doanh nghiệp nhỏ có thể dùng cụm khoảng 20 nút, trong khi các doanh nghiệp như Yahoo vận hành (hoặc từng vận hành) các cụm lớn tới 40.000 nút.
7. Một số dự án trong hệ sinh thái Hadoop là gì?
Các ngành khác nhau có nhu cầu phân tích và xử lý dữ liệu riêng. Vì vậy, Hadoop đã phát hành nhiều dự án trong hệ sinh thái để đáp ứng các nhu cầu đó. Danh sách dự án Hadoop rộng hơn bạn tưởng—nhưng đây là những cái cốt lõi:
8. Một số thách thức thường gặp với Hadoop là gì?
Mặc dù framework Hadoop rất giỏi quản lý và xử lý lượng dữ liệu khổng lồ có giá trị, nó vẫn đặt ra vài thách thức quan trọng.
Hãy cùng tìm hiểu:
9. HBase là gì và vai trò các thành phần của nó?
HBase là cơ sở dữ liệu được thiết kế để truy cập nhanh các tệp lớn. Nó cho phép đọc/ghi các bộ dữ liệu lớn theo thời gian thực bằng cách lưu trữ dữ liệu theo cột và lập chỉ mục bằng khóa hàng (row key) duy nhất.
Thiết kế này cho phép truy xuất dữ liệu nhanh và quét hiệu quả, phù hợp với các bảng lớn và thưa vì có thể thêm bao nhiêu nút tùy cần.
HBase có ba thành phần:
10. Điều gì khiến Hadoop 2.0 khác với Hadoop 1.x?
Bảng sau so sánh hai phiên bản Hadoop cạnh nhau:
Tiêu chí
Hadoop 1.x
Hadoop 2.0
Quản lý NameNode
Một NameNode duy nhất quản lý không gian tên
Nhiều NameNode xử lý không gian tên thông qua liên bang HDFS (HDFS federation)
Hỗ trợ hệ điều hành
Không hỗ trợ Microsoft Windows
Bổ sung hỗ trợ cho Microsoft
Quản lý job và tài nguyên
Dùng JobTracker và TaskTracker để quản lý job và tài nguyên
Thay bằng YARN để tách hai nhiệm vụ này
Khả năng mở rộng
Có thể mở rộng đến 4.000 nút mỗi cụm
Có thể mở rộng đến 10.000 nút mỗi cụm
Kích thước DataNode
Kích thước DataNode là 64 MB
Tăng gấp đôi lên 128 MB
Thực thi tác vụ
Dùng slot chỉ chạy được tác vụ Map hoặc Reduce
Dùng container có thể chạy bất kỳ tác vụ nào
Nếu bạn ứng tuyển vị trí kỹ sư dữ liệu, hãy xem bài viết tổng hợp về các câu hỏi phỏng vấn kỹ sư dữ liệu.
Câu hỏi phỏng vấn Hadoop nâng cao
Đến đây mới là phần thú vị. Những câu hỏi phỏng vấn này kiểm tra bạn ở cấp độ nâng cao, đặc biệt quan trọng với các kỹ sư cấp cao.
11. Khái niệm Active NameNode và Standby NameNode trong Hadoop 2.0 là gì?
Trong Hadoop 2.0, Active NameNode quản lý không gian tên hệ thống tệp và kiểm soát quyền truy cập tệp của khách hàng. Ngược lại, Standby NameNode là bản dự phòng và duy trì đủ thông tin để tiếp quản nếu Active NameNode gặp sự cố.
Điều này khắc phục vấn đề điểm lỗi đơn (SPOF) thường gặp ở Hadoop 1.x.
12. Mục đích của distributed cache trong Hadoop là gì? Vì sao HDFS không đọc tệp nhỏ?
HDFS kém hiệu quả khi xử lý hàng nghìn tệp nhỏ, dẫn đến độ trễ tăng. Vì vậy distributed cache cho phép bạn lưu trữ các tệp chỉ đọc, archive và jar và cung cấp chúng cho các tác vụ trong MapReduce.
Giả sử bạn cần chạy 40 job MapReduce và mỗi job cần truy cập tệp từ HDFS. Trong thực tế, con số này có thể tăng lên hàng trăm hoặc hàng nghìn lượt đọc. Ứng dụng sẽ thường xuyên định vị các tệp này trong HDFS, gây quá tải HDFS và ảnh hưởng hiệu năng.
Tuy nhiên, distributed cache có thể xử lý nhiều tệp kích thước nhỏ mà không ảnh hưởng thời gian truy cập và tốc độ xử lý.
13. Giải thích vai trò của checksum trong phát hiện dữ liệu hỏng. Đồng thời nêu mã phát hiện lỗi tiêu chuẩn.
Checksum giúp nhận diện dữ liệu bị hỏng trong HDFS. Khi dữ liệu vào hệ thống, nó tạo ra một giá trị nhỏ gọi là checksum. Hadoop tính lại checksum khi người dùng yêu cầu truyền dữ liệu. Nếu checksum mới khớp với bản gốc, dữ liệu còn nguyên vẹn; nếu không, dữ liệu đã hỏng.
Mã phát hiện lỗi cho Hadoop là CRC-32.
14. HDFS đạt tính chịu lỗi như thế nào?
HDFS đạt tính chịu lỗi thông qua quy trình sao chép, đảm bảo độ tin cậy và sẵn sàng. Cách quy trình sao chép hoạt động:
15. Bạn có thể xử lý tệp nén với MapReduce không? Nếu có, hỗ trợ các định dạng nào và chúng có thể tách (splittable) không?
Có, có thể xử lý tệp nén với MapReduce. Hadoop hỗ trợ nhiều định dạng nén, nhưng không phải tất cả đều có thể tách.
Các định dạng MapReduce hỗ trợ gồm:
Trong số này, chỉ bzip2 là định dạng có thể tách.
HDFS chia các tệp rất lớn thành những phần nhỏ hơn, mỗi phần 128 MB. Ví dụ, HDFS sẽ chia một tệp 1,28 GB thành mười khối. Mỗi khối sau đó được xử lý bởi một mapper riêng trong job MapReduce. Nhưng nếu tệp không thể tách, một mapper duy nhất sẽ xử lý toàn bộ tệp.
Câu hỏi phỏng vấn Hive
Một số công việc yêu cầu chuyên môn tích hợp Hive với Hadoop. Ở vai trò cụ thể như vậy, nhà tuyển dụng sẽ tập trung vào các câu hỏi sau:
16. Định nghĩa Hive.
Hive là hệ thống kho dữ liệu thực hiện các job xử lý theo lô và phân tích dữ liệu. Nó được Facebook phát triển để chạy các truy vấn dạng SQL trên các bộ dữ liệu khổng lồ lưu trữ trong HDFS mà không phải dựa vào Java.
Với Hive, chúng ta có thể tổ chức dữ liệu theo bảng và dùng metastore để lưu metadata như schema. Nó hỗ trợ nhiều hệ thống lưu trữ như S3, Azure Data Lake Storage (ADLs) và Google Cloud Storage.
17. Hive Metastore (HMS) là gì? Bạn phân biệt Managed Metastore với External Metastore như thế nào?
Hive Metastore (HMS) là cơ sở dữ liệu tập trung cho metadata. Nó chứa thông tin về bảng, view và quyền truy cập được lưu trong lưu trữ đối tượng HDFS.
Có hai loại bảng trong HIVE Metastore:
/user/hive/warehouse.18. Hive hỗ trợ những ngôn ngữ lập trình nào?
Hive cung cấp hỗ trợ mạnh mẽ để tích hợp với nhiều ngôn ngữ lập trình, tăng tính linh hoạt và khả dụng trong các ứng dụng khác nhau:
19. Kích thước dữ liệu tối đa Hive có thể xử lý là bao nhiêu?
Nhờ tích hợp với HDFS và kiến trúc có khả năng mở rộng, Hive có thể xử lý dữ liệu ở mức petabyte. Không có giới hạn trên cố định về kích thước dữ liệu mà Hive có thể quản lý, khiến nó trở thành công cụ mạnh mẽ cho xử lý và phân tích big data.
20. Hive có bao nhiêu kiểu dữ liệu?
Hive cung cấp bộ kiểu dữ liệu phong phú để đáp ứng các yêu cầu dữ liệu khác nhau:
Kiểu dữ liệu dựng sẵn:
Nhóm
Kiểu dữ liệu
Mô tả
Ví dụ
Kiểu số
TINYINT
Số nguyên có dấu 1 byte
127
SMALLINT
Số nguyên có dấu 2 byte
32767
INT
Số nguyên có dấu 4 byte
2147483647
BIGINT
Số nguyên có dấu 8 byte
9223372036854775807
FLOAT
Số thực dấu phẩy động đơn chính xác
3.14
DOUBLE
Số thực dấu phẩy động kép chính xác
3.141592653589793
DECIMAL
Số thập phân có dấu, độ chính xác tùy ý
1234567890.1234567890
Kiểu chuỗi
STRING
Chuỗi độ dài biến đổi
'Hello, World!'
VARCHAR
Chuỗi độ dài biến đổi với độ dài tối đa chỉ định
'Example'
CHAR
Chuỗi độ dài cố định
'A'
Kiểu ngày/giờ
TIMESTAMP
Ngày và giờ, bao gồm múi giờ
'2023-01-01 12:34:56'
DATE
Ngày không có thời gian
'2023-01-01'
INTERVAL
Khoảng thời gian
INTERVAL '1' DAY
Các kiểu khác
BOOLEAN
Đại diện cho đúng hoặc sai
TRUE
BINARY
Dãy byte
0x1A2B3C
Kiểu dữ liệu phức tạp:
Kiểu dữ liệu
Mô tả
Ví dụ
ARRAY
Tập hợp có thứ tự các phần tử
ARRAY<STRING> ('apple', 'banana', 'cherry')
MAP
Tập hợp các cặp khóa-giá trị
MAP<STRING, INT> ('key1' -> 1, 'key2' -> 2)
STRUCT
Tập hợp các trường với kiểu dữ liệu khác nhau
STRUCT<name: STRING, age: INT> ('Alice', 30)
UNIONTYPE
Có thể chứa một trong nhiều kiểu chỉ định
UNIONTYPE<INT, DOUBLE, STRING> (1, 2.0, 'three')
Câu hỏi phỏng vấn Hadoop theo kịch bản cho Kỹ sư Big Data
Những câu hỏi này kiểm tra khả năng bạn sử dụng Hadoop để xử lý vấn đề thực tế. Chúng đặc biệt phù hợp nếu bạn ứng tuyển vai trò kiến trúc sư dữ liệu nhưng cũng có thể xuất hiện ở bất kỳ quy trình phỏng vấn nào yêu cầu kiến thức Hadoop.
21. Bạn đang thiết lập cụm HDFS với hệ thống sao chép của Hadoop. Cụm có ba rack: A, B và C. Hãy giải thích cách Hadoop sẽ sao chép tệp tên là datafile.text.
Cách Hadoop sao chép dữ liệu như sau:
Chiến lược sao chép của Hadoop trong cụm HDFS có ba rack (A, B và C) được thiết kế để tối ưu phân phối tải, nâng cao khả năng chịu lỗi và cải thiện hiệu quả mạng. Nhờ vậy,
datafile.textđược sao chép theo cách cân bằng hiệu năng và độ tin cậy.22. Bạn đang làm việc trên một ứng dụng dựa trên Hadoop tương tác với tệp bằng LocalFileSystem. Bạn sẽ xử lý tính toàn vẹn dữ liệu với checksum như thế nào?
Sử dụng checksum trong
LocalFileSystemcủa Hadoop đảm bảo toàn vẹn dữ liệu bằng cách:.filename.crccùng thư mục.ChecksumExceptionnếu có chênh lệch.Bằng cách làm theo các bước này, chúng ta có thể đảm bảo ứng dụng duy trì tính toàn vẹn dữ liệu và phát hiện kịp thời mọi hỏng hóc dữ liệu tiềm ẩn.
23. Giả sử bạn đang gỡ lỗi một job Hadoop quy mô lớn chạy trên nhiều nút và có các trường hợp bất thường ảnh hưởng đầu ra. Bạn sẽ xử lý thế nào?
Chúng ta có thể làm như sau:
stderr.Bằng cách này, chúng ta có thể gỡ lỗi có hệ thống các job Hadoop quy mô lớn và theo dõi, khắc phục hiệu quả những trường hợp bất thường ảnh hưởng kết quả.
24. Bạn đang tính toán thiết lập bộ nhớ cho cụm Hadoop dùng YARN. Hãy giải thích cách bạn đặt bộ nhớ cho NodeManager và các job MapReduce.
Khi cấu hình bộ nhớ cho cụm Hadoop dùng YARN, điều quan trọng là cân bằng phân bổ bộ nhớ giữa các daemon của Hadoop, tiến trình hệ thống và NodeManager để tối ưu hiệu năng và sử dụng tài nguyên.
Đặt bộ nhớ cho NodeManager:
Đặt bộ nhớ cho các job MapReduce:
mapreduce.map.memory.mb: Tham số này xác định lượng bộ nhớ cấp cho mỗi tác vụ map. Điều chỉnh dựa trên nhu cầu bộ nhớ của tác vụ map.mapreduce.map.memory.mblà 2048 MB nghĩa là mỗi tác vụ map được cấp 2 GB bộ nhớ.mapreduce.reduce.memory.mb: Tham số này xác định lượng bộ nhớ cấp cho mỗi tác vụ reduce. Điều chỉnh theo nhu cầu bộ nhớ của tác vụ reduce.mapreduce.reduce.memory.mblà 4096 MB nghĩa là mỗi tác vụ reduce được cấp 4 GB bộ nhớ.yarn-site.xmlvới các tham số nhưyarn.nodemanager.resource.memory-mb, phù hợp với bộ nhớ cấp cho NodeManager.yarn.nodemanager.resource.memory-mblà 59.000 MB.Tóm tắt cấu hình bộ nhớ:
Thành phần
Cấu hình
Giá trị ví dụ
NodeManager
Tổng bộ nhớ vật lý
64.000 MB
Bộ nhớ cho daemon Hadoop
3.000 MB
Bộ nhớ cho tiến trình hệ thống
2.000 MB
Bộ nhớ còn lại cho NodeManager
59.000 MB
Tác vụ map của MapReduce
mapreduce.map.memory.mb
2048 MB
Tác vụ reduce của MapReduce
mapreduce.reduce.memory.mb
4096 MB
Kích thước container
yarn.nodemanager.resource.memory-mb
59.000 MB
Kết luận
Sau khi nắm các câu hỏi này, bạn sẽ hiểu các thuật ngữ cơ bản và có
năng lực vững vàng với những phức tạp của các ứng dụng Hadoop trong thực tế. Bên cạnh đó, bạn cần thích ứng với các dự án mới xây dựng trên Hadoop để luôn phù hợp và chinh phục các buổi phỏng vấn.
Bạn cũng có thể mở rộng kiến thức về các framework big data khác như Spark và Flink, vì chúng nhanh và có độ trễ thấp hơn Hadoop.
Nếu bạn đang tìm một lộ trình học có cấu trúc để làm chủ big data, hãy tham khảo các tài nguyên sau: