课程
理解机器学习
2 小时
310.7K
这些入门级机器学习项目主要处理结构化的表格数据。您将为分析目的应用数据清洗、处理与可视化技能,并使用scikit-learn 框架来训练和验证机器学习模型。
如果您想先学习机器学习的基本概念,我们有一门零代码的机器学习入门课程。若您想提升 AI 方向的技能,也可以看看我们的AI 项目。
在Predict Energy Consumption项目中,您将使用回归与机器学习模型,根据时间段与温度等时间因素预测每日用电量。目标是发现可优化能源使用的模式,从而提升效率并降低成本。这对希望降低运营开销、推动节能并以更可持续方式管理资源的公用事业单位与企业尤为重要。
Predict Energy Consumption 是引导式项目,您也可以在其他数据集上复现实验目标,例如首尔共享单车需求。在全新数据集上实践有助于提升代码调试与问题解决能力。
在From Data to Dollars - Predicting Insurance Charges项目中,您将扮演健康保险公司的数据科学家,基于客户属性(如年龄与健康因素)构建预测模型以估算保险费用。该项目是机器学习在商业中的实际应用,有助于建立更精准的定价模型,帮助公司管理风险,并为客户制定个性化定价策略。
Predicting Insurance Charges 是引导式项目。您也可在其他数据集上复现实验结果,例如酒店预订需求数据集,用于预测客户是否会取消预订。
在Predicting Credit Card Approvals项目中,您将使用超参数优化与逻辑回归构建自动化信用卡审批应用。
您将练习处理缺失值、处理分类特征、特征缩放、应对类别不平衡,并使用 GridCV 进行自动化超参数优化。这个项目将挑战您在应对非简单、非干净数据方面的能力。

图片作者自制
Predicting Credit Card Approvals 是引导式项目。您也可以在其他数据集上复现实验结果,例如来自 LendingClub.com 的贷款数据,用于构建自动化贷款审批预测器。
您可以基于一份葡萄酒理化属性数据集(如酒精度、酸度与糖分)来搭建葡萄酒质量预测项目。通过应用 scikit-learn 的逻辑回归等分类模型,可将葡萄酒按 1–10 的等级进行分类。
该项目对于涉足葡萄酒生产与质量控制的行业非常重要,能帮助持续监控与预测葡萄酒质量,确保产品卓越性。
在Predictive Modeling for Agriculture Data Science Project中,您将使用监督学习与特征选择构建一个简单的作物推荐系统。围绕四个关键土壤属性:氮、磷、钾与 pH,并在一个现实约束下工作:农户只能负担测量其中一个。您的任务是识别单一最能预测合适作物的特征,并训练一个轻量分类器来稳定地给出推荐。
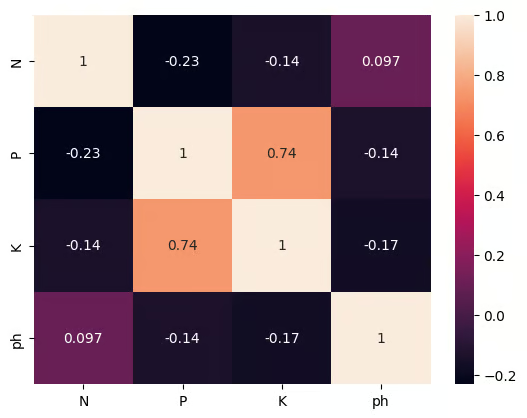
您将练习处理缺失值、标签编码、特征缩放、模型评估等实用技能,尤其是应用并比较两种特征选择技术来对土壤指标进行排序。
Store Sales 是 Kaggle 的入门竞赛,参赛者训练多种时间序列模型来提升排行榜得分。在该项目中,您将获得门店销售数据,并对其进行清洗、深入的时间序列分析、特征缩放,并训练多变量时间序列模型。
为提升排行榜得分,您可以使用 Bagging 与投票回归器等集成方法。

图片来自 Kaggle
Store Sales 是基于 Kaggle 的项目,您可以查看其他参赛者的笔记本。
为加深对时间序列预测的理解,尝试将技能应用于证券交易所数据集,并使用Facebook Prophet训练单变量时间序列预测模型。
这些中级项目聚焦于为结构化与非结构化数据进行数据处理与模型训练。学习使用多种统计工具清洗、处理与增强数据集。
Reveal Categories Found in Data项目将帮助您用聚类与自然语言处理(NLP)探索客户反馈。您将使用 K-means 聚类将 Google Play 商店的评论组织为不同类别。理解客户反馈中的共性主题对产品团队至关重要,有助于解决痛点、改进功能,并通过可执行洞见提升用户满意度。
尝试在其他数据集上复现实验结果,例如Netflix 电影数据集。
在Word Frequency in Moby Dick项目中,您将抓取赫尔曼·梅尔维尔《白鲸记》的文本,并使用 Python 的 nltk 库分析词频。本项目介绍 NLP 的关键技术,帮助理解高频词如何揭示文本模式。非常适合对文本挖掘与语言分析感兴趣的文学爱好者、历史学家或研究人员。
在Facial Recognition with Supervised Learning项目中,您将使用 Python 与 scikit-learn 的监督学习技术构建人脸识别模型,以区分阿诺德·施瓦辛格与他人。这一领域在安防、身份验证系统以及社交媒体平台的人脸检测中应用广泛,意义重大。
为一家在线书店构建图书热度预测器,将混合数据(如文本:书名与描述;数值:评分与计数)转化为有效特征。您将经历完整的机器学习流程,包括快速 EDA、校正数据类型、转换文本与数值变量,并微调模型以获得尽可能高的准确率。
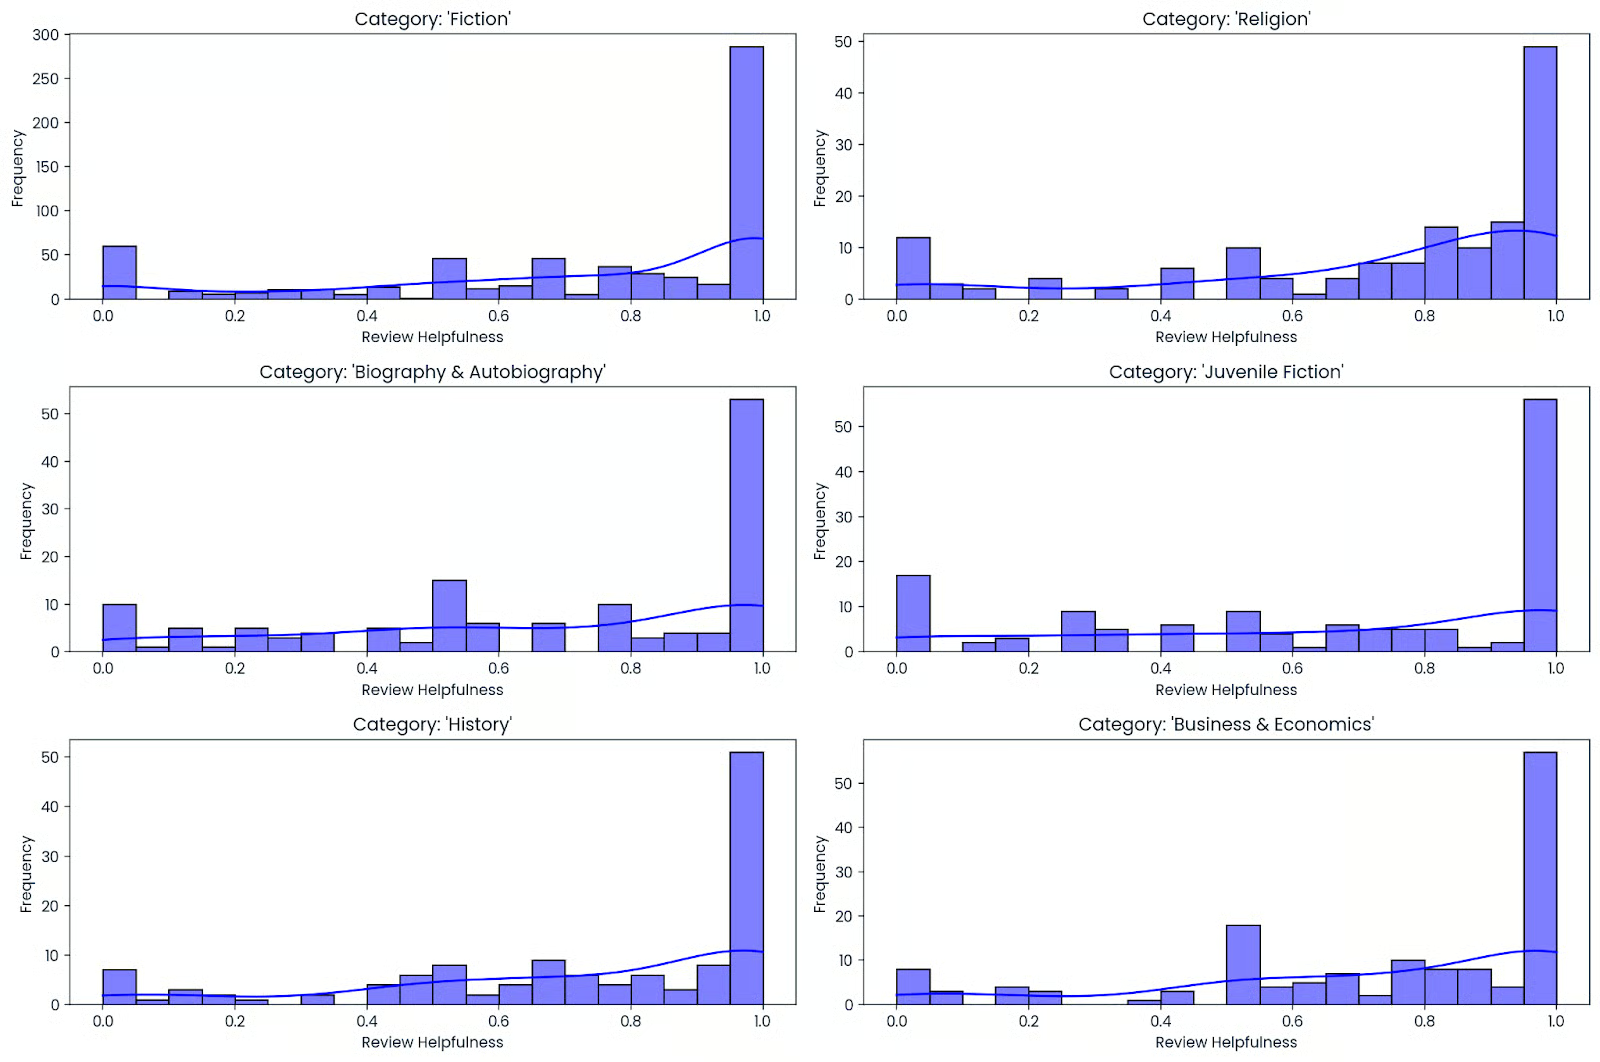
您将学会管理凌乱的多格式数据,并用干净、可复用的流水线评估结果。完成后,您就能将同样的方法应用于任何目录,无论是个人书单还是公共数据集,以预测潜在畅销书并增强推荐系统。
在Clustering Antarctic Penguin Species项目中,您将使用无监督学习在无标签情况下发现企鹅的自然分组。您会清洗类似 Palmer Penguins 的数据集,处理缺失值,对喙长、喙深、翼展、体重等数值特征进行缩放,并可选地对岛屿或性别等简单分类变量进行编码,然后应用 K-means 聚类。
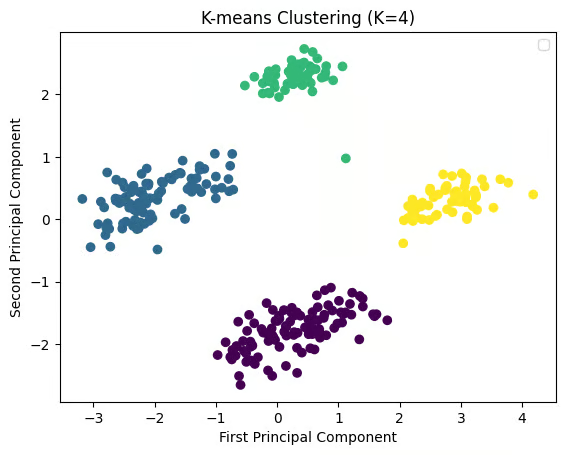
随后通过肘部法与轮廓系数选择簇数,用 PCA 可视化结构,并与已知物种对照进行快速校验。
在Taxi Route Optimization with Reinforcement Learning项目中,您将训练一个Q-learning智能体来解决 Gymnasium 的 Taxi-v3 环境,学习高效的接送路线。您会构建状态–动作价值表,使用 epsilon-greedy 策略平衡探索与利用,并调优学习率、折扣因子与 epsilon 衰减等核心超参数以加速收敛。
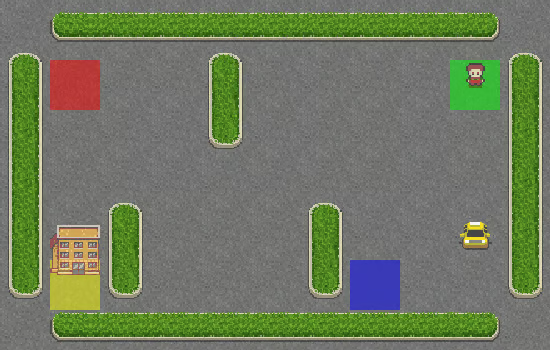
然后用每回合平均回报与完成步数评估表现,可视化学习曲线,并在未见过的回合上测试已训练策略。
使用威斯康星乳腺癌数据集来预测肿瘤是恶性还是良性。数据集包含肿瘤特征,如纹理、周长与面积,您的目标是基于这些特征构建分类模型来进行诊断预测。
该项目在医疗健康应用中非常关键,既能提供医学数据分析的宝贵洞见,也具备开发辅助早期癌症检测诊断工具的潜力。
在Speech Emotion Recognition with Librosa项目中,您将使用 Librosa、sound file 和 sklearn 的 MLPClassifier 对音频文件进行处理,从中识别情感。
您将加载与处理音频文件、进行特征提取,并训练多层感知机分类器模型。该项目将教授音频处理基础,便于您进一步训练深度学习模型以提升准确率。

图片来自 researchgate.net
这些高级项目聚焦于构建与训练深度学习模型以及处理非结构化数据。您将训练卷积神经网络、门控循环单元、微调大型语言模型,以及强化学习模型。
在Service Desk Ticket Classification with Deep Learning项目中,您将构建一个 PyTorch 文本分类器,自动将来件工单路由至正确类别。您会清洗与分词文本、创建训练与验证集划分、将工单转为向量表示,并在调整批大小、学习率与正则化的同时训练紧凑的神经模型以实现稳定收敛。
随后通过准确率与加权 F1 评估,检查混淆矩阵以发现标注错误或类别重叠,并应用加权损失等方法应对类别不平衡。
在Build Rick Sanchez Bot Using Transformers项目中,您将使用 DialoGPT 与Hugging Face Transformer 库来构建您的 AI 聊天机器人。
您将处理与转换数据,在《瑞克和莫蒂》台词数据集上构建并微调微软的大规模预训练响应生成模型(DialoGPT)。您还可以创建一个简单的 Gradio 应用进行实时测试:Rick & Morty Block Party。

Building an E-Commerce Clothing Classifier Model with Keras项目专注于电商场景下的图像分类。您将使用 Keras 构建一个基于图片的自动服饰分类模型。这能改进购物体验,帮助顾客更快找到商品,并简化库存管理。准确的分类也支持个性化推荐,从而提升用户参与度与销售额。
在Detect Traffic Signs with Deep Learning项目中,您将使用 Keras 开发能检测停车标志与交通信号灯等交通标志的深度学习模型。该技术对自动驾驶车辆至关重要,快速而准确地识别道路信号是安全行驶的关键。本项目为开发更先进、安全、可靠的自动驾驶系统打下基础。
在Building a Demand Forecasting Model项目中,您将使用 PySpark 进行大规模电商商品需求预测。您会加载交易数据,构造滞后与滚动均值等时间特征,按时间切分以进行公正评估,并训练基线模型与如梯度提升树或随机森林等学习模型,以捕捉趋势与季节性。
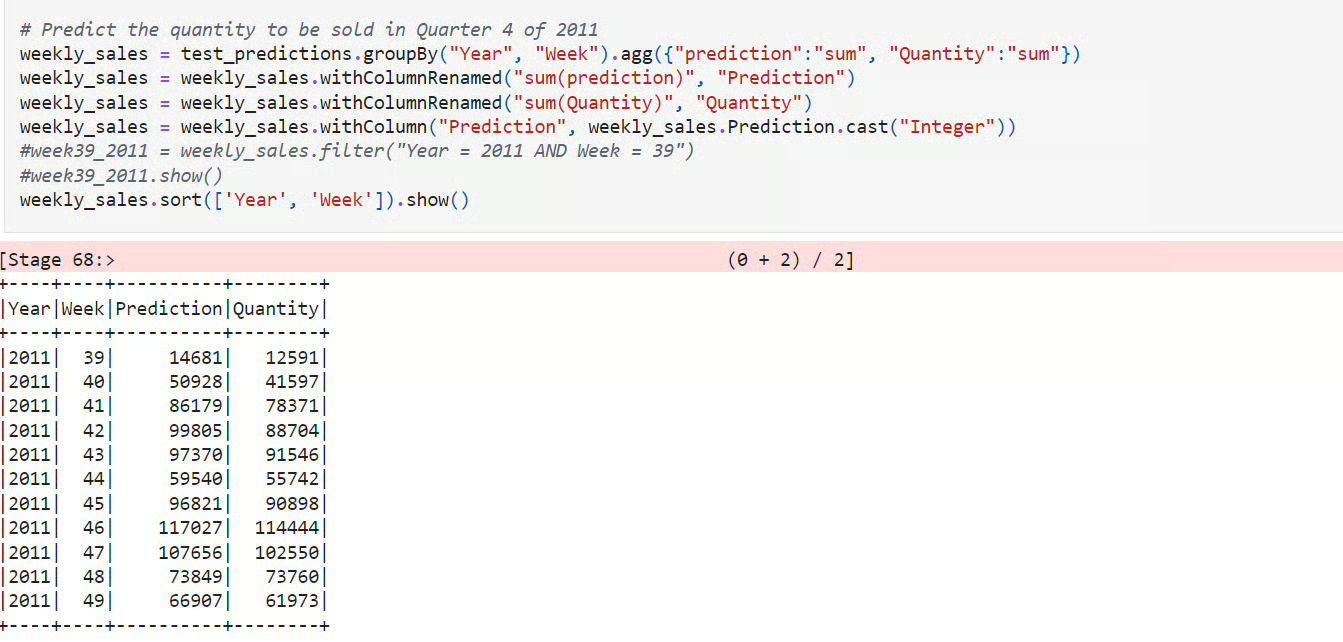
随后用 MAE、RMSE 与 MAPE 进行评估,与基线对比,并按 SKU 与时间窗口分析误差以发现偏差与波动。
在Predicting Temperature in London项目中,您将开展结构化的机器学习实验,用历史天气数据预测每日平均气温。您将加载与清洗数据集,创建时间感知的切分,工程化滚动均值与滞后值等特征,并使用 scikit-learn 训练多个候选模型。
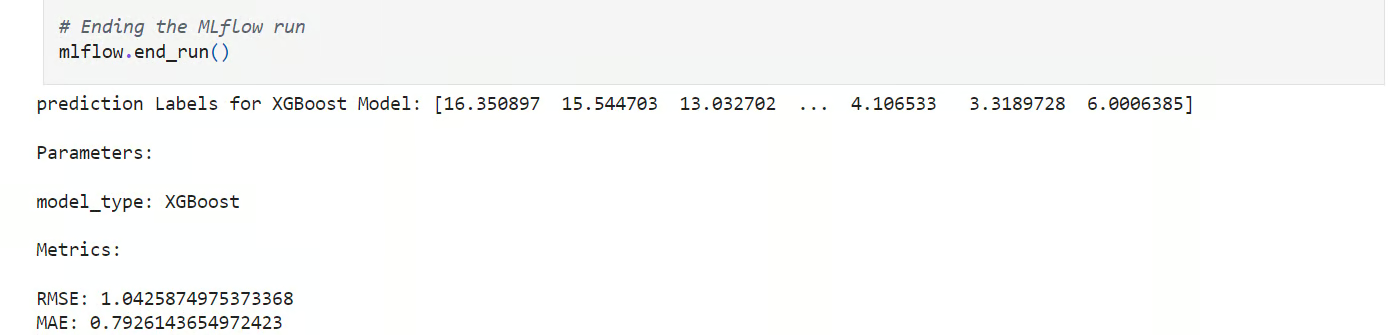
随后用可复用函数编排工作流,并在 MLflow 中跟踪参数、指标与制品,便于比较各次运行。
Connect X 是 Kaggle 的模拟竞赛。构建一个 RL(强化学习)智能体与其他参赛者对战。
您将先了解游戏机制,并创建一个可运行的简单智能体作为基线。之后开始尝试不同的 RL 算法与模型架构,例如基于深度 Q-learning 或 PPO(近端策略优化)构建模型。
毕业设计需要投入足够时间产出独特的解决方案。您将调研多种模型架构,使用各类机器学习框架来归一化与增强数据集,理解背后的数学原理,并基于结果撰写论文。
在Multi-Lingual ASR模型中,您将用土耳其语音频与转录微调 Wave2Vec XLS-R 模型,构建自动语音识别系统。
首先理解音频与文本数据集,然后使用文本分词器、提取特征并处理音频文件。之后创建训练器与 WER 函数,加载预训练模型,调参并训练与评估模型。
您可以使用 Hugging Face 平台存储模型权重,并发布实时转写的 Web 应用:Streaming Urdu Asr。

图片来自 huggingface.co
在One Shot Face Stylization项目中,您可以修改模型以改进效果,或在新数据集上微调 JoJoGAN,创建您的风格化应用。
它将使用原始图像通过 GAN 反演与微调预训练的 StyleGAN 来生成新图像。您将理解多种生成对抗网络架构。之后收集配对数据集来创建您所选的风格。
随后借助上一版 StyleGAN 的样例方案,尝试新架构以产出更逼真的艺术作品。

图片由 JoJoGAN 生成
在H&M Personalized Fashion Recommendations项目中,您将基于历史交易、客户数据与商品元数据进行商品推荐。
该项目将检验您的 NLP、CV(计算机视觉)与深度学习技能。前几周先理解数据,思考如何利用各类特征构建基线。
之后,先创建仅使用文本与类别特征的简单模型进行预测;再将 NLP 与 CV 结合,提高排行榜得分。您也可以通过查看社区讨论与代码深化对问题的理解。

图片来自 H&M EDA FIRST LOOK
在Analyzing Customer Support Calls项目中,您将构建端到端流水线,将原始音频转化为洞见。您会用自动语音识别模型转写通话、清洗并分段文本、进行情感分析,并抽取产品、套餐、地点、人名等实体。您还将通过嵌入为转写结果建立索引,以便在对话中进行快速语义搜索。
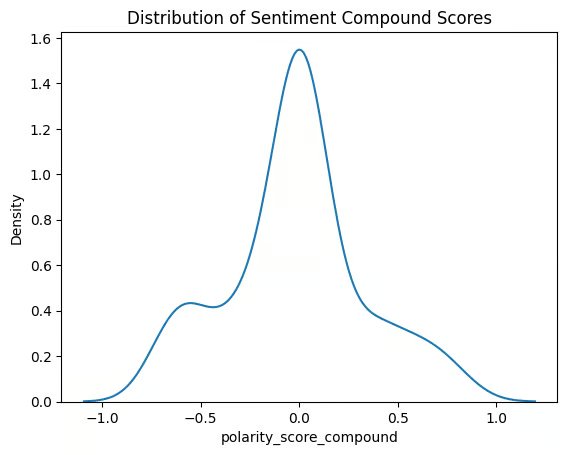
随后评估转写质量与模型表现,对主题进行聚类以揭示常见来电原因,并突出负向情绪峰值或升级相关关键词等要点。
在Monitoring A Financial Fraud Detection Model项目中,您将担任一家英国银行的上线后数据科学家,诊断线上欺诈模型为何出现下滑。您会加载生产环境的预测与结果,跟踪精确率、召回率、PR-AUC 与校准等核心指标,并可视化随时间的变化以发现退化。您还将按渠道、区域与客户分群切片,定位假阳性或假阴性集中的地方。
随后通过分布检验与稳定性指数测试数据与概念漂移,检查特征重要性变化,并使用可解释性工具比较当前与基线行为。
在MuZero for Atari 2600项目中,您将使用 MuZero 算法为 Atari 2600 游戏构建、训练与验证强化学习智能体。阅读这篇教程以进一步理解 MuZero 算法。
目标是新建或改造现有架构,以提升全球排行榜的得分。理解该算法在强化学习中的工作原理可能需要三个月以上。
该项目数学要求较高,并需要精通 Python。尽管可找到参考方案,但若要冲击全球顶尖排名,仍需自行构建解决方案。
MLOps End-To-End Machine Learning项目是进入顶尖公司的必要条件之一。如今,招聘方希望 ML 工程师能够使用 MLOps 工具、数据编排与云计算构建端到端系统。
在该项目中,您将使用 TensorFlow、Streamlit、Docker、Kubernetes、cloudbuild、GitHub 与 Google Cloud 构建并部署一个地点图像分类器。主要目标是用 CI/CD 自动化模型的构建与生产部署。可参考机器学习、流水线、部署与 MLOps教程。

图片来自 Senthil E
要打造出众的机器学习作品集,您需要与众不同的项目。向招聘经理或 HR 展示您能使用多种编程语言写代码、掌握多种机器学习框架、能用机器学习解决独特问题,并理解端到端的机器学习生态。
在Fine-Tuning GPT-OSS项目中,您将安装依赖、加载模型与分词器,使用 Harmony Python 包定义清晰的提示风格,并先运行一次端到端的基线推理以确认环境无误。
随后,您将用 Harmony 格式准备一个医学问答数据集,配置训练并微调模型,最后通过微调后的评估来衡量改进幅度。
在Fine-Tuning MedGemma on a Brain MRI Dataset项目中,您将适配 MedGemma 4B 多模态模型、SigLIP 图像编码器与一款医学调优的 LLM,用于脑部 MRI 扫描分类。您会在 RunPod 上搭建环境、安装所需 Python 包、加载并清洗 MRI 数据集,并通过一致的缩放、归一化与标签映射来准备输入,然后运行快速的健全性检查推理。
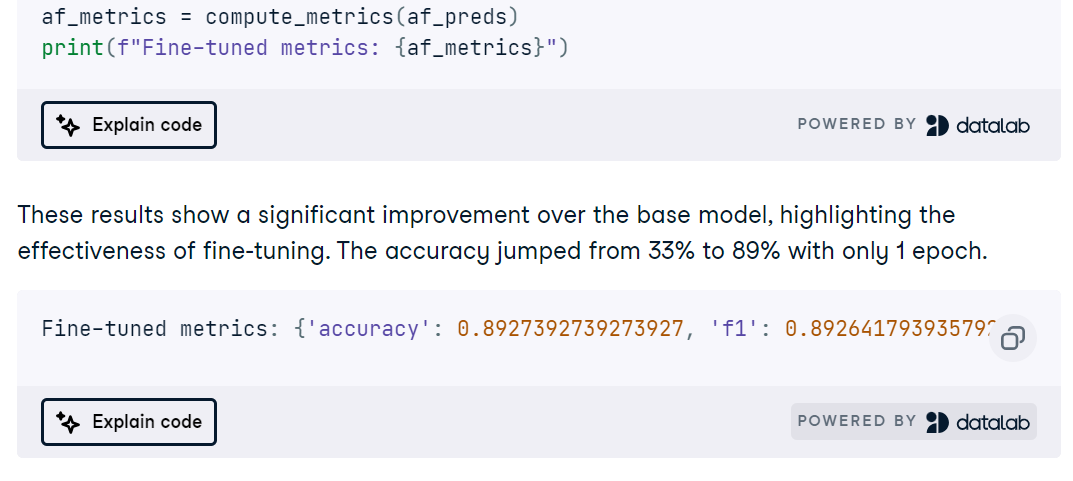
接着在 MRI 任务上微调 MedGemma,跟踪训练曲线,并用准确率、ROC AUC、精确率、召回率与混淆矩阵评估,以定位失效模式。
在Fine-tuning Stable Diffusion XL with DreamBooth and LoRA项目中,您将在 Python 中使用 Diffusers 配置 SDXL,在 CUDA GPU 上加载 FP16 基座模型与 VAE,并从简短提示生成图像。您将探索用 SDXL refiner 的快速画质增强,对比输出,并使用简易网格工具并排查看多组生成结果。
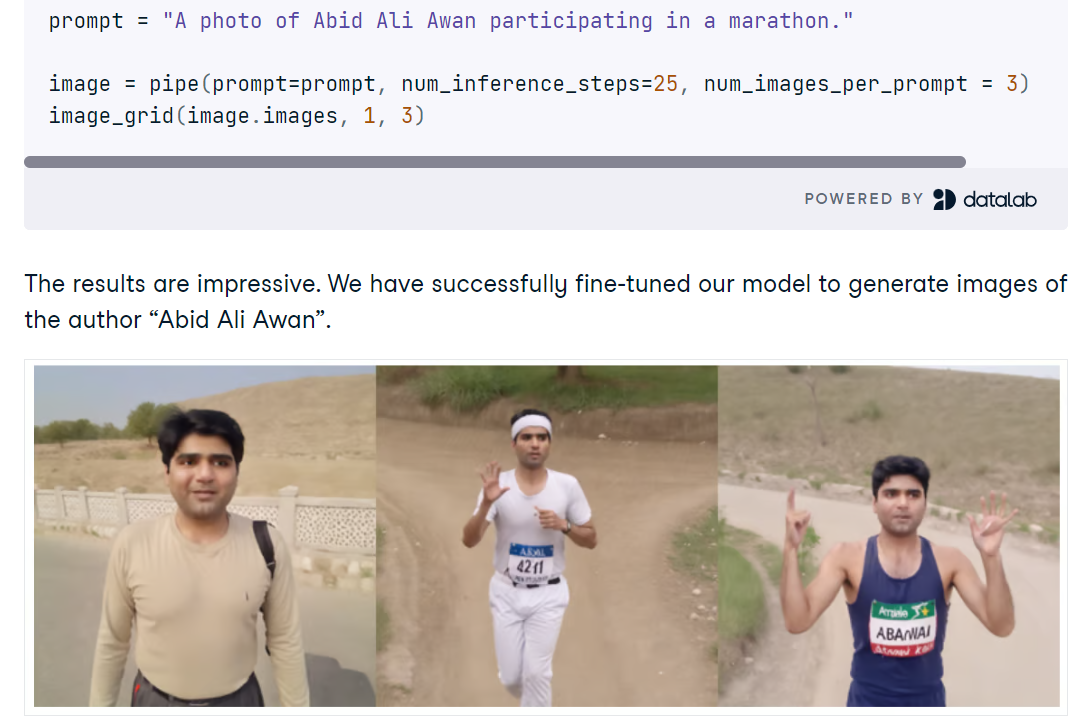
随后用 AutoTrain Advanced 结合 DreamBooth 在少量个人照片上微调 SDXL,产出紧凑的 LoRA 适配器而非完整检查点,以实现快速且节省内存的推理。训练完成后,将 LoRA 权重挂载到基础管线,测试新提示,并评估何时 refiner 有助于或损害身份保真度。
在Song Generation with Latent Diffusion项目中,您将配置一个开源的扩散式音乐模型,根据文本风格提示或参考音频片段生成完整歌曲。您会通过 Conda 或 Docker 安装,配置环境(Windows 上的 espeak-ng、phonemizer 路径),并运行提供的推理脚本,利用基础或完整检查点创建音轨,在显存紧张时启用分块解码。
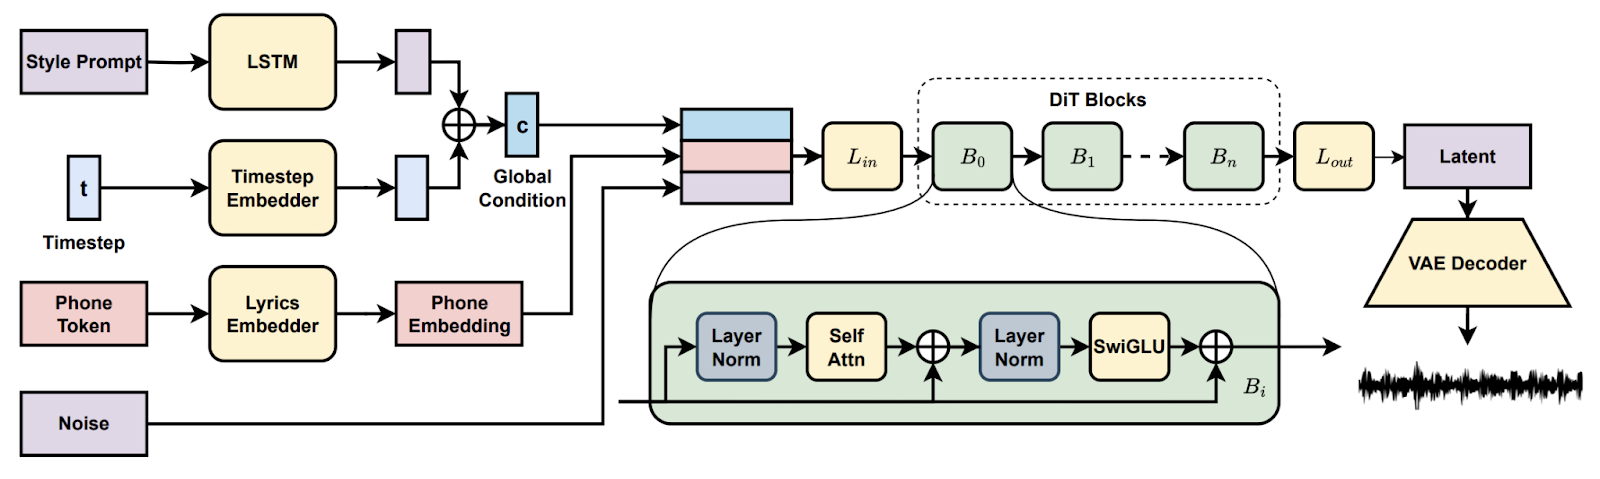
随后探索续写与编辑等功能,对比不同提示下的编配,并记录设置以便复现。最终,您将拥有一条实用的端到端音乐创作流水线。
在Deploying a Machine Learning Application to Production项目中,您将用 GitHub Actions 构建全自动的 ML 流水线,训练、评估、版本化并部署一个简单的药物分类模型。您会搭建仓库结构与 Makefile,添加环境配置、代码规范检查、单元测试与数据检查,然后编写可复现的训练与评估脚本,记录指标与制品。
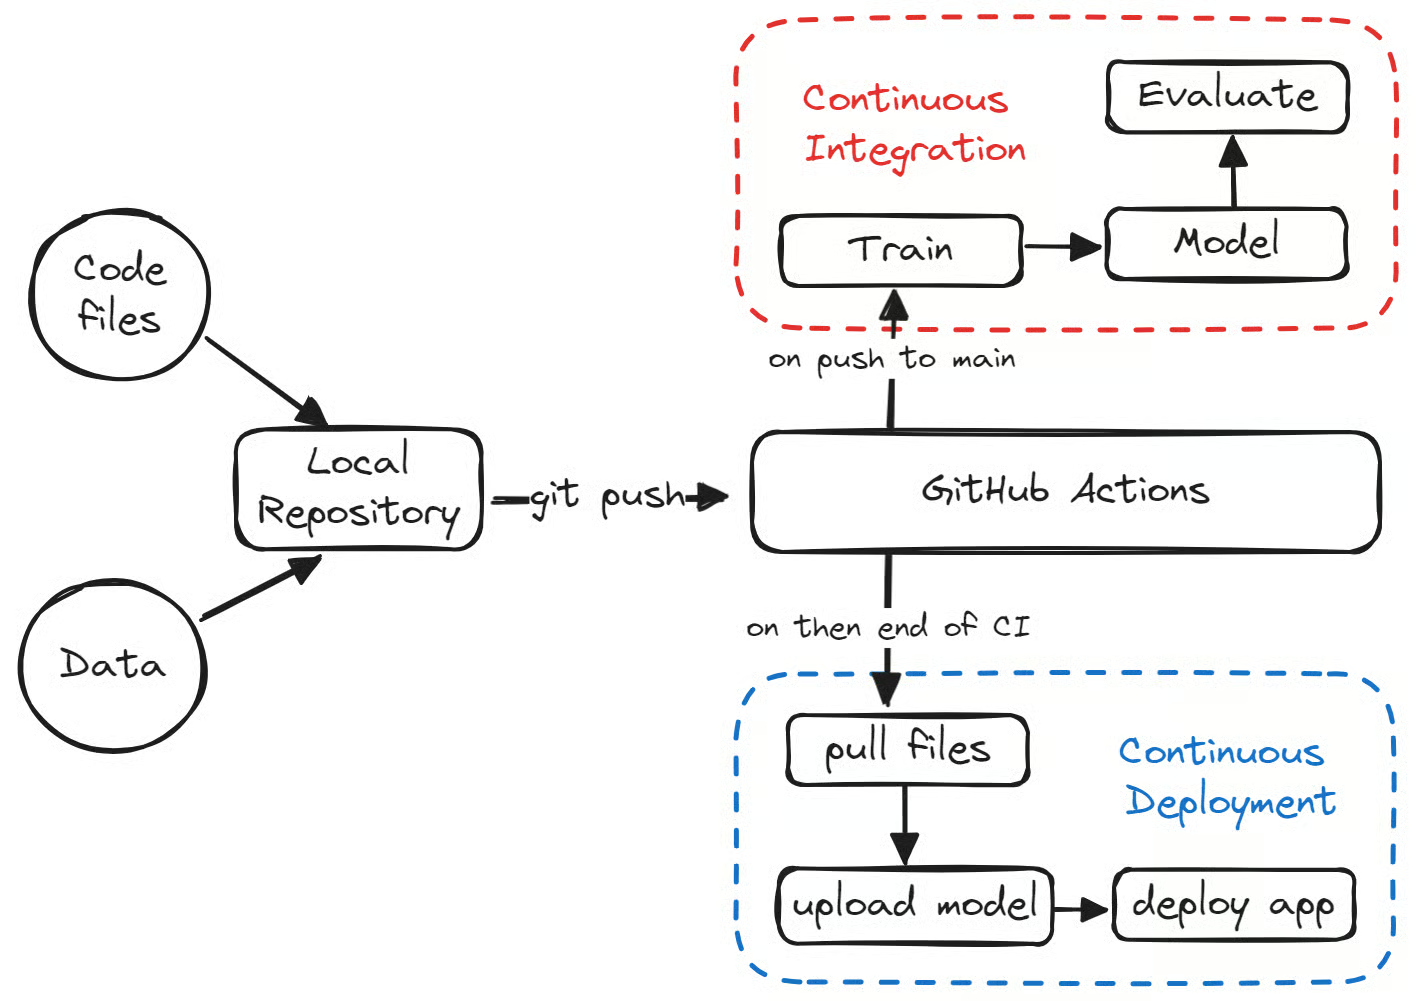
随后将持续集成配置为在 PR 与主分支推送时触发,使用 CML 与 Hugging Face CLI 发布模型制品,并通过持续部署工作流将通过验收的模型推广到部署。

图片作者自制
典型的机器学习项目没有固定标准步骤。有时可能仅是数据收集、数据准备与模型训练。在本节中,我们将了解构建可用于生产的机器学习项目所需的步骤。
您需要理解业务问题,并初步构想如何用机器学习来解决它。查阅论文、开源项目、教程,以及其他公司采用的类似应用。确保方案切实可行,且数据易于获取。
您将从多方收集数据、对其进行清洗与标注,并编写数据验证脚本。务必确保数据不含偏见或敏感信息。
填补缺失值,清洗与处理数据以便分析。使用可视化工具理解数据分布,并思考如何利用特征提升模型表现。特征缩放与数据增强用于将数据转化为适合机器学习模型的形式。
选择常用于具体问题的神经网络或机器学习算法。使用交叉验证训练模型,并采用多种超参数优化技术以获得最优结果。
在测试集上评估模型。确保为具体问题选择正确的评估指标。准确率并非适用于所有问题。分类可查看 F1 或 AUC,回归看 RMSE。可视化特征重要性以剔除不重要的特征。评估训练与推理时间等性能指标。
确保模型超越了人工基线。如未达标,回到高质量数据的收集并重新开始。这是一个迭代过程,您将不断尝试不同的特征工程技术、模型架构与机器学习框架来提升表现。
在取得 SOTA 结果后,就该使用 MLOps 工具将模型部署到生产/云端,并在实时数据上监控模型。大多数模型在生产中会失败,因此先面向一小部分用户部署是个好主意。
如果模型未能达标,您需要回到起点提出更优解。即便结果出色,模型也可能因数据漂移与概念漂移而随时间退化。用新数据再训练还能让模型适应实时变化。