Curso
Creación de agentes de IA con Google ADK
1 h
7.5K
Meta Superintelligence Labs lanzó Muse Glimmer el 10 de agosto de 2026, con una propuesta poco habitual para un lanzamiento de 2026: funciona en un portátil.
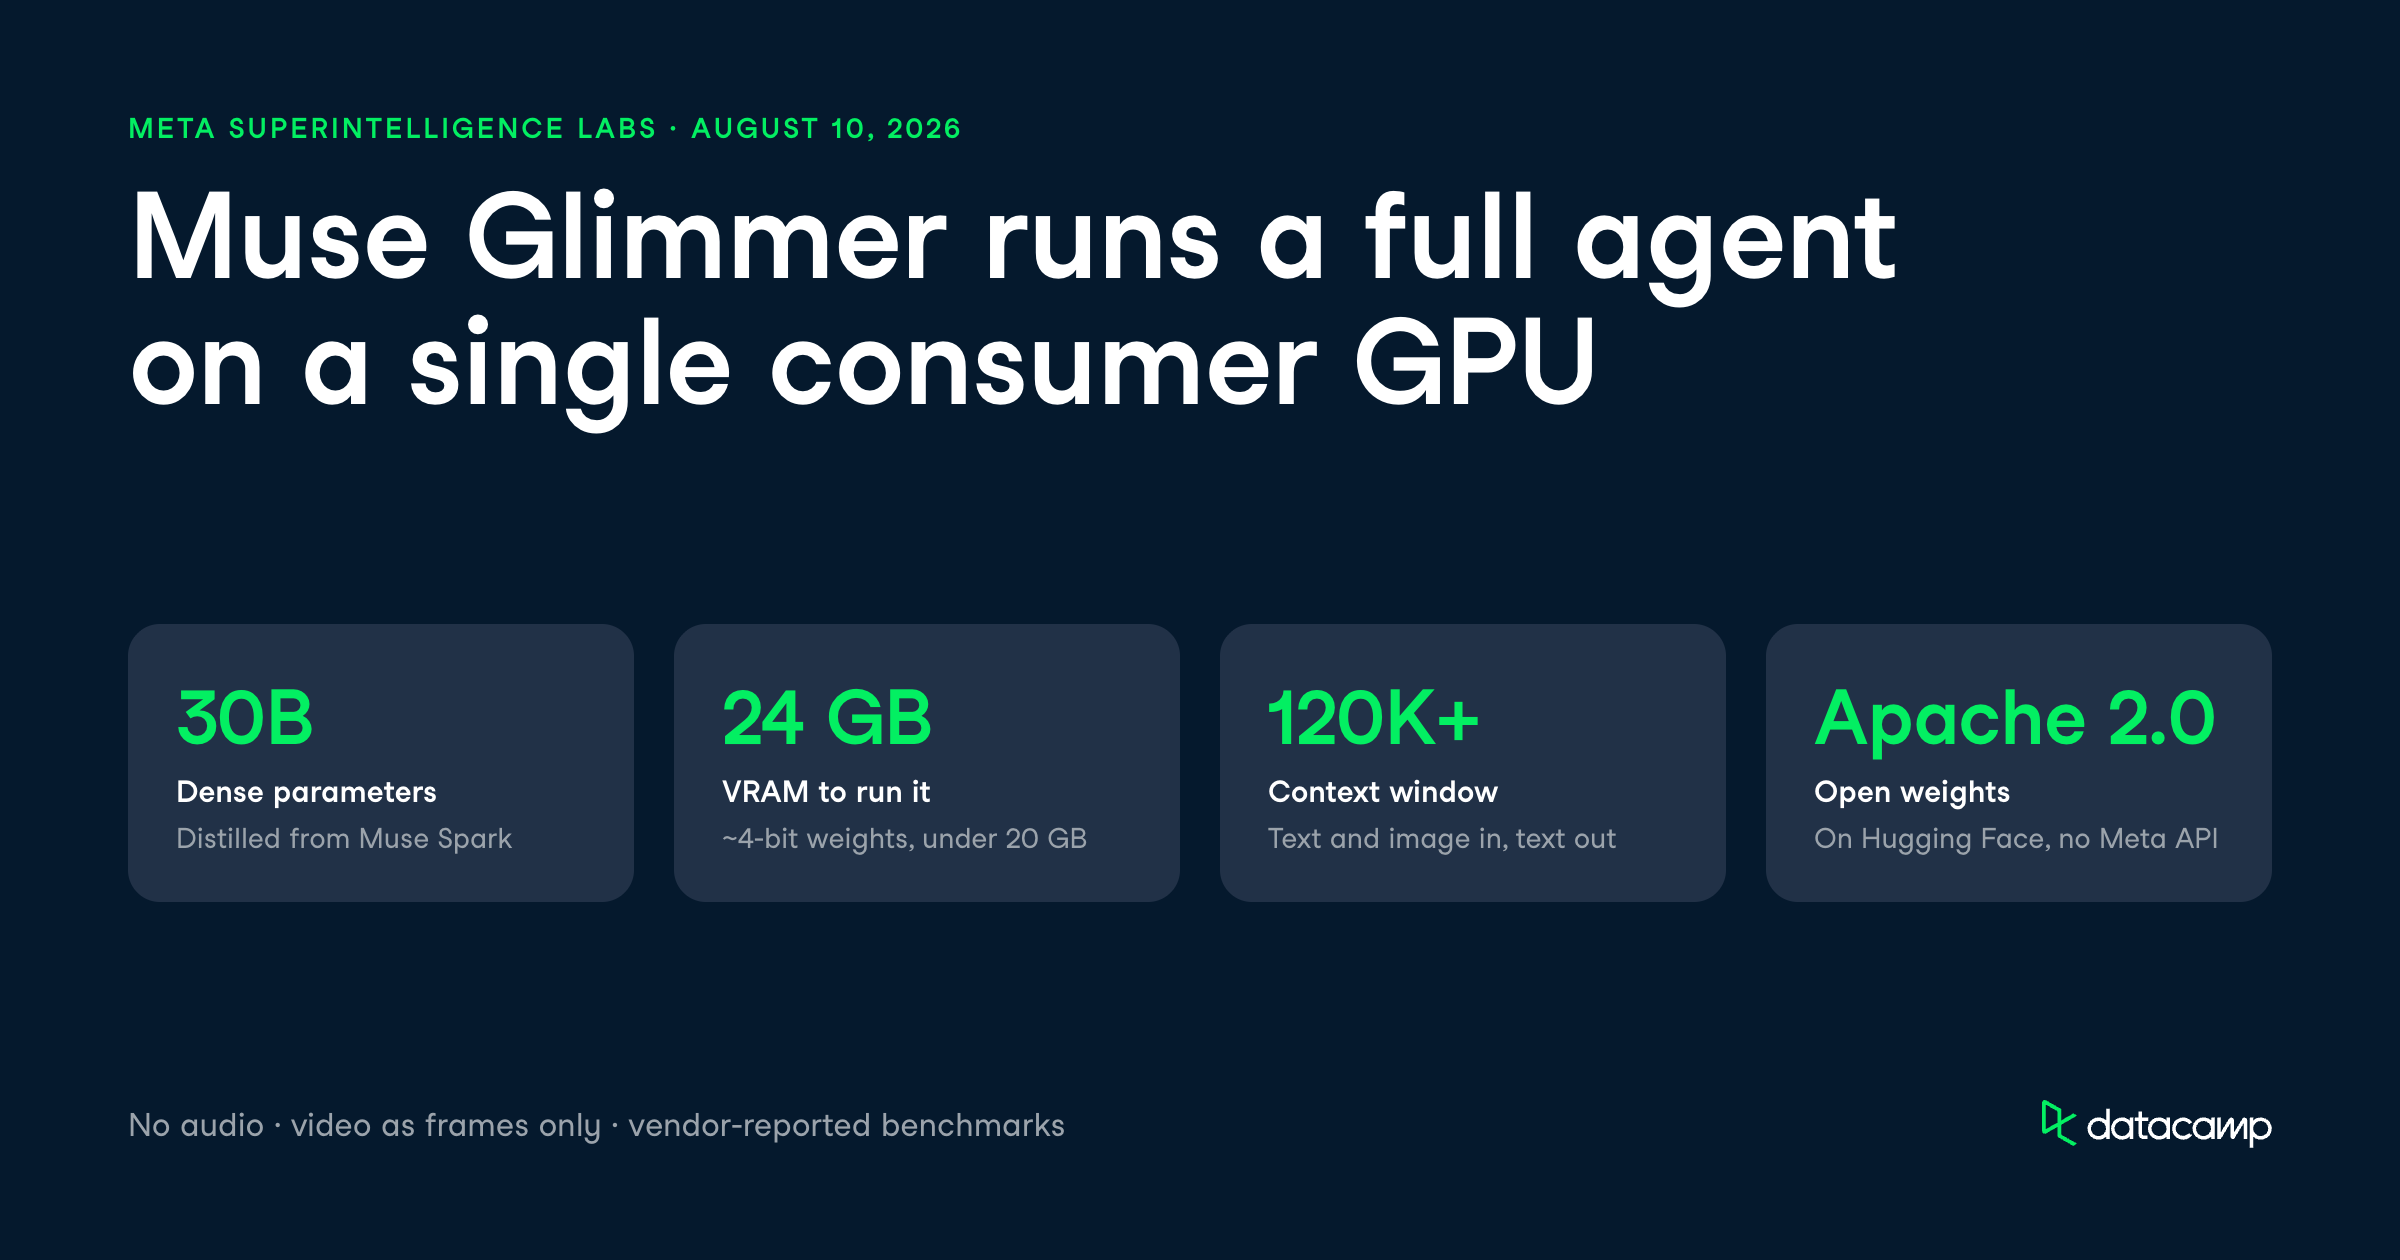
Es un modelo agentivo denso de 30.000 millones de parámetros pensado para flujos de trabajo locales, siempre activos, que se entrega con pesos abiertos bajo licencia Apache 2.0.
La gran promesa es que Muse Glimmer actúa como un agente completo (planificación, llamadas a herramientas, autocontrol y recuperación de errores) en una sola GPU de consumo de 24 GB o en sistemas Mac con memoria unificada. Incluye una ventana de contexto de más de 120K, entrada multimodal de texto e imagen y pesos cuantizados que reducen el modelo por debajo de 20 GB. Meta ha publicado los pesos en Hugging Face junto con documentación para desarrolladores.
En este artículo, repasamos todas las novedades de Muse Glimmer: sus funciones, los benchmarks frente a modelos como Qwen3.6-27B y Gemma4-31B, y los trucos de despliegue en local. También puedes leer nuestra guía para ejecutar Muse Glimmer en local para programación con IA.
Si quieres profundizar en la ejecución local de modelos en general, echa un vistazo a nuestros tutoriales sobre ajuste fino de Qwen3.6 y ponerte al día con nuestro itinerario de aprendizaje AI Agent Fundamentals.
Muse Glimmer es un modelo denso de 30.000 millones de parámetros de Meta Superintelligence Labs, optimizado para flujos de trabajo agentivos locales en lugar de chat alojado en la nube.
Se presenta como el hermano pequeño, destilado, de un modelo docente interno mayor, Muse Spark, y Meta deja claro que Muse Glimmer no cumple su definición de "Frontier AI".
La novedad aquí está en el objetivo de despliegue.
La mayoría de modelos agentivos con esta capacidad presuponen un centro de datos detrás, pero Muse Glimmer está diseñado para ejecutarse sin conexión en una sola GPU de consumo.
Meta ha comprimido los pesos a una precisión cercana a 4 bits, dejando el modelo por debajo de 20 GB para que quepa en 24 GB o 32 GB de memoria con margen.
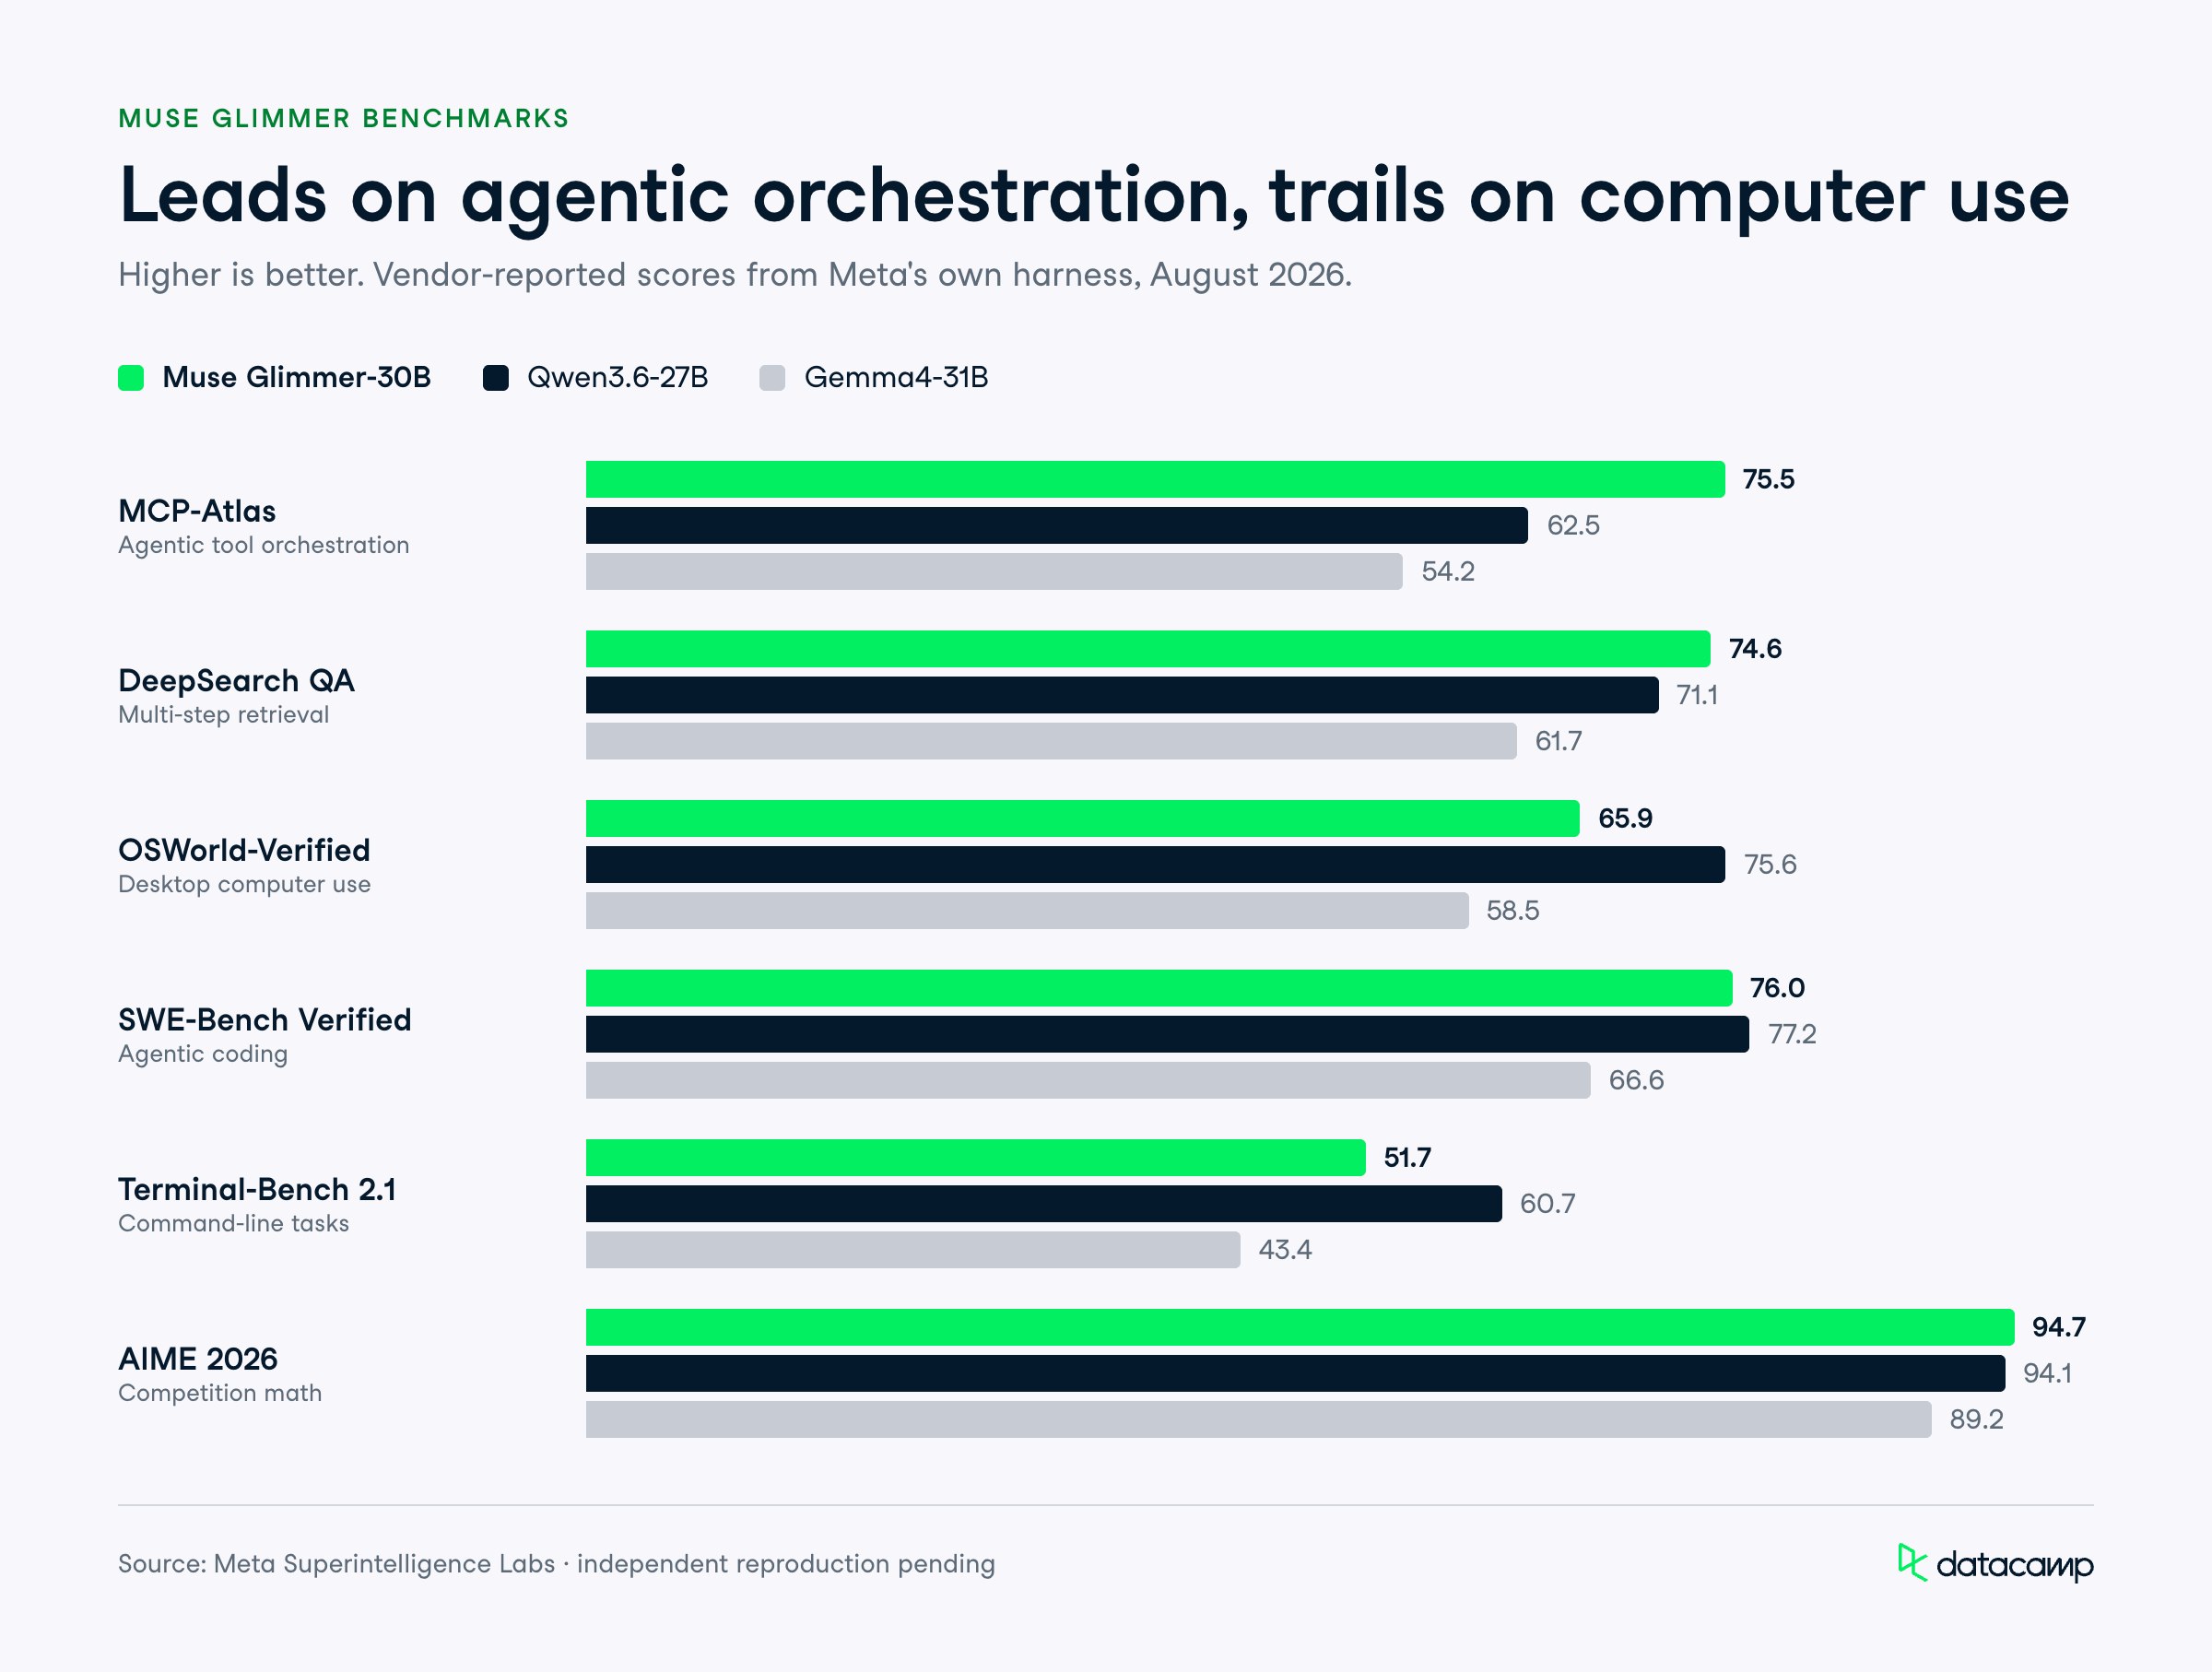
El titular de benchmarks es MCP-Atlas, un benchmark agentivo general, donde Muse Glimmer logra 75,5 frente a 62,5 de Qwen3.6-27B y 54,2 de Gemma4-31B.
Para un modelo que puedes ejecutar sin conexión a internet, liderar su categoría en orquestación agentiva es la clave del lanzamiento.
Muse Glimmer está pensado para ejecutar agentes personales en local, así que sus funciones se centran en completar tareas, usar herramientas y mantener la respuesta en hardware limitado.
Estas son las capacidades que más importan a quienes lo ponen en práctica.
Puedes asignarle a Muse Glimmer una tarea de varios pasos y dejar que planifique, llame a herramientas, verifique sus resultados y se recupere de fallos sin conexión a la red.
Alexandr Wang, Chief AI Officer de Meta, afirmó que el modelo funciona "como un agente plenamente capaz" y mantiene su fiabilidad agentiva con 24 GB de VRAM.
Para profesionales, esto cambia dónde puede vivir un agente.
Un modelo que redacta tus correos, reorganiza tus archivos o prioriza tu calendario necesita un acceso profundo a tu contexto personal, y mantener ese contexto en el dispositivo es una postura de privacidad muy distinta a enviarlo a una API en la nube.
Muse Glimmer invoca herramientas con esquemas precisos en flujos de trabajo largos y, cuando una llamada falla o devuelve algo inesperado, está entrenado para diagnosticar el error y reintentar en lugar de detenerse. Este comportamiento de recuperación es la diferencia entre un agente que termina una tarea y uno que se queda a medias.
Funciona con OpenClaw y otros patrones de orquestación agentiva, así que no te ata a un único andamiaje.
Meta incluye en la documentación pautas para configurar andamiajes personalizados, algo crucial porque la calidad del agente suele depender más del arnés que lo rodea que del modelo en bruto.
Gracias a un codificador de percepción dedicado, Muse Glimmer acepta texto e imágenes intercalados, de modo que un agente puede interpretar la captura de un cuadro de error, un gráfico de ventas o una factura escaneada junto con la conversación.
La entrada es texto e imagen; la salida, solo texto.
Hay una limitación importante: no admite audio de entrada ni salida, y el vídeo solo se gestiona como fotogramas individuales, no como comprensión real de vídeo.
Si tu flujo de trabajo necesita ver una grabación de pantalla de principio a fin, este no es el modelo adecuado.
Muse Glimmer permite distintos niveles de razonamiento, para que puedas intercambiar calidad por velocidad según la tarea.
Un agente que renombra archivos al vuelo no necesita la misma deliberación que una sesión de depuración compleja, y poder ajustar eso en el dispositivo mantiene una latencia razonable.
El modelo también se ha entrenado con datos de más de 100 idiomas, aunque Meta advierte que no se ha evaluado en todos y la calidad puede bajar fuera del conjunto con mayor soporte.
Meta evaluó Muse Glimmer frente a Gemma4-31B y Qwen3.6-27B en categorías de agentividad, programación, multimodalidad, seguridad y razonamiento, usando su propio arnés.
En el momento de escribir esto no había reproducciones independientes, así que tómalo como cifras del proveedor.
Muse Glimmer lidera su tamaño en benchmarks agentivos generales, pero queda por detrás de Qwen3.6-27B en varias tareas de uso del ordenador y terminal.
En la tabla siguiente puedes ver rápidamente cómo se compara Muse Glimmer con la competencia:
| Benchmark | Muse Glimmer-30B | Qwen3.6-27B | Gemma4-31B |
|---|---|---|---|
| MCP-Atlas | 75,5 | 62,5 | 54,2 |
| DeepSearch QA | 74,6 | 71,1 | 61,7 |
| OSWorld-Verified | 65,9 | 75,6 | 58,5 |
| SWE-Bench Verified | 76,0 | 77,2 | 66,6 |
| Terminal-Bench 2.1 | 51,7 | 60,7 | 43,4 |
| AIME 2026 | 94,7 | 94,1 | 89,2 |
| GPQA Diamond | 83,5 | 84,2 | 85,7 |
| MMMU Pro | 74 | 75 | 73 |
MCP-Atlas mide cómo orquesta un modelo las llamadas a herramientas mediante Model Context Protocol, y Muse Glimmer marca 75,5 frente a 62,5 de Qwen3.6-27B y 54,2 de Gemma4-31B.
En DeepSearch QA, un benchmark de recuperación de información en varios pasos, Muse Glimmer logra 74,6, por delante de los 71,1 de Qwen3.6-27B y muy por encima de los 61,7 de Gemma4-31B.
El panorama no es uniforme. En OSWorld-Verified, que prueba agentes de uso del ordenador en un escritorio real, Muse Glimmer consigue 65,9 mientras Qwen3.6-27B lidera con 75,6, así que Qwen es la opción más fuerte para agentes que conducen la pantalla.
SWE-Bench Verified mide si un modelo puede resolver incidencias reales de GitHub escribiendo y depurando código.
Muse Glimmer obtiene 76,0, cerca de los 77,2 de Qwen3.6-27B y por delante de los 66,6 de Gemma4-31B.
En Terminal-Bench 2.1, que evalúa la finalización de tareas en línea de comandos, Muse Glimmer queda en 51,7 frente a 60,7 de Qwen3.6-27B. Como referencia, cuando ajustamos Qwen3.6 en nuestro propio tutorial, vimos que su fortaleza en SWE-Bench y Terminal-Bench se mantenía en la práctica, así que su ventaja aquí cuadra con lo que hemos observado.
AIME 2026 es un benchmark de matemáticas de competición, y Muse Glimmer puntúa 94,7, superando por poco los 94,1 de Qwen3.6-27B y por encima de los 89,2 de Gemma4-31B.
Es un resultado potente para un modelo de este tamaño.
En GPQA Diamond, un conjunto de preguntas científicas a nivel de posgrado, Muse Glimmer logra 83,5 mientras Gemma4-31B lidera con 85,7 y Qwen3.6-27B se sitúa en 84,2.
En Humanity's Last Exam (texto, sin herramientas), Muse Glimmer obtiene 22,0, ligeramente por detrás de ambos rivales.
MMMU Pro evalúa el razonamiento multimodal entre imágenes y texto con dificultad de posgrado, y los tres modelos quedan casi idénticos: Muse Glimmer 74, Qwen3.6-27B 75, Gemma4-31B 73.
En Charxiv Reasoning, que mide la interpretación de gráficos, Muse Glimmer logra 78,8, ligeramente por delante de ambos rivales.
La propia afirmación de fortaleza de Meta en ScreenSpot Pro no se cumple del todo: Muse Glimmer marca 75,4 mientras Qwen3.6-27B lidera con 76,1.
La categoría multimodal está tan ajustada que no será el factor decisivo entre estos modelos.
En CI Memories, que mide la tasa de violaciones de privacidad (cuanto menor, mejor), Muse Glimmer registra un 26,4 frente al mucho más limpio 12,1 de Gemma4-31B y el 53,4 de Qwen3.6-27B.
Así que aquí Muse Glimmer queda entre sus rivales: más seguro que Qwen, pero lejos de Gemma en esta métrica.
En Siren AgentDojo, que mide la resistencia a ataques de inyección de prompts, Muse Glimmer muestra una tasa de éxito del ataque del 28,4 con una utilidad de 94,2, frente a 25,6 de Gemma4-31B y 40,3 de Qwen3.6-27B. Si vas a desplegar un agente que toca contenido no confiable, conviene ponderar esa resistencia.
Muse Glimmer se distribuye como pesos abiertos bajo Apache 2.0, y no hay una API propia alojada por Meta.
Esto significa que no hay precios por token de Meta que reportar: tu coste es la infraestructura y el autoalojamiento, no una tarifa por uso de API.
Puedes ponerte en marcha por varias vías:
Meta está colaborando con AMD, Arm, Dell, Intel y NVIDIA para optimizar el rendimiento en distintos dispositivos.
El objetivo práctico de hardware son máquinas de 24 GB o 32 GB: Meta informa de que la build K-Quant-17GB junto con el "drafter" cuantizado DFlash acelera la decodificación 3,1x en una RTX 5090, 1,8x en un M5 Max y 1,5x en un M4 Max.
Muse Glimmer es la apuesta deliberada de Meta por agentes locales, privados y de pesos abiertos, en lugar de otro buque insignia en la nube.
Al limitarlo a 30B y enviar pesos cuantizados que caben en una sola GPU de consumo, Meta apunta a un nicho que muchos laboratorios ignoran: desarrolladores que quieren un agente offline cuyo contexto personal nunca salga del dispositivo.
Mi lectura honesta es que esto es una pila para constructores, no un reemplazo en la nube de un clic.
La historia de benchmarks es mixta (Qwen3.6-27B sigue liderando en OSWorld-Verified y Terminal-Bench 2.1, y Gemma4-31B es más limpio en CI Memories), y algunos análisis califican a Muse Glimmer de lento y frágil cerca del límite de memoria. Pero liderar su categoría en MCP-Atlas y DeepSearch QA, con una permisiva Apache 2.0, lo convierte en una opción seria para cualquiera que construya agentes locales.
Las salvedades: no hay audio, el vídeo solo como fotogramas, cobertura de idiomas desigual y benchmarks del proveedor hasta que lleguen reproducciones independientes.
Si tu flujo de trabajo es sensible a la privacidad o realmente necesita funcionar sin red, merece la pena descargar Muse Glimmer y probarlo frente a Qwen3.6 en tu propio hardware.
Si quieres desarrollar las habilidades para ejecutar y afinar modelos como este por tu cuenta, te recomiendo nuestro tutorial sobre cómo crear tu primer agente de IA autónomo.
Los mejores cursos de DataCamp
Curso
Curso
programa
blog
Ryan Ong
8 min
blog
Abid Ali Awan
9 min
blog
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
9 min
Tutorial
Moez Ali
11 min





