
Last chance! 50% off DataCamp Premium
Sale ends in
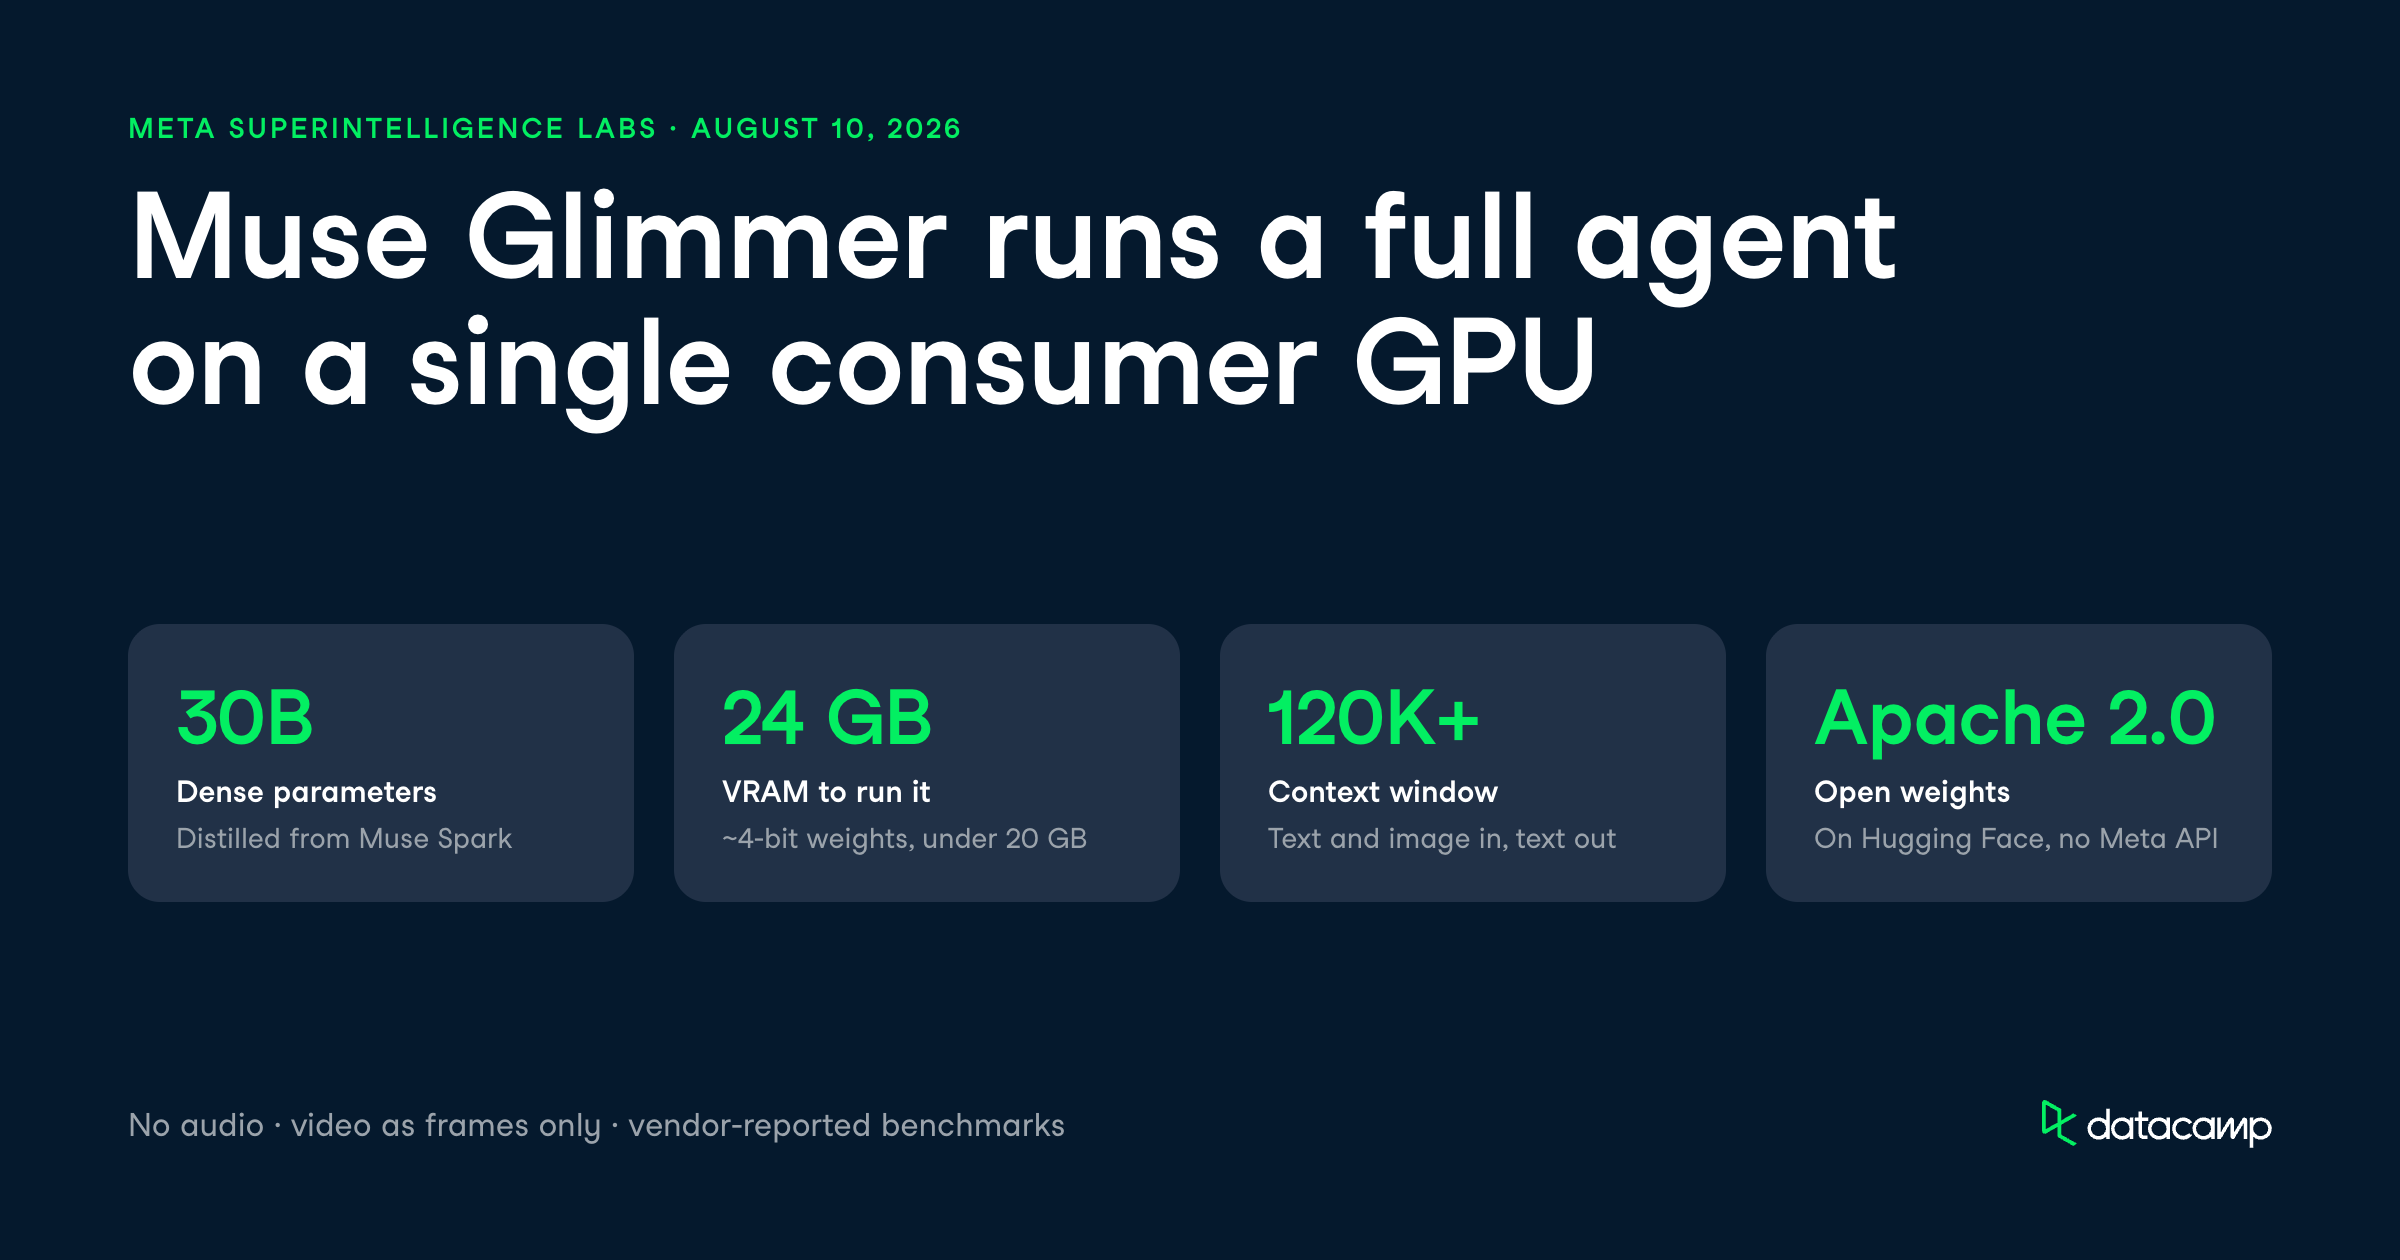
Meta Superintelligence Labs ने 10 अगस्त, 2026 को Muse Glimmer जारी किया, और 2026 के किसी मॉडल लॉन्च के लिए यह एक अलग तरह की पेशकश है: यह लैपटॉप पर चलता है।
यह 30-बिलियन-पैरामीटर वाला एजेंटिक मॉडल है जो लोकल, हमेशा-ऑन वर्कफ़्लोज़ के लिए बनाया गया है, और Apache 2.0 लाइसेंस के तहत ओपन वेट्स के साथ आता है।
मुख्य दावा यह है कि Muse Glimmer एक अकेले 24 GB कंज़्यूमर GPU या Mac-क्लास यूनिफ़ाइड मेमोरी सिस्टम पर पूर्ण एजेंट की तरह काम करता है (प्लानिंग, टूल कॉल्स, स्व-परख, और फेल्योर रिकवरी)। यह 120K+ कॉन्टेक्स्ट विंडो, मल्टीमॉडल टेक्स्ट-और-इमेज इनपुट, और क्वांटाइज़्ड वेट्स के साथ आता है जो मॉडल को 20 GB से नीचे समेट देते हैं। Meta ने वेट्स को डेवलपर डॉक्यूमेंटेशन के साथ Hugging Face पर ओपन-सोर्स किया है।
इस लेख में, मैं Muse Glimmer की नई चीज़ें कवर करूँगा—फ़ीचर्स, Qwen3.6-27B और Gemma4-31B जैसे मॉडलों के मुकाबले बेंचमार्क्स, और लोकल डिप्लॉयमेंट की तरकीबें। हमारा अलग गाइड: AI कोडिंग के लिए Muse Glimmer को लोकली कैसे चलाएँ भी पढ़ सकते हैं।
सामान्य तौर पर मॉडल्स को लोकली चलाने के बारे में और जानने के लिए, हमारे Qwen3.6 के फाइन-ट्यूनिंग पर ट्यूटोरियल देखें और हमारी AI Agent Fundamentals स्किल ट्रैक से गति पकड़ें।
Muse Glimmer, Meta Superintelligence Labs का 30-बिलियन-पैरामीटर डेंस मॉडल है, जिसे क्लाउड-होस्टेड चैट के बजाय लोकल एजेंट वर्कफ़्लोज़ के लिए ऑप्टिमाइज़ किया गया है।
इसे एक बड़े इंटरनल टीचर मॉडल Muse Spark के छोटे, डिस्टिल्ड सिब्लिंग के रूप में पेश किया गया है, और Meta स्पष्ट रूप से कहता है कि Muse Glimmer उसकी "Frontier AI" परिभाषा पर खरा नहीं उतरता।
यहाँ नई बात डिप्लॉयमेंट टार्गेट है।
इतना सक्षम ज़्यादातर एजेंटिक मॉडल अपने पीछे डाटासेंटर मानकर चलते हैं, लेकिन Muse Glimmer को एक अकेले कंज़्यूमर GPU पर ऑफ़लाइन चलाने के लिए बनाया गया है।
Meta ने वेट्स को लगभग 4-बिट प्रिसिजन तक कंप्रेस किया, जिससे भाषा मॉडल 20 GB से कम में आ गया—ताकि 24 GB या 32 GB मेमोरी एनवेलप में आराम से फिट हो सके।
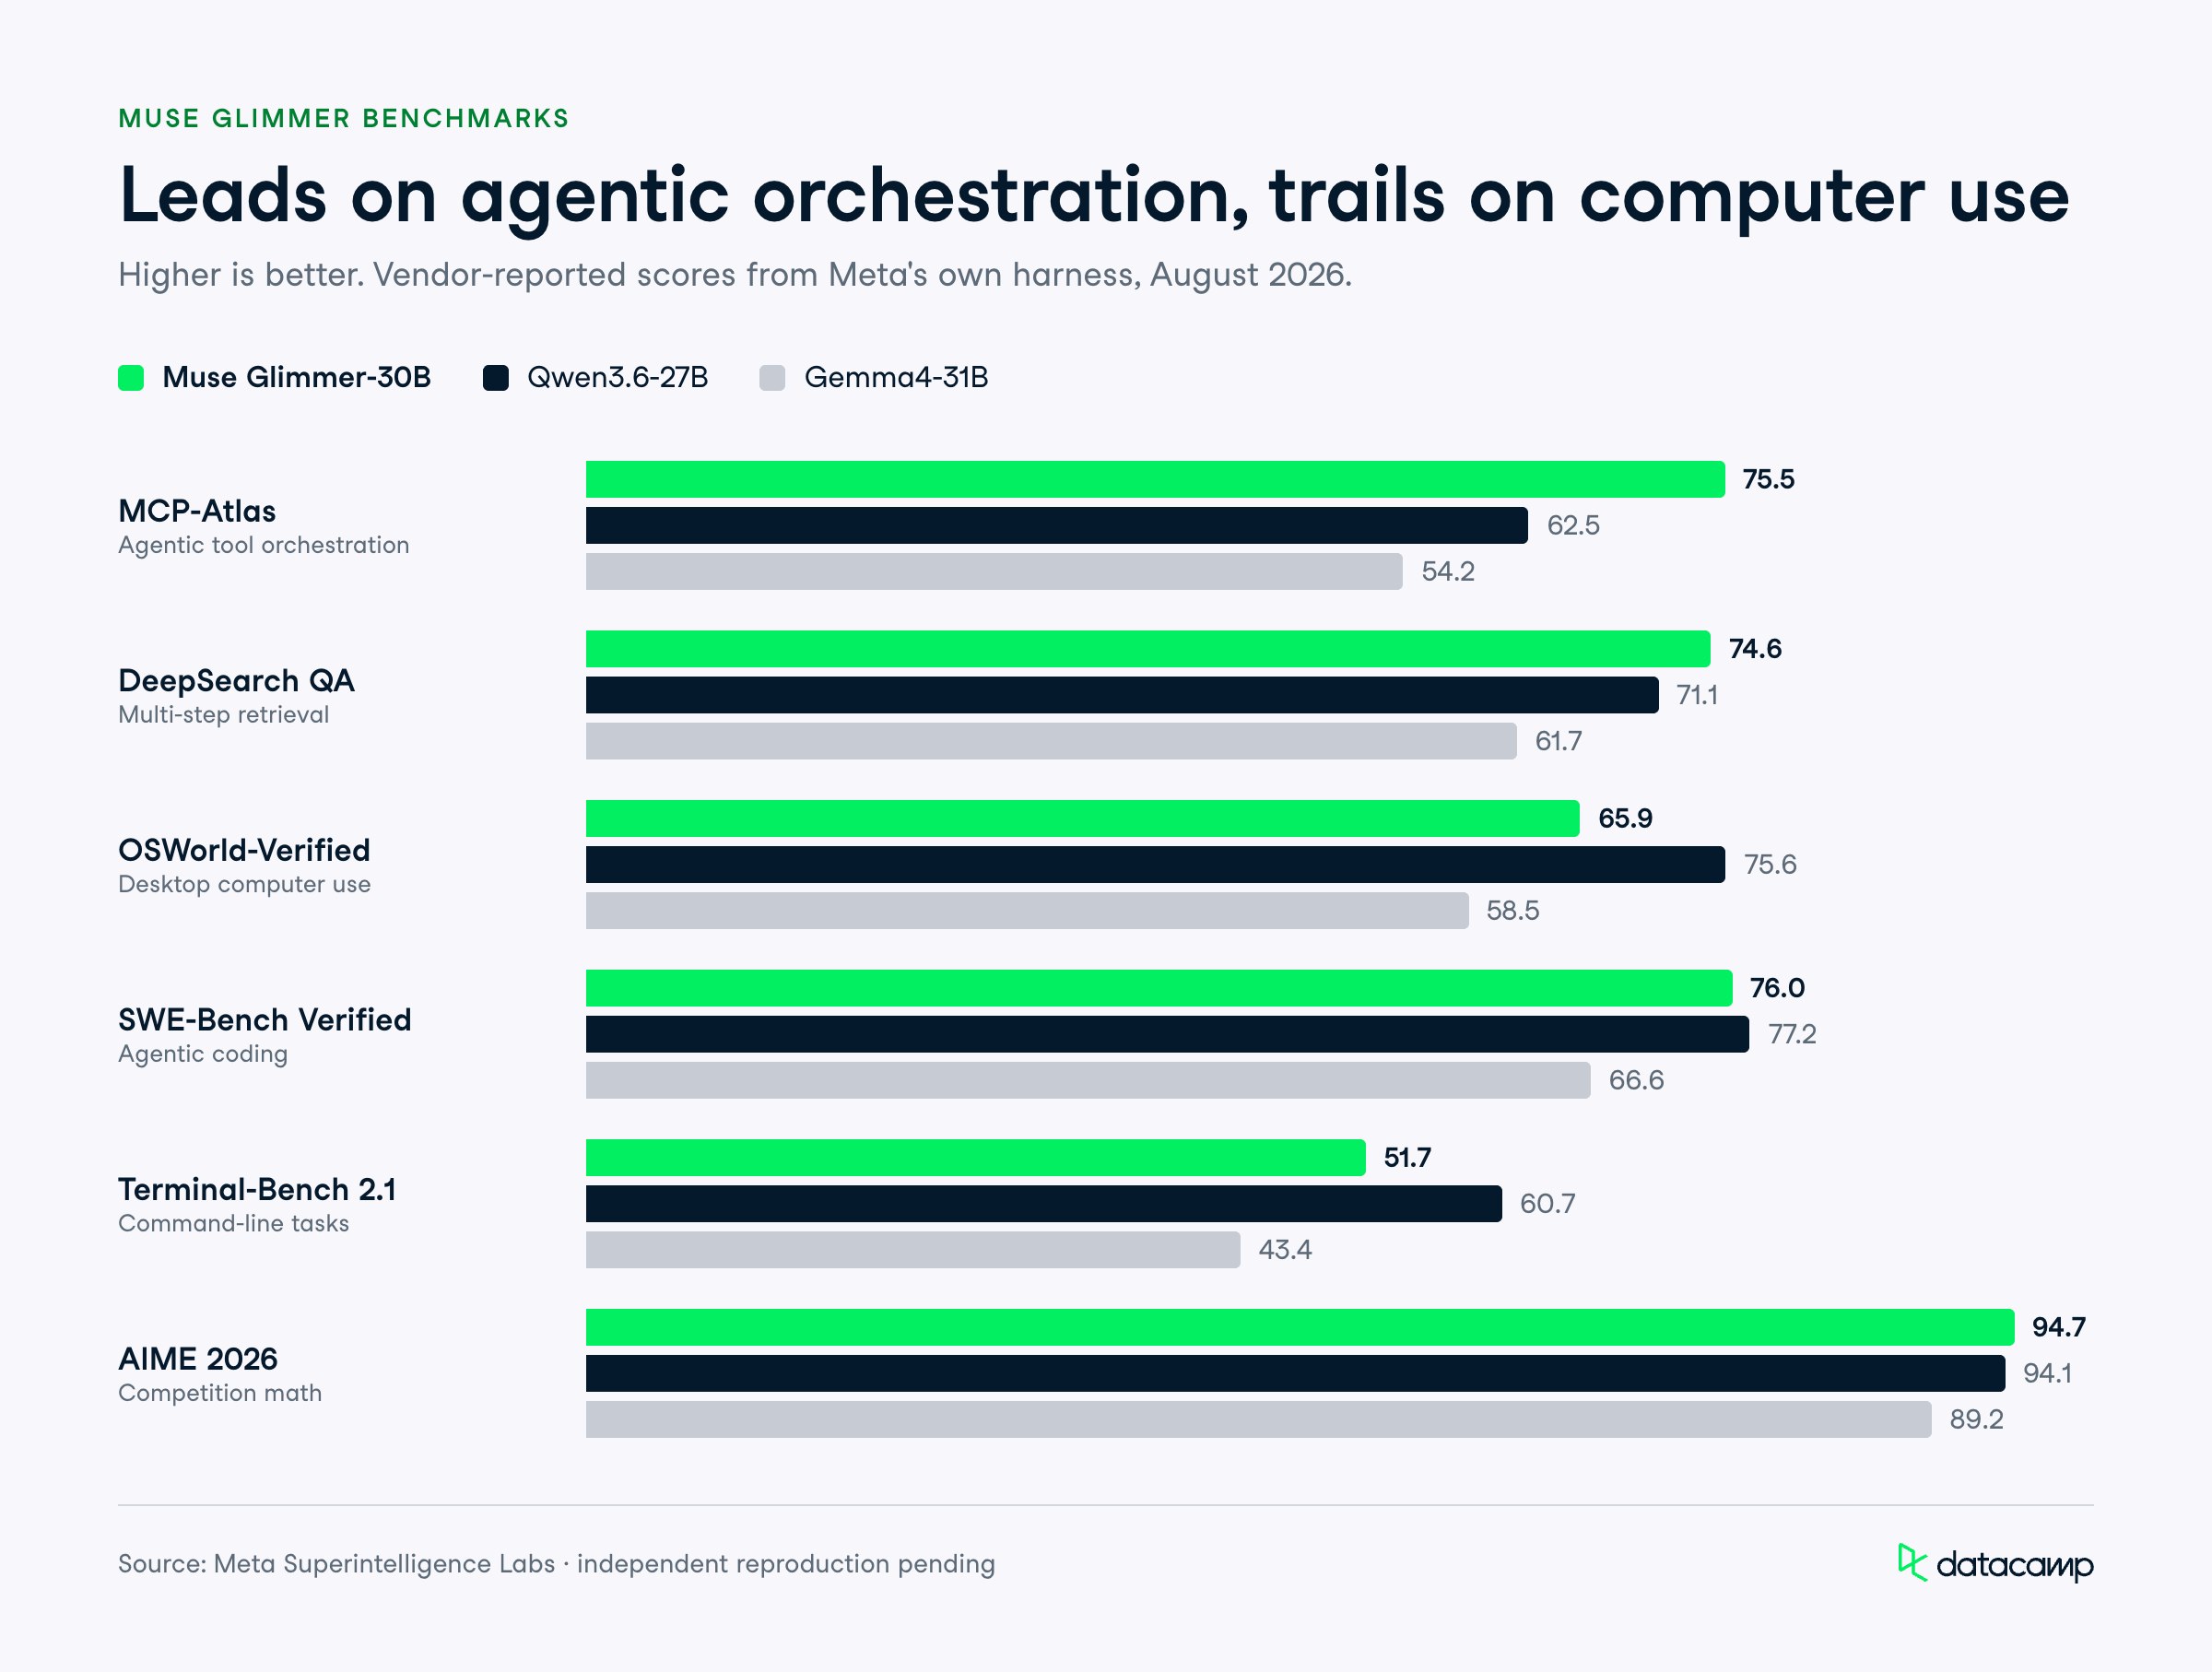
जो बेंचमार्क सबसे उभरकर आता है वह MCP-Atlas है—एक जनरल एजेंटिक बेंचमार्क—जहाँ Muse Glimmer 75.5 स्कोर करता है, Qwen3.6-27B के 62.5 और Gemma4-31B के 54.2 के मुकाबले।
बिना इंटरनेट कनेक्शन के चल सकने वाले मॉडल के लिए, अपनी साइज क्लास में एजेंटिक ऑर्केस्ट्रेशन में आगे होना ही इस रिलीज़ का मकसद है।
Muse Glimmer को पर्सनल एजेंट्स को लोकली चलाने के इर्द-गिर्द बनाया गया है, इसलिए इसकी विशेषताएँ कार्य-समापन, टूल उपयोग, और सीमित हार्डवेयर पर उत्तरदायी बने रहने पर केंद्रित हैं।
व्यवहार में सबसे अधिक मायने रखने वाली क्षमताएँ ये हैं:
आप Muse Glimmer को किसी मल्टी-स्टेप टास्क पर लगाकर बिना नेटवर्क कनेक्शन के योजना बनवाना, टूल कॉल करना, अपने परिणामों की जाँच करना, और विफलताओं से उबरना—सब करवा सकते हैं।
Meta के Chief AI officer Alexandr Wang ने कहा कि मॉडल "पूरी तरह सक्षम एजेंट" की तरह काम करता है और 24 GB VRAM पर भी अपनी एजेंटिक विश्वसनीयता बनाए रखता है।
व्यवहारकर्ताओं के लिए, यह बदलता है कि एजेंट कहाँ रह सकता है।
जो मॉडल आपके ईमेल ड्राफ्ट करता है, आपकी फ़ाइलें फिर से व्यवस्थित करता है, या आपका कैलेंडर ट्रायेज करता है—उसे व्यक्तिगत संदर्भ तक गहरी पहुँच चाहिए होती है, और उस संदर्भ को डिवाइस पर ही रखना, उसे किसी क्लाउड API पर भेजने से अलग प्राइवेसी रुख है।
Muse Glimmer विस्तारित वर्कफ़्लोज़ में सटीक स्कीमाज़ के साथ टूल्स को इनवोक करता है, और जब कोई कॉल विफल होती है या अप्रत्याशित परिणाम लौटाती है, तो यह त्रुटि का निदान करने और रुकने के बजाय पुनः प्रयास करने के लिए प्रशिक्षित है। यह फेल्योर-रिकवरी व्यवहार ही उस एजेंट में फर्क लाता है जो काम पूरा करता है बनाम जो बीच में अटक जाता है।
यह OpenClaw और अन्य एजेंटिक ऑर्केस्ट्रेशन पैटर्न्स में काम करता है, इसलिए आप किसी एक स्कैफ़ोल्ड में बंद नहीं हैं।
Meta डॉक्यूमेंटेशन में कस्टम स्कैफ़ोल्ड सेटअप पर मार्गदर्शन देता है—यह इसलिए अहम है क्योंकि एजेंट की गुणवत्ता अक्सर कच्चे मॉडल से ज़्यादा उसके आस-पास के हार्नेस पर निर्भर करती है।
एक समर्पित परसेप्शन एन्कोडर के ज़रिए, Muse Glimmer इंटरलीव्ड टेक्स्ट और इमेज स्वीकार करता है, ताकि एजेंट बातचीत के साथ किसी एरर डायलॉग का स्क्रीनशॉट, सेल्स चार्ट, या स्कैन किए हुए इनवॉइस की व्याख्या कर सके।
यह टेक्स्ट-और-इमेज इन, टेक्स्ट आउट है।
यहाँ एक वास्तविक सीमा है: कोई ऑडियो इनपुट या आउटपुट नहीं है, और वीडियो को वास्तविक वीडियो समझ की बजाय केवल व्यक्तिगत फ़्रेम्स की तरह हैंडल किया जाता है।
यदि आपके वर्कफ़्लो को स्क्रीन रिकॉर्डिंग को शुरू से अंत तक देखना ज़रूरी है, तो यह मॉडल उसके लिए नहीं है।
Muse Glimmer अलग-अलग रीज़निंग स्ट्रेंथ्स सपोर्ट करता है, ताकि आप काम के अनुसार क्वालिटी और स्पीड के बीच संतुलन कर सकें।
तेज़ फ़ाइल-रीनेम एजेंट को उतनी ही सोच-विचार नहीं चाहिए जितनी किसी मल्टी-स्टेप डिबगिंग सत्र को, और इसे ऑन-डिवाइस डायल करना लेटेंसी को उचित रखता है।
मॉडल को 100 से अधिक भाषाओं के डाटा पर प्रशिक्षित किया गया है, हालाँकि Meta सावधान करता है कि इन सभी पर इसका मूल्यांकन नहीं हुआ है, और मज़बूती से समर्थित सेट के बाहर गुणवत्ता गिर सकती है।
Meta ने अपने हार्नेस का उपयोग करते हुए Muse Glimmer का Gemma4-31B और Qwen3.6-27B के मुकाबले एजेंटिक, कोडिंग, मल्टीमॉडल, सेफ़्टी, और रीज़निंग श्रेणियों में मूल्यांकन किया।
लेखन के समय तक स्वतंत्र पुनरुत्पादन उपलब्ध नहीं था, इसलिए इन्हें वेंडर नंबर मानें।
Muse Glimmer जनरल एजेंटिक बेंचमार्क्स पर अपनी साइज क्लास में आगे है, लेकिन कई कंप्यूटर-यूज़ और टर्मिनल कार्यों पर Qwen3.6-27B से पीछे है।
नीचे दी गई तालिका में, आप जल्दी से देख सकते हैं कि Muse Glimmer प्रतिस्पर्धियों के मुकाबले कैसा है:
| बेंचमार्क | Muse Glimmer-30B | Qwen3.6-27B | Gemma4-31B |
|---|---|---|---|
| MCP-Atlas | 75.5 | 62.5 | 54.2 |
| DeepSearch QA | 74.6 | 71.1 | 61.7 |
| OSWorld-Verified | 65.9 | 75.6 | 58.5 |
| SWE-Bench Verified | 76.0 | 77.2 | 66.6 |
| Terminal-Bench 2.1 | 51.7 | 60.7 | 43.4 |
| AIME 2026 | 94.7 | 94.1 | 89.2 |
| GPQA Diamond | 83.5 | 84.2 | 85.7 |
| MMMU Pro | 74 | 75 | 73 |
MCP-Atlas मापता है कि कोई मॉडल Model Context Protocol के ज़रिए टूल कॉल्स को कितना अच्छी तरह ऑर्केस्ट्रेट करता है, और Muse Glimmer यहाँ 75.5 स्कोर करता है—Qwen3.6-27B के 62.5 और Gemma4-31B के 54.2 के मुकाबले।
DeepSearch QA पर—जो मल्टी-स्टेप सूचना-खोज का बेंचमार्क है—Muse Glimmer 74.6 स्कोर करता है, Qwen3.6-27B के 71.1 से थोड़ा आगे और Gemma4-31B के 61.7 से काफ़ी आगे।
तस्वीर एकसमान नहीं है। OSWorld-Verified पर—जो एक वास्तविक डेस्कटॉप वातावरण में कंप्यूटर-यूज़ एजेंट्स का परीक्षण करता है—Muse Glimmer 65.9 स्कोर करता है, जबकि Qwen3.6-27B 75.6 के साथ आगे है; यानी स्क्रीन-ड्राइविंग एजेंट्स के लिए Qwen मज़बूत विकल्प है।
SWE-Bench Verified मापता है कि कोई मॉडल कोड लिखकर और डिबग करके वास्तविक GitHub इश्यूज़ को सुलझा सकता है या नहीं।
Muse Glimmer 76.0 स्कोर करता है—Qwen3.6-27B के 77.2 के क़रीब और Gemma4-31B के 66.6 से आगे।
Terminal-Bench 2.1 पर—जो कमांड-लाइन टास्क समापन का परीक्षण करता है—Muse Glimmer 51.7 पर पीछे रह जाता है, जबकि Qwen3.6-27B 60.7 है। संदर्भ के लिए, जब हमने अपने ट्यूटोरियल में Qwen3.6 को फाइन-ट्यून किया, तो SWE-bench और Terminal-Bench पर उसकी बढ़त व्यवहार में भी कायम रही—तो टर्मिनल टास्क्स पर Qwen की बढ़त यहाँ हमारे अनुभव से मेल खाती है।
AIME 2026 एक प्रतियोगी-गणित बेंचमार्क है, और Muse Glimmer 94.7 स्कोर करता है—Qwen3.6-27B के 94.1 से थोड़ा आगे और Gemma4-31B के 89.2 से बेहतर।
इस आकार के मॉडल के लिए यह मज़बूत परिणाम है।
GPQA Diamond—ग्रेजुएट-स्तरीय विज्ञान प्रश्नों का सेट—पर Muse Glimmer 83.5 स्कोर करता है, जबकि Gemma4-31B 85.7 के साथ आगे है, और Qwen3.6-27B 84.2 पर है।
Humanity's Last Exam (टेक्स्ट, बिना टूल्स) पर Muse Glimmer 22.0 स्कोर करता है, दोनों प्रतिद्वंद्वियों से थोड़ा पीछे।
MMMU Pro, इमेज और टेक्स्ट के बीच ग्रेजुएट-कठिनाई पर मल्टीमॉडल रीज़निंग का परीक्षण करता है, और तीनों मॉडल लगभग समान हैं: Muse Glimmer 74, Qwen3.6-27B 75, Gemma4-31B 73।
Charxiv Reasoning—जो चार्ट इंटरप्रिटेशन का परीक्षण करता है—पर Muse Glimmer 78.8 स्कोर करता है, दोनों प्रतिद्वंद्वियों से थोड़ा आगे।
ScreenSpot Pro पर Meta का अपना स्ट्रेंथ दावा पूरी तरह नहीं ठहरता: Muse Glimmer 75.4 स्कोर करता है, जबकि Qwen3.6-27B 76.1 के साथ आगे है।
मल्टीमॉडल श्रेणी इतनी करीबी है कि यह इन मॉडलों के बीच निर्णायक कारक नहीं बनेगी।
CI Memories—जो प्राइवेसी-उल्लंघन दर (कम बेहतर) मापता है—पर Muse Glimmer 26.4 उल्लंघन दर दर्ज करता है, Gemma4-31B के काफ़ी साफ़ 12.1 और Qwen3.6-27B के 53.4 के मुकाबले।
तो यहाँ Muse Glimmer अपने प्रतिद्वंद्वियों के बीच बैठता है—Qwen से सुरक्षित, पर इस मीट्रिक पर Gemma से काफी पीछे।
Siren AgentDojo—जो प्रॉम्प्ट-इंजेक्शन हमलों के प्रतिरोध को मापता है—पर Muse Glimmer 94.2 यूटिलिटी के साथ 28.4 अटैक सक्सेस रेट दिखाता है, जबकि Gemma4-31B 25.6 और Qwen3.6-27B 40.3 पर हैं। यदि आप ऐसा एजेंट डिप्लॉय कर रहे हैं जो अविश्वसनीय कंटेंट को छूता है, तो यह इंजेक्शन-प्रतिरोध तौलने लायक है।
Muse Glimmer Apache 2.0 के तहत ओपन वेट्स के रूप में वितरित होता है, और कोई Meta-होस्टेड फ़र्स्ट-पार्टी API नहीं है।
मतलब Meta की ओर से कोई प्रति-टोकन कीमतें नहीं हैं: आपकी लागत इन्फ्रास्ट्रक्चर और सेल्फ-होस्टिंग है, न कि मीटर्ड API फ़ीस।
आप कई तरीकों से इसे चलाना शुरू कर सकते हैं:
Meta, AMD, Arm, Dell, Intel, और NVIDIA के साथ मिलकर अलग-अलग डिवाइसेज़ पर प्रदर्शन ट्यून करने पर काम कर रहा है।
व्यावहारिक हार्डवेयर टार्गेट 24 GB या 32 GB मशीन है: Meta बताता है कि K-Quant-17GB बिल्ड और क्वांटाइज़्ड DFlash ड्राफ्टर RTX 5090 पर डिकोडिंग को 3.1x, M5 Max पर 1.8x, और M4 Max पर 1.5x तक तेज़ कर देता है।
Muse Glimmer, Meta का लोकल, प्राइवेट, ओपन-वेट एजेंट्स पर सोचा-समझा दाँव है—किसी और क्लाउड फ़्लैगशिप के बजाय।
इसे 30B पर सीमित रखकर और क्वांटाइज़्ड वेट्स भेजकर जो एक अकेले कंज़्यूमर GPU पर फिट हो जाएँ, Meta उस विशेष ज़रूरत को निशाना बना रहा है जिसे ज़्यादातर लैब नज़रअंदाज़ करती हैं: ऐसे डेवलपर्स जो ऑफ़लाइन, पर्सनल कॉन्टेक्स्ट के साथ—जो डिवाइस से बाहर न जाए—एजेंट चलाना चाहते हैं।
मेरी साफ़ राय: यह बिल्डर्स का स्टैक है, वन-क्लिक क्लाउड रिप्लेसमेंट नहीं।
बेंचमार्क कहानी मिश्रित है (OSWorld-Verified और Terminal-Bench 2.1 पर Qwen3.6-27B अब भी आगे है, और CI Memories पर Gemma4-31B अधिक स्वच्छ है), और समीक्षकों ने Muse Glimmer को मेमोरी सीमा के पास धीमा और नाज़ुक कहा है। लेकिन MCP-Atlas और DeepSearch QA पर अपनी साइज क्लास में आगे रहना, और उदार Apache 2.0 लाइसेंस के साथ—उसे किसी भी लोकल एजेंट बनाने वाले के लिए गंभीर विकल्प बनाता है।
चेतावनियाँ: ऑडियो नहीं, वीडियो केवल फ़्रेम्स के रूप में; भाषा कवरेज असमान; और जब तक स्वतंत्र पुनरुत्पादन न आएँ, वेंडर-आधारित बेंचमार्क ही।
यदि आपका वर्कफ़्लो प्राइवेसी-संवेदनशील है या सच में बिना नेटवर्क के चलना चाहिए, तो Muse Glimmer डाउनलोड कर के अपने हार्डवेयर पर Qwen3.6 के साथ इसकी तुलना ज़रूर करें।
यदि आप ऐसे मॉडलों को स्वयं चलाने और ट्यून करने के कौशल बनाना चाहते हैं, तो हमारा ट्यूटोरियल अपना पहला स्वायत्त AI एजेंट बनाना देखें।
शीर्ष DataCamp पाठ्यक्रम
कोर्स
कोर्स
लर्निंग पाथ
