
Cursus
AI-agents bouwen met Google ADK
1 uur
7.6K
Meta Superintelligence Labs bracht Muse Glimmer uit op 10 augustus 2026, met een opvallende pitch voor een modelrelease in 2026: het draait op een laptop.
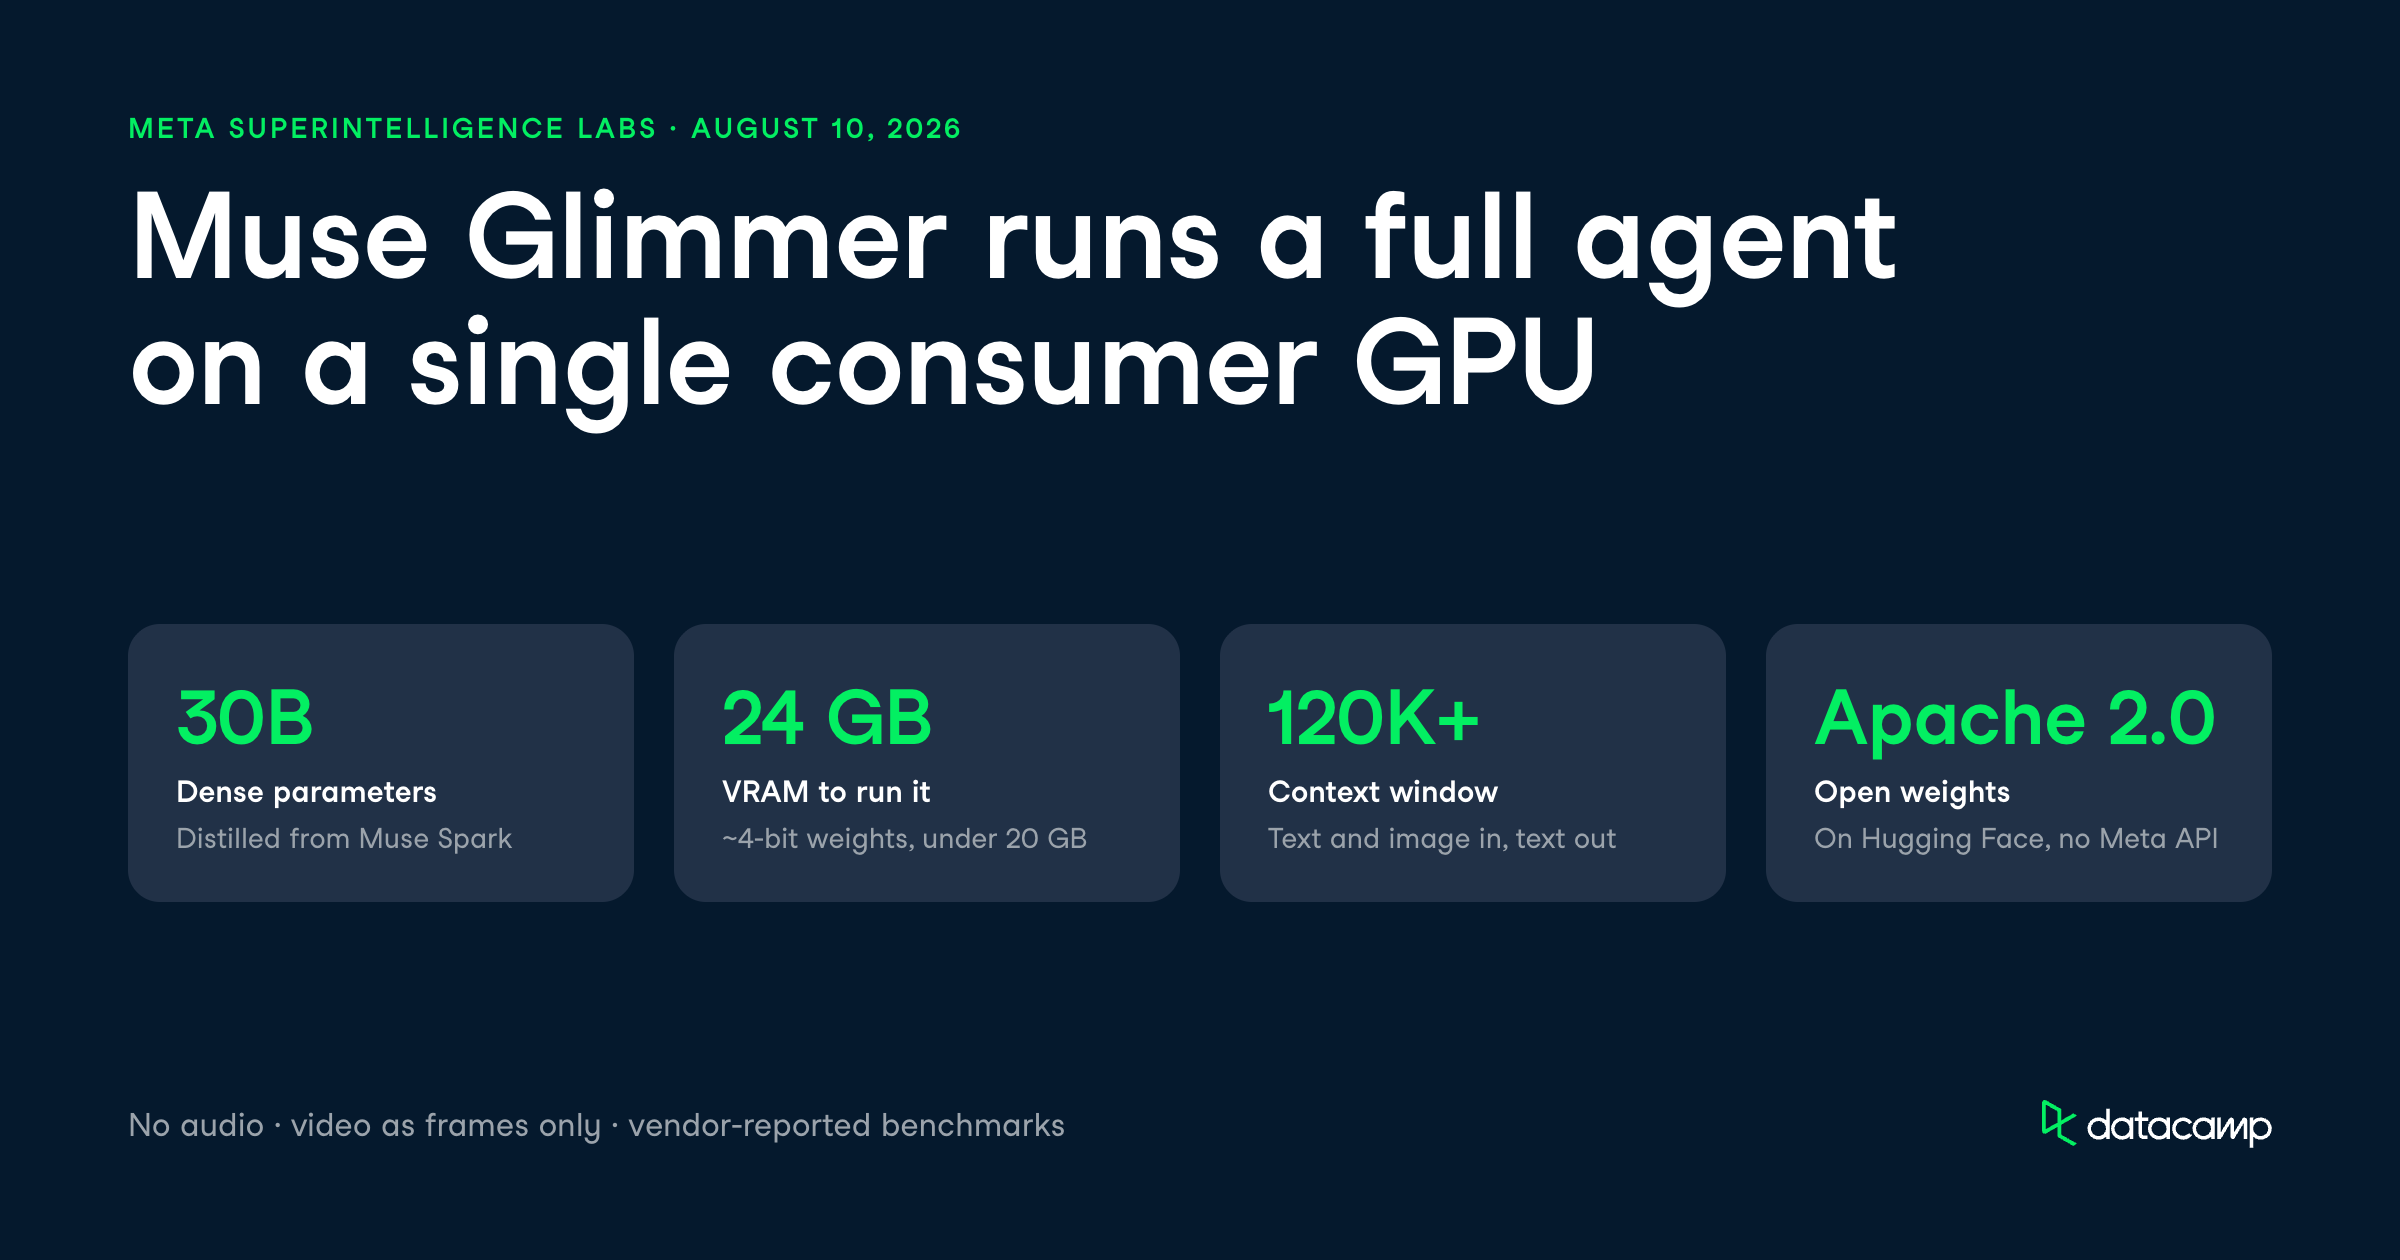
Dit is een agentisch model met 30 miljard parameters, gebouwd voor lokale, always-on workflows, geleverd met open gewichten onder een Apache 2.0-licentie.
De kernbelofte: Muse Glimmer werkt als een volledige agent (plannen, toolaanroepen, zelfcontrole en herstel na fouten) op een enkele 24 GB consumenten-GPU of een Mac-klasse unified memory-systeem. Het wordt geleverd met een contextvenster van 120K+, multimodale tekst-en-beeldinvoer en gequantiseerde gewichten die het model verkleinen tot onder de 20 GB. Meta heeft de gewichten open source gezet op Hugging Face, samen met ontwikkelaarsdocumentatie.
In dit artikel bespreek ik alles wat nieuw is aan Muse Glimmer: de features, de benchmarks ten opzichte van modellen zoals Qwen3.6-27B en Gemma4-31B, en de trucs voor lokale deployment. Lees ook onze aparte handleiding voor het lokaal draaien van Muse Glimmer voor AI-codering.
Wil je meer leren over het lokaal draaien van modellen in het algemeen? Bekijk dan onze tutorials over fine-tunen van Qwen3.6 en zet vaart achter je kennis met onze AI Agent Fundamentals skill track.
Muse Glimmer is een dense model met 30 miljard parameters van Meta Superintelligence Labs, geoptimaliseerd voor lokale agentworkflows in plaats van cloudgehoste chat.
Het wordt gepositioneerd als de kleinere, gedistilleerde broer of zus van een groter intern teachermodel, Muse Spark, en Meta zegt expliciet dat Muse Glimmer niet voldoet aan zijn definitie van "Frontier AI".
Wat hier nieuw is, is het deploymentdoel.
De meeste agentische modellen met deze capaciteiten gaan uit van een datacenter erachter, maar Muse Glimmer is gebouwd om offline te draaien op een enkele consumenten-GPU.
Meta comprimeerde de gewichten naar grofweg 4-bit precisie, waardoor het taalmodel onder de 20 GB komt en binnen een geheugenbudget van 24 GB of 32 GB past, met ruimte over.
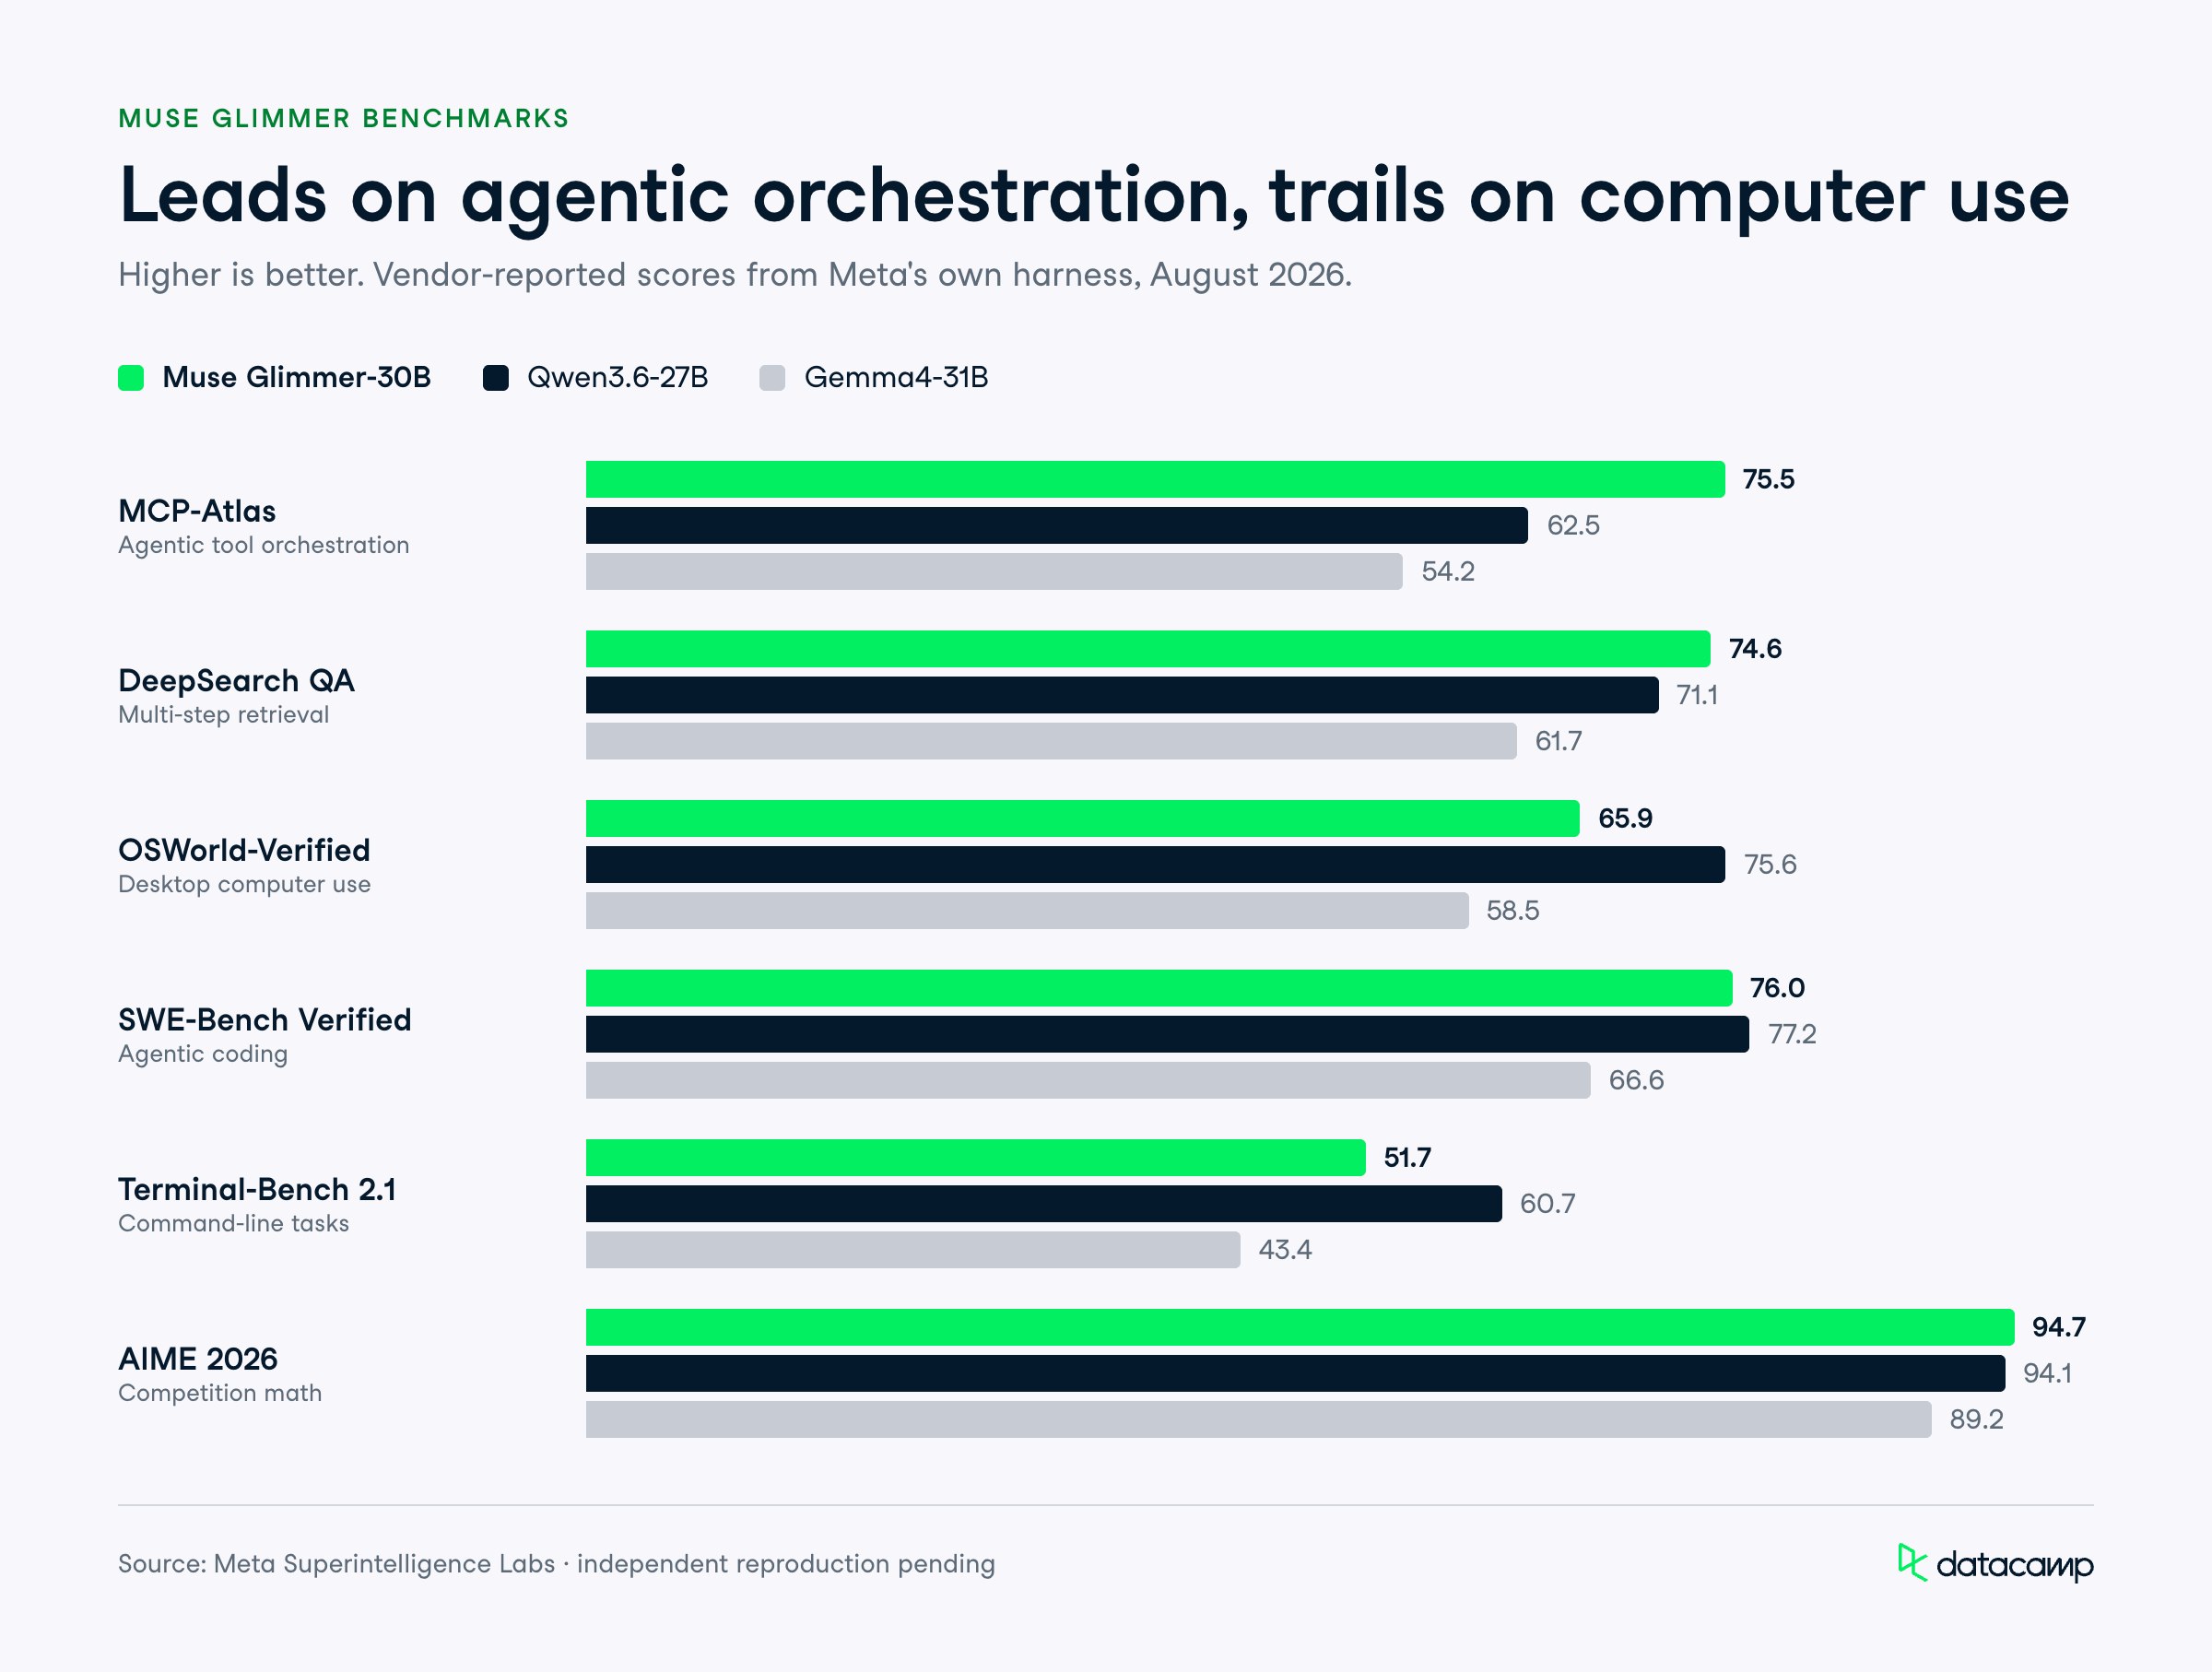
De benchmark die eruit springt is MCP-Atlas, een algemene agentische benchmark, waar Muse Glimmer 75,5 scoort tegenover 62,5 voor Qwen3.6-27B en 54,2 voor Gemma4-31B.
Voor een model dat je zonder internetverbinding kunt draaien, is het leiden van zijn grootteklasse op agentische orkestratie precies het punt van deze release.
Muse Glimmer is gebouwd rondom het lokaal draaien van persoonlijke agents, dus de features draaien om taakafronding, toolgebruik en responsiviteit op beperkte hardware.
Dit zijn de capaciteiten die het meest tellen voor practitioners.
Je kunt Muse Glimmer op een meerstapstaak zetten en het laten plannen, tools laten aanroepen, eigen resultaten laten controleren en herstellen na fouten, alles zonder netwerkverbinding.
Alexandr Wang, Chief AI officer van Meta, zei dat het model "als een volledig capabele agent" opereert en zijn agentische betrouwbaarheid behoudt op 24 GB VRAM.
Voor practitioners verandert dit waar een agent kan leven.
Een model dat je e-mails opstelt, je bestanden herorganiseert of je agenda triaget, heeft diepgaande toegang tot persoonlijke context nodig, en het behouden van die context on-device is een heel andere privacyhouding dan die naar een cloud-API sturen.
Muse Glimmer roept tools aan met precieze schema's over uitgebreide workflows, en wanneer een call faalt of iets onverwachts terugstuurt, is het getraind om de fout te diagnosticeren en opnieuw te proberen in plaats van te stoppen. Dit herstelgedrag is het verschil tussen een agent die een taak voltooit en een die halverwege vastloopt.
Het werkt over OpenClaw en andere agentische orkestratiepatronen, zodat je niet vastzit aan één enkele scaffold.
Meta levert in de documentatie aanwijzingen voor het opzetten van aangepaste scaffolds, wat ertoe doet omdat de kwaliteit van een agent vaak meer afhangt van de omliggende harness dan van het ruwe model.
Via een speciale perceptie-encoder accepteert Muse Glimmer afwisselend tekst en beelden, zodat een agent een screenshot van een foutmelding, een verkoopgrafiek of een gescande factuur kan interpreteren naast het gesprek.
Dit is tekst-en-beeld in, tekst uit.
Er is hier een reële beperking: er is geen audio-invoer of -uitvoer, en video wordt alleen behandeld als afzonderlijke frames in plaats van echte videobegrip.
Als je workflow een volledige screencast moet bekijken, is dit niet het juiste model.
Muse Glimmer ondersteunt verschillende redeneerkrachten, zodat je kwaliteit kunt inruilen voor snelheid afhankelijk van de taak.
Een snelle bestands-hernoemagent heeft niet dezelfde overweging nodig als een meerstaps debugsessie, en dat on-device kunnen afstellen houdt de latentie binnen de perken.
Het model is ook getraind op data uit meer dan 100 talen, al waarschuwt Meta dat het niet op al die talen is geëvalueerd en dat de kwaliteit kan dalen buiten de sterk ondersteunde set.
Meta evalueerde Muse Glimmer tegenover Gemma4-31B en Qwen3.6-27B in agentisch, coderen, multimodaal, veiligheid en redeneren, met gebruik van hun eigen harness.
Onafhankelijke reproductie was ten tijde van schrijven nog niet beschikbaar, dus beschouw dit als leverancierscijfers.
Muse Glimmer leidt zijn grootteklasse op algemene agentische benchmarks, maar blijft achter op Qwen3.6-27B op verschillende computer- en terminaltaken.
In de onderstaande tabel zie je snel hoe Muse Glimmer zich verhoudt tot de concurrentie:
| Benchmark | Muse Glimmer-30B | Qwen3.6-27B | Gemma4-31B |
|---|---|---|---|
| MCP-Atlas | 75.5 | 62.5 | 54.2 |
| DeepSearch QA | 74.6 | 71.1 | 61.7 |
| OSWorld-Verified | 65.9 | 75.6 | 58.5 |
| SWE-Bench Verified | 76.0 | 77.2 | 66.6 |
| Terminal-Bench 2.1 | 51.7 | 60.7 | 43.4 |
| AIME 2026 | 94.7 | 94.1 | 89.2 |
| GPQA Diamond | 83.5 | 84.2 | 85.7 |
| MMMU Pro | 74 | 75 | 73 |
MCP-Atlas meet hoe goed een model toolaanroepen orkestreert via het Model Context Protocol, en Muse Glimmer scoort 75,5 tegenover 62,5 voor Qwen3.6-27B en 54,2 voor Gemma4-31B.
Op DeepSearch QA, een benchmark voor meerstapsinformatieopvraging, scoort Muse Glimmer 74,6, net voor Qwen3.6-27B (71,1) en ruim boven Gemma4-31B (61,7).
Het beeld is niet uniform. Op OSWorld-Verified, dat computer-use agents test in een echte desktopomgeving, scoort Muse Glimmer 65,9 terwijl Qwen3.6-27B leidt met 75,6, dus Qwen is de sterkere keuze voor schermsturende agents.
SWE-Bench Verified meet of een model echte GitHub-issues kan oplossen door code te schrijven en te debuggen.
Muse Glimmer scoort 76,0, dicht bij Qwen3.6-27B (77,2) en voor Gemma4-31B (66,6).
Op Terminal-Bench 2.1, dat taakafronding op de command line test, blijft Muse Glimmer achter met 51,7 tegenover 60,7 voor Qwen3.6-27B. Ter referentie: toen we Qwen3.6 fine-tuneden in onze eigen tutorial, zagen we dat zijn kracht op SWE-bench en Terminal-Bench in de praktijk standhield, dus Qwens voorsprong op terminaltaken hier sluit aan bij wat we zagen.
AIME 2026 is een wiskundebenchmark op competitieniveau, en Muse Glimmer scoort 94,7, net boven Qwen3.6-27B (94,1) en beter dan Gemma4-31B (89,2).
Dat is een sterk resultaat voor een model van deze grootte.
Op GPQA Diamond, een set vragen op masterniveau in de natuurwetenschappen, scoort Muse Glimmer 83,5, terwijl Gemma4-31B leidt met 85,7 en Qwen3.6-27B op 84,2 zit.
Op Humanity's Last Exam (tekst, geen tools) scoort Muse Glimmer 22,0, iets achter beide rivalen.
MMMU Pro test multimodaal redeneren over beelden en tekst op masterniveau, en de drie modellen liggen bijna gelijk: Muse Glimmer 74, Qwen3.6-27B 75, Gemma4-31B 73.
Op Charxiv Reasoning, dat grafiekinterpretatie test, scoort Muse Glimmer 78,8, net voor beide rivalen.
Meta's eigen sterktec claims op ScreenSpot Pro houden niet helemaal stand: Muse Glimmer scoort 75,4, terwijl Qwen3.6-27B leidt met 76,1.
De multimodale categorie ligt zo dicht bij elkaar dat dit niet de doorslaggevende factor zal zijn tussen deze modellen.
Op CI Memories, dat het percentage privacyovertredingen meet (lager is beter), noteert Muse Glimmer 26,4 tegenover een veel schonere 12,1 voor Gemma4-31B en 53,4 voor Qwen3.6-27B.
Dus Muse Glimmer zit hier tussen zijn rivalen in: veiliger dan Qwen, maar ruimschoots achter op Gemma op deze metric.
Op Siren AgentDojo, dat weerstand tegen prompt-injectieaanvallen meet, laat Muse Glimmer een aanvalssuccesratio van 28,4 zien met 94,2 nut, vergeleken met 25,6 voor Gemma4-31B en 40,3 voor Qwen3.6-27B. Als je een agent inzet die met onbetrouwbare content werkt, is die injectiebestendigheid het overwegen waard.
Muse Glimmer wordt verspreid als open gewichten onder Apache 2.0, en er is geen door Meta gehoste eigen API.
Dat betekent dat er geen per-tokenprijzen van Meta te melden zijn: je kosten zijn infrastructuur en self-hosting, niet een afgemeten API-tarief.
Je kunt aan de slag via verschillende routes:
Meta werkt samen met AMD, Arm, Dell, Intel en NVIDIA om de prestaties op verschillende apparaten te tunen.
Het praktische hardwaredoel is een machine met 24 GB of 32 GB: Meta rapporteert dat de K-Quant-17GB-build plus de gequantiseerde DFlash-drafter het decoderen versnelt met 3,1x op een RTX 5090, 1,8x op een M5 Max en 1,5x op een M4 Max.
Muse Glimmer is Meta's bewuste gok op lokale, private agents met open gewichten, in plaats van weer een cloudvlaggenschip.
Door het te beperken tot 30B en gequantiseerde gewichten te leveren die op één consumenten-GPU passen, richt Meta zich op een niche die de meeste labs negeren: developers die een agent willen die offline draait met persoonlijke context die het apparaat nooit verlaat.
Mijn eerlijke oordeel: dit is een builder's stack, geen one-click cloudvervanging.
Het benchmarkverhaal is gemengd (Qwen3.6-27B leidt nog steeds op OSWorld-Verified en Terminal-Bench 2.1, en Gemma4-31B is schoner op CI Memories), en reviewers noemden Muse Glimmer traag en fragiel dicht bij de geheugengrens. Maar het leiden van zijn grootteklasse op MCP-Atlas en DeepSearch QA, met een permissieve Apache 2.0-licentie, maakt het een serieuze optie voor iedereen die lokale agents bouwt.
De kanttekeningen: geen audio, video alleen als frames, ongelijke taaldekking en voorlopig alleen leveranciersbenchmarks tot onafhankelijke reproducties verschijnen.
Als je workflow privacygevoelig is of echt zonder netwerk moet draaien, is Muse Glimmer het downloaden waard en het testen tegenover Qwen3.6 op je eigen hardware.
Wil je zelf de skills opbouwen om dit soort modellen te draaien en te tunen? Bekijk dan onze tutorial over je eerste autonome AI-agent bouwen.
Topcursussen op DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

