Cours
Créer des agents IA avec Google ADK
1 h
7.5K
Meta Superintelligence Labs a présenté Muse Glimmer le 10 août 2026, avec une promesse rare pour un lancement en 2026 : il tourne sur un ordinateur portable.
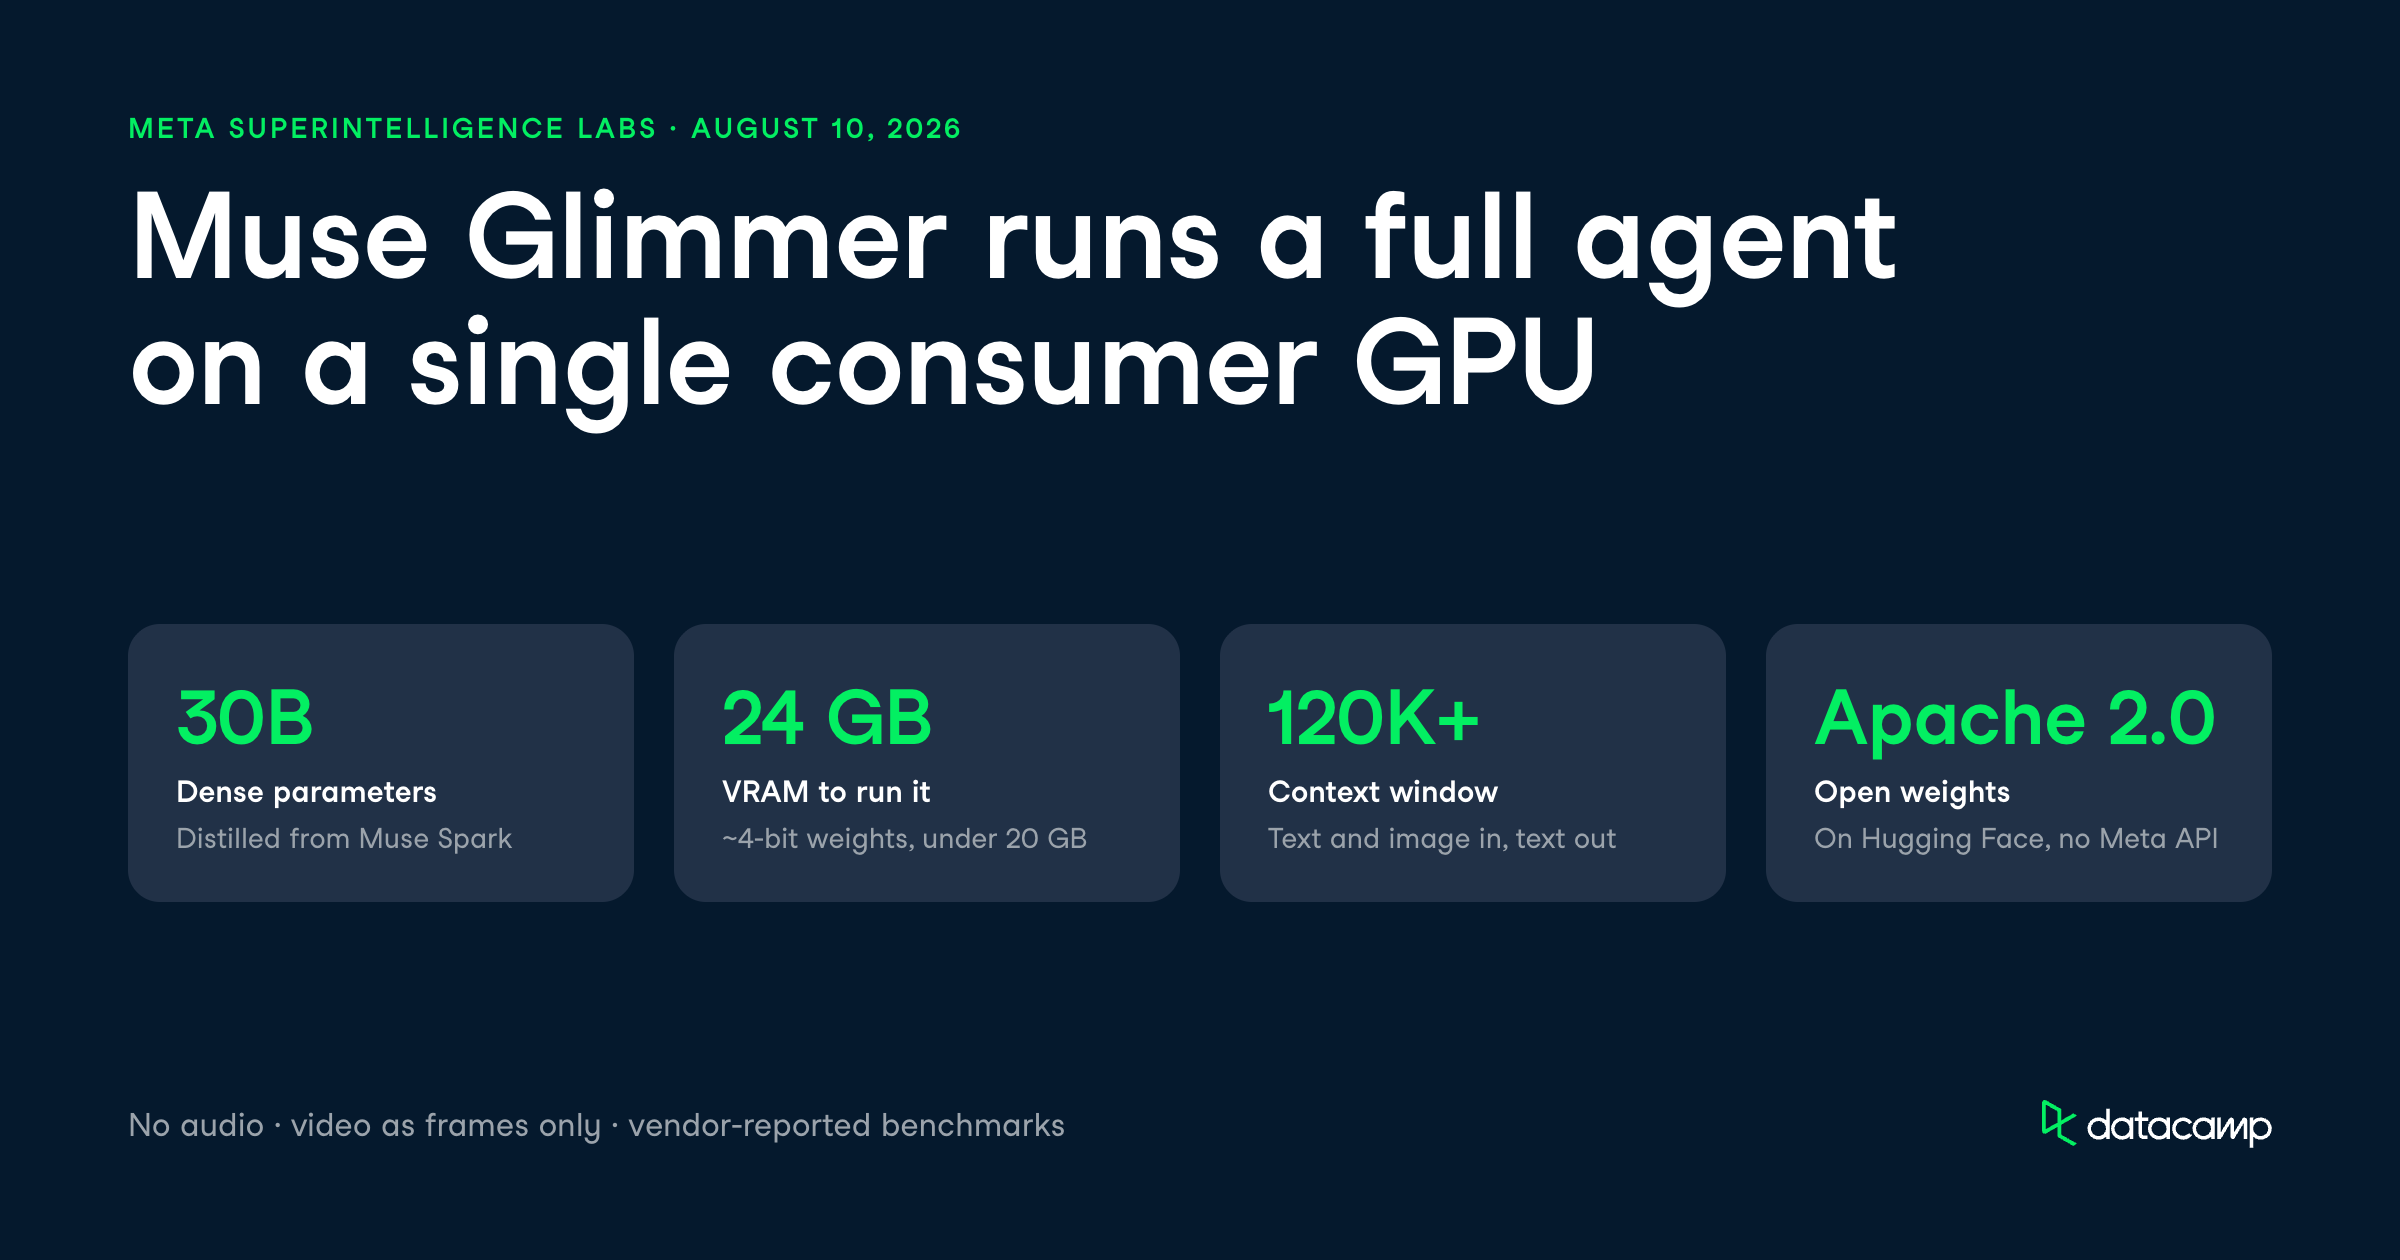
Il s'agit d'un modèle agentique dense de 30 milliards de paramètres, conçu pour des workflows locaux en permanence, publié avec des poids ouverts sous licence Apache 2.0.
La promesse phare : Muse Glimmer fonctionne comme un agent complet (planification, appels d'outils, auto-vérification et récupération en cas d'échec) sur un seul GPU grand public de 24 Go ou sur un Mac avec mémoire unifiée. Il est livré avec une fenêtre de contexte de plus de 120 000 tokens, une entrée multimodale texte + image, et des poids quantifiés qui réduisent le modèle à moins de 20 Go. Meta a publié les poids en open source sur Hugging Face, accompagnés d'une documentation développeur.
Dans cet article, je passe en revue toutes les nouveautés de Muse Glimmer : ses fonctionnalités, ses résultats face à des modèles comme Qwen3.6-27B et Gemma4-31B, et ses astuces de déploiement local. Vous pouvez également consulter notre guide pour exécuter Muse Glimmer en local pour le codage en IA.
Pour en savoir plus sur l'exécution locale de modèles en général, consultez nos tutoriels sur le fine-tuning de Qwen3.6 et accélérez votre progression avec notre parcours de compétences AI Agent Fundamentals.
Muse Glimmer est un modèle dense de 30 milliards de paramètres signé Meta Superintelligence Labs, optimisé pour des workflows d'agents locaux plutôt que pour du chat hébergé dans le cloud.
Il est présenté comme le petit frère distillé d'un grand modèle enseignant interne, Muse Spark, et Meta précise explicitement que Muse Glimmer ne correspond pas à sa définition de « Frontier AI ».
La nouveauté tient ici à la cible de déploiement.
La plupart des modèles agentiques de ce niveau supposent un datacenter derrière eux, alors que Muse Glimmer est conçu pour tourner hors ligne sur un seul GPU grand public.
Meta a compressé les poids à une précision d'environ 4 bits, ramenant le modèle de langue à moins de 20 Go afin qu'il tienne dans 24 Go ou 32 Go de mémoire, avec de la marge.
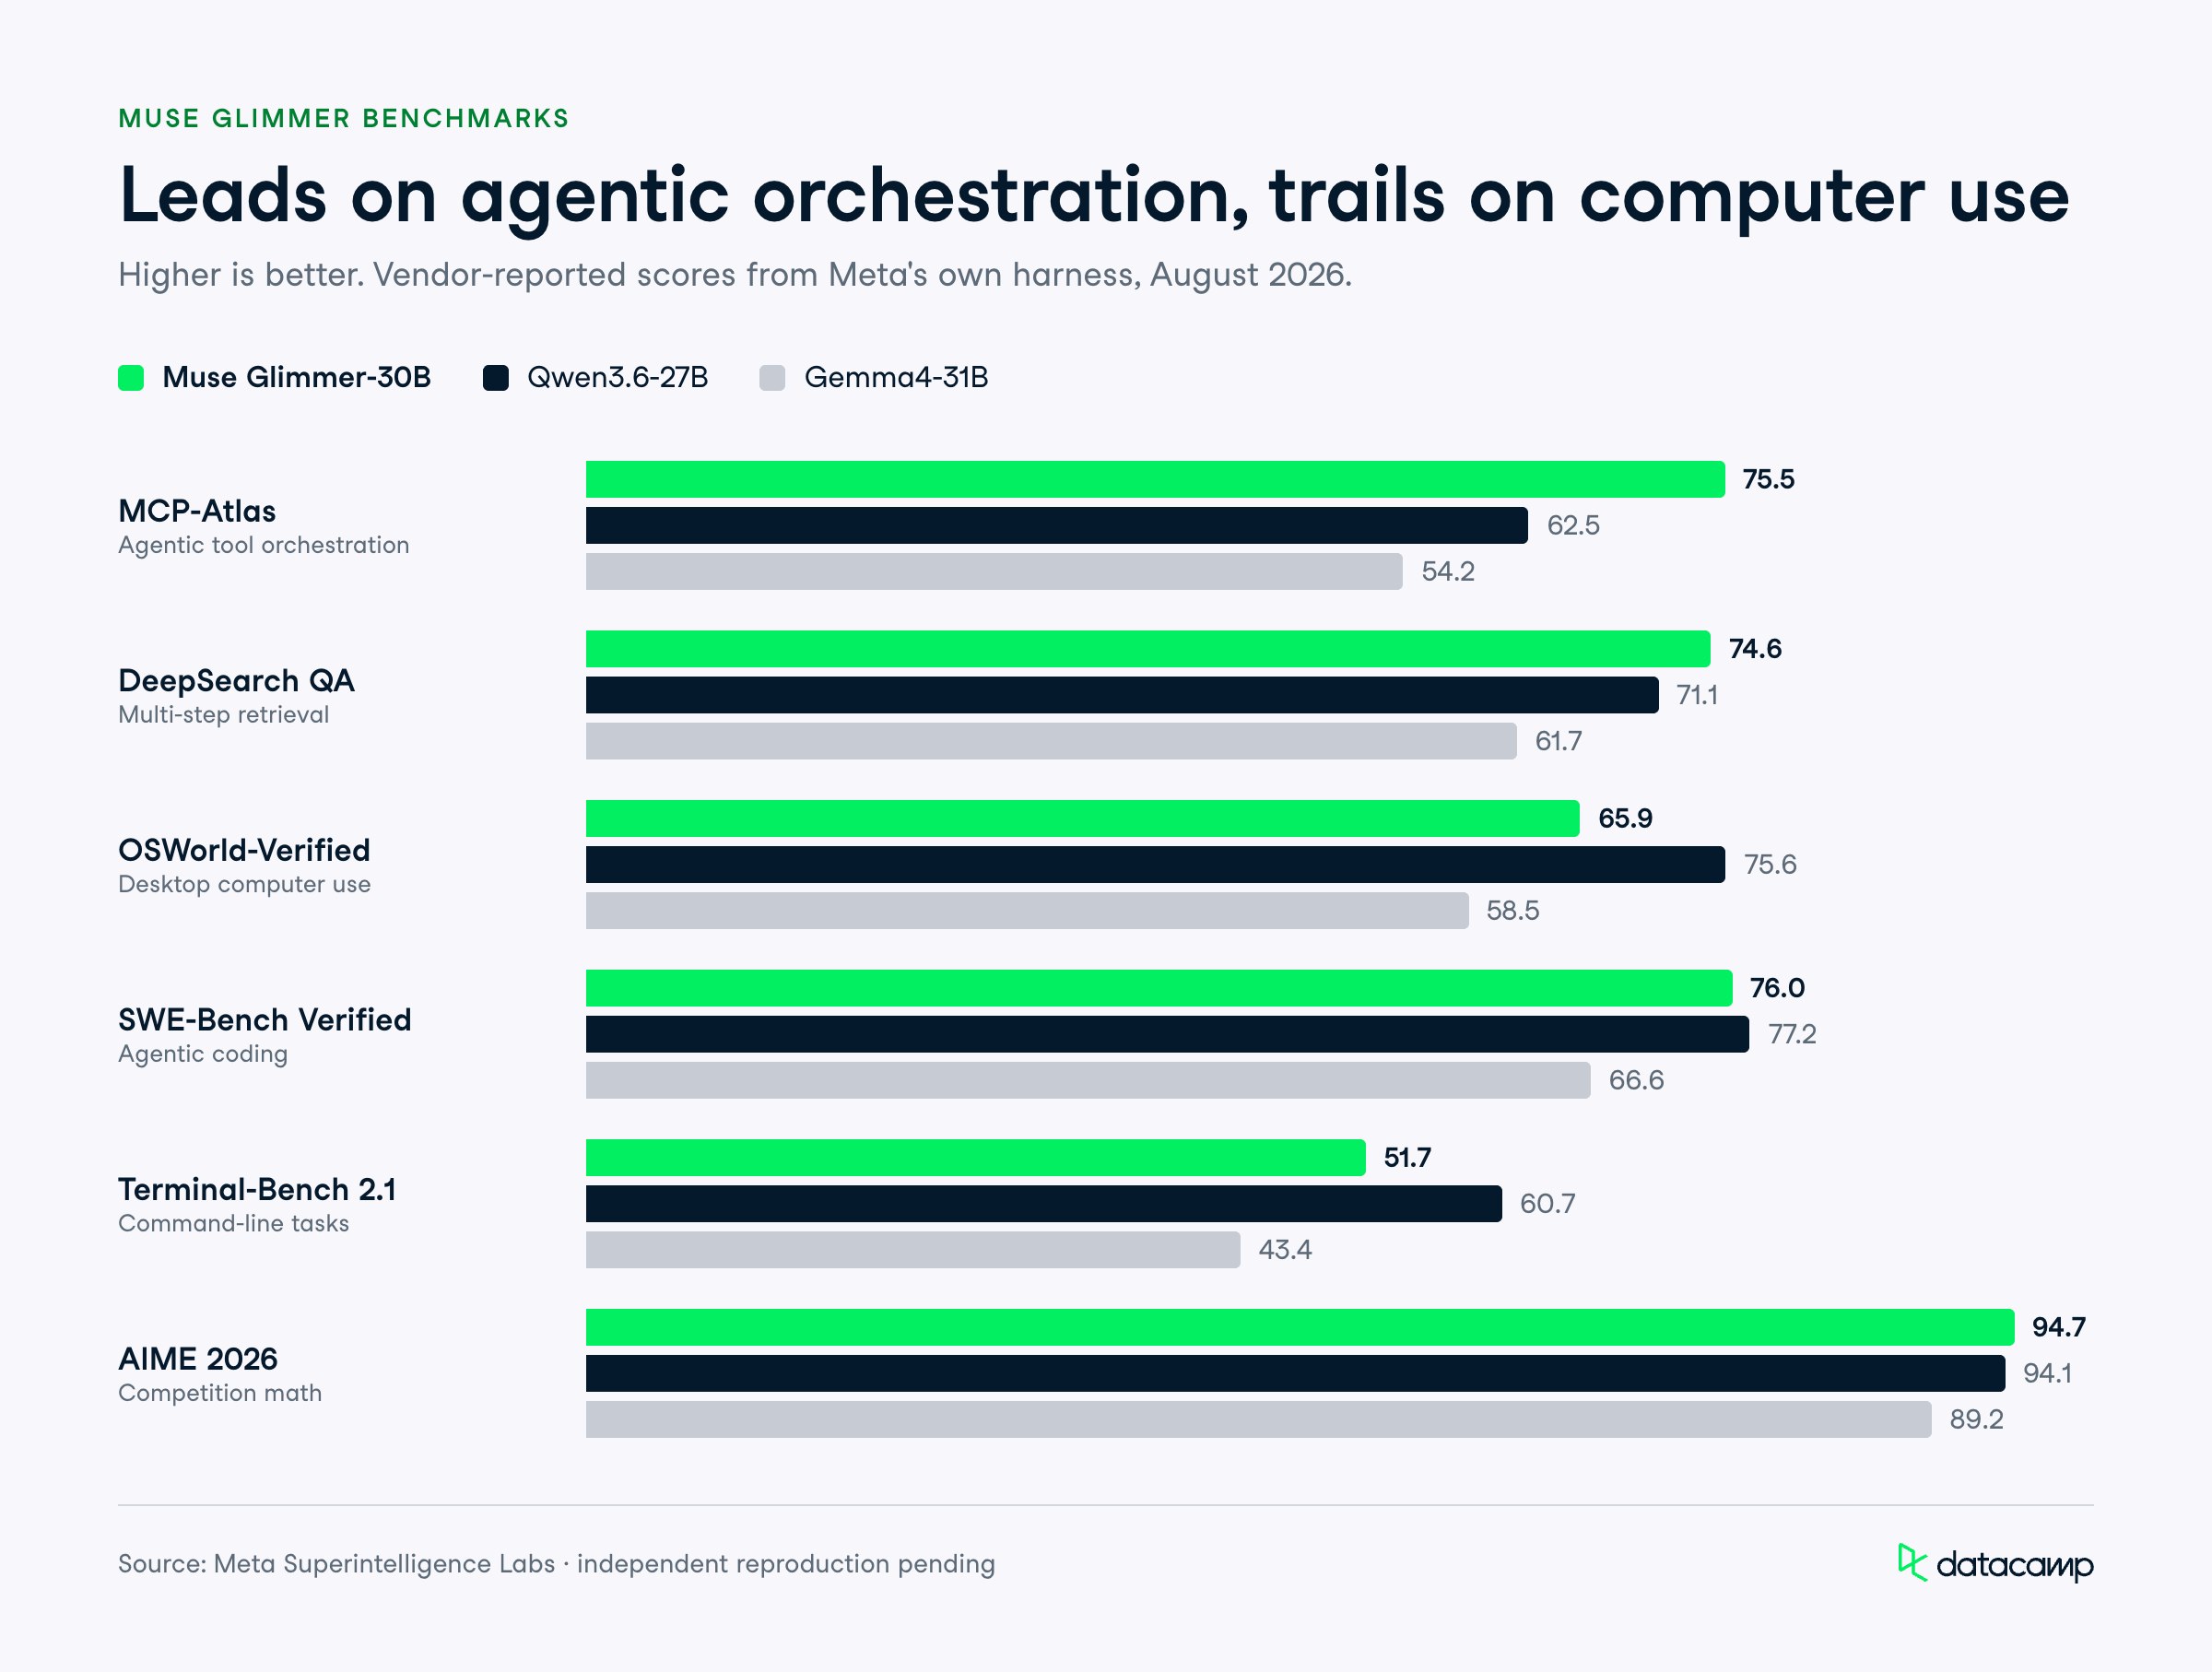
Le résultat de benchmark qui saute aux yeux est MCP-Atlas, un benchmark généraliste pour agents, où Muse Glimmer atteint 75,5 contre 62,5 pour Qwen3.6-27B et 54,2 pour Gemma4-31B.
Pour un modèle exécutable sans connexion, dominer sa catégorie en orchestration agentique est l'intention de cette sortie.
Muse Glimmer est conçu pour faire tourner des agents personnels en local ; ses fonctionnalités sont donc axées sur l'exécution de tâches, l'usage d'outils et la réactivité sur matériel limité.
Voici les capacités qui comptent le plus pour les praticiens.
Vous pouvez confier à Muse Glimmer une tâche en plusieurs étapes : il planifie, appelle des outils, vérifie ses propres résultats et se remet des échecs sans connexion réseau.
Alexandr Wang, Chief AI officer de Meta, a indiqué que le modèle fonctionne « comme un agent pleinement opérationnel » et conserve sa fiabilité agentique avec 24 Go de VRAM.
Pour les praticiens, cela change le périmètre d'usage d'un agent.
Un modèle qui rédige vos e-mails, réorganise vos fichiers ou priorise votre agenda a besoin d'un accès profond à votre contexte personnel ; conserver ce contexte sur l'appareil offre un positionnement de confidentialité bien différent d'un envoi vers une API cloud.
Muse Glimmer invoque des outils avec des schémas précis sur des workflows étendus et, lorsqu'un appel échoue ou renvoie un résultat inattendu, il est entraîné à diagnostiquer l'erreur et à réessayer au lieu de s'arrêter. Cette capacité de récupération fait la différence entre un agent qui termine une tâche et un autre qui se bloque en chemin.
Il fonctionne avec OpenClaw et d'autres schémas d'orchestration agentique, sans vous enfermer dans une seule structure.
Meta fournit des recommandations pour créer des « scaffolds » personnalisés dans la documentation, ce qui compte car la qualité d'un agent dépend souvent davantage du harnais périphérique que du modèle brut.
Grâce à un encodeur de perception dédié, Muse Glimmer accepte du texte et des images entremêlés, permettant à un agent d'interpréter une capture d'erreur, un graphique commercial ou une facture scannée dans le fil de conversation.
C'est texte + image en entrée, texte en sortie.
Une limite réelle est à noter : pas d'entrée ni de sortie audio, et la vidéo n'est gérée qu'en images fixes, sans compréhension vidéo véritable.
Si votre flux de travail doit analyser une capture d'écran vidéo de bout en bout, ce n'est pas le bon modèle.
Muse Glimmer prend en charge plusieurs niveaux de raisonnement, de sorte que vous pouvez arbitrer qualité et vitesse selon la tâche.
Un agent qui renomme des fichiers n'a pas besoin du même degré de délibération qu'une session de débogage en plusieurs étapes, et pouvoir régler cela en local maintient une latence raisonnable.
Le modèle a aussi été entraîné sur des données dans plus de 100 langues, mais Meta précise qu'il n'a pas été évalué sur toutes, et la qualité peut baisser hors du noyau fortement pris en charge.
Meta a évalué Muse Glimmer face à Gemma4-31B et Qwen3.6-27B sur des catégories agentiques, de codage, multimodales, de sécurité et de raisonnement, avec son propre harnais.
Au moment d'écrire ces lignes, aucune reproduction indépendante n'avait encore été publiée ; considérez donc ces chiffres comme ceux de l'éditeur.
Muse Glimmer mène sa catégorie sur les benchmarks généralistes d'agents, mais reste derrière Qwen3.6-27B sur plusieurs tâches d'usage de l'ordinateur et du terminal.
Le tableau ci-dessous permet de comparer rapidement Muse Glimmer à ses concurrents :
| Benchmark | Muse Glimmer-30B | Qwen3.6-27B | Gemma4-31B |
|---|---|---|---|
| MCP-Atlas | 75,5 | 62,5 | 54,2 |
| DeepSearch QA | 74,6 | 71,1 | 61,7 |
| OSWorld-Verified | 65,9 | 75,6 | 58,5 |
| SWE-Bench Verified | 76,0 | 77,2 | 66,6 |
| Terminal-Bench 2.1 | 51,7 | 60,7 | 43,4 |
| AIME 2026 | 94,7 | 94,1 | 89,2 |
| GPQA Diamond | 83,5 | 84,2 | 85,7 |
| MMMU Pro | 74 | 75 | 73 |
MCP-Atlas mesure la capacité d'un modèle à orchestrer des appels d'outils via le Model Context Protocol, et Muse Glimmer y obtient 75,5 contre 62,5 pour Qwen3.6-27B et 54,2 pour Gemma4-31B.
Sur DeepSearch QA, un benchmark de recherche d'information en plusieurs étapes, Muse Glimmer atteint 74,6, devant Qwen3.6-27B à 71,1 et nettement devant Gemma4-31B à 61,7.
Le tableau n'est pas uniforme. Sur OSWorld-Verified, qui évalue des agents d'usage du PC dans un environnement de bureau réel, Muse Glimmer obtient 65,9 tandis que Qwen3.6-27B mène à 75,6 ; Qwen est donc un meilleur choix pour piloter l'écran.
SWE-Bench Verified mesure la capacité d'un modèle à résoudre de véritables issues GitHub en écrivant et déboguant du code.
Muse Glimmer obtient 76,0, au niveau de Qwen3.6-27B à 77,2 et devant Gemma4-31B à 66,6.
Sur Terminal-Bench 2.1, qui évalue l'exécution de tâches en ligne de commande, Muse Glimmer est derrière à 51,7 contre 60,7 pour Qwen3.6-27B. Pour mémoire, lorsque nous avons fine-tuné Qwen3.6 dans notre propre tutoriel, sa force sur SWE-Bench et Terminal-Bench s'est confirmée en pratique ; l'avance de Qwen sur le terminal ici est donc cohérente avec nos observations.
AIME 2026 est un benchmark de mathématiques de concours ; Muse Glimmer atteint 94,7, devant Qwen3.6-27B à 94,1 et Gemma4-31B à 89,2.
Un très bon résultat pour un modèle de cette taille.
Sur GPQA Diamond, un ensemble de questions scientifiques de niveau master, Muse Glimmer obtient 83,5, tandis que Gemma4-31B mène à 85,7 et Qwen3.6-27B est à 84,2.
Sur Humanity's Last Exam (texte, sans outils), Muse Glimmer marque 22,0, légèrement derrière ses deux rivaux.
MMMU Pro teste le raisonnement multimodal texte + image à un niveau avancé, et les trois modèles sont au coude à coude : Muse Glimmer 74, Qwen3.6-27B 75, Gemma4-31B 73.
Sur Charxiv Reasoning, qui évalue l'interprétation de graphiques, Muse Glimmer obtient 78,8, légèrement devant ses concurrents.
La revendication de supériorité de Meta sur ScreenSpot Pro ne se vérifie pas tout à fait : Muse Glimmer est à 75,4 alors que Qwen3.6-27B mène à 76,1.
La catégorie multimodale est suffisamment équilibrée pour ne pas être le facteur décisif entre ces modèles.
Sur CI Memories, qui mesure le taux d'atteintes à la vie privée (plus bas est meilleur), Muse Glimmer affiche 26,4 contre 12,1 pour Gemma4-31B (nettement plus propre) et 53,4 pour Qwen3.6-27B.
Muse Glimmer se situe donc entre ses rivaux ici : plus sûr que Qwen, mais loin derrière Gemma sur cette mesure.
Sur Siren AgentDojo, qui évalue la résistance aux attaques par injection de prompt, Muse Glimmer présente un taux de réussite des attaques de 28,4 avec une utilité de 94,2, contre 25,6 pour Gemma4-31B et 40,3 pour Qwen3.6-27B. Si vous déployez un agent exposé à du contenu non fiable, cette résilience aux injections compte.
Muse Glimmer est distribué en poids ouverts sous Apache 2.0, sans API native hébergée par Meta.
Concrètement, pas de tarif au token à indiquer : votre coût tient à l'infrastructure et à l'auto-hébergement, pas à une API facturée à l'usage.
Plusieurs voies pour vous lancer :
Meta collabore avec AMD, Arm, Dell, Intel et NVIDIA pour optimiser les performances selon les appareils.
La cible matérielle pragmatique est une machine de 24 Go ou 32 Go : Meta indique que la version K-Quant-17GB, ajoutée au drafter DFlash quantifié, accélère le décodage par 3,1× sur une RTX 5090, 1,8× sur un M5 Max et 1,5× sur un M4 Max.
Muse Glimmer traduit un pari assumé de Meta en faveur d'agents locaux, privés et en poids ouverts, plutôt qu'un nouveau fleuron cloud.
En limitant à 30 Md et en livrant des poids quantifiés tenant sur un seul GPU grand public, Meta vise un segment que la plupart des labs ignorent : les développeurs qui veulent un agent hors ligne dont le contexte personnel ne quitte jamais l'appareil.
Mon avis honnête : c'est une pile pour bâtisseurs, pas un remplaçant cloud en un clic.
Les benchmarks sont mitigés (Qwen3.6-27B reste devant sur OSWorld-Verified et Terminal-Bench 2.1, et Gemma4-31B est plus propre sur CI Memories), et des testeurs ont jugé Muse Glimmer lent et fragile à la limite mémoire. Mais dominer sa catégorie sur MCP-Atlas et DeepSearch QA, avec une licence Apache 2.0 permissive, en fait une option sérieuse pour qui construit des agents locaux.
Les bémols : pas d'audio, vidéo seulement en images, couverture linguistique inégale, et benchmarks éditeur en attendant des reproductions indépendantes.
Si votre flux de travail est sensible à la confidentialité ou doit vraiment tourner sans réseau, Muse Glimmer mérite d'être téléchargé et testé face à Qwen3.6 sur votre propre matériel.
Si vous souhaitez acquérir les compétences pour exécuter et ajuster vous-même ce type de modèles, je recommande notre tutoriel sur la création de votre premier agent IA autonome.
Les meilleurs cours DataCamp
Cours
Cours
Cursus