Curso
Criando agentes de IA com o Google ADK
1 h
7.5K
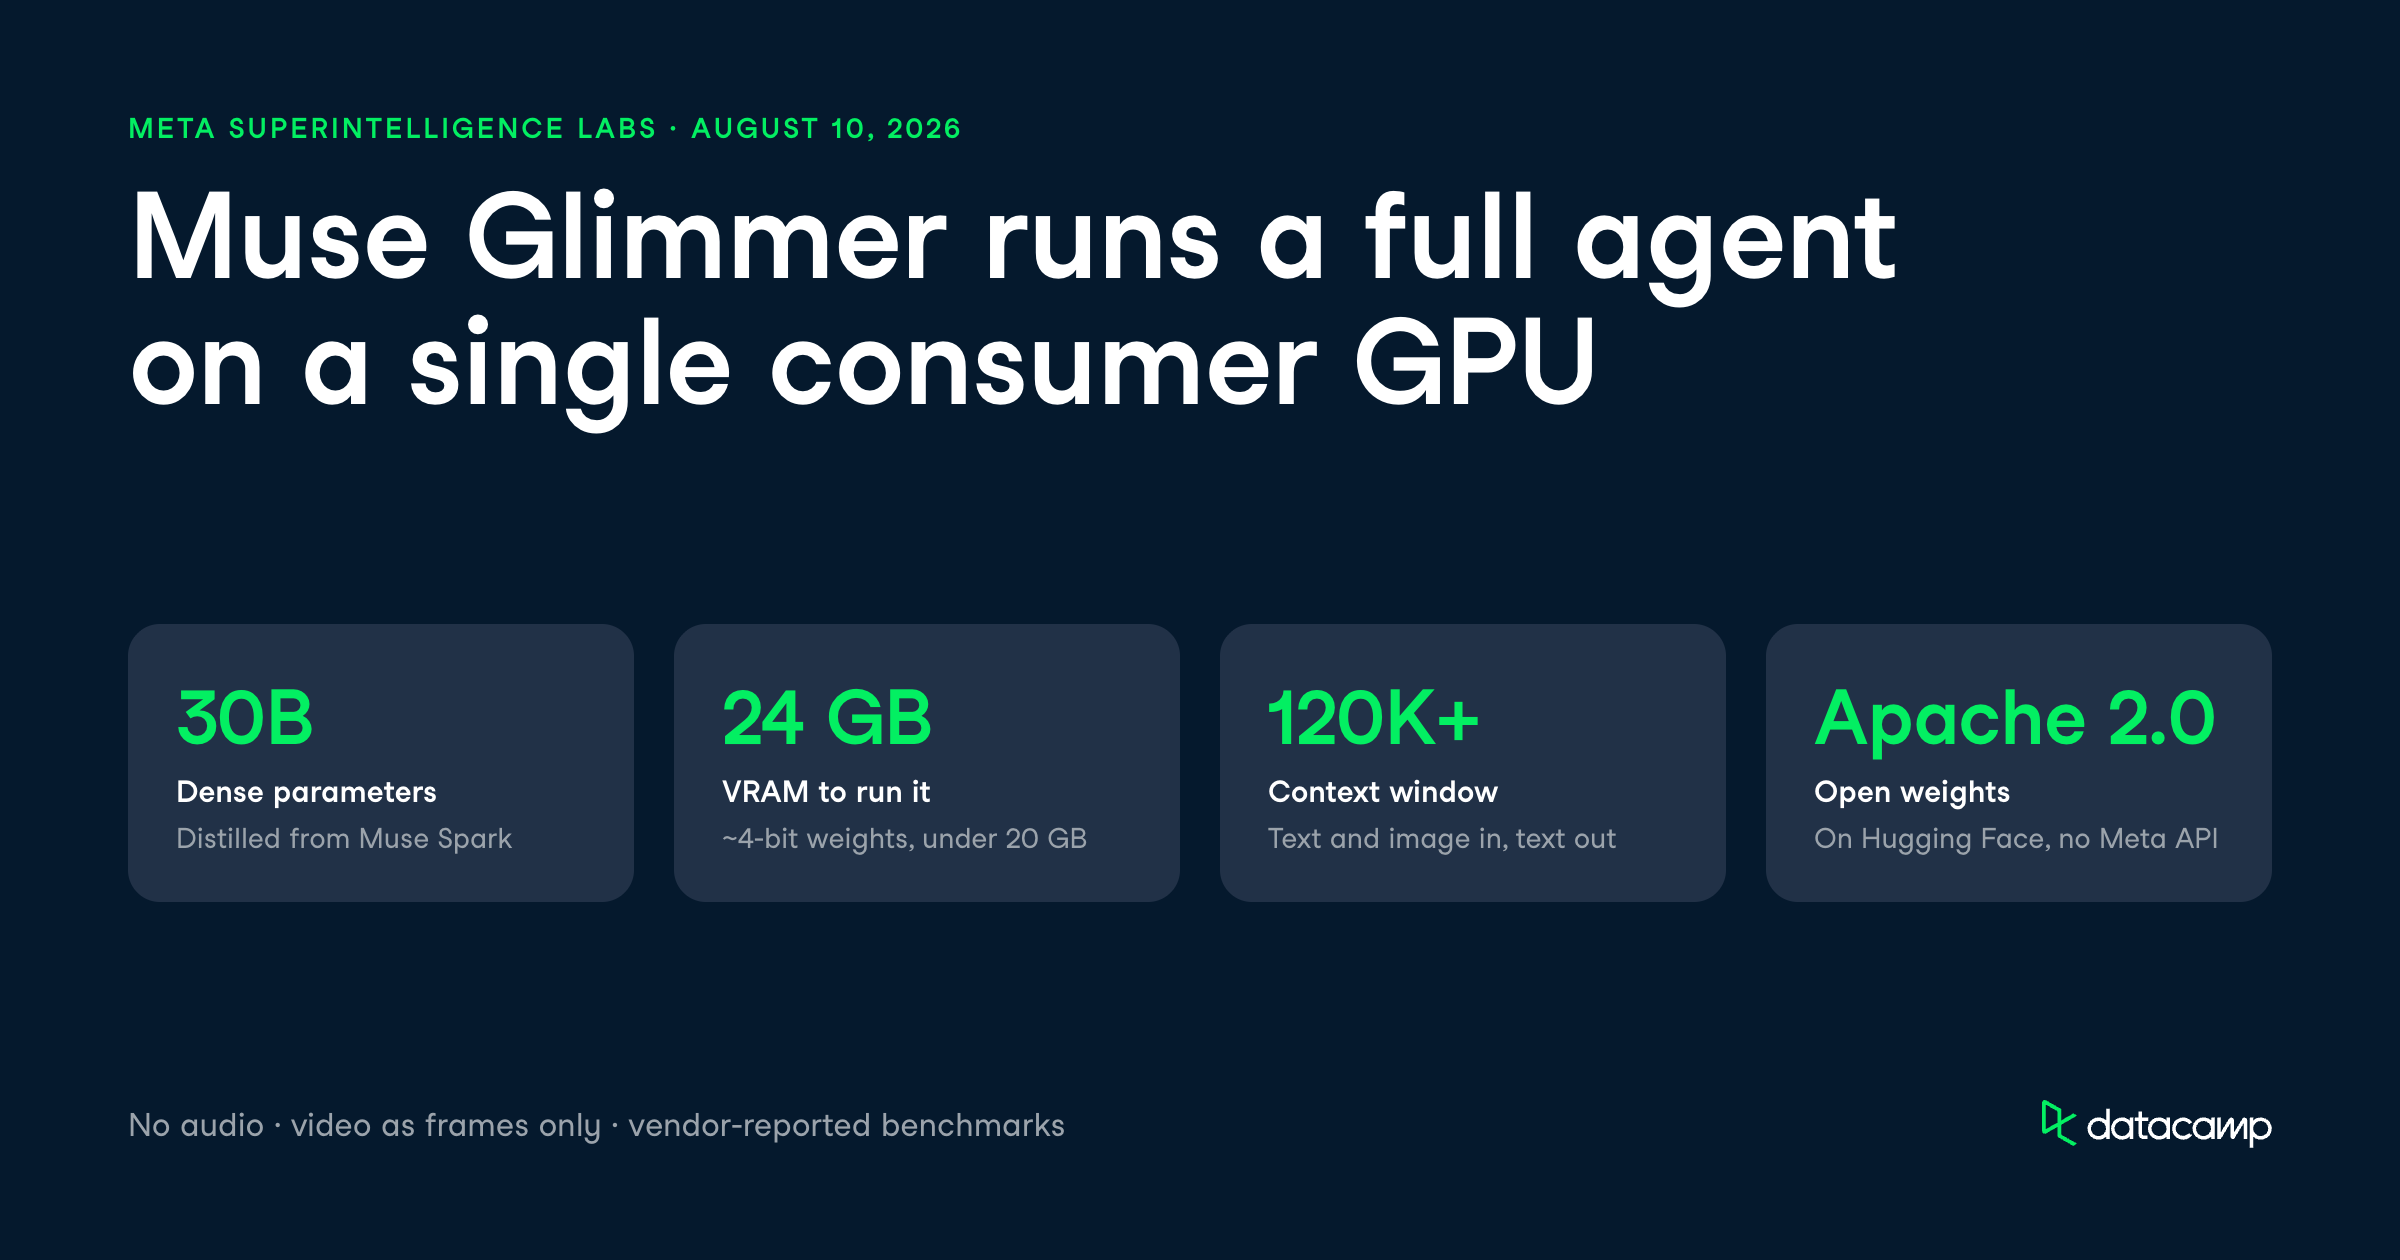
A Meta Superintelligence Labs lançou o Muse Glimmer em 10 de agosto de 2026, e a proposta é incomum para um lançamento de 2026: ele roda em um laptop.
Trata-se de um modelo agentivo denso com 30 bilhões de parâmetros, pensado para fluxos de trabalho locais e sempre ativos, distribuído com pesos abertos sob a licença Apache 2.0.
A principal promessa é que o Muse Glimmer funciona como um agente completo (planejamento, chamadas de ferramentas, autoavaliação e recuperação de falhas) em uma única GPU de 24 GB para consumidores ou em um sistema Mac com memória unificada. Ele vem com janela de contexto acima de 120K, entrada multimodal de texto e imagem e pesos quantizados que reduzem o modelo para menos de 20 GB. A Meta abriu os pesos no Hugging Face junto com a documentação para desenvolvedores.
Neste artigo, vou cobrir tudo que há de novo no Muse Glimmer, analisando os recursos, os benchmarks contra modelos como Qwen3.6-27B e Gemma4-31B, e os truques para implantação local. Você também pode conferir nosso guia para rodar o Muse Glimmer localmente para programação com IA.
Para saber mais sobre execução local de modelos em geral, veja nossos tutoriais sobre fine-tuning do Qwen3.6 e acelere com nossa trilha de aprendizado AI Agent Fundamentals.
O Muse Glimmer é um modelo denso de 30 bilhões de parâmetros da Meta Superintelligence Labs, otimizado para fluxos de trabalho agentivos locais, não para chat hospedado em nuvem.
Ele é posicionado como o irmão menor, destilado, de um modelo professor interno maior, o Muse Spark, e a Meta diz explicitamente que o Muse Glimmer não se enquadra na sua definição de "Frontier AI".
O novo aqui é o alvo de implantação.
A maioria dos modelos agentivos com essa capacidade pressupõe um datacenter por trás, mas o Muse Glimmer foi feito para rodar offline em uma única GPU de consumidor.
A Meta comprimiu os pesos para cerca de 4 bits de precisão, trazendo o modelo de linguagem para menos de 20 GB, de modo que caiba em 24 GB ou 32 GB de memória com folga.
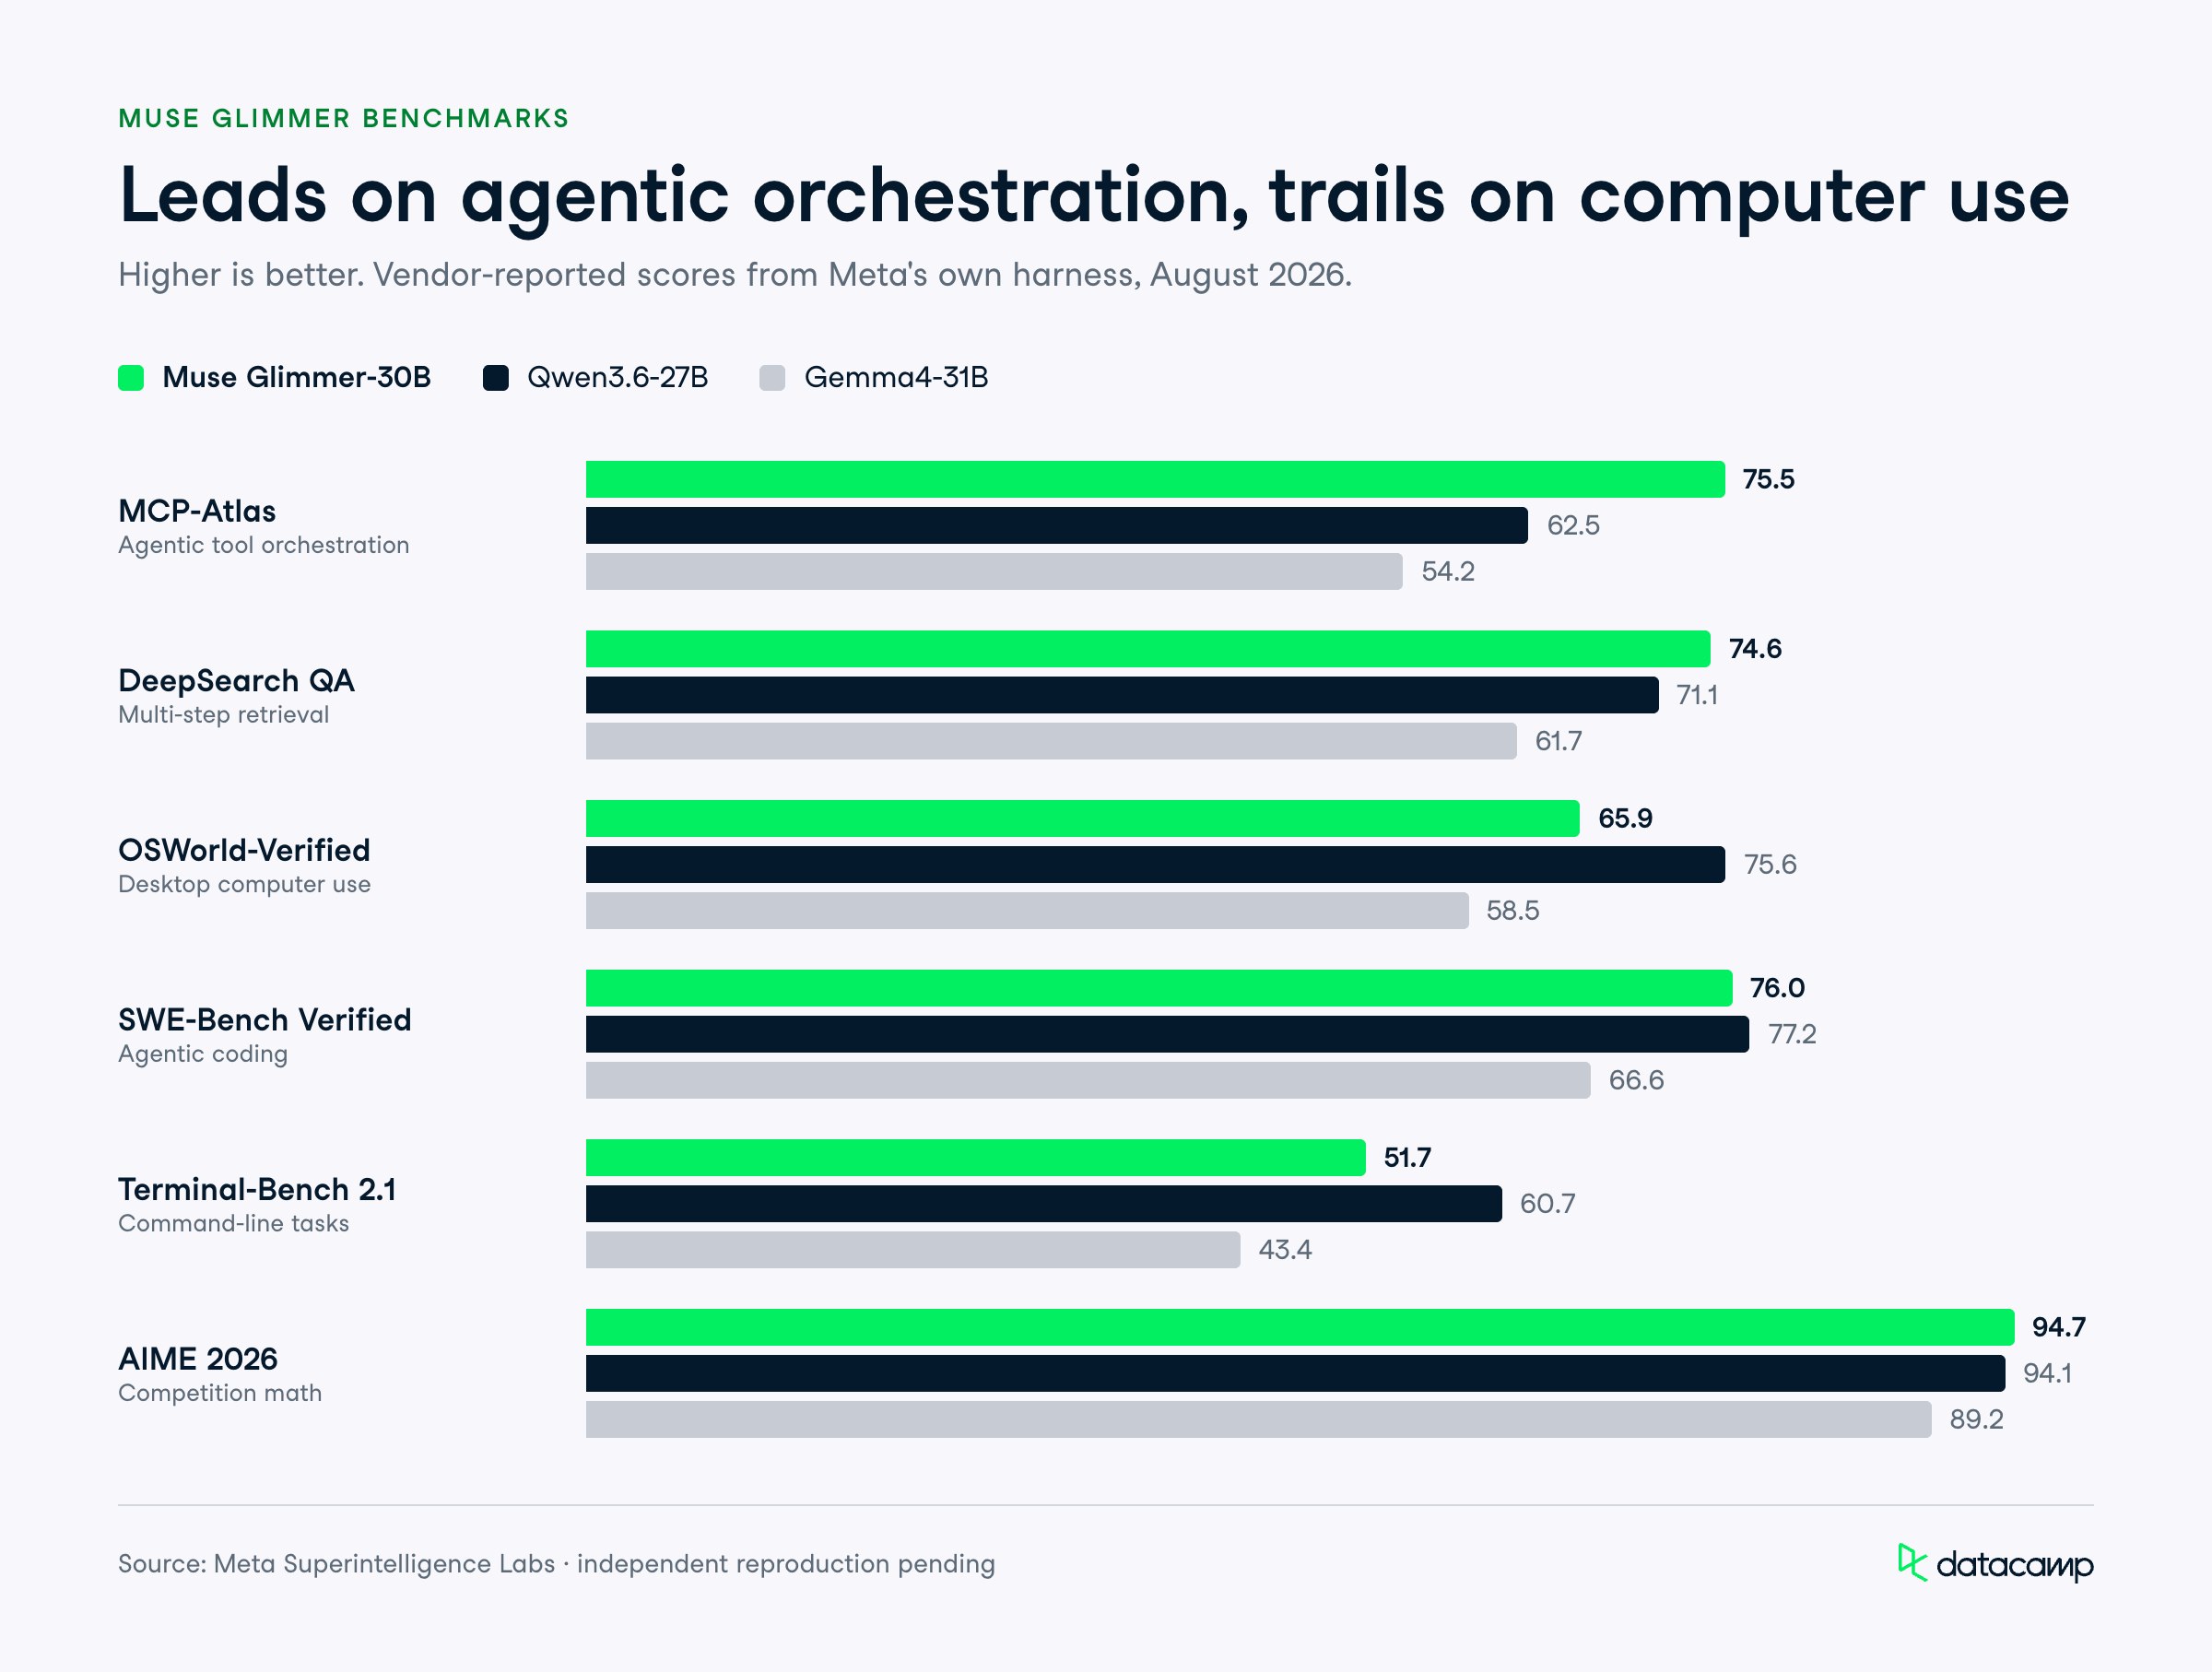
O destaque de benchmark que chama atenção é o MCP-Atlas, um benchmark agentivo geral, em que o Muse Glimmer marca 75,5 contra 62,5 do Qwen3.6-27B e 54,2 do Gemma4-31B.
Para um modelo que você pode rodar sem conexão com a internet, liderar sua faixa de tamanho em orquestração agentiva é o ponto central do lançamento.
O Muse Glimmer foi construído para rodar agentes pessoais localmente, então seus recursos se concentram em conclusão de tarefas, uso de ferramentas e responsividade em hardware limitado.
Veja as capacidades que mais importam para quem está na prática.
Você pode passar uma tarefa de múltiplas etapas para o Muse Glimmer e deixá-lo planejar, chamar ferramentas, checar seus próprios resultados e se recuperar de falhas sem conexão de rede.
Alexandr Wang, chief AI officer da Meta, disse que o modelo opera "como um agente plenamente capaz" e mantém a confiabilidade agentiva com 24 GB de VRAM.
Para quem constrói na prática, isso muda onde um agente pode viver.
Um modelo que redige seus e-mails, reorganiza seus arquivos ou gerencia sua agenda precisa de acesso profundo ao contexto pessoal — e manter esse contexto no dispositivo é uma postura de privacidade bem diferente de enviá-lo para uma API na nuvem.
O Muse Glimmer invoca ferramentas com esquemas precisos em fluxos de trabalho extensos e, quando uma chamada falha ou retorna algo inesperado, ele é treinado para diagnosticar o erro e tentar novamente em vez de parar. Esse comportamento de recuperação de falhas é a diferença entre um agente que conclui a tarefa e outro que trava no meio do caminho.
Funciona com o OpenClaw e outros padrões de orquestração agentiva, então você não fica preso a uma única estrutura.
A Meta fornece orientações na documentação para configurar estruturas personalizadas — o que importa porque a qualidade do agente muitas vezes depende mais do arcabouço ao redor do que do modelo cru.
Com um codificador de percepção dedicado, o Muse Glimmer aceita texto e imagens intercalados, permitindo que um agente interprete a captura de tela de um erro, um gráfico de vendas ou uma fatura digitalizada junto com a conversa.
É texto e imagem na entrada, e apenas texto na saída.
Há um limite real a destacar: não há entrada ou saída de áudio, e vídeo é tratado apenas como frames individuais, não como entendimento de vídeo de fato.
Se seu fluxo de trabalho precisa assistir a uma gravação de tela de ponta a ponta, este não é o modelo ideal.
O Muse Glimmer oferece diferentes níveis de raciocínio, para você equilibrar qualidade e velocidade conforme a tarefa.
Um agente para renomear arquivos rapidamente não precisa da mesma deliberação que uma sessão de depuração com várias etapas — e poder ajustar isso no dispositivo ajuda a manter a latência sob controle.
O modelo também foi treinado com dados de mais de 100 idiomas, embora a Meta alerte que ele não foi avaliado em todos e que a qualidade pode cair fora do conjunto com suporte mais forte.
A Meta avaliou o Muse Glimmer contra o Gemma4-31B e o Qwen3.6-27B em categorias de agentividade, programação, multimodalidade, segurança e raciocínio, usando seu próprio arcabouço.
Reproduções independentes não estavam disponíveis no momento da redação, então trate esses números como dados do fornecedor.
O Muse Glimmer lidera sua faixa de tamanho em benchmarks agentivos gerais, mas fica atrás do Qwen3.6-27B em várias tarefas de uso de computador e terminal.
Na tabela abaixo, você vê rapidamente como o Muse Glimmer se compara à concorrência:
| Benchmark | Muse Glimmer-30B | Qwen3.6-27B | Gemma4-31B |
|---|---|---|---|
| MCP-Atlas | 75,5 | 62,5 | 54,2 |
| DeepSearch QA | 74,6 | 71,1 | 61,7 |
| OSWorld-Verified | 65,9 | 75,6 | 58,5 |
| SWE-Bench Verified | 76,0 | 77,2 | 66,6 |
| Terminal-Bench 2.1 | 51,7 | 60,7 | 43,4 |
| AIME 2026 | 94,7 | 94,1 | 89,2 |
| GPQA Diamond | 83,5 | 84,2 | 85,7 |
| MMMU Pro | 74 | 75 | 73 |
O MCP-Atlas mede quão bem um modelo orquestra chamadas de ferramentas via Model Context Protocol, e o Muse Glimmer marca 75,5 contra 62,5 do Qwen3.6-27B e 54,2 do Gemma4-31B.
No DeepSearch QA, um benchmark para recuperação de informações em múltiplas etapas, o Muse Glimmer marca 74,6, à frente dos 71,1 do Qwen3.6-27B e bem acima dos 61,7 do Gemma4-31B.
O quadro não é uniforme. No OSWorld-Verified, que testa agentes de uso de computador em um ambiente de desktop real, o Muse Glimmer marca 65,9 enquanto o Qwen3.6-27B lidera com 75,6 — então o Qwen é a escolha mais forte para agentes que controlam a tela.
O SWE-Bench Verified mede se um modelo consegue resolver issues reais do GitHub escrevendo e depurando código.
O Muse Glimmer marca 76,0, próximo aos 77,2 do Qwen3.6-27B e à frente dos 66,6 do Gemma4-31B.
No Terminal-Bench 2.1, que testa a conclusão de tarefas em linha de comando, o Muse Glimmer fica atrás com 51,7, contra 60,7 do Qwen3.6-27B. Para referência, quando fizemos fine-tuning do Qwen3.6 no nosso próprio tutorial, vimos sua força no SWE-Bench e no Terminal-Bench se manter na prática, então a vantagem do Qwen em tarefas de terminal aqui bate com o que já observamos.
O AIME 2026 é um benchmark de matemática competitiva, e o Muse Glimmer marca 94,7, superando de leve os 94,1 do Qwen3.6-27B e deixando os 89,2 do Gemma4-31B para trás.
É um resultado forte para um modelo desse porte.
No GPQA Diamond, um conjunto de perguntas de ciências em nível de pós-graduação, o Muse Glimmer marca 83,5, enquanto o Gemma4-31B lidera com 85,7 e o Qwen3.6-27B fica com 84,2.
No Humanity's Last Exam (texto, sem ferramentas), o Muse Glimmer marca 22,0, um pouco atrás de ambos os rivais.
O MMMU Pro testa raciocínio multimodal em imagens e texto com dificuldade de pós-graduação, e os três modelos ficam praticamente empatados: Muse Glimmer 74, Qwen3.6-27B 75, Gemma4-31B 73.
No Charxiv Reasoning, que testa interpretação de gráficos, o Muse Glimmer marca 78,8, ligeiramente à frente dos dois concorrentes.
A própria alegação de força da Meta no ScreenSpot Pro não se sustenta totalmente: o Muse Glimmer marca 75,4 enquanto o Qwen3.6-27B lidera com 76,1.
A categoria multimodal é tão equilibrada que provavelmente não será o fator decisivo entre esses modelos.
No CI Memories, que mede a taxa de violação de privacidade (quanto menor, melhor), o Muse Glimmer registra 26,4, contra 12,1 bem mais limpos do Gemma4-31B e 53,4 do Qwen3.6-27B.
Assim, o Muse Glimmer fica entre os rivais aqui — mais seguro que o Qwen, mas bem atrás do Gemma nessa métrica.
No Siren AgentDojo, que mede a resistência a ataques de prompt injection, o Muse Glimmer apresenta 28,4 de taxa de sucesso de ataque com 94,2 de utilidade, comparado a 25,6 do Gemma4-31B e 40,3 do Qwen3.6-27B. Se você vai implantar um agente que toca conteúdo não confiável, essa resistência a injeção merece peso.
O Muse Glimmer é distribuído como pesos abertos sob a Apache 2.0, e não há API oficial hospedada pela Meta.
Isso significa que não há preços por token da Meta a reportar: seu custo é infraestrutura e self-hosting, não uma taxa de API medida.
Você pode começar por vários caminhos:
A Meta está trabalhando com AMD, Arm, Dell, Intel e NVIDIA para ajustar performance em diferentes dispositivos.
O alvo prático de hardware é uma máquina com 24 GB ou 32 GB: a Meta relata que a build K-Quant-17GB mais o drafter quantizado DFlash aceleram a decodificação em 3,1x na RTX 5090, 1,8x no M5 Max e 1,5x no M4 Max.
O Muse Glimmer mostra a aposta deliberada da Meta em agentes locais, privados e com pesos abertos — em vez de mais um carro-chefe na nuvem.
Ao limitar para 30B e entregar pesos quantizados que cabem em uma única GPU de consumidor, a Meta mira um nicho que a maioria dos labs ignora: desenvolvedores que querem um agente offline com contexto pessoal que nunca sai do dispositivo.
Minha leitura honesta é que isso é um stack para builders, não um substituto de nuvem com um clique.
Os benchmarks são mistos (o Qwen3.6-27B ainda lidera no OSWorld-Verified e no Terminal-Bench 2.1, e o Gemma4-31B é mais limpo no CI Memories), e avaliadores chamaram o Muse Glimmer de lento e frágil próximo ao limite de memória. Mas, ao liderar sua faixa de tamanho no MCP-Atlas e no DeepSearch QA, com uma licença permissiva Apache 2.0, ele vira uma opção séria para quem está construindo agentes locais.
As ressalvas: não há áudio, vídeo só como frames, cobertura linguística irregular e benchmarks apenas do fornecedor até que cheguem reproduções independentes.
Se seu fluxo de trabalho é sensível à privacidade ou realmente precisa rodar sem rede, vale baixar o Muse Glimmer e testá-lo contra o Qwen3.6 no seu próprio hardware.
Se você quer desenvolver as habilidades para rodar e ajustar modelos como este por conta própria, eu recomendo nosso tutorial sobre como construir seu primeiro agente autônomo de IA.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
blog
Ryan Ong
8 min
blog
Josep Ferrer
8 min
blog
Khalid Abdelaty
15 min





