
{count, plural, one {Corso} other {Corsi}}
Creare agenti AI con Google ADK
{hours} ore
7.6K
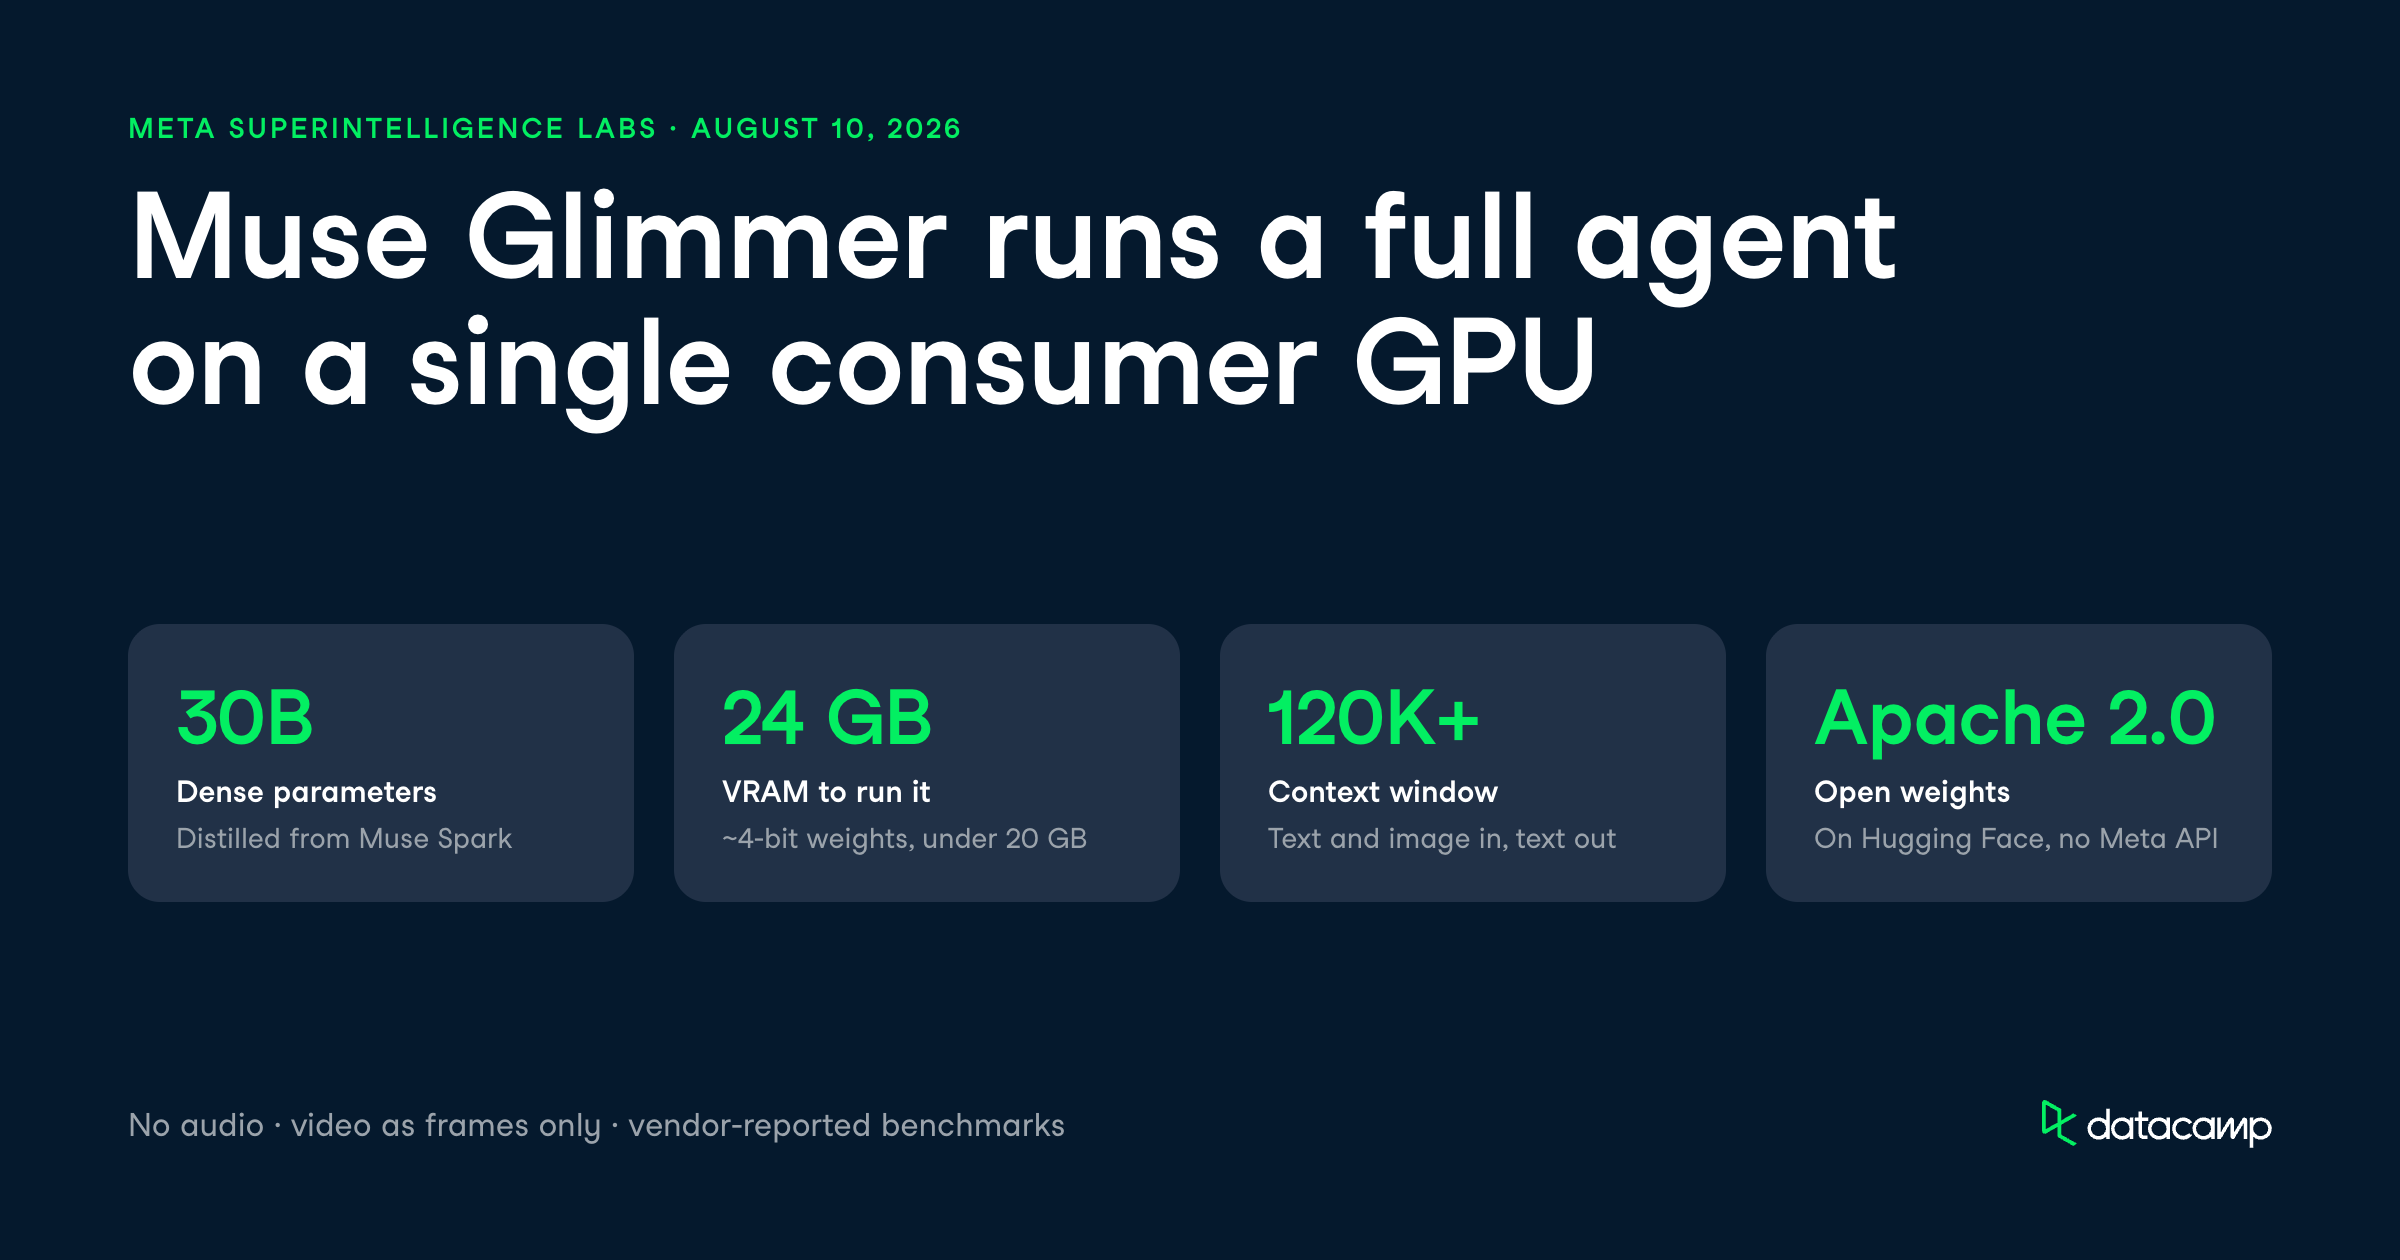
Meta Superintelligence Labs ha rilasciato Muse Glimmer il 10 agosto 2026, e la proposta è insolita per un lancio del 2026: gira su un laptop.
È un modello agentico da 30 miliardi di parametri, pensato per flussi di lavoro locali e always-on, distribuito con pesi aperti sotto licenza Apache 2.0.
La promessa principale è che Muse Glimmer funziona come un agente completo (pianificazione, chiamate agli strumenti, auto-verifica e recupero dagli errori) su una singola GPU consumer da 24 GB o su un sistema Mac con memoria unificata. Viene fornito con una finestra di contesto da oltre 120K, input multimodale testo+immagine e pesi quantizzati che riducono il modello a meno di 20 GB. Meta ha open-sourcizzato i pesi su Hugging Face insieme alla documentazione per sviluppatori.
In questo articolo vedremo tutte le novità di Muse Glimmer: le funzionalità, i benchmark rispetto a modelli come Qwen3.6-27B e Gemma4-31B, e i trucchi per il deployment locale. Puoi leggere anche la nostra guida per eseguire Muse Glimmer in locale per il coding AI.
Per saperne di più sull'esecuzione locale dei modelli in generale, dai un'occhiata ai nostri tutorial sul fine-tuning di Qwen3.6 e aggiorna le tue competenze con il nostro percorso di competenze AI Agent Fundamentals.
Muse Glimmer è un modello denso da 30 miliardi di parametri di Meta Superintelligence Labs, ottimizzato per flussi di lavoro agentici locali piuttosto che per chat in cloud.
È presentato come il fratello minore e distillato di un modello teacher interno più grande, Muse Spark, e Meta dichiara esplicitamente che Muse Glimmer non rientra nella sua definizione di "Frontier AI".
La novità qui è il target di deployment.
La maggior parte dei modelli agentici di questa capacità presuppone un datacenter alle spalle, ma Muse Glimmer è costruito per girare offline su una singola GPU consumer.
Meta ha compresso i pesi a una precisione di circa 4 bit, portando il modello linguistico sotto i 20 GB così da rientrare in un envelope di memoria da 24 GB o 32 GB lasciando anche margine.
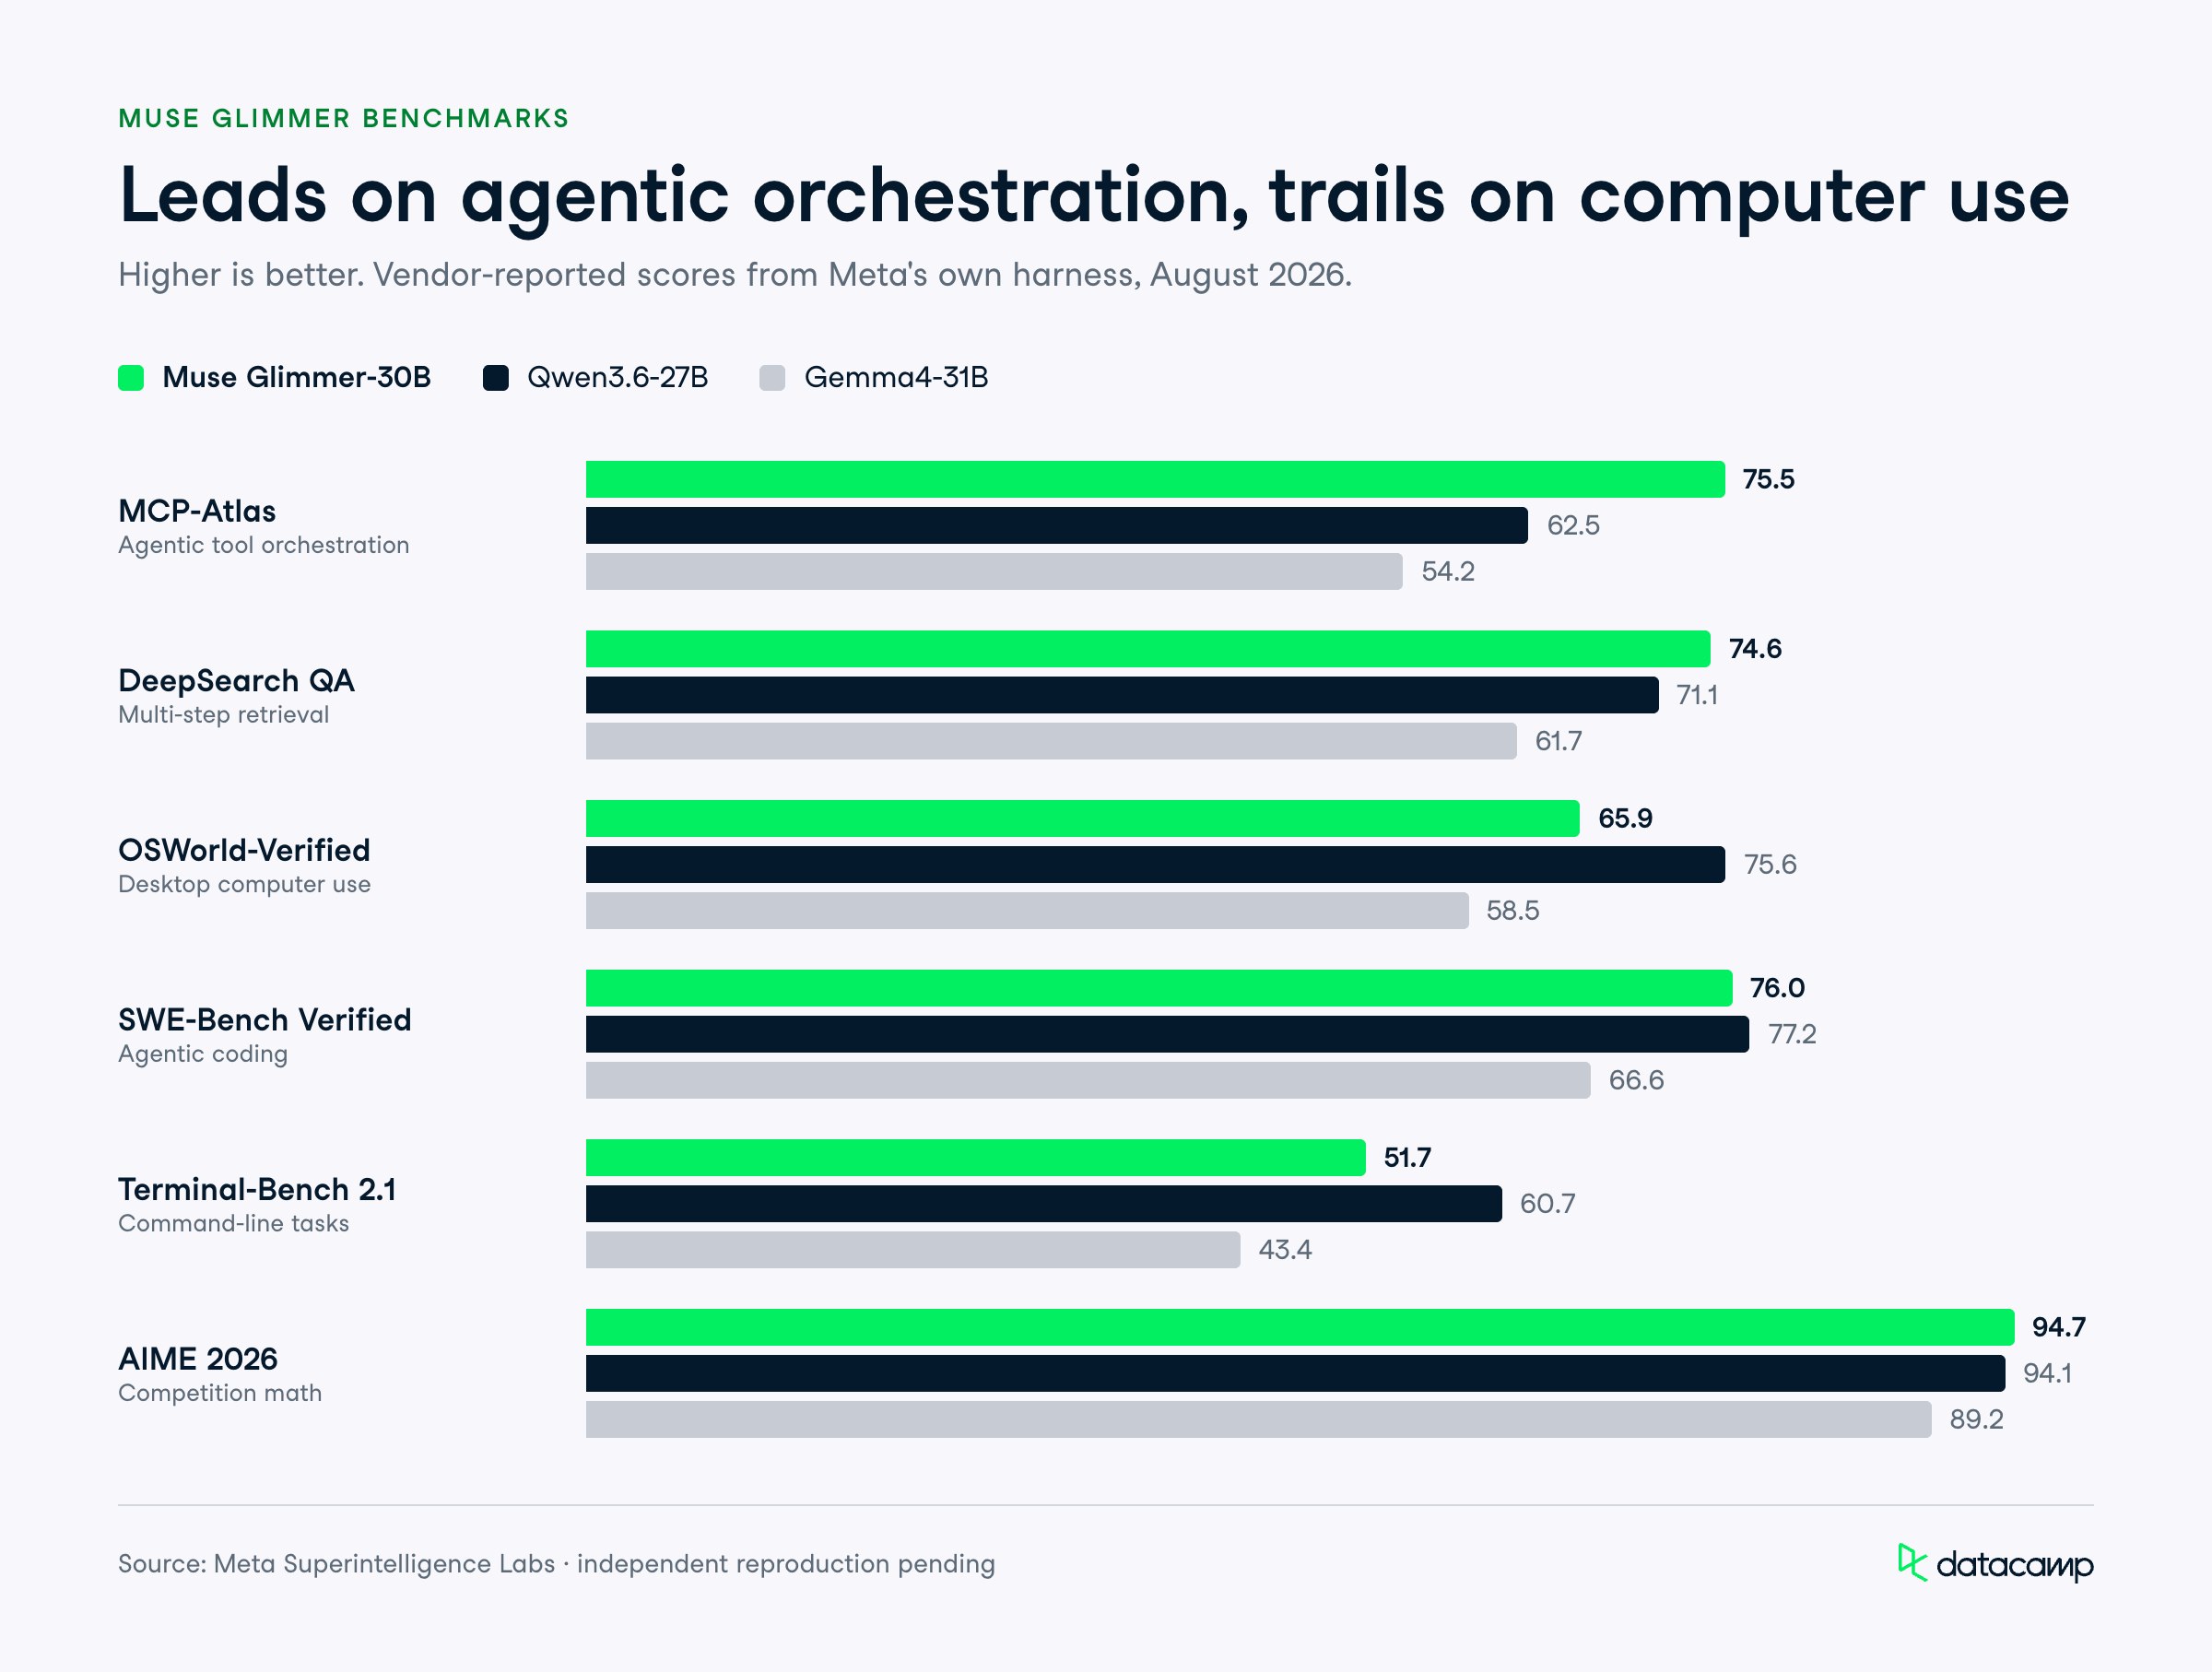
Il benchmark che spicca è MCP-Atlas, un benchmark agentico generale, dove Muse Glimmer ottiene 75,5 contro i 62,5 di Qwen3.6-27B e i 54,2 di Gemma4-31B.
Per un modello che puoi eseguire senza connessione internet, guidare la sua classe di dimensioni nell'orchestrazione agentica è il punto centrale del rilascio.
Muse Glimmer è costruito attorno all'esecuzione locale di agenti personali, quindi le sue funzionalità riguardano il completamento dei task, l'uso di strumenti e il mantenimento della reattività su hardware limitato.
Ecco le capacità che contano di più per chi lo usa sul campo.
Puoi affidare a Muse Glimmer un'attività multi-step e lasciare che pianifichi, chiami strumenti, verifichi i propri risultati e recuperi dagli errori senza connessione di rete.
Alexandr Wang, Chief AI officer di Meta, ha detto che il modello opera "come un agente pienamente capace" e mantiene l'affidabilità agentica con 24 GB di VRAM.
Per chi lo adotta in pratica, questo cambia dove può vivere un agente.
Un modello che scrive le tue email, riorganizza i file o gestisce il calendario ha bisogno di un accesso profondo al contesto personale, e mantenere quel contesto sul dispositivo è un approccio alla privacy diverso dal mandarlo a un'API cloud.
Muse Glimmer invoca strumenti con schemi precisi in flussi di lavoro estesi e, quando una chiamata fallisce o restituisce qualcosa di inatteso, è addestrato a diagnosticare l'errore e riprovare invece di bloccarsi. Questo comportamento di recupero dagli errori fa la differenza tra un agente che porta a termine un compito e uno che si ferma a metà.
Funziona su OpenClaw e altri pattern di orchestrazione agentica, quindi non sei vincolato a un unico scaffold.
Meta fornisce indicazioni su come impostare scaffold personalizzati nella documentazione, il che conta perché la qualità di un agente spesso dipende più dall'harness circostante che dal modello grezzo.
Attraverso un encoder percettivo dedicato, Muse Glimmer accetta testo e immagini intercalati, così un agente può interpretare uno screenshot di una finestra di errore, un grafico di vendita o una fattura scansionata insieme alla conversazione.
È input testo+immagine, output testo.
C'è un limite concreto da segnalare: non c'è input o output audio, e i video sono gestiti solo come frame individuali, non come vera comprensione video.
Se il tuo flusso di lavoro deve guardare un'intera registrazione dello schermo, questo non è il modello giusto.
Muse Glimmer supporta diversi livelli di ragionamento, così puoi scambiare qualità e velocità a seconda del task.
Un agente che rinomina file al volo non ha bisogno della stessa deliberazione di una sessione di debug multi-step, e poter regolare questo aspetto in locale mantiene la latenza ragionevole.
Il modello è anche addestrato su dati in oltre 100 lingue, ma Meta avverte che non è stato valutato su tutte e la qualità può calare fuori dall'insieme con supporto forte.
Meta ha valutato Muse Glimmer rispetto a Gemma4-31B e Qwen3.6-27B su categorie agentiche, coding, multimodali, sicurezza e ragionamento, usando il proprio harness.
Al momento della stesura mancavano riproduzioni indipendenti, quindi considera questi numeri come forniti dal vendor.
Muse Glimmer guida la sua classe su benchmark agentici generali ma è dietro a Qwen3.6-27B su diversi task di uso del computer e terminale.
Nella tabella qui sotto puoi vedere rapidamente come Muse Glimmer si confronta con la concorrenza:
| Benchmark | Muse Glimmer-30B | Qwen3.6-27B | Gemma4-31B |
|---|---|---|---|
| MCP-Atlas | 75.5 | 62.5 | 54.2 |
| DeepSearch QA | 74.6 | 71.1 | 61.7 |
| OSWorld-Verified | 65.9 | 75.6 | 58.5 |
| SWE-Bench Verified | 76.0 | 77.2 | 66.6 |
| Terminal-Bench 2.1 | 51.7 | 60.7 | 43.4 |
| AIME 2026 | 94.7 | 94.1 | 89.2 |
| GPQA Diamond | 83.5 | 84.2 | 85.7 |
| MMMU Pro | 74 | 75 | 73 |
MCP-Atlas misura quanto bene un modello orchestra chiamate agli strumenti tramite il Model Context Protocol, e Muse Glimmer ottiene 75,5 contro i 62,5 di Qwen3.6-27B e i 54,2 di Gemma4-31B.
Su DeepSearch QA, un benchmark per il recupero di informazioni multi-step, Muse Glimmer ottiene 74,6, appena sopra i 71,1 di Qwen3.6-27B e ben oltre i 61,7 di Gemma4-31B.
Il quadro non è uniforme. Su OSWorld-Verified, che testa agenti di uso del computer in un ambiente desktop reale, Muse Glimmer fa 65,9 mentre Qwen3.6-27B guida con 75,6, quindi Qwen è la scelta più forte per agenti che guidano lo schermo.
SWE-Bench Verified misura se un modello sa risolvere issue reali su GitHub scrivendo e facendo debug del codice.
Muse Glimmer ottiene 76,0, vicino ai 77,2 di Qwen3.6-27B e davanti ai 66,6 di Gemma4-31B.
Su Terminal-Bench 2.1, che testa il completamento di task da riga di comando, Muse Glimmer è indietro a 51,7 contro i 60,7 di Qwen3.6-27B. Per riferimento, quando abbiamo fatto fine-tuning di Qwen3.6 nel nostro tutorial, abbiamo riscontrato che la sua forza su SWE-bench e Terminal-Bench si conferma nella pratica, quindi il vantaggio di Qwen sui task da terminale qui è in linea con quanto abbiamo visto.
AIME 2026 è un benchmark di matematica da competizione, e Muse Glimmer ottiene 94,7, superando di poco i 94,1 di Qwen3.6-27B e battendo gli 89,2 di Gemma4-31B.
È un risultato forte per un modello così piccolo.
Su GPQA Diamond, un set di domande di scienze a livello graduate, Muse Glimmer ottiene 83,5 mentre guida Gemma4-31B con 85,7, e Qwen3.6-27B è a 84,2.
Su Humanity's Last Exam (testo, senza strumenti), Muse Glimmer ottiene 22,0, leggermente dietro a entrambi i rivali.
MMMU Pro testa il ragionamento multimodale tra immagini e testo a difficoltà graduate, e i tre modelli sono quasi identici: Muse Glimmer 74, Qwen3.6-27B 75, Gemma4-31B 73.
Su Charxiv Reasoning, che testa l'interpretazione dei grafici, Muse Glimmer ottiene 78,8, leggermente davanti a entrambi i rivali.
La dichiarazione di forza di Meta su ScreenSpot Pro non regge del tutto: Muse Glimmer fa 75,4 mentre Qwen3.6-27B guida a 76,1.
La categoria multimodale è abbastanza vicina da non essere il fattore decisivo tra questi modelli.
Su CI Memories, che misura il tasso di violazioni della privacy (più basso è meglio), Muse Glimmer registra un 26,4 contro il 12,1, molto più pulito, di Gemma4-31B e il 53,4 di Qwen3.6-27B.
Quindi qui Muse Glimmer si colloca tra i rivali: più sicuro di Qwen ma ben dietro a Gemma su questa metrica.
Su Siren AgentDojo, che misura la resistenza agli attacchi di prompt injection, Muse Glimmer mostra un tasso di successo degli attacchi del 28,4 con utilità 94,2, rispetto ai 25,6 di Gemma4-31B e ai 40,3 di Qwen3.6-27B. Se stai distribuendo un agente che tocca contenuti non affidabili, vale la pena considerare quella resistenza alle injection.
Muse Glimmer è distribuito come pesi aperti sotto Apache 2.0, e non esiste un'API first-party ospitata da Meta.
Questo significa che non ci sono prezzi per token da riportare da parte di Meta: il tuo costo è l'infrastruttura e il self-hosting, non una tariffa a consumo per API.
Puoi iniziare in vari modi:
Meta sta collaborando con AMD, Arm, Dell, Intel e NVIDIA per ottimizzare le prestazioni sui vari dispositivi.
Il target hardware pratico è una macchina da 24 GB o 32 GB: Meta riporta che la build K-Quant-17GB più il drafter quantizzato DFlash velocizza il decoding di 3,1x su una RTX 5090, 1,8x su un M5 Max e 1,5x su un M4 Max.
Muse Glimmer rappresenta la scelta deliberata di Meta per agenti locali, privati e open-weight, invece di un'altra punta di diamante in cloud.
Limitandolo a 30B e distribuendo pesi quantizzati che entrano in una singola GPU consumer, Meta punta a una nicchia che la maggior parte dei lab ignora: sviluppatori che vogliono un agente offline con contesto personale che non lascia mai il dispositivo.
La mia lettura onesta è che questo è uno stack per builder, non un sostituto cloud one-click.
La storia dei benchmark è mista (Qwen3.6-27B resta davanti su OSWorld-Verified e Terminal-Bench 2.1, e Gemma4-31B è più pulito su CI Memories), e i reviewer hanno definito Muse Glimmer lento e fragile vicino al limite di memoria. Ma guidare la sua classe su MCP-Atlas e DeepSearch QA, con una licenza permissiva Apache 2.0, lo rende un'opzione seria per chiunque costruisca agenti locali.
I caveat sono: niente audio, video solo come frame, copertura linguistica irregolare e benchmark solo del vendor finché non arrivano riproduzioni indipendenti.
Se il tuo flusso di lavoro è sensibile alla privacy o deve davvero girare senza rete, vale la pena scaricare Muse Glimmer e testarlo contro Qwen3.6 sull'hardware che hai.
Se vuoi costruire le competenze per eseguire e ottimizzare modelli come questo in autonomia, ti consiglio il nostro tutorial su come costruire il tuo primo agente AI autonomo.
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



