
Kurs
KI-gestütztes Programmieren für Entwickler
1 Std. 30 Min.
11.1K
Nur wenige Stunden nachdem Google Gemini 3.8 Flash vorgestellt hat, bringt Meta Muse Spark 1.3, ein Update der Flaggschiff-Modellfamilie mit klarem Fokus auf agentische Workflows und Coding.
Der Launch trifft auf ein dicht besetztes Feld, in dem OpenAIs GPT-5.6 Sol, Anthropics Claude Opus 5 und xAIs Grok 4.6 um die gleiche Entwickleraufmerksamkeit konkurrieren.
Muse Spark 1.3 rollt in Muse Code und der Meta Model API aus und behält ein Kontextfenster von 1M Tokens.
In Vergleichen von Meta-Teams nutzte das Modell rund 20% weniger Tool-Aufrufe und 25% weniger Tokens als Muse Spark 1.2, und Artificial Analysis bewertete die xhigh-Variante mit Intelligence Index 61 bei einer Ausgabegeschwindigkeit von 182 Tokens/Sek.
In diesem Artikel zeige ich alles Neue in Muse Spark 1.3: agentische und Coding-Features, Benchmarks und Preise.
Für Vergleiche mit der Konkurrenz empfehlen wir unsere Guides zu GPT-5.6 Terra vs Claude Sonnet 5 und Claude Opus 5 vs Claude Sonnet 5. Außerdem lesenswert: unser Guide zu Metas Muse Agent.
Muse Spark 1.3 ist Metas aktuelles Flaggschiffmodell, konzipiert als inkrementelles Update gegenüber Muse Spark 1.2 statt eines kompletten Neubaus.
Es erscheint in zwei Varianten, die in der Forschung genannt werden:
Die Änderungen konzentrieren sich auf zwei Bereiche: lang andauernde agentische Arbeit und eine sauberere Coding-Performance.
Meta hat das Modell über verschiedene Harnesses trainiert, damit es auf unterschiedliche agentische Umgebungen generalisiert, und zusätzlich mehr Long-Horizon-Coding-Aufgaben einbezogen. Das Release wird als Schritt in Richtung der erklärten Vision persönlicher Superintelligenz gerahmt.
Die wichtigste Erkenntnis für mich ist die Effizienz: Muse Spark 1.3 absolvierte Ingenieursvergleiche mit etwa 20% weniger Tool-Aufrufen und 25% weniger Tokens als 1.2.
Für alle, die pro Token über die Meta Model API zahlen, bedeutet das direkte Kostensenkungen bei gleicher Arbeitslast.
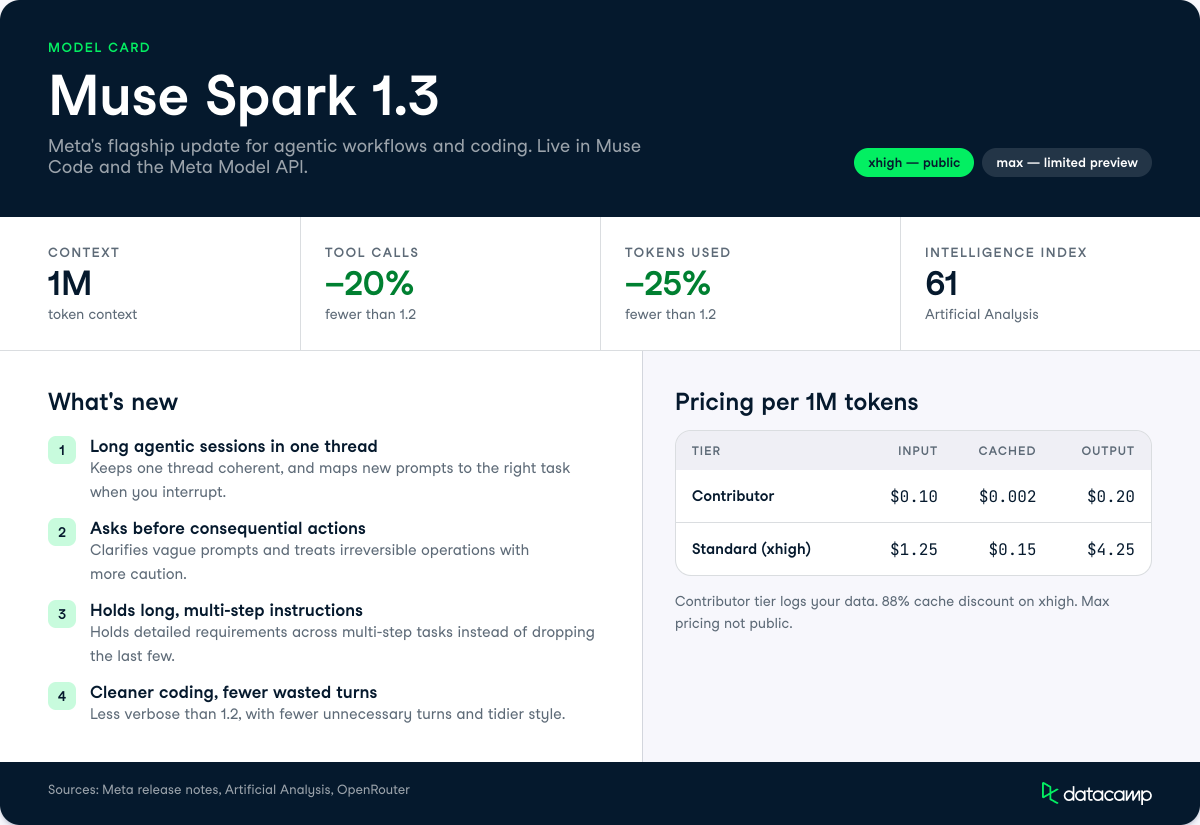
Die Updates in Muse Spark 1.3 betreffen vor allem das Verhalten in langen agentischen Sessions sowie das Schreiben und Bearbeiten von Code.
Das sind die Fähigkeiten, die für mich herausstechen.
Muse Spark 1.3 hält einen langen Thread konsistent, auch wenn mehrere Workflows parallel laufen.
Bei offenen Zielen nutzt es Tools, um aus unübersichtlichen und widersprüchlichen Quellen eigenen Kontext aufzubauen, Lücken im Plan unterwegs zu schließen und Gelerntes zu tracken, um ein finales Ergebnis zu liefern.
Meta hat außerdem das Multitasking innerhalb eines Single-Thread-Kontexts verbessert.
Das Modell ordnet eingehende Prompts der richtigen Aufgabe zu, selbst wenn du eine frühere Anfrage steuerst oder mitten im Lauf unterbrichst – genau der Fehler, der lange Agent-Sessions sonst entgleisen lässt.
Für alle, die Muse Spark regelmäßig nutzen, ist das entscheidend: Echte Agentenarbeit ist selten eine saubere Einzelanweisung. Es ist ein laufendes Gespräch, in dem du die Richtung änderst, Restriktionen ergänzt und Tasks pausierst – ein Modell, das den zugehörigen Task eines Messages verliert, ist schnell unbrauchbar.
Meta gibt an, dass Muse Spark 1.3 darauf trainiert wurde, mit dir zu arbeiten statt auf mehrdeutige Anweisungen einfach loszupreschen. Heißt: Es stellt Rückfragen bei vagen Prompts, holt dich ins Boot, wenn es festhängt, und bestätigt vor folgenreichen Aktionen.
Bei langen Tasks passt es sich deinem Update-Bedarf an. Du kannst dir häufige Statusmeldungen geben lassen oder es still im Hintergrund arbeiten lassen, bis ein Ergebnis vorliegt – ideal, wenn du Tasks anstößt und später zurückkehrst.
Meta hat außerdem die Kalibrierung für irreversible Aktionen verbessert, sodass destruktive Operationen vorsichtiger behandelt werden als reversible.
Das ist ein sinnvolles Sicherheitsventil für Agenten, die Dateien anfassen, Nachrichten senden oder Shell-Kommandos ausführen.
Muse Spark 1.3 befolgt komplexe, ausführliche Anweisungen zuverlässiger als frühere Muse-Spark-Versionen.
Über mehrstufige Tasks hinweg meldet Meta, dass detaillierte Anforderungen besser beibehalten werden, ohne Restriktionen zu verlieren oder vom gewünschten Workflow abzuweichen.
Beispiel: Erstelle einen Compliance-Report, ziehe Zahlen aus einer angehängten Tabelle, formatiere die Werte in zwei Tabellen, exportiere als PDF und gliedere das Dokument unter sechs benannten Überschriften. Frühere Modelle erledigen oft die ersten drei Punkte und vergessen die letzten zwei stillschweigend.
Das Modell kennt zudem seine eigenen Grenzen besser.
Meta hat es darauf trainiert zu erkennen, wann es ansteht, und das auch zu sagen – statt ein Ergebnis zu halluzinieren, nur um vollständig zu wirken. Wie oft das greift, wird in der Forschung allerdings nicht quantifiziert.
Muse Spark 1.3 wurde auf mehr Long-Horizon-Coding-Aufgaben trainiert und verhält sich in gängigen Engineering-Workflows besser.
Im Vergleich zu Muse Spark 1.2 braucht es laut Meta weniger unnötige Turns, ist weniger wortreich und produziert einen saubereren Coding-Stil.
Die Effizienzgewinne sind greifbar: In Vergleichen von Meta-Teams nutzte Muse Spark 1.3 etwa 20% weniger Tool-Aufrufe und 25% weniger Tokens als 1.2.
Weniger Tool-Aufrufe bedeuten weniger Roundtrips und geringere Latenz bei agentischem Coding, und weniger Tokens senken die Kosten pro abgeschlossenem Task.
Ein Vorbehalt aus der Community: Einige Reddit-User fanden das Modell frustrierend, weil es seinen Denkprozess nicht offenlegt. Das erschwert das Debugging von Coding-Entscheidungen gegenüber Modellen mit sichtbaren Reasoning-Traces.
Meta veröffentlichte im Release von Muse Spark 1.3 Benchmarks in drei Kategorien: Agent-Tasks, Long-Context-Retrieval und Coding.
Die folgenden Ergebnisse vergleichen die Max-Variante mit Muse Spark 1.2 xhigh, GPT-5.6 Sol (max) und Claude Opus 5 (max).
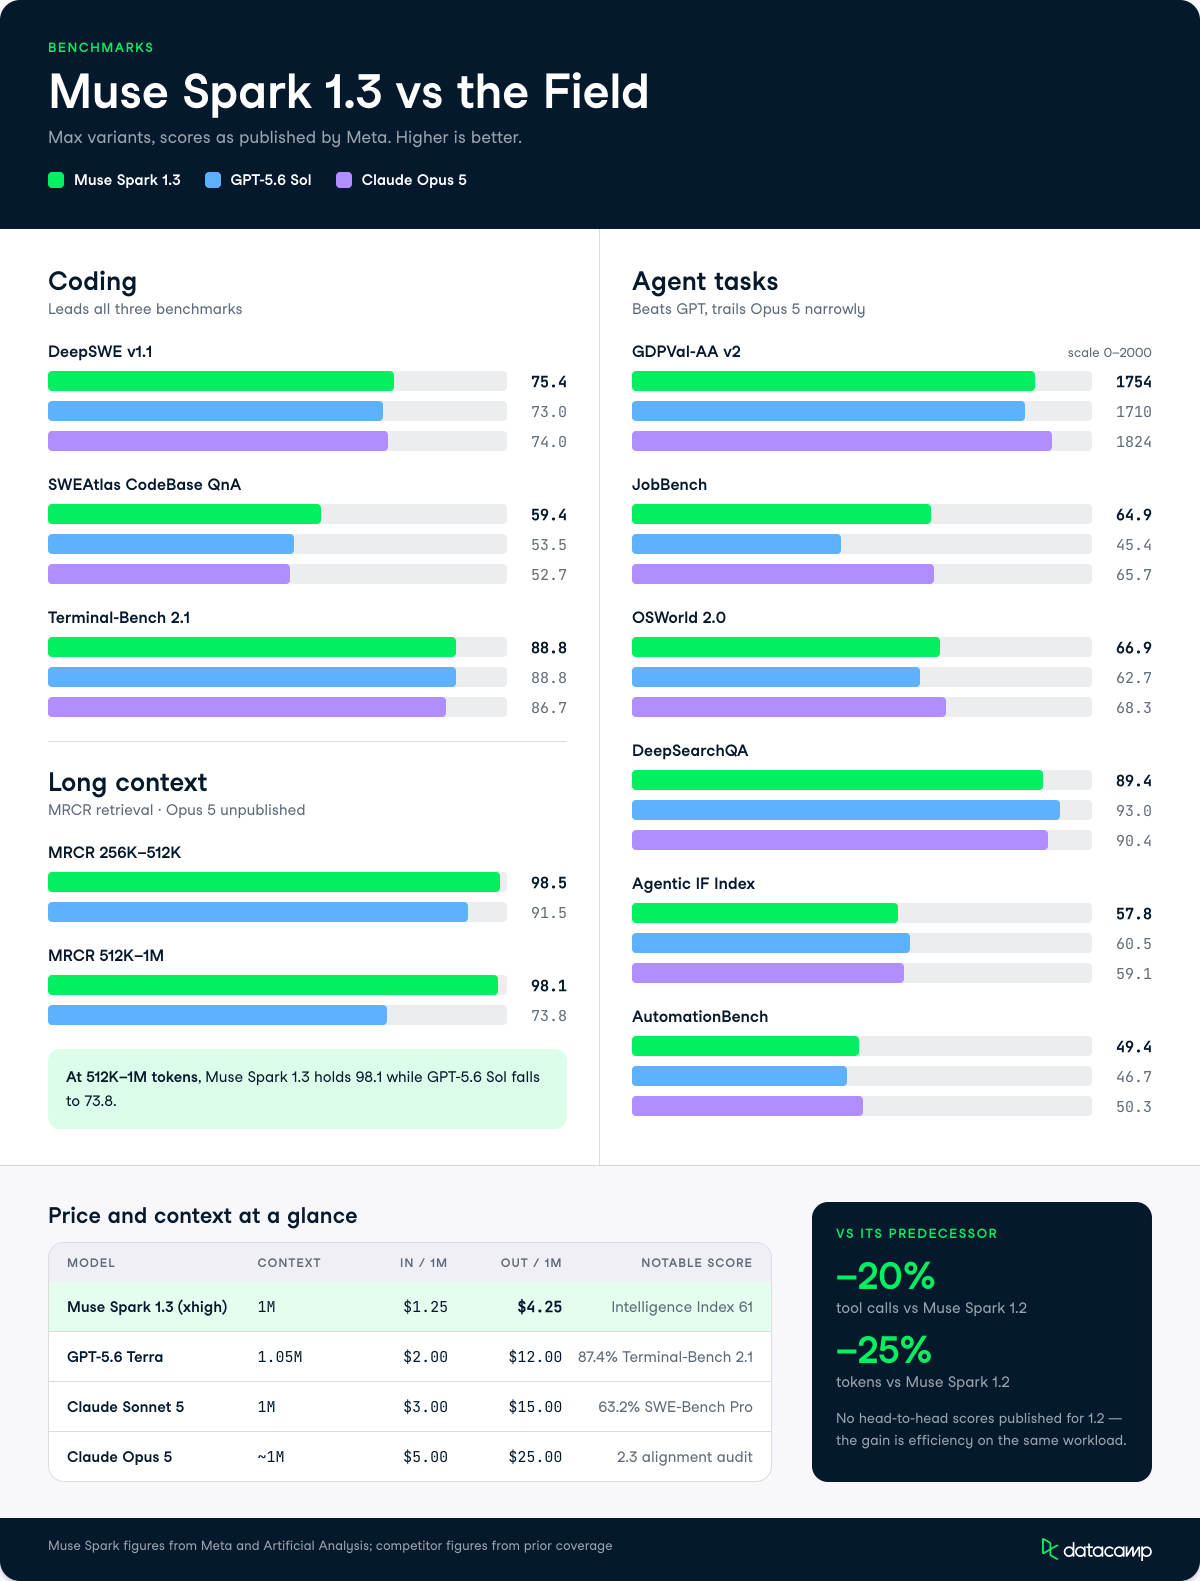
Beim Coding macht Muse Spark 1.3 den stärksten Punkt. Es führt alle drei Benchmarks an, inklusive einem Gleichstand mit GPT-5.6 Sol auf Terminal-Bench 2.1.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| DeepSWE v1.1 | 75.4 | 73.0 | 74.0 |
| SWEAtlas CodeBase QnA | 59.4 | 53.5 | 52.7 |
| Terminal-Bench 2.1 | 88.8 | 88.8 | 86.7 |
Das DeepSWE-v1.1-Ergebnis (75.4) ist der Ausreißer nach oben.
Dieser Benchmark misst lang angelegte agentische Coding-Aufgaben, bei denen das Modell echte Software-Engineering-Tasks autonom erledigen muss.
Beide, Opus 5 und GPT-5.6 Sol, auf diesem Eval zu schlagen, ist für alle relevant, die Coding-Agenten bewerten.
Die SWEAtlas-Score zur Codebase-Verständnis (59.4) erzählt eine ähnliche Geschichte: Muse Spark 1.3 liest und erschließt große Codebasen hier besser als beide direkten Rivalen.
Muse Spark 1.3 liegt beim Long-Context-Retrieval deutlich vorn, besonders am oberen Ende des Kontextfensters, wo die meisten Modelle abbauen.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) |
|---|---|---|
| MRCR 256K–512K | 98.5 | 91.5 |
| MRCR 512K–1M | 98.1 | 73.8 |
Bei 512K bis 1M Tokens fällt GPT-5.6 Sol auf 73.8, während Muse Spark 1.3 bei 98.1 bleibt. Wenn du ganze Codebasen, lange Dokumentketten oder ausgedehnte Agent-Traces in einen Kontext gibst, ist das die Kategorie, die am meisten zählt. Für MRCR gibt es keine veröffentlichten Opus-5-Werte, daher ist kein direkter Drei-Wege-Vergleich möglich.
Auf Agent-Benchmarks liegt Muse Spark 1.3 zwischen GPT-5.6 Sol und Opus 5.
Es schlägt GPT in den meisten Kategorien, liegt aber knapp hinter Opus 5 über das Feld hinweg.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| GDPVal-AA v2 | 1754 | 1710 | 1824 |
| JobBench | 64.9 | 45.4 | 65.7 |
| OSWorld 2.0 | 66.9 | 62.7 | 68.3 |
| DeepSearchQA | 89.4 | 93.0 | 90.4 |
| Agentic IF Index | 57.8 | 60.5 | 59.1 |
| AutomationBench | 49.4 | 46.7 | 50.3 |
Der JobBench-Abstand zu GPT-5.6 Sol (64.9 vs 45.4) ist die größte Differenz in der Agent-Kategorie und für alle relevant, die KI in professionellen Workflows einsetzen.
DeepSearchQA ist der eine Bereich, in dem GPT-5.6 Sol vorn liegt (93.0 vs 89.4), und auch das Befolgen von Anweisungen (Agentic IF Index) ist knapp zugunsten von GPT.
Bei Computer-Nutzung (OSWorld 2.0) ist Muse Spark 1.3 mit 66.9 nah an Opus 5 (68.3) dran.
Unterm Strich führt Muse Spark 1.3 beim Coding und Long-Context-Retrieval, ist bei Agent-Tasks konkurrenzfähig und liegt bei Knowledge Work und allgemeiner Agent-Orchestrierung knapp hinter Opus 5.
Hier ein schneller Vergleich von Muse Spark 1.3 mit den Mid-Tier- und Flaggschiff-Modellen aus unseren Reviews.
Die Zahlen für Muse Spark stammen von Artificial Analysis; Wettbewerberwerte aus unserer bisherigen Berichterstattung.
| Modell | Kontext | Input / 1M | Output / 1M | Auffälliger Score |
|---|---|---|---|---|
| Muse Spark 1.3 (xhigh) | 1M | $1.25 | $4.25 | Intelligence Index 61 |
| GPT-5.6 Terra | 1.05M | $2.00 | $12.00 | 87.4% Terminal-Bench 2.1 |
| Claude Sonnet 5 | 1M | $3.00 | $15.00 | 63.2% SWE-Bench Pro |
| Claude Opus 5 | ~1M | $5.00 | $25.00 | 2.3 Alignment-Audit |
Die Preisunterschiede springen ins Auge: Die Output-Tokens von Muse Spark 1.3 kosten etwa ein Drittel von Sonnet 5 und ein Sechstel von Opus 5.
Muse Spark 1.3 ist ab sofort in Muse Code und der Meta Model API verfügbar.
Meta for Developers weist darauf hin, dass bestehende Nutzerinnen und Nutzer die Modell-ID ändern und dieselben Endpunkte, SDKs und Preise beibehalten können – das macht das Upgrade reibungslos.
Die Preise in der Meta Model API hängen vom Tier ab: ein Contributor-Tier, das deine Daten zur Verbesserung von Metas Produkten nutzt und günstiger ist, und ein Standard-Tier ohne Datennutzung.
| Tier | Kontext | Input / 1M | Gecachter Input / 1M | Output / 1M |
|---|---|---|---|---|
| Contributor (Daten werden zur Produktverbesserung genutzt) | 1M | $0.10 | $0.002 | $0.20 |
| Standard (xhigh) | 1M | $1.25 | $0.15 | $4.25 |
Artificial Analysis meldet einen Cache-Rabatt von 88% im xhigh-Tier, und OpenRouter spiegelt die $1,25 Input- / $4,25 Output-Sätze, mit Add-ons wie Websuche zu $2,50 pro 1.000 Aufrufe.
Preise für die Max-Variante waren zum Zeitpunkt der Analyse noch nicht öffentlich.
Aus der Community kommen zum Zeitpunkt des Schreibens zwei Hinweise zur Verfügbarkeit:
Muse Spark 1.3 ist ein gezieltes Update für Effizienz und Zuverlässigkeit, kein großer Fähigkeitssprung – und Meta kommuniziert das offen.
Die 20% weniger Tool-Aufrufe und 25% weniger Tokens gegenüber 1.2 sind die Kennzahlen, die für den Betrieb von Agenten in großem Umfang zählen, weil sie direkt Kosten und Latenz senken.
Wenn du bereits die Meta Model API oder Muse Code nutzt, ist das Drop-in-Upgrade mit geringerem Tokenverbrauch für mich ein klarer Gewinn.
Wenn du ein Modell frisch für produktive Agenten auswählst, würde ich die Performance im Feld und die Preisgestaltung der Max-Variante abwarten, bevor ich mich gegen eine gut dokumentierte Alternative entscheide.
Wenn du dir die Kompetenzen aufbauen willst, um Modelle wie dieses selbst zu bewerten und in deinen Workflows einzusetzen, starte mit unserem AI Agent Fundamentals Skill Track.
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Nathaniel Taylor-Leach
8 Min.
Blog
Nathaniel Taylor-Leach
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Matt Crabtree
5 Min.


