Curso
Codificação com IA para Desenvolvedores
1 h 30 min
11.1K
Algumas horas depois de o Google apresentar o Gemini 3.8 Flash, a Meta lançou o Muse Spark 1.3, uma atualização da sua família de modelos voltada diretamente para fluxos de trabalho agentic e codificação.
O lançamento chega a um cenário competitivo onde o GPT-5.6 Sol da OpenAI, o Claude Opus 5 da Anthropic e o Grok 4.6 da xAI disputam a atenção dos desenvolvedores.
O Muse Spark 1.3 está sendo disponibilizado no Muse Code e na Meta Model API, mantendo a janela de contexto de 1M tokens.
Em comparações realizadas por engenheiros da Meta, o modelo usou aproximadamente 20% menos chamadas de ferramentas e 25% menos tokens do que o Muse Spark 1.2, e a Artificial Analysis avaliou a variante xhigh com Intelligence Index 61 e velocidade de saída de 182 tokens/s.
Neste artigo, vou cobrir tudo o que há de novo no Muse Spark 1.3, analisando seus recursos para agentes e codificação, o panorama de benchmarks e os preços.
Para comparar com a concorrência, confira nossos guias GPT-5.6 Terra vs Claude Sonnet 5 e Claude Opus 5 vs Claude Sonnet 5. Recomendo também nosso guia do Muse Agent da Meta.
O Muse Spark 1.3 é o modelo principal atual da Meta, apresentado como uma atualização incremental em relação ao Muse Spark 1.2, não uma reconstrução do zero.
Ele chega em duas variantes mencionadas na pesquisa:
As mudanças se concentram em duas frentes: sustentar trabalho agentic de longo prazo e aprimorar o comportamento na escrita de código.
A Meta treinou o modelo em uma variedade de harnesses para que ele generalize em diferentes ambientes agentic, e incluiu treino em tarefas de codificação de horizonte mais longo. A empresa enquadra o lançamento como um passo rumo ao objetivo declarado de superinteligência pessoal.
Meu principal destaque neste lançamento é a eficiência: o Muse Spark 1.3 completou as comparações de engenharia com cerca de 20% menos chamadas de ferramentas e 25% menos tokens do que o 1.2.
Para quem paga por token na Meta Model API, isso reduz diretamente o custo para a mesma carga de trabalho.
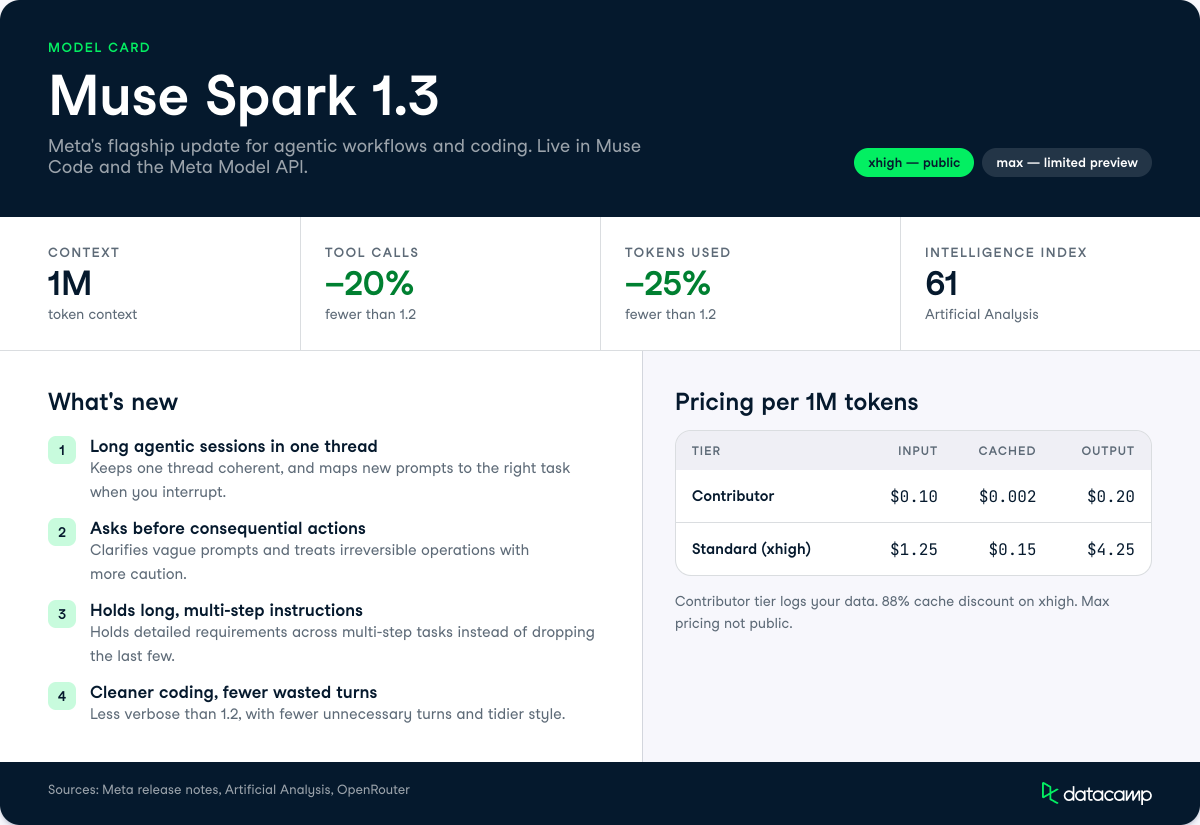
As atualizações no Muse Spark 1.3 giram em torno de como o modelo se comporta durante sessões agentic longas e de como ele escreve e edita código.
Estas são as capacidades que mais chamam atenção.
O Muse Spark 1.3 foi projetado para manter uma thread longa coerente enquanto gerencia vários fluxos de trabalho ao mesmo tempo.
Dado um objetivo aberto, ele usa ferramentas para construir seu próprio contexto a partir de fontes confusas e conflitantes, corrige lacunas no plano ao longo do caminho e acompanha o que aprendeu para entregar um resultado final.
A Meta também melhorou o multitarefa dentro de um contexto single-thread.
O modelo mapeia prompts recebidos para a tarefa correta mesmo quando você está redirecionando uma solicitação anterior ou a interrompendo no meio, que é o modo de falha que costuma descarrilar sessões longas de agentes.
Para quem usa o Muse Spark com frequência, isso importa porque a maior parte do trabalho real com agentes não é um único comando limpo. É uma conversa contínua em que você muda de ideia, adiciona restrições e pausa tarefas, e um modelo que perde a noção de qual tarefa cada mensagem pertence vira inviável rapidamente.
A Meta afirma que o Muse Spark 1.3 foi treinado para trabalhar com você, em vez de avançar sem freio diante de instruções ambíguas. Isso significa que ele faz perguntas de esclarecimento quando o prompt é vago, chama você quando fica travado e confirma antes de tomar ações com consequências relevantes.
Em tarefas longas, ele se adapta à sua preferência por atualizações. Você pode pedir que reporte com frequência ou que trabalhe silenciosamente em segundo plano até ter um resultado — útil quando você quer disparar uma tarefa e voltar depois.
A Meta também melhorou a calibração do modelo em ações irreversíveis, para que ele trate uma operação destrutiva com mais cautela do que uma reversível.
Isso pode funcionar como uma válvula de segurança importante para agentes que manipulam arquivos, enviam mensagens ou executam comandos no shell.
O Muse Spark 1.3 segue instruções complexas e extensas de forma mais confiável do que versões anteriores.
Em tarefas com várias etapas, a Meta relata que ele preserva melhor requisitos detalhados, sem perder restrições ou se desviar do fluxo de trabalho solicitado.
Considere um pedido como: redigir um relatório de compliance, puxar números de uma planilha anexada, formatar os valores em duas tabelas, exportar em PDF e organizar sob seis títulos nomeados. Modelos anteriores tendem a acertar as três primeiras exigências e esquecer silenciosamente as duas últimas.
O modelo também tem mais consciência dos próprios limites.
A Meta o treinou para reconhecer quando bate num limite e dizer isso, em vez de alucinar um resultado para parecer completo, embora a pesquisa não quantifique com que frequência isso se mantém.
O Muse Spark 1.3 foi treinado em mais tarefas de codificação de longo horizonte e se comporta melhor em fluxos de trabalho comuns de engenharia.
Em relação ao Muse Spark 1.2, a Meta diz que ele dá menos voltas desnecessárias, é menos verborrágico e produz um estilo de código mais limpo.
Os ganhos de eficiência são a parte concreta: em comparações de engenheiros da Meta, o Muse Spark 1.3 usou aproximadamente 20% menos chamadas de ferramentas e 25% menos tokens do que o 1.2.
Menos chamadas de ferramentas significam menos idas e vindas e menor latência em tarefas de codificação agentic, e menos tokens significam menor custo por tarefa concluída.
Um ponto de atenção citado por relatos na comunidade é que alguns usuários do Reddit acharam o modelo frustrante por não expor seu processo de pensamento, o que dificulta depurar decisões de código em comparação com modelos que mostram rastros de raciocínio.
A Meta publicou pontuações de benchmarks em três categorias no lançamento do Muse Spark 1.3: tarefas de agentes, recuperação de longo contexto e codificação.
Os resultados abaixo comparam a variante max com o Muse Spark 1.2 xhigh, o GPT-5.6 Sol (max) e o Claude Opus 5 (max).
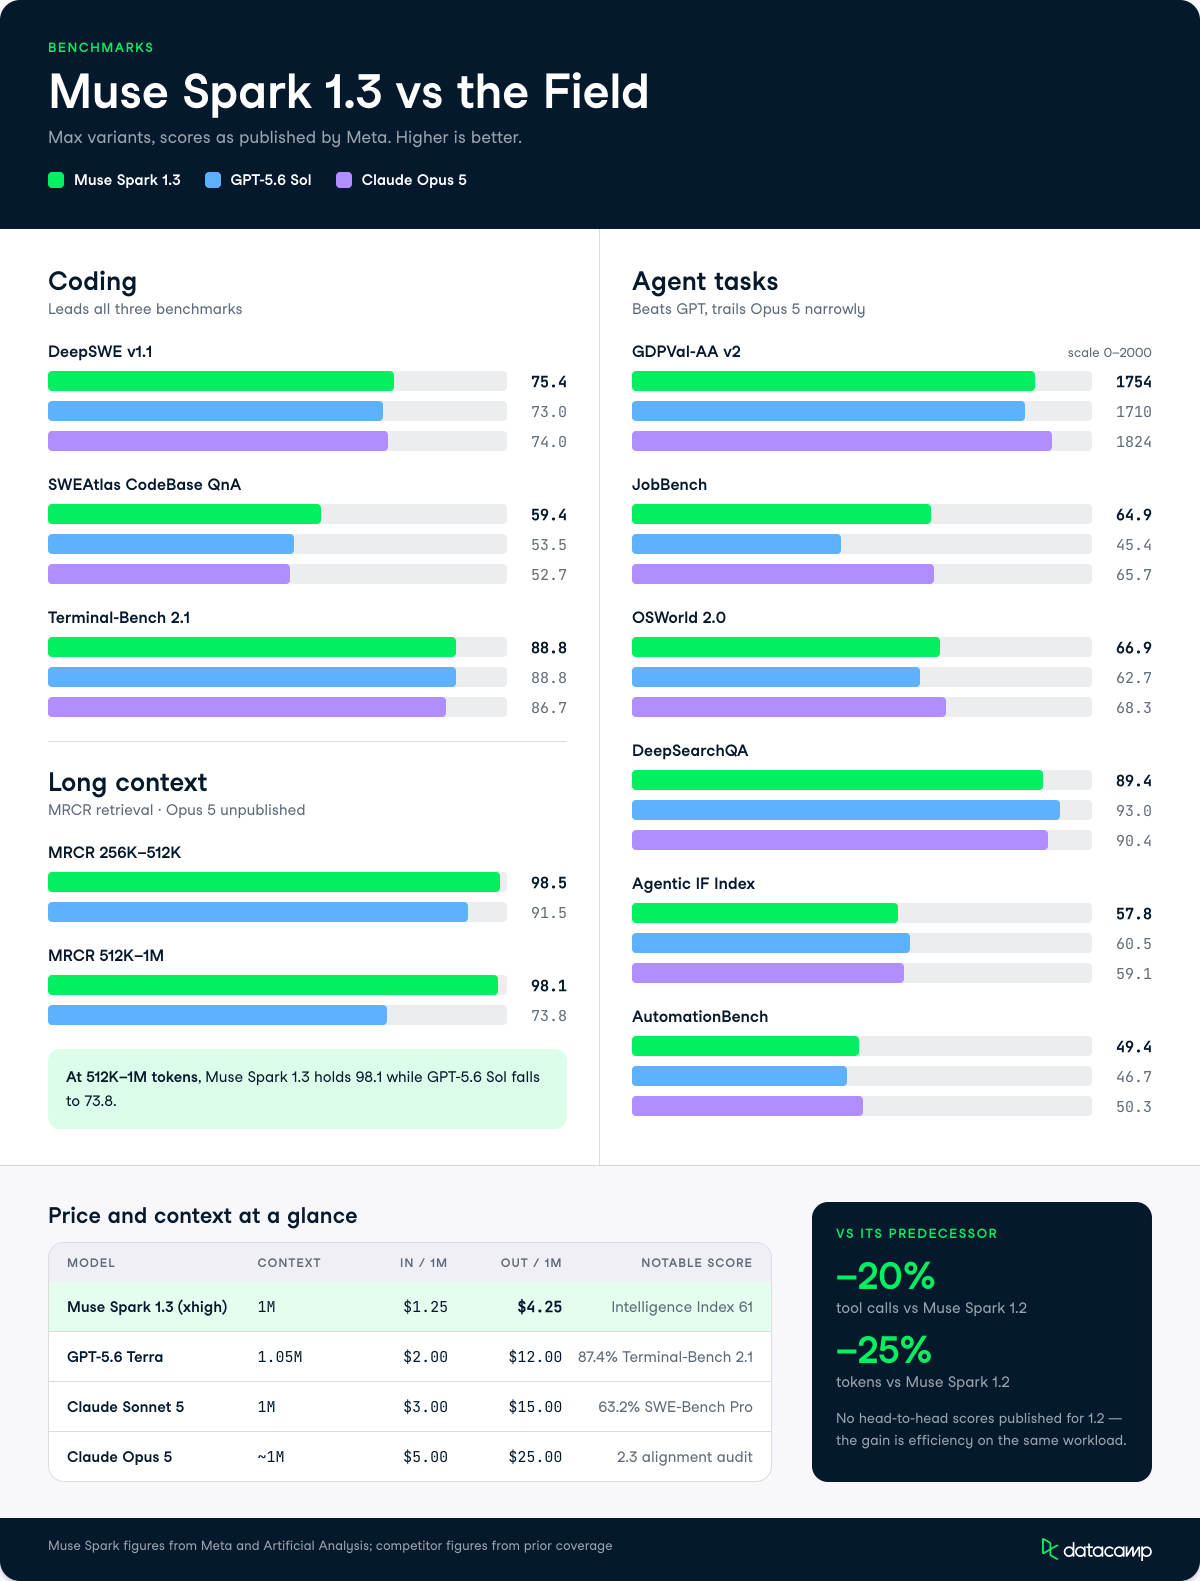
É na codificação que o Muse Spark 1.3 apresenta seu caso mais forte. Ele lidera os três benchmarks, incluindo um empate com o GPT-5.6 Sol no Terminal-Bench 2.1.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| DeepSWE v1.1 | 75.4 | 73.0 | 74.0 |
| SWEAtlas CodeBase QnA | 59.4 | 53.5 | 52.7 |
| Terminal-Bench 2.1 | 88.8 | 88.8 | 86.7 |
O resultado no DeepSWE v1.1 (75.4) é o destaque.
Esse benchmark mede codificação agentic de longo horizonte, em que o modelo precisa concluir tarefas reais de engenharia de software de forma autônoma.
Vencer o Opus 5 e o GPT-5.6 Sol nessa avaliação é significativo para quem está avaliando agentes de codificação.
A pontuação de entendimento de codebase no SWEAtlas (59.4) conta uma história semelhante: o Muse Spark 1.3 lê e raciocina sobre grandes bases de código melhor do que os dois rivais diretos aqui.
O Muse Spark 1.3 tem uma liderança clara em recuperação de longo contexto, principalmente no limite superior da janela, onde a maioria dos modelos degrada.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) |
|---|---|---|
| MRCR 256K–512K | 98.5 | 91.5 |
| MRCR 512K–1M | 98.1 | 73.8 |
Em 512K a 1M tokens, o GPT-5.6 Sol cai para 73.8 enquanto o Muse Spark 1.3 se mantém em 98.1. Se seu trabalho envolve enviar codebases inteiras, cadeias longas de documentos ou rastros extensos de agentes em um único contexto, esta é a categoria que mais importa. As pontuações do Opus 5 não foram publicadas para o MRCR, então não é possível uma comparação direta entre os três.
Em benchmarks de agentes, o Muse Spark 1.3 fica entre o GPT-5.6 Sol e o Opus 5.
Ele supera o GPT na maioria das categorias, mas fica um pouco atrás do Opus 5 no geral.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| GDPVal-AA v2 | 1754 | 1710 | 1824 |
| JobBench | 64.9 | 45.4 | 65.7 |
| OSWorld 2.0 | 66.9 | 62.7 | 68.3 |
| DeepSearchQA | 89.4 | 93.0 | 90.4 |
| Agentic IF Index | 57.8 | 60.5 | 59.1 |
| AutomationBench | 49.4 | 46.7 | 50.3 |
A diferença no JobBench em relação ao GPT-5.6 Sol (64.9 vs 45.4) é a maior margem na categoria de agentes e vale atenção para quem usa IA em fluxos de trabalho profissionais.
O DeepSearchQA é a única área em que o GPT-5.6 Sol lidera (93.0 vs 89.4), e o seguimento de instruções (Agentic IF Index) também fica ligeiramente a favor do GPT.
No uso de computador (OSWorld 2.0), o Muse Spark 1.3 é competitivo com 66.9 contra 68.3 do Opus 5.
O panorama geral: o Muse Spark 1.3 lidera em codificação e recuperação de longo contexto, é competitivo em tarefas de agentes e fica logo atrás do Opus 5 em trabalho de conhecimento e orquestração geral de agentes.
Aqui vai uma referência rápida comparando o Muse Spark 1.3 com os modelos de meio de linha e topo de linha que analisamos.
Os números do Muse Spark vêm da Artificial Analysis; os das concorrentes vêm de nossas coberturas anteriores.
| Modelo | Contexto | Entrada / 1M | Saída / 1M | Pontuação de destaque |
|---|---|---|---|---|
| Muse Spark 1.3 (xhigh) | 1M | US$ 1,25 | US$ 4,25 | Intelligence Index 61 |
| GPT-5.6 Terra | 1,05M | US$ 2,00 | US$ 12,00 | 87,4% Terminal-Bench 2.1 |
| Claude Sonnet 5 | 1M | US$ 3,00 | US$ 15,00 | 63,2% SWE-Bench Pro |
| Claude Opus 5 | ~1M | US$ 5,00 | US$ 25,00 | 2.3 alignment audit |
O diferencial de preço é evidente: os tokens de saída do Muse Spark 1.3 custam cerca de um terço dos do Sonnet 5 e um sexto dos do Opus 5.
O Muse Spark 1.3 já está disponível no Muse Code e na Meta Model API.
O Meta for Developers observou que usuários existentes podem apenas trocar o ID do modelo e manter os mesmos endpoints, SDKs e preços, o que torna a atualização praticamente sem atritos.
Os preços na Meta Model API dependem do nível, com um nível contributor que registra seus dados para melhorar os produtos da Meta a um custo menor e um nível standard que não faz esse registro.
| Nível | Contexto | Entrada / 1M | Entrada em cache / 1M | Saída / 1M |
|---|---|---|---|---|
| Contributor (dados usados para melhorar produtos) | 1M | US$ 0,10 | US$ 0,002 | US$ 0,20 |
| Standard (xhigh) | 1M | US$ 1,25 | US$ 0,15 | US$ 4,25 |
A Artificial Analysis relata um desconto de cache de 88% no nível xhigh, e o OpenRouter espelha as tarifas de US$ 1,25 na entrada / US$ 4,25 na saída, listando add-ons como busca na web a US$ 2,50 por 1.000 chamadas.
Os preços da variante max ainda não eram públicos no momento da análise do lançamento.
Há dois pontos de disponibilidade, vindos da comunidade, que valem o alerta neste momento:
O Muse Spark 1.3 é uma atualização focada em eficiência e confiabilidade, não um salto de capacidade — e a Meta é transparente sobre isso.
Os 20% a menos de chamadas de ferramentas e 25% a menos de tokens em relação ao 1.2 são os números que mais importam para quem roda agentes em escala, porque se traduzem diretamente em menor custo e latência.
Se você já usa a Meta Model API ou o Muse Code, o upgrade plug-and-play com menor uso de tokens é uma escolha fácil.
Se vai escolher um modelo do zero para agentes em produção, eu esperaria ver como ele se sai no mundo real e conhecer os preços da variante max antes de optar por ele em vez de uma alternativa bem documentada.
Se você quer desenvolver as habilidades para avaliar e usar modelos como este nos seus fluxos de trabalho, recomendo começar pela nossa trilha de habilidades AI Agent Fundamentals.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Richie Cotton
blog
Richie Cotton
7 min
blog
Matt Crabtree
12 min
blog
Abid Ali Awan
8 min
blog
Abid Ali Awan
9 min
blog
Bhavishya Pandit
7 min