Curso
Programación asistida por IA para desarrolladores
1 h 30 min
11.1K
Pocas horas después de que Google presentara Gemini 3.8 Flash, Meta ha lanzado Muse Spark 1.3, una actualización de su familia de modelos insignia dirigida de lleno a flujos agentic y a la programación.
La versión llega a un mercado muy competitivo donde GPT-5.6 Sol de OpenAI, Claude Opus 5 de Anthropic y Grok 4.6 de xAI compiten por la atención de los desarrolladores.
Muse Spark 1.3 se está desplegando en Muse Code y en la Meta Model API, manteniendo una ventana de contexto de 1M tokens.
En comparativas realizadas por ingenieros de Meta, el modelo usó aproximadamente un 20% menos de llamadas a herramientas y un 25% menos de tokens que Muse Spark 1.2, y Artificial Analysis puntuó la variante xhigh con un Intelligence Index de 61 y una velocidad de salida de 182 tokens/s.
En este artículo, repaso todo lo nuevo de Muse Spark 1.3: sus funciones para agentes y para código, los benchmarks y los precios.
Para compararlo con la competencia, echa un vistazo a nuestras guías de GPT-5.6 Terra vs Claude Sonnet 5 y Claude Opus 5 vs Claude Sonnet 5. También te recomiendo nuestra guía de Muse Agent de Meta.
Muse Spark 1.3 es el modelo insignia actual de Meta, planteado como una actualización incremental sobre Muse Spark 1.2, no una reconstrucción desde cero.
Llega en dos variantes mencionadas en la investigación:
Los cambios se centran en dos áreas: sostener trabajo agentic de largo recorrido y depurar el comportamiento al programar.
Meta entrenó el modelo en una variedad de harnesses para que generalice a distintos entornos agentic, y añadió entrenamiento en más tareas de programación de largo alcance. Enmarcan el lanzamiento como un paso hacia su objetivo declarado de superinteligencia personal.
Mi principal conclusión es la eficiencia: Muse Spark 1.3 completó las comparativas internas con ~20% menos llamadas a herramientas y ~25% menos tokens que 1.2.
Para quien paga por token en la Meta Model API, eso es una reducción directa de coste en la misma carga de trabajo.
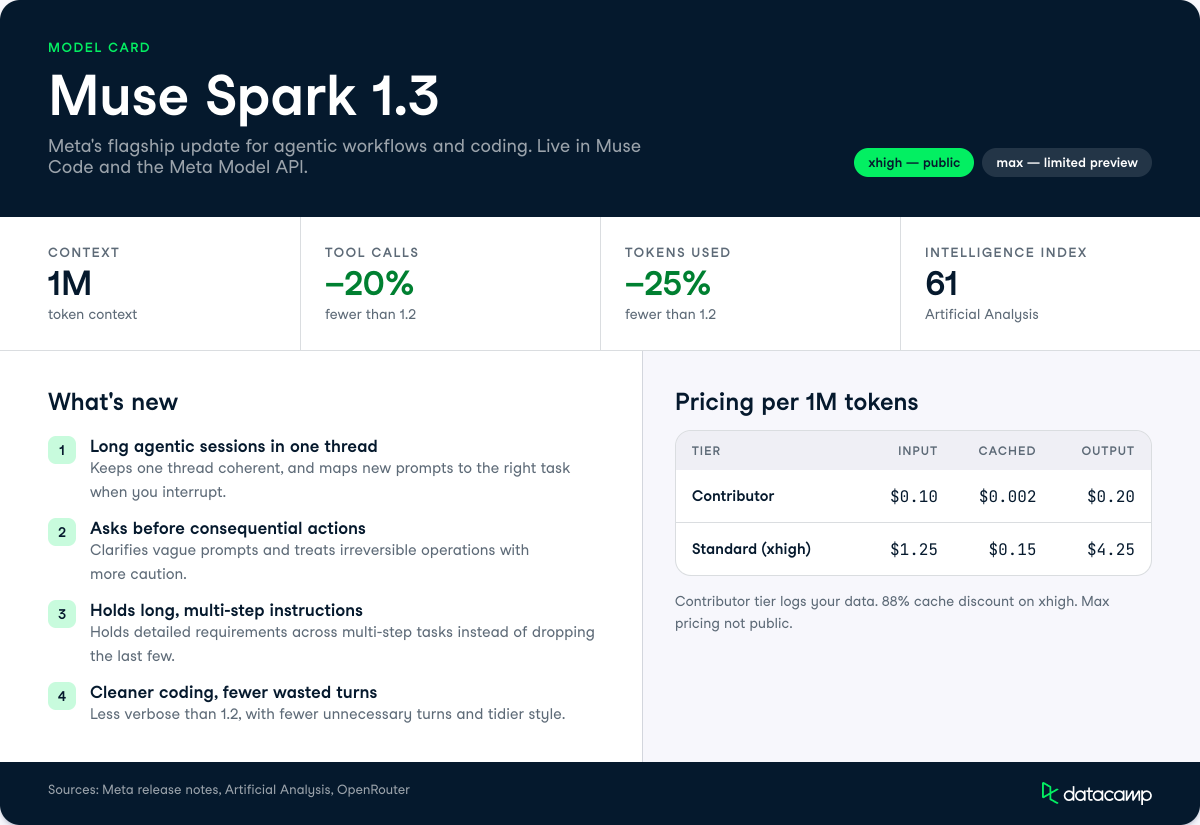
Las novedades de Muse Spark 1.3 se centran en cómo se comporta el modelo durante sesiones agentic largas y en cómo escribe y edita código.
Estas son las capacidades que más destacan.
Muse Spark 1.3 está diseñado para mantener coherente un hilo largo mientras gestiona varios flujos de trabajo a la vez.
Ante un objetivo abierto, usa herramientas para construir su propio contexto a partir de fuentes desordenadas o contradictorias, corrige lagunas sobre la marcha y registra lo aprendido para entregar un resultado final.
Meta también mejoró la multitarea dentro de un contexto monohilo.
El modelo asigna las instrucciones entrantes a la tarea correcta incluso cuando estás redirigiendo una solicitud anterior o interrumpiéndola a mitad, que suele ser el fallo que descarrila las sesiones largas con agentes.
Para quienes usan Muse Spark de forma habitual, esto importa porque la mayoría del trabajo real con agentes no es una instrucción limpia. Es una conversación en la que cambias de opinión, añades restricciones y pausas tareas, y un modelo que pierde el hilo de a qué tarea pertenece cada mensaje se vuelve inútil muy rápido.
Meta afirma que Muse Spark 1.3 se entrenó para trabajar contigo en lugar de avanzar a ciegas con instrucciones ambiguas. Es decir, hace preguntas aclaratorias si un prompt es vago, te implica cuando se atasca y confirma antes de ejecutar acciones con consecuencias.
En tareas largas, se adapta a tu preferencia de seguimiento. Puedes pedirle informes frecuentes o que trabaje en segundo plano hasta tener un resultado, útil cuando quieres lanzar una tarea y volver más tarde.
Meta también mejoró la calibración del modelo en acciones irreversibles, de modo que trata una operación destructiva con más cautela que una reversible.
Eso puede ser una válvula de seguridad relevante para agentes que manipulan archivos, envían mensajes o ejecutan comandos de shell.
Muse Spark 1.3 sigue instrucciones complejas y extensas con más fiabilidad que versiones anteriores.
En tareas de varios pasos, Meta informa de que conserva mejor los requisitos detallados sin omitir restricciones ni desviarse del flujo solicitado.
Pensemos en una petición: redactar un informe de cumplimiento, extraer cifras de una hoja de cálculo adjunta, dar formato a los números en dos tablas, exportarlo a PDF y organizarlo en seis epígrafes nominales. Los modelos anteriores suelen clavar los tres primeros requisitos y olvidarse en silencio de los dos últimos.
El modelo también es más consciente de sus propios límites.
Meta lo entrenó para reconocer cuándo choca con una pared y decirlo, en lugar de alucinar un resultado para aparentar que ha completado la tarea, aunque la investigación no cuantifica con qué frecuencia se cumple.
Muse Spark 1.3 se entrenó con más tareas de programación de largo recorrido y se comporta mejor en flujos de ingeniería comunes.
Frente a Muse Spark 1.2, Meta indica que da menos rodeos cuando no hacen falta, es menos verboso y produce un estilo de código más limpio.
Las ganancias de eficiencia son lo tangible: en comparativas internas, Muse Spark 1.3 usó aproximadamente un 20% menos llamadas a herramientas y un 25% menos tokens que 1.2.
Menos llamadas a herramientas significa menos idas y vueltas y menor latencia en tareas de programación agentic, y menos tokens se traducen en menor coste por tarea completada.
Un matiz comentado en la comunidad es que a algunos usuarios de Reddit les frustra que el modelo no exponga su proceso de pensamiento, lo que dificulta depurar sus decisiones de código frente a modelos que sí muestran trazas de razonamiento.
Meta publicó puntuaciones de benchmarks en tres categorías en el lanzamiento de Muse Spark 1.3: tareas de agente, recuperación en contexto largo y programación.
Los resultados siguientes comparan la variante max con Muse Spark 1.2 xhigh, GPT-5.6 Sol (max) y Claude Opus 5 (max).
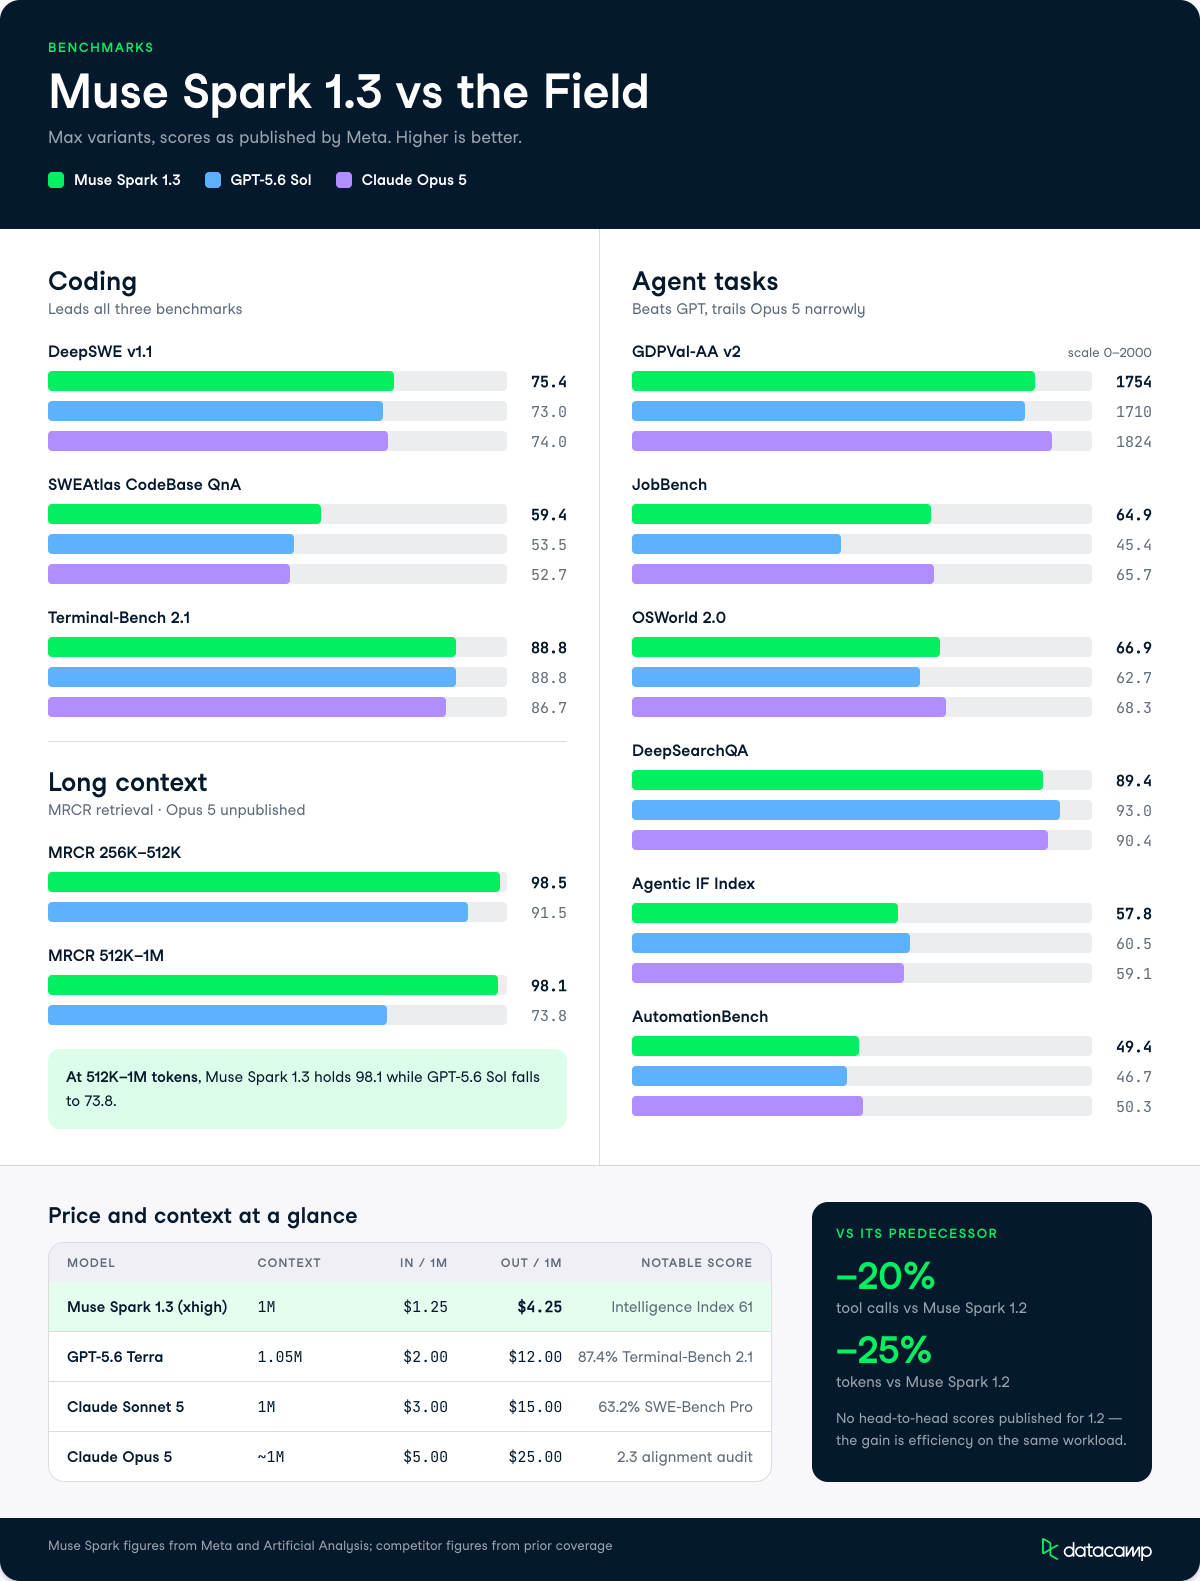
La programación es donde Muse Spark 1.3 presenta su mejor argumento. Lidera los tres benchmarks, incluido un empate con GPT-5.6 Sol en Terminal-Bench 2.1.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| DeepSWE v1.1 | 75.4 | 73.0 | 74.0 |
| SWEAtlas CodeBase QnA | 59.4 | 53.5 | 52.7 |
| Terminal-Bench 2.1 | 88.8 | 88.8 | 86.7 |
El resultado en DeepSWE v1.1 (75.4) es el más destacado.
Ese benchmark mide programación agentic de largo recorrido, donde el modelo debe completar de forma autónoma tareas reales de ingeniería de software.
Superar a Opus 5 y a GPT-5.6 Sol en esa evaluación es significativo para cualquiera que evalúe agentes de programación. T
La puntuación de comprensión de la base de código en SWEAtlas (59.4) cuenta una historia similar: Muse Spark 1.3 lee y razona sobre bases de código grandes mejor que ambos rivales directos aquí.
Muse Spark 1.3 saca ventaja clara en recuperación con contexto largo, especialmente en el extremo superior de la ventana de contexto, donde la mayoría de modelos se degradan.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) |
|---|---|---|
| MRCR 256K–512K | 98.5 | 91.5 |
| MRCR 512K–1M | 98.1 | 73.8 |
Entre 512K y 1M tokens, GPT-5.6 Sol cae a 73.8 mientras que Muse Spark 1.3 se mantiene en 98.1. Si tu trabajo implica introducir bases de código completas, cadenas largas de documentos o trazas extensas de agentes en un único contexto, esta es la categoría que más importa. No hay puntuaciones publicadas de Opus 5 para MRCR, así que no es posible una comparación directa a tres bandas aquí.
En benchmarks de agentes, Muse Spark 1.3 se sitúa entre GPT-5.6 Sol y Opus 5.
Supera a GPT en la mayoría de categorías pero queda ligeramente por detrás de Opus 5 en el global.
| Benchmark | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| GDPVal-AA v2 | 1754 | 1710 | 1824 |
| JobBench | 64.9 | 45.4 | 65.7 |
| OSWorld 2.0 | 66.9 | 62.7 | 68.3 |
| DeepSearchQA | 89.4 | 93.0 | 90.4 |
| Agentic IF Index | 57.8 | 60.5 | 59.1 |
| AutomationBench | 49.4 | 46.7 | 50.3 |
La brecha en JobBench frente a GPT-5.6 Sol (64.9 vs 45.4) es el mayor margen en la categoría de agentes y merece mención para quienes usan IA en flujos profesionales.
DeepSearchQA es el único apartado donde lidera GPT-5.6 Sol (93.0 vs 89.4), y el seguimiento de instrucciones (Agentic IF Index) también cae ligeramente del lado de GPT.
En uso de ordenador (OSWorld 2.0), Muse Spark 1.3 compite bien con 66.9 frente a 68.3 de Opus 5.
En conjunto, Muse Spark 1.3 lidera en programación y recuperación con contexto largo, compite en tareas de agente y queda justo por detrás de Opus 5 en trabajo de conocimiento y orquestación general de agentes.
Aquí tienes una referencia rápida comparando Muse Spark 1.3 con los modelos de gama media y buques insignia que hemos analizado.
Las cifras de Muse Spark proceden de Artificial Analysis; las de competidores, de nuestra cobertura previa.
| Modelo | Contexto | Entrada / 1M | Salida / 1M | Puntuación destacada |
|---|---|---|---|---|
| Muse Spark 1.3 (xhigh) | 1M | $1.25 | $4.25 | Intelligence Index 61 |
| GPT-5.6 Terra | 1.05M | $2.00 | $12.00 | 87.4% Terminal-Bench 2.1 |
| Claude Sonnet 5 | 1M | $3.00 | $15.00 | 63.2% SWE-Bench Pro |
| Claude Opus 5 | ~1M | $5.00 | $25.00 | 2.3 alignment audit |
La diferencia de precio es clara: los tokens de salida de Muse Spark 1.3 cuestan aproximadamente un tercio que los de Sonnet 5 y una sexta parte que los de Opus 5.
Muse Spark 1.3 está disponible hoy en Muse Code y en la Meta Model API.
Meta for Developers señaló que los usuarios actuales pueden cambiar el ID del modelo y mantener los mismos endpoints, SDKs y precios, lo que hace que la actualización sea muy sencilla.
El precio en la Meta Model API depende del nivel, con un nivel contributor que registra tus datos para mejorar los productos de Meta a un precio inferior y un nivel estándar que no lo hace.
| Nivel | Contexto | Entrada / 1M | Entrada en caché / 1M | Salida / 1M |
|---|---|---|---|---|
| Contributor (datos usados para mejorar productos) | 1M | $0.10 | $0.002 | $0.20 |
| Standard (xhigh) | 1M | $1.25 | $0.15 | $4.25 |
Artificial Analysis informa de un descuento del 88% por caché en el nivel xhigh, y OpenRouter refleja las tarifas de $1.25 de entrada / $4.25 de salida mientras lista complementos como búsqueda web a $2.50 por 1,000 llamadas.
El precio de la variante max no era público en el momento del análisis.
Hay dos matices de disponibilidad, según la comunidad, que conviene señalar por ahora:
Muse Spark 1.3 es una actualización orientada a eficiencia y fiabilidad más que un salto de capacidad, y Meta lo plantea así de forma transparente.
El 20% menos de llamadas a herramientas y el 25% menos de tokens frente a 1.2 son los números que más importan para quien ejecuta agentes a escala, porque se traducen directamente en menos coste y latencia.
Si ya usas la Meta Model API o Muse Code, la actualización directa con menor uso de tokens es un sí fácil.
Si estás eligiendo un modelo nuevo para agentes en producción, yo esperaría a ver su rendimiento en el mundo real y el precio de la variante max antes de comprometerme frente a alternativas bien documentadas.
Si quieres desarrollar las habilidades para evaluar y usar modelos como este en tus propios flujos, te recomiendo empezar con nuestro itinerario de aprendizaje AI Agent Fundamentals.
Los mejores cursos de DataCamp
Curso
Curso
Programa
blog
Matt Crabtree
12 min
blog
Abid Ali Awan
15 min
blog
blog
Bhavishya Pandit
7 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
11 min