
迈向高性能 pandas 代码的愿景
pandas 的问题
pandas 是 Python 中最受欢迎的数据处理包,上月下载量达 1.44 亿。pandas 之所以广受欢迎,很大程度上得益于其易用性以及覆盖广泛的数据处理功能。
不幸的是,pandas 的开发历史悠久——它在 2011 年首次公开发布——这意味着它早于许多高性能计算(HPC)的创新出现。因此,pandas 代码在处理大型数据集时往往过于缓慢,难以实用。
让 pandas 更快的诸多尝试
业界已经进行了许多尝试来解决这一问题。目标是在保持与数百万用户熟悉的 pandas 代码一致的同时,让其运行得更快。一些高性能的 pandas 替代方案包括:Polars,通过用 Rust 重写后端来提速;PySpark,为 Spark HPC 平台提供 Python 接口;Vaex,利用内存外计算;以及 DuckDB,在为分析优化的数据库中执行计算。
想更深入了解这些替代方案,请参阅以下教程:
NVIDIA 的加速 pandas 方案
NVIDIA 正在开发一套名为 RAPIDS 的高性能数据科学工具。这一工具箱包含 cuDF,即 NVIDIA 面向高性能 pandas 代码的 Python 包。(其名称结合了 CUDA——NVIDIA 的 GPU 应用底层工具包——与 DataFrame,即 pandas 中用于存储分析数据的对象;后者也启发了 DataCamp 播客 DataFramed 的命名。)
cuDF 加速数据处理代码的诀窍在于让代码在 GPU 而非 CPU 上运行。尽管 GPU 最初是为图形显示而设计,但在数据科学计算方面也极为高效。
cuDF 存在的问题
尽管 cuDF 在让您更快运行 pandas 代码方面颇为成功,但仍有若干问题阻碍了其广泛采用。
并非完全支持 pandas
一个重大障碍在于 cuDF 仅实现了约 60% 的 Pandas API。也就是说,只有大约 60% 的 pandas 代码可以在 cuDF 中运行。能运行的这 60% 自然是大多数人最常用的部分,这意味着日常分析中,cuDF 通常足够。然而,一旦您想做些不那么常规的操作,就可能在 cuDF 中遇到问题。
开发与测试需要 GPU
cuDF 仅支持在 GPU 上执行代码。这意味着无论开发还是测试都需要 GPU。如果您希望在本地笔记本电脑上运行代码,这往往难以实现;而在云端运行则可能成本高昂。
与其他 Python 包交互需要在处理器间切换
另一个问题是,绝大多数 Python 包并未启用 GPU。这意味着对于任何使用其他包的分析——例如几乎所有机器学习工作流——您都需要考虑如何在 GPU 与 CPU 之间来回迁移计算。
缺乏 GPU 时的现有解决方案很繁琐
上述三点综合起来,往往意味着您需要编写两版代码:一版在可用 GPU 且 cuDF 可完成全部计算时运行;另一版则用于无 GPU 的情形。
大多数数据科学家更愿意专注于从数据中获得洞见,而非这些代码细节。历史上,这使得在许多数据科学任务中使用 cuDF 并不理想。
pandas 加速模式如何改进 cuDF
pandas 加速模式为上述问题提供的解决方案是:您只需写一行代码即可启用 GPU 支持,随后即可照常编写标准 pandas 代码。
当支持在 GPU 上计算时(即存在 NVIDIA GPU,且 cuDF 知道如何运行该 pandas 代码),您的代码将运行在 GPU 上。在无法做到时,cuDF 会自动切换到 CPU 执行。您无需编写两版代码,也不用手动处理 GPU 与 CPU 之间的切换。
pandas 加速模式是否比替代方案更快?
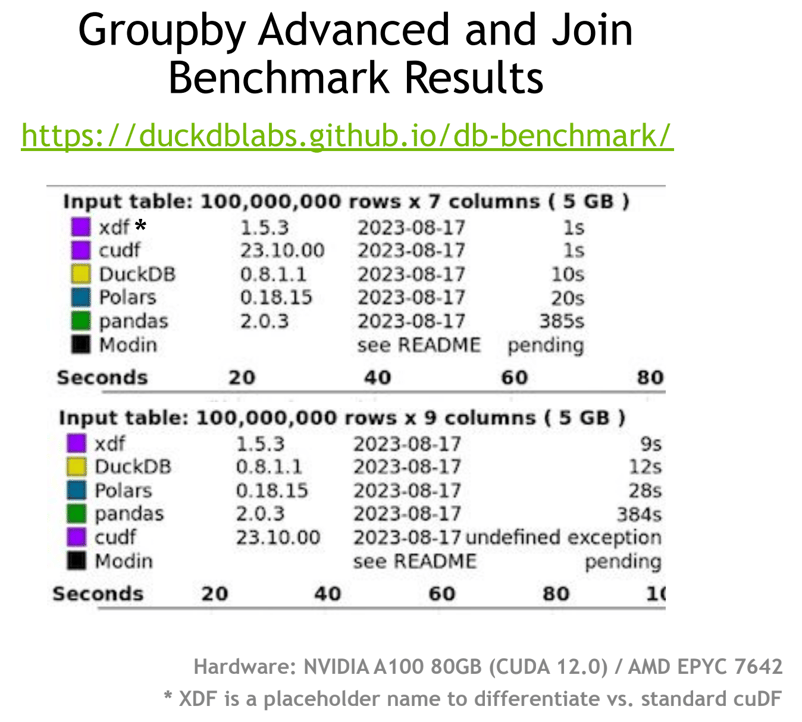
图片版权归 NVIDIA 所有。
NVIDIA 在 DuckDB 类数据库操作基准上,将 pandas 加速模式与其他高性能 Python 数据处理工具进行了对比测试。该组数据处理挑战衡量一项技术在大数据集上执行分组汇总统计、表连接等任务的能力。
据 NVIDIA 称,pandas 加速模式(图中标记为 xdf)在该基准中名列第一。值得注意的是,当前标准版 cuDF 在连接测试中会失败,因为它无法在 GPU 上完成所有所需操作。(您需要将 cuDF 与其他工具混合使用才能全部跑通。)
需要注意的是,NVIDIA 使用的是高端的 NVIDIA A100 80GB GPU,且所用 CPU 未做说明。您的性能表现会因硬件配置、数据集以及要执行的计算而异。
我如何使用 pandas 加速模式?
下面看看如何在 pandas 中开始使用加速模式:
如何安装最新的 cuDF
包含 pandas 加速模式的最新 cuDF 版本称为 cudf-cu11。它可通过标准的 pip 安装,不过目前需要从 NVIDIA 的 PyPi 仓库获取。
运行以下代码安装该包。
pip install cudf-cu11 index-url=https://pypi.nvidia.com如果您在 Juypter 笔记本中运行,请在代码前加上感叹号
!pip install cudf-cu11 index-url=https://pypi.nvidia.com在 Jupyter 笔记本中启用 pandas 加速模式
要在 Jupyter 笔记本中启用 pandas 加速模式,请在笔记本开头附近的一个单元格中加入以下代码行。
%load_ext cudf.pandas从终端启用 pandas 加速模式
要从终端启用 pandas 加速模式,请将运行 Python 脚本的标准命令
python script.py
with
python -m cudf.pandas script.py我还需要做什么?
只需启用 GPU,然后照常编写并运行您的 pandas 代码即可。
我可以对 pandas 加速模式的代码做性能分析吗?
-
在笔记本中,
在要分析的单元格中添加 %%cudf.pandas.profile。 -
您将获得按函数调用或逐行的统计信息,包括 GPU 与 CPU 的调用次数以及在各处理单元上花费的时间。
如果您在使用 cuDF,那么代码运行耗时对您大概率很重要。为优化它,您需要能够进行测量。衡量代码运行时间的技术称为性能分析(profiling)。pandas 加速模式为在 Jupyter 笔记本中运行的代码提供了性能分析工具。
要对单元格中的代码进行分析,请在该单元格的起始位置添加以下一行。
%%cudf.pandas.profile运行代码后,您将获得统计信息(按函数调用或逐行),显示在 GPU 与 CPU 上分别花费了多少时间。
是否支持所有 pandas 代码?
在发布时,除两种情况外,其余 pandas 代码均受支持:其一,基于 Apache Arrow 构建的 pandas 2.0 DataFrame 尚未支持,但正在开发中;其二,由 Numba 或 Cython 生成的已编译 pandas 代码并未完全支持。
无论哪种情况,cuDF 不支持的代码都会在 CPU 上运行。
继续学习
如果您对数据科学家如何使用 cuDF 感兴趣,请收听 DataFramed 的这一期节目:如何成为 Kaggle 大师,嘉宾是 NVIDIA 的杰出工程师、Kaggle 大师 Jean-Francois Puget。
您可以在 Big Data with PySpark 技能路径中学习如何使用 PySpark 在 Python 中处理大数据。
最后,请关注 NVIDIA 的最新进展,其宣布了在 scikit-learn、UMAP 和 HDBSCAN 中启用 GPU 加速。阅读并学习如何让您的 Python 机器学习库在 GPU 上运行。
Richie 帮助个人与组织更好地运用数据与人工智能。他在“数据科学”这一称谓流行之前就从事相关工作,并在该领域撰写了两本书,创作了多门 DataCamp 课程。他主持 DataFramed 播客,并负责 DataCamp 的网络研讨会项目。
与 AI 版 Richie 对话,畅聊每一期 DataFramed——欢迎所有数据高手加入!
NVIDIA 宣布在其 cuDF 包中推出“pandas 加速模式”,让您在 Python 中编写高性能的 pandas 数据处理代码。这是朝着“用人类可读的 Python 代码也能在大数据集上高速运行”的愿景迈出的又一步。
在本文中,我们将解析它如何助您一臂之力、如何上手,以及可供选择的替代方案。