Cours
Manipulation de données avec pandas
4 h
567.9K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleNVIDIA a annoncé un « pandas Accelerator Mode » pour son package cuDF, qui vous permet d’écrire du code pandas haute performance pour la manipulation de données en Python. C’est une nouvelle étape vers le rêve d’un Python lisible et rapide, même sur de gros jeux de données.
Dans cet article, nous détaillons en quoi cela peut vous aider, comment démarrer et quelles sont les alternatives.
pandas est la bibliothèque de manipulation de données la plus populaire pour Python, avec 144 millions de téléchargements le mois dernier. Une grande partie de sa popularité vient de sa simplicité d’utilisation et de sa riche palette de fonctionnalités pour manipuler les données.
Malheureusement, l’histoire de développement très longue de pandas — la première version publique date de 2011 — précède de nombreuses innovations en calcul haute performance (HPC). Conséquence : le code pandas est trop lent pour être utile sur de grands ensembles de données.
Beaucoup ont cherché à résoudre ce problème : l’objectif est de pouvoir écrire le même code pandas, familier à des millions d’utilisateurs, mais exécuté bien plus vite. Parmi les alternatives performantes à pandas, citons Polars, qui accélère les traitements avec un backend réécrit en Rust ; PySpark, interface Python vers la plateforme HPC Spark ; Vaex, qui s’appuie sur le calcul hors mémoire ; et DuckDB, qui effectue les calculs au sein d’une base analytique optimisée.
Découvrez ces tutoriels, qui approfondissent certaines alternatives :
NVIDIA développe une suite d’outils pour la data science haute performance, appelée RAPIDS. Cette boîte à outils inclut cuDF, le package Python de NVIDIA pour exécuter du code de type pandas à haute performance. (Le nom combine CUDA, l’ensemble d’outils bas niveau de NVIDIA pour les applications exploitant le GPU, et DataFrame, l’objet pandas de stockage des données analytiques. Ce dernier a inspiré le nom du podcast de DataCamp, DataFramed.)
L’astuce de cuDF pour accélérer la manipulation de données consiste à exécuter le code sur un GPU plutôt que sur un CPU. Conçus à l’origine pour le rendu graphique, les GPU se révèlent très efficaces pour les calculs de data science.
Bien que cuDF ait largement réussi à accélérer du code de style pandas, plusieurs points ont freiné son adoption massive.
Un frein majeur est que cuDF n’implémente qu’environ 60 % de l’API de pandas. Autrement dit, seuls environ 60 % de tous les cas de code possibles en pandas peuvent tourner dans cuDF. Naturellement, ce sont les 60 % les plus courants, utiles au quotidien. En revanche, dès que vous souhaitez faire quelque chose d’un peu atypique, vous risquez de buter sur des limites.
cuDF n’exécute le code que sur GPU. Vous devez donc disposer d’un GPU pour développer et pour tester. Souvent impossible en local sur un ordinateur portable, et coûteux dans le cloud.
Autre problème : l’immense majorité des packages Python ne tirent pas parti du GPU. Dès que votre analyse mobilise d’autres bibliothèques — par exemple, quasiment tout workflow de machine learning — il faut gérer le va-et-vient des calculs entre GPU et CPU.
Au total, ces trois obstacles vous obligeaient à maintenir deux versions de votre code : une pour le cas où des GPU sont disponibles et où cuDF peut tout calculer, et une autre pour un environnement sans GPU.
La plupart des data scientists préfèrent se concentrer sur l’analyse plutôt que sur ces détails d’implémentation. Historiquement, cela a rendu l’usage de cuDF peu attrayant pour de nombreuses tâches.
La réponse apportée par le mode pandas Accelerator, c’est qu’une seule ligne de code suffit pour activer la prise en charge GPU, puis vous codez en pandas standard.
Lorsque l’exécution sur GPU est possible (GPU NVIDIA disponible et cuDF sait exécuter le code pandas), votre code tourne sur le GPU. Dans le cas contraire, cuDF bascule automatiquement sur le CPU. Vous n’avez pas à écrire deux versions de votre code ni à gérer manuellement le passage GPU/CPU.
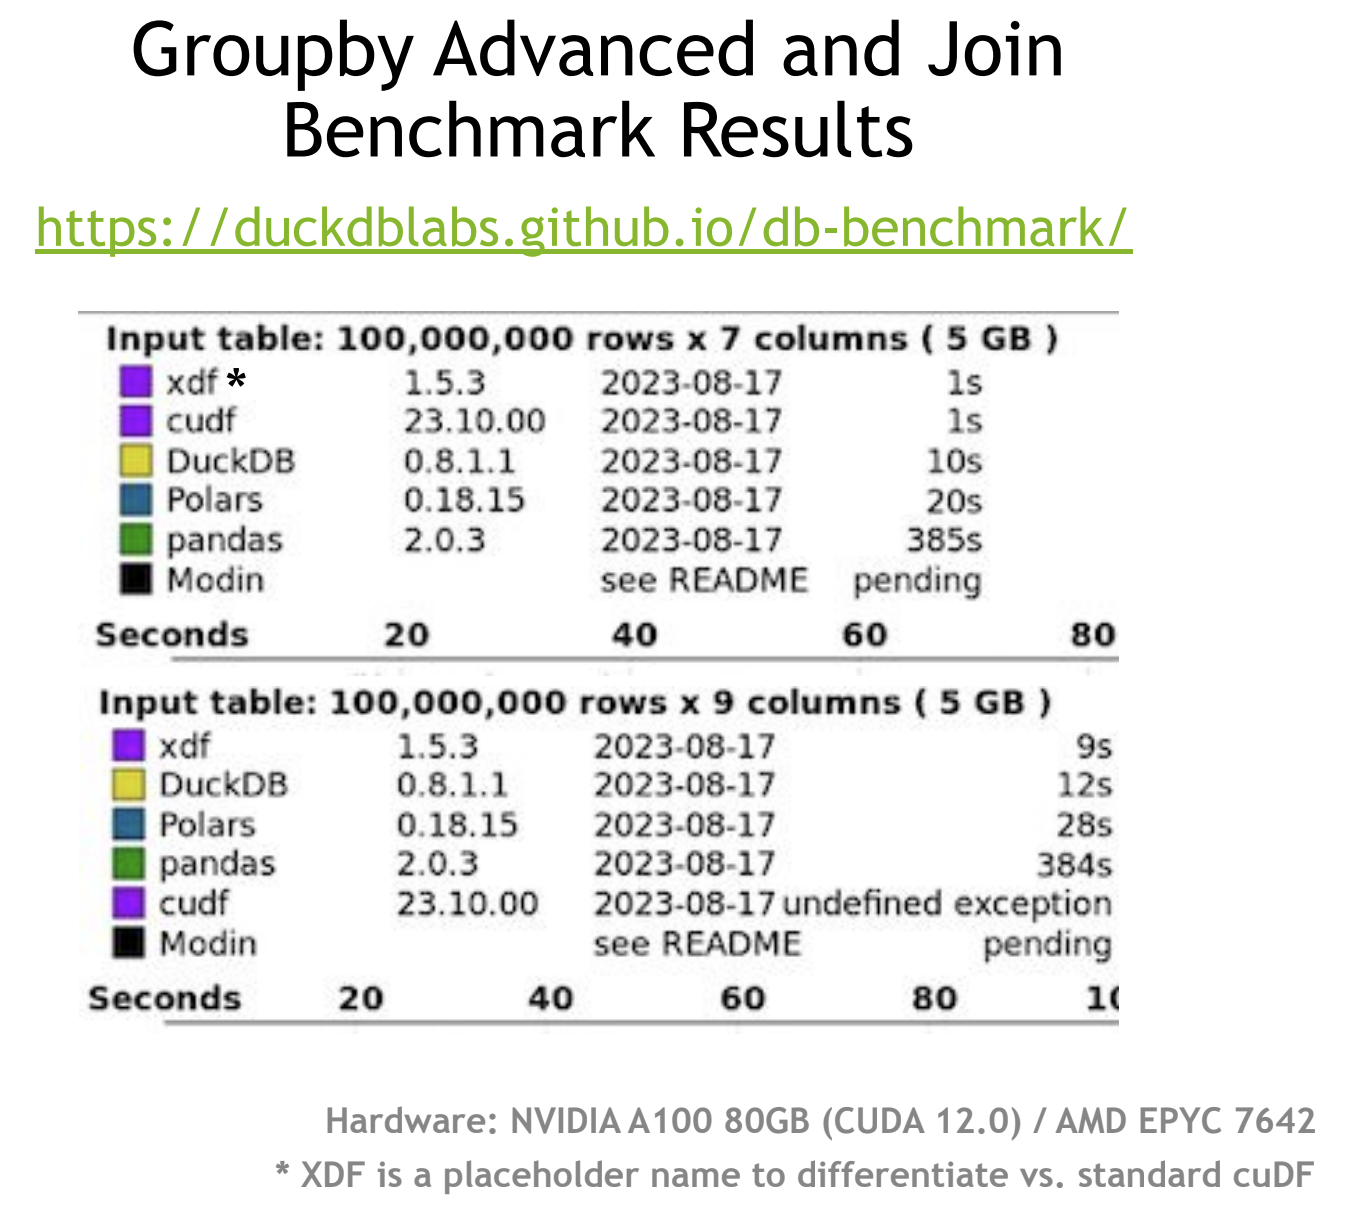
Image : droits d’auteur NVIDIA.
NVIDIA a testé le mode pandas Accelerator face à d’autres outils Python de manipulation de données haute performance sur le benchmark DuckDB Database-like ops. Cette batterie d’épreuves mesure la capacité d’une technologie à réaliser des tâches telles que des statistiques agrégées par groupe et des jointures de tables sur de gros volumes.
D’après NVIDIA, le mode pandas Accelerator (noté xdf sur l’image) arrive en tête. C’est notable car la version standard de cuDF échoue actuellement au test de jointure, n’étant pas en mesure d’effectuer toutes les opérations requises sur GPU. (Il faudrait combiner cuDF avec un autre outil pour tout faire fonctionner.)
Précision : le test a été réalisé sur un GPU NVIDIA A100 80 Go haut de gamme, et le CPU utilisé n’est pas spécifié. Les performances dépendent de votre matériel, de votre jeu de données et des calculs effectués.
Voyons comment commencer à utiliser l’Accelerator Mode dans pandas :
La dernière version de cuDF, qui inclut le mode pandas Accelerator, s’appelle cudf-cu11. Elle est disponible via une installation pip standard, avec la particularité qu’il faut actuellement la récupérer depuis le dépôt PyPi de NVIDIA.
Exécutez ce code pour installer le package.
pip install cudf-cu11 index-url=https://pypi.nvidia.comSi vous êtes dans un notebook Jupyter, préfixez la commande par un point d’exclamation
!pip install cudf-cu11 index-url=https://pypi.nvidia.comPour activer le mode pandas Accelerator dans un notebook Jupyter, ajoutez la ligne suivante dans une cellule au début du notebook.
%load_ext cudf.pandasPour l’activer depuis un terminal, remplacez la commande standard d’exécution d’un script Python
python script.py

with

python -m cudf.pandas script.pyIl suffit de disposer d’un GPU, puis d’écrire et d’exécuter votre code pandas comme d’habitude.
Dans un notebook, ajoutez %%cudf.pandas.profile à la cellule à profiler.
Vous obtenez des statistiques (par appel de fonction ou ligne par ligne) sur le nombre d’appels GPU et CPU, ainsi que le temps passé sur chaque unité de calcul.
Si vous utilisez cuDF, le temps d’exécution de votre code est probablement crucial. Pour l’optimiser, vous devez pouvoir le mesurer. La technique de mesure du temps d’exécution s’appelle le profilage. Le mode pandas Accelerator fournit un outil de profilage pour le code exécuté dans Jupyter.
Pour profiler le code d’une cellule, ajoutez la ligne suivante au début de la cellule.
%%cudf.pandas.profileAu lancement, vous obtiendrez des statistiques, par appel de fonction ou ligne par ligne, sur le temps passé à calculer sur GPU et sur CPU.
Au moment de l’annonce, tout le code pandas était pris en charge, à deux exceptions près : les DataFrames pandas 2.0 basés sur Apache Arrow n’étaient pas encore pris en charge, même si le support était en cours de développement. Deuxièmement, le code pandas compilé généré par Numba ou Cython n’est pas entièrement pris en charge.
Dans les deux cas, le code non pris en charge par cuDF s’exécutera sur CPU.
Pour découvrir comment les data scientists utilisent cuDF, écoutez cet épisode de DataFramed : Becoming a Kaggle Grandmaster avec Jean-François Puget, Distinguished Engineer chez NVIDIA et Kaggle Grandmaster.
Vous pouvez apprendre à travailler sur des données massives en Python avec PySpark dans le parcours de compétences Big Data with PySpark.
Enfin, restez au fait des dernières nouveautés de NVIDIA, qui a annoncé l’accélération GPU dans scikit-learn, UMAP et HDBSCAN. Lisez et apprenez à faire tourner vos bibliothèques de machine learning Python sur GPU.
Débutez votre parcours pandas dès aujourd’hui !
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec GoogleTutoriel
DataCamp Team
3 min
Tutoriel
Aditya Sharma
5 min
Tutoriel
Stephen Gruppetta
12 min
Tutoriel
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Sejal Jaiswal
24 min