

Corso
Manipolazione dei dati con pandas
4 ore
567.9K
Pratica and corso your progress.
Continua Con GoogleNVIDIA ha annunciato una "pandas Accelerator Mode" per il pacchetto cuDF, che ti permette di scrivere codice pandas ad alte prestazioni per la manipolazione dei dati in Python. È un altro passo verso il sogno di scrivere codice Python leggibile che gira velocemente, anche su dataset di grandi dimensioni.
In questo post vediamo come può esserti utile, come iniziare e quali sono le alternative.
pandas è il pacchetto di manipolazione dei dati più popolare per Python, con 144 milioni di download lo scorso mese. Gran parte della popolarità di pandas deriva dalla sua facilità d'uso e dall'ampia gamma di funzionalità per la manipolazione dei dati.
Sfortunatamente, la lunga storia di sviluppo di pandas — è stato reso pubblico per la prima volta nel 2011 — significa che precede molte innovazioni nel calcolo ad alte prestazioni (HPC). Ciò implica che il codice pandas gira troppo lentamente per essere utile con dataset di grandi dimensioni.
Ci sono stati molti tentativi di risolvere questo problema. L'obiettivo è poter scrivere lo stesso codice pandas che milioni di utenti conoscono, ma farlo girare più rapidamente. Alcune alternative ad alte prestazioni a pandas includono Polars, che accelera riscrivendo il backend in Rust; PySpark, che fornisce un'interfaccia Python alla piattaforma HPC Spark; Vaex, che usa il calcolo out-of-memory; e DuckDB, che esegue i calcoli all'interno di un database ottimizzato per l'analisi.
Dai un'occhiata a questi tutorial, che approfondiscono alcune alternative:
NVIDIA sta sviluppando una suite di strumenti per il data science ad alte prestazioni chiamata RAPIDS. Questa toolbox include cuDF, il pacchetto Python di NVIDIA per codice pandas ad alte prestazioni. (Il nome combina CUDA, la toolkit di basso livello di NVIDIA per creare applicazioni abilitate alla GPU, e DataFrame, l'oggetto pandas per archiviare dati analitici. Quest'ultimo ha ispirato il nome del podcast di DataCamp DataFramed.)
Il trucco di cuDF per accelerare il codice di manipolazione dei dati è farlo girare su una GPU invece che su una CPU. Sebbene originariamente progettate per i calcoli grafici, le GPU sono incredibilmente efficaci nei calcoli per il data science.
Sebbene cuDF abbia avuto molto successo nel permetterti di eseguire più velocemente il codice pandas, presentava diversi problemi che ne hanno impedito l'adozione diffusa.
Un grosso ostacolo è che cuDF implementa solo circa il 60% della API di Pandas. Cioè, solo circa il 60% di tutto il possibile codice che potresti scrivere in pandas può essere eseguito in cuDF. Il 60% di codice eseguibile è, naturalmente, il 60% più comune che la maggior parte delle persone vuole usare. Questo significa che per le analisi quotidiane il codice cuDF dovrebbe andare bene. Tuttavia, se vuoi fare qualcosa di un po' insolito, incontrerai problemi con cuDF.
cuDF supporta l'esecuzione del codice solo su GPU. Ciò significa che ti serve una GPU quando sviluppi il codice e quando lo testi. Spesso non è fattibile se vuoi eseguire il codice in locale su un laptop ed è costoso se vuoi eseguirlo nel cloud.
Un altro problema è che la stragrande maggioranza dei pacchetti Python non è abilitata alla GPU. Questo significa che per qualsiasi analisi che usi altri pacchetti — ad esempio, più o meno qualsiasi workflow di machine learning — dovresti capire come spostare il calcolo da GPU a CPU e viceversa.
Insieme, questi tre problemi significavano che avresti dovuto scrivere due versioni del tuo codice: una che girasse se le GPU erano disponibili e cuDF potesse eseguire tutto, e una per quando non fosse disponibile alcuna GPU.
La maggior parte dei data scientist preferisce concentrarsi nel ricavare insight dai dati piuttosto che su questi dettagli di implementazione. Storicamente, questo ha reso l'uso di cuDF problematico per molte attività di data science.
La soluzione offerta dalla modalità pandas Accelerator a questi problemi è che ti basta scrivere una sola riga di codice per abilitare il supporto GPU, e poi puoi scrivere il normale codice pandas.
Quando l'elaborazione su GPU è supportata (c'è una GPU NVIDIA disponibile e cuDF sa come eseguire il codice pandas), il tuo codice girerà sulla GPU. Nei casi in cui ciò non è possibile, cuDF passa automaticamente all'esecuzione su CPU. Non devi scrivere due versioni del tuo codice, né gestire manualmente il passaggio tra GPU e CPU.
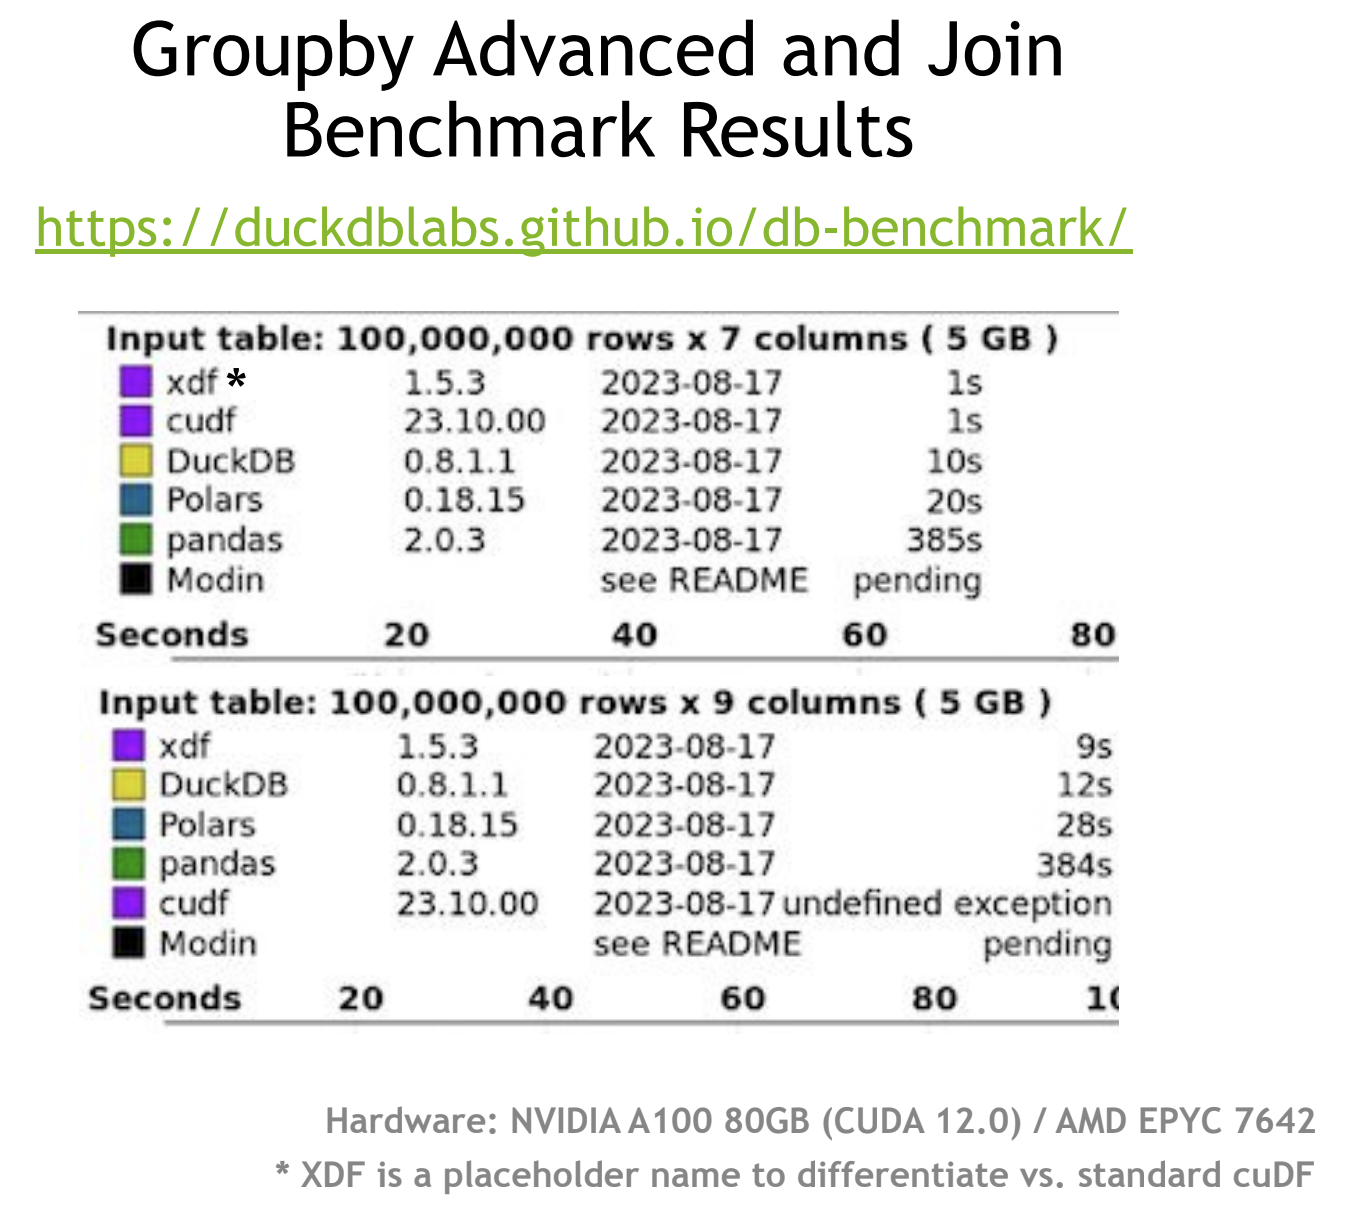
Immagine copyright NVIDIA.
NVIDIA ha testato la modalità pandas Accelerator rispetto ad altri strumenti Python ad alte prestazioni per la manipolazione dei dati sul benchmark DuckDB Database-like ops. Questa suite di sfide di manipolazione dei dati misura quanto bene una tecnologia sa eseguire attività come fornire statistiche riassuntive raggruppate e join di tabelle su grandi dataset.
Secondo NVIDIA, la modalità pandas Accelerator (indicata come xdf nell'immagine) arriva prima nel benchmark. È notevole perché la versione standard di cuDF attualmente fallisce il test di join, poiché non può eseguire tutte le operazioni richieste su GPU. (Bisognerebbe combinare cuDF con un altro strumento per far funzionare tutto.)
Da notare che NVIDIA ha testato su una GPU di fascia alta NVIDIA A100 80GB e la CPU utilizzata non è specificata. Le tue prestazioni varieranno in base alla configurazione hardware, al dataset e ai calcoli che vuoi eseguire.
Vediamo come iniziare a usare la modalità Accelerator in pandas:
L'ultima versione di cuDF, che include la modalità pandas Accelerator, si chiama cudf-cu11. È disponibile tramite una normale installazione con pip, con la precisazione che al momento devi scaricarla dal repository PyPi di NVIDIA.
Esegui questo comando per installare il pacchetto.
pip install cudf-cu11 index-url=https://pypi.nvidia.comSe stai lavorando dentro un notebook Juypter, anteponi un punto esclamativo al comando
!pip install cudf-cu11 index-url=https://pypi.nvidia.comPer abilitare la modalità pandas Accelerator in un notebook Jupyter, aggiungi la riga seguente in una cella vicino all'inizio del notebook.
%load_ext cudf.pandasPer abilitare la modalità pandas Accelerator da terminale, sostituisci il comando standard per eseguire uno script Python
python script.py

with

python -m cudf.pandas script.pyAbilita semplicemente una GPU, quindi scrivi ed esegui il tuo codice pandas come al solito.
In un notebook, aggiungi %%cudf.pandas.profile alla cella che vuoi profilare.
Ottieni statistiche (per chiamata di funzione o riga per riga) sul numero di chiamate GPU e CPU + tempo speso su ciascuna PU.
Se usi cuDF, è probabile che il tempo di esecuzione del tuo codice sia importante per te. Per ottimizzarlo, devi poterlo misurare. La tecnica per misurare il tempo di esecuzione del codice si chiama profilazione. La modalità pandas Accelerator fornisce uno strumento di profilazione per il codice eseguito nei notebook Jupyter.
Per profilare il codice in una cella, aggiungi la riga seguente all'inizio della cella.
%%cudf.pandas.profileQuando esegui il codice, otterrai statistiche, per chiamata di funzione o riga per riga, su quanto tempo è stato speso computando su GPU e su CPU.
Al momento dell'annuncio, tutto il codice pandas era supportato con due eccezioni: i DataFrame di pandas 2.0 basati su Apache Arrow non erano ancora supportati, anche se il supporto era in sviluppo. In secondo luogo, il codice pandas compilato generato da Numba o Cython non è pienamente supportato.
In entrambi i casi, il codice non supportato da cuDF verrà eseguito su CPU.
Se ti interessa come i data scientist usano cuDF, ascolta questo episodio di DataFramed: Diventare un Kaggle Grandmaster con Jean-Francois Puget, Distinguished Engineer in NVIDIA e Kaggle Grandmaster.
Puoi imparare a lavorare con big data in Python usando PySpark nel percorso di competenze Big Data with PySpark.
Infine, resta aggiornato con gli ultimi sviluppi di NVIDIA, che ha annunciato l'accelerazione GPU in scikit-learn, UMAP e HDBSCAN. Leggi e scopri come far girare le tue librerie di machine learning Python su GPU.
Inizia oggi il tuo viaggio con pandas!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



