

Kursus
Manipulasi Data dengan pandas
4 jam
567.8K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleNVIDIA mengumumkan "Mode Akselerator pandas" untuk paket cuDF mereka, yang memungkinkan Anda menulis kode pandas berkinerja tinggi untuk manipulasi data di Python. Ini adalah langkah lain menuju mimpi menulis kode Python yang mudah dibaca manusia namun berjalan cepat, bahkan pada kumpulan data besar.
Dalam artikel ini, kami mengulas bagaimana ini dapat membantu Anda, cara memulainya, dan apa saja alternatifnya.
pandas adalah paket manipulasi data paling populer untuk Python, dengan 144 juta unduhan bulan lalu. Sebagian besar popularitas pandas berasal dari kemudahan penggunaan dan rangkaian fitur yang luas untuk manipulasi data.
Sayangnya, sejarah pengembangan pandas yang panjang—pertama kali dirilis pada 2011—berarti ia hadir sebelum banyak inovasi dalam komputasi berkinerja tinggi (HPC). Ini membuat kode pandas berjalan terlalu lambat untuk bermanfaat pada kumpulan data berukuran besar.
Ada banyak upaya untuk menyelesaikan masalah ini. Tujuannya adalah agar dapat menulis kode pandas yang sama seperti yang dikenal jutaan pengguna, namun berjalan lebih cepat. Beberapa alternatif pandas berkinerja tinggi termasuk Polars, yang mempercepat dengan menulis ulang backend dalam Rust; PySpark, yang menyediakan antarmuka Python untuk platform HPC Spark; Vaex, yang menggunakan komputasi out-of-memory; dan DuckDB, yang melakukan komputasi di dalam basis data yang dioptimalkan untuk analitik.
Lihat tutorial berikut yang membahas beberapa alternatif tersebut secara lebih rinci:
NVIDIA telah mengembangkan serangkaian alat untuk data science berkinerja tinggi bernama RAPIDS. Kotak peralatan ini mencakup cuDF, paket Python NVIDIA untuk kode pandas berkinerja tinggi. (Namanya menggabungkan CUDA, toolkit tingkat rendah NVIDIA untuk membangun aplikasi berkemampuan GPU, dan DataFrame, objek pandas untuk menyimpan data analitik. Yang terakhir menginspirasi nama podcast DataCamp DataFramed.)
Trik cuDF untuk mempercepat kode manipulasi data adalah membuat kode berjalan di GPU alih-alih CPU. Meski awalnya dirancang untuk komputasi guna menampilkan grafis, GPU sangat efektif untuk komputasi data science.
Walaupun cuDF sangat berhasil memungkinkan Anda menjalankan kode pandas lebih cepat, ada beberapa masalah yang menghambat adopsi luas.
Satu hambatan besar adalah cuDF hanya mengimplementasikan sekitar 60% dari API Pandas. Artinya, hanya sekitar 60% dari seluruh kemungkinan kode yang dapat Anda tulis di pandas yang bisa dijalankan di cuDF. 60% kode yang dapat dijalankan tersebut, tentu saja, adalah 60% paling umum yang ingin dijalankan kebanyakan orang. Ini berarti untuk analisis sehari-hari, kode cuDF seharusnya baik-baik saja. Namun, jika Anda ingin melakukan sesuatu yang sedikit tidak biasa, Anda akan menemui masalah dengan cuDF.
cuDF hanya mendukung menjalankan kode di GPU. Ini berarti Anda memerlukan GPU saat mengembangkan kode dan saat mengujinya. Sering kali ini tidak memungkinkan jika Anda ingin menjalankan kode secara lokal di laptop, dan menjadi mahal jika Anda ingin menjalankan kode di cloud.
Masalah lain adalah sebagian besar paket Python tidak berkemampuan GPU. Artinya, untuk analisis yang menggunakan paket lain—misalnya, hampir semua alur kerja machine learning—Anda harus mencari cara untuk memindahkan komputasi dari GPU ke CPU dan sebaliknya.
Kombinasi ketiga masalah ini berarti Anda harus menulis dua versi kode: satu yang akan berjalan jika GPU tersedia dan cuDF dapat menghitung semuanya, dan satu lagi untuk kondisi tanpa GPU.
Kebanyakan data scientist ingin lebih fokus mendapatkan insight dari data daripada pada detail kode semacam itu. Secara historis, hal ini membuat penggunaan cuDF menjadi bermasalah bagi banyak tugas data science.
Solusi dari masalah-masalah ini yang ditawarkan Mode Akselerator pandas adalah Anda hanya perlu menulis satu baris kode untuk mengaktifkan dukungan GPU, lalu Anda dapat menulis kode pandas standar.
Ketika komputasi GPU didukung (tersedia GPU NVIDIA, dan cuDF mengetahui cara menjalankan kode pandas tersebut), kode Anda akan berjalan di GPU. Jika hal ini tidak memungkinkan, cuDF secara otomatis beralih untuk berjalan di CPU. Anda tidak perlu menulis dua versi kode, dan tidak perlu menangani perpindahan antara GPU dan CPU secara manual.
Hak cipta gambar milik NVIDIA.
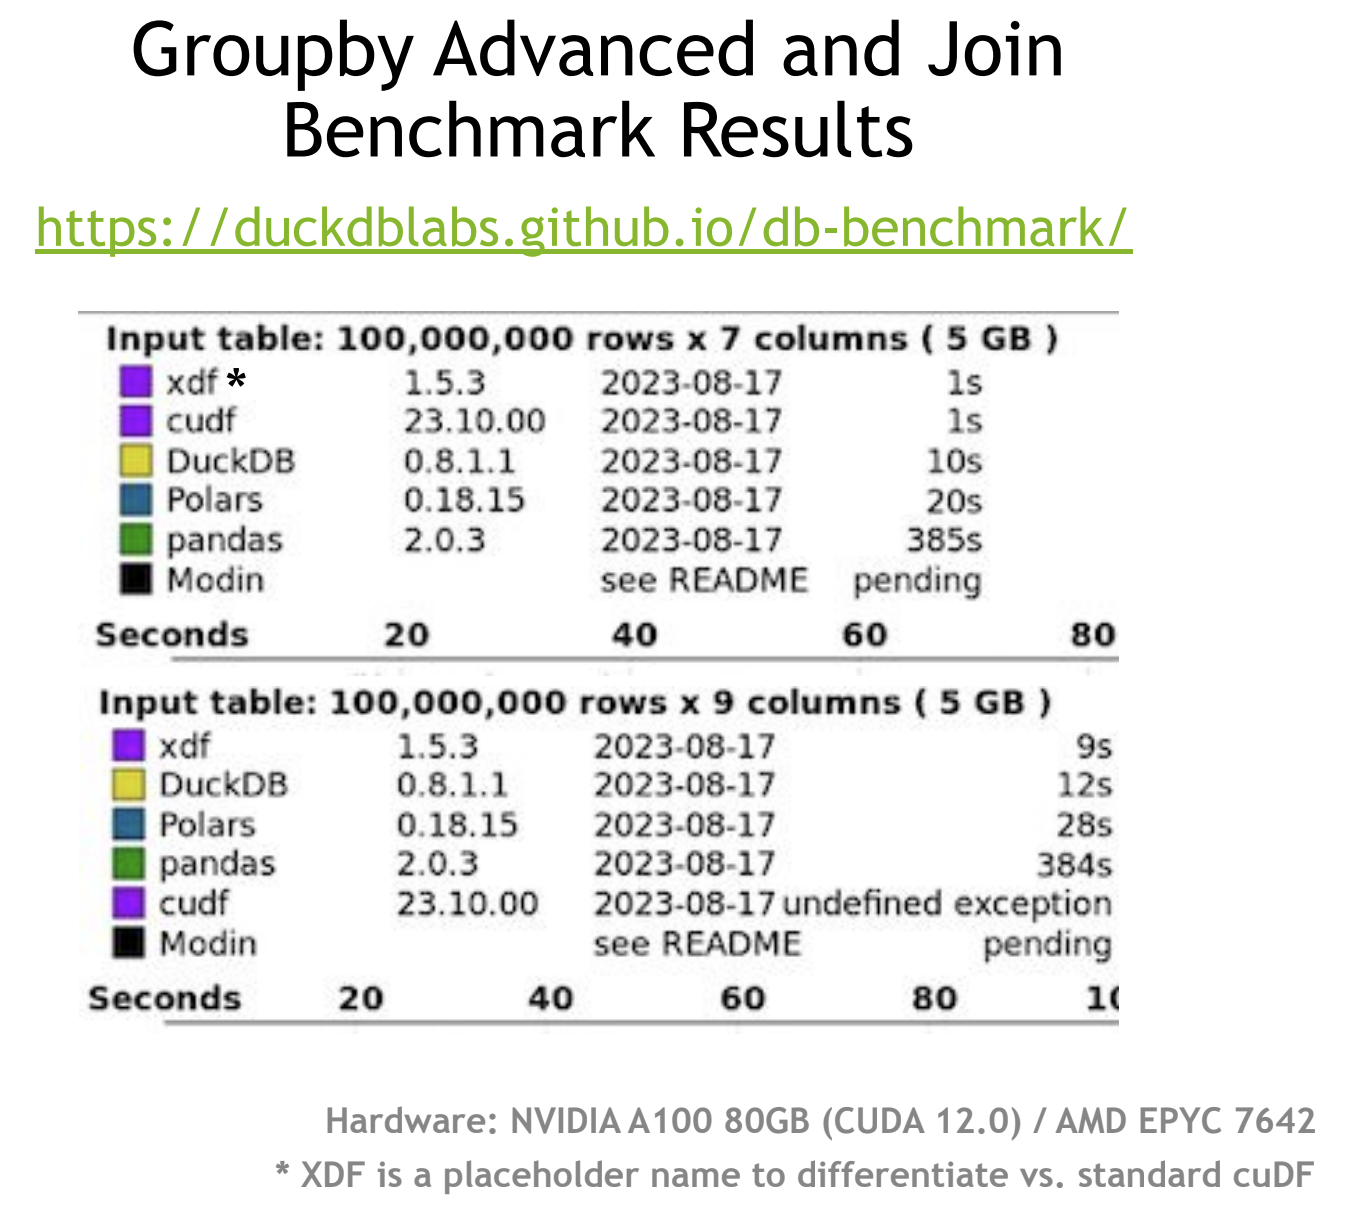
NVIDIA menguji Mode Akselerator pandas dibandingkan alat manipulasi data Python berkinerja tinggi lainnya pada benchmark DuckDB Database-like ops. Kumpulan tantangan manipulasi data ini mengukur seberapa baik suatu teknologi melakukan tugas seperti menyediakan statistik ringkasan terkelompok dan join tabel pada kumpulan data besar.
Menurut NVIDIA, Mode Akselerator pandas (ditandai xdf pada gambar) menempati peringkat pertama dalam benchmark. Ini patut dicatat karena versi standar cuDF saat ini gagal pada uji join karena tidak dapat melakukan semua operasi yang diperlukan di GPU. (Anda perlu menggabungkan cuDF dengan alat lain agar semuanya berjalan.)
Satu hal yang perlu dicatat adalah NVIDIA menguji ini pada GPU kelas atas NVIDIA A100 80GB, dan CPU yang digunakan tidak disebutkan. Kinerja Anda akan bervariasi tergantung pada konfigurasi perangkat keras, kumpulan data, dan perhitungan yang ingin Anda lakukan.
Mari lihat bagaimana Anda dapat mulai menggunakan Mode Akselerator di pandas:
Versi terbaru cuDF, yang menyertakan Mode Akselerator pandas, bernama cudf-cu11. Paket ini tersedia melalui pemasangan pip standar, dengan catatan bahwa saat ini Anda harus mengunduhnya dari repositori PyPi NVIDIA.
Jalankan kode ini untuk memasang paketnya.
pip install cudf-cu11 index-url=https://pypi.nvidia.comJika Anda menjalankan di dalam notebook Juypter, tambahkan tanda seru di awal kodenya
!pip install cudf-cu11 index-url=https://pypi.nvidia.comUntuk mengaktifkan Mode Akselerator pandas di Jupyter notebook, tambahkan baris kode berikut pada sel di dekat awal notebook Anda.
%load_ext cudf.pandasUntuk mengaktifkan Mode Akselerator pandas dari terminal, ganti perintah standar untuk menjalankan skrip Python
python script.py

with

python -m cudf.pandas script.pyCukup aktifkan GPU, lalu tulis dan jalankan kode pandas Anda seperti biasa.
Di dalam notebook, tambahkan %%cudf.pandas.profile pada sel yang ingin Anda profilkan.
Anda akan mendapatkan statistik (berdasarkan pemanggilan fungsi atau baris demi baris) tentang jumlah pemanggilan GPU dan CPU + waktu yang dihabiskan pada masing-masing PU.
Jika Anda menggunakan cuDF, kemungkinan besar waktu eksekusi kode penting bagi Anda. Untuk mengoptimalkannya, Anda perlu dapat mengukurnya. Teknik untuk mengukur waktu yang dibutuhkan kode untuk berjalan disebut profiling. Mode Akselerator pandas menyediakan alat profiling untuk kode yang dijalankan di Jupyter notebook.
Untuk memprofilkan kode dalam sebuah sel, tambahkan baris berikut di awal sel tersebut.
%%cudf.pandas.profileSaat Anda menjalankan kodenya, Anda akan mendapatkan statistik, baik berdasarkan pemanggilan fungsi maupun baris demi baris, tentang berapa banyak waktu yang dihabiskan untuk komputasi di GPU dan di CPU.
Pada saat pengumuman, semua kode pandas didukung dengan dua pengecualian: DataFrame pandas 2.0 yang dibangun di atas Apache Arrow belum didukung, meski dukungannya sedang dikembangkan. Kedua, kode pandas terkompilasi yang dihasilkan oleh Numba atau Cython belum sepenuhnya didukung.
Dalam kedua kasus tersebut, kode yang tidak didukung oleh cuDF akan berjalan di CPU.
Jika Anda tertarik bagaimana data scientist menggunakan cuDF, dengarkan episode DataFramed ini: Menjadi Kaggle Grandmaster bersama Jean-Francois Puget, Distinguished Engineer di NVIDIA dan Kaggle Grandmaster.
Anda dapat mempelajari cara bekerja dengan big data di Python menggunakan PySpark dalam jalur keterampilan Big Data dengan PySpark.
Terakhir, pastikan untuk mengikuti perkembangan terbaru dari NVIDIA, yang mengumumkan Akselerasi GPU di scikit-learn, UMAP, dan HDBSCAN. Baca dan pelajari cara membuat pustaka machine learning Python Anda berjalan di GPU.
Mulai Perjalanan pandas Anda Hari Ini!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



