
उच्च-प्रदर्शन pandas कोड के सपने की ओर
pandas की समस्या
pandas Python के लिए सबसे लोकप्रिय डेटा मैनिपुलेशन पैकेज है, जिसके पिछले महीने 144 मिलियन डाउनलोड हुए। pandas की लोकप्रियता का एक बड़ा कारण इसका इस्तेमाल में आसान होना और डेटा मैनिपुलेशन के लिए समृद्ध फीचर-सेट है।
दुर्भाग्यवश, pandas का व्यापक विकास इतिहास—यह पहली बार 2011 में सार्वजनिक रूप से उपलब्ध हुआ—का मतलब है कि यह उच्च-प्रदर्शन कंप्यूटिंग (HPC) की कई नवाचारों से पहले का है। इसका अर्थ यह है कि बड़े डेटासेट्स के लिए pandas कोड पर्याप्त तेज़ नहीं चलता।
pandas को तेज़ बनाने के कई प्रयास
इस समस्या को सुलझाने के कई प्रयास हुए हैं। लक्ष्य है कि वही pandas कोड लिखा जा सके जिससे लाखों उपयोगकर्ता परिचित हैं, लेकिन वह अधिक तेज़ चले। कुछ उच्च-प्रदर्शन pandas विकल्पों में Polars शामिल है, जो बैकएंड को Rust में लिखकर गति बढ़ाता है; PySpark, जो Spark HPC प्लेटफ़ॉर्म का Python इंटरफ़ेस देता है; Vaex, जो आउट-ऑफ-मेमोरी कंप्यूटेशन का उपयोग करता है; और DuckDB, जो विश्लेषण के लिए अनुकूलित डेटाबेस के भीतर गणना करता है।
इन ट्यूटोरियल्स को देखें, जो कुछ विकल्पों पर विस्तार से चर्चा करते हैं:
- High Performance Data Manipulation in Python: pandas 2.0 बनाम polars
- Benchmarking High-Performance pandas Alternatives
- DuckDB का परिचय: यह क्या है और आपको इसका उपयोग क्यों करना चाहिए?
तेज़ pandas के लिए NVIDIA का समाधान
NVIDIA उच्च-प्रदर्शन डेटा साइंस के लिए RAPIDS नामक टूल्स का एक सूट विकसित कर रहा है। इस टूलबॉक्स में cuDF शामिल है, जो उच्च-प्रदर्शन pandas कोड के लिए NVIDIA का Python पैकेज है। (यह नाम CUDA—GPU-सक्षम एप्लीकेशंस बनाने के लिए NVIDIA का लो-लेवल टूलकिट—और DataFrame, जो एनालिटिक्स डेटा को स्टोर करने के लिए pandas ऑब्जेक्ट है—को मिलाकर बना है। इसी से DataCamp के DataFramed पॉडकास्ट का नाम भी प्रेरित है।)
डेटा मैनिपुलेशन कोड को तेज़ करने के लिए cuDF की तरकीब यह है कि कोड को CPU के बजाय GPU पर चलाया जाए। यद्यपि मूल रूप से ग्राफ़िक्स दिखाने के लिए गणनाओं हेतु डिज़ाइन किए गए थे, GPUs डेटा साइंस गणनाओं में अत्यंत प्रभावी हैं।
cuDF में समस्याएँ थीं
हालाँकि cuDF ने pandas कोड को तेज़ी से चलाने में काफी सफलता पाई है, इसमें कई ऐसी खामियाँ थीं जिन्होंने व्यापक उपयोग अपनाने में बाधा डाली।
pandas का पूरा समर्थन नहीं है
एक बड़ी रुकावट यह है कि cuDF केवल लगभग 60% Pandas API को लागू करता है। यानी pandas में जो भी संभावित कोड आप लिख सकते हैं, उनमें से लगभग 60% ही cuDF में चल सकते हैं। जो 60% कोड चल सकते हैं, वे स्वाभाविक रूप से वे सबसे आम कार्य हैं जिन्हें अधिकांश लोग चलाना चाहेंगे। इसका मतलब है कि दिन-प्रतिदिन के विश्लेषण के लिए cuDF कोड ठीक रहना चाहिए। हालाँकि, यदि आप कुछ असामान्य करना चाहेंगे, तो cuDF के साथ समस्याएँ आएँगी।
विकास और परीक्षण के लिए GPU आवश्यक था
cuDF केवल GPUs पर कोड चलाने का समर्थन करता है। यानी आपको कोड विकसित करते समय और परीक्षण के दौरान GPU की आवश्यकता होगी। यदि आप स्थानीय रूप से लैपटॉप पर कोड चलाना चाहते हैं तो यह अक्सर अव्यावहारिक है, और यदि क्लाउड में चलाना चाहते हैं तो महँगा।
अन्य Python पैकेजों के साथ इंटरैक्शन हेतु प्रोसेसर स्वैपिंग की ज़रूरत
एक और समस्या यह है कि अधिकांश Python पैकेज GPU-सक्षम नहीं हैं। यानी किसी भी ऐसे विश्लेषण के लिए जो अन्य पैकेजों का उपयोग करता है—जैसे लगभग हर मशीन लर्निंग वर्कफ़्लो—आपको यह समझना होगा कि गणना को GPU से CPU और फिर वापस GPU पर कैसे ले जाया जाए।
GPUs की कमी का मौजूदा समाधान उबाऊ था
साथ मिलकर, ये तीन समस्याएँ यह दर्शाती थीं कि आपको अपने कोड के दो संस्करण लिखने पड़ते: एक जो तब चले जब GPU उपलब्ध हो और cuDF सब कुछ गणना कर सके, और एक तब जब GPU उपलब्ध न हो।
अधिकांश डेटा वैज्ञानिक डेटा से अंतर्दृष्टि प्राप्त करने पर अधिक ध्यान देना चाहते हैं, न कि ऐसे कोड विवरणों पर। ऐतिहासिक रूप से, इसने कई डेटा साइंस कार्यों के लिए cuDF का उपयोग समस्याग्रस्त बना दिया।
pandas Accelerator Mode cuDF को कैसे बेहतर बनाता है
इन समस्याओं का समाधान जो pandas Accelerator Mode देता है, वह यह है कि GPU समर्थन सक्षम करने के लिए आपको केवल एक पंक्ति कोड लिखनी है, और फिर आप मानक pandas कोड लिख सकते हैं।
जब GPU गणना समर्थित होती है (यानी NVIDIA GPU उपलब्ध है, और cuDF को पता है कि pandas कोड कैसे चलाना है), तो आपका कोड GPU पर चलेगा। जहाँ यह संभव नहीं है, वहाँ cuDF स्वतः CPU पर चलने की ओर स्विच कर देता है। आपको अपने कोड के दो संस्करण लिखने की आवश्यकता नहीं है, और आपको GPU और CPU के बीच स्विचिंग को मैन्युअल रूप से संभालने की भी ज़रूरत नहीं।
क्या pandas Accelerator Mode विकल्पों से तेज़ है?
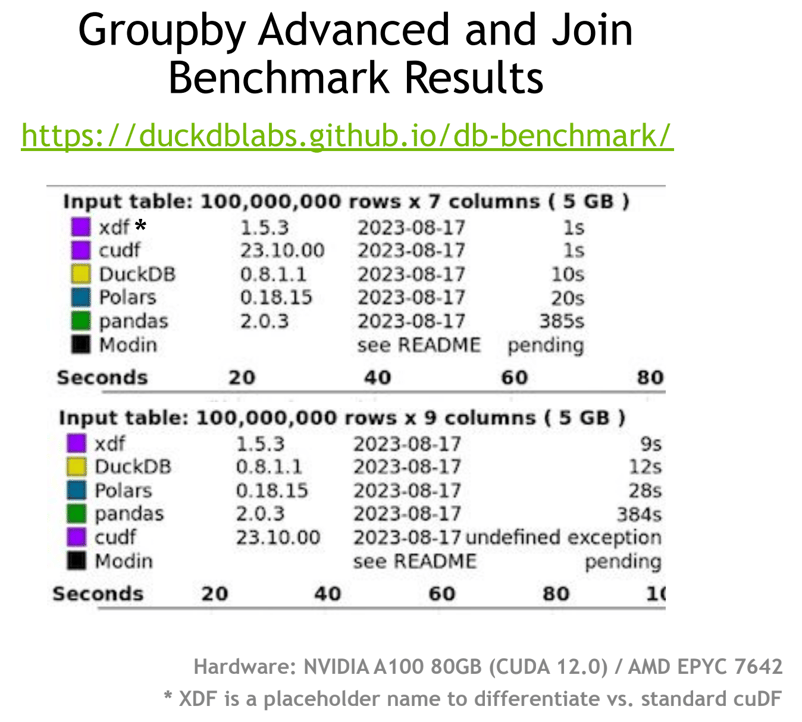
छवि कॉपीराइट NVIDIA।
NVIDIA ने pandas Accelerator Mode का अन्य उच्च-प्रदर्शन Python डेटा मैनिपुलेशन टूल्स के विरुद्ध DuckDB Database-like ops बेंचमार्क पर परीक्षण किया। डेटा मैनिपुलेशन चुनौतियों का यह सूट यह माप प्रदान करता है कि कोई तकनीक बड़े डेटासेट्स पर ग्रुप्ड समरी आँकड़े और टेबल जॉइन जैसे कार्य कितनी अच्छी तरह कर सकती है।
NVIDIA के अनुसार, pandas Accelerator Mode (छवि में xdf के रूप में दर्शाया गया) बेंचमार्क में प्रथम स्थान पर आता है। यह उल्लेखनीय है क्योंकि cuDF का मानक संस्करण वर्तमान में जॉइन टेस्ट में विफल होता है, चूँकि वह सभी आवश्यक ऑपरेशंस GPU पर नहीं कर सकता। (सब कुछ काम कराने के लिए आपको cuDF को किसी अन्य टूल के साथ मिलाना होगा।)
ध्यान देने योग्य एक बात यह है कि NVIDIA ने यह परीक्षण टॉप-एंड NVIDIA A100 80GB GPU पर किया, और उपयोग किया गया CPU निर्दिष्ट नहीं है। आपका प्रदर्शन आपके हार्डवेयर सेटअप, आपके डेटासेट, और जिन गणनाओं को आप करना चाहते हैं, उनके अनुसार अलग-अलग होगा।
मैं pandas Accelerator Mode का उपयोग कैसे कर सकता/सकती हूँ?
आइए देखें कि आप pandas में Accelerator Mode का उपयोग कैसे शुरू कर सकते हैं:
नवीनतम cuDF कैसे इंस्टॉल करें
cuDF का नवीनतम संस्करण, जिसमें pandas Accelerator Mode शामिल है, cudf-cu11 कहलाता है। यह एक मानक pip इंस्टॉल के माध्यम से उपलब्ध है, बशर्ते कि फिलहाल आपको इसे NVIDIA PyPi रिपॉज़िटरी से प्राप्त करना होगा।
पैकेज इंस्टॉल करने के लिए यह कोड चलाएँ।
pip install cudf-cu11 index-url=https://pypi.nvidia.comयदि आप Juypter नोटबुक के अंदर चला रहे हैं, तो कोड से पहले विस्मयादिबोधक चिन्ह जोड़ें
!pip install cudf-cu11 index-url=https://pypi.nvidia.comJupyter नोटबुक में pandas Accelerator Mode सक्षम करना
Jupyter नोटबुक में pandas Accelerator Mode सक्षम करने के लिए, अपने नोटबुक की शुरुआत के पास किसी सेल में नीचे दी गई कोड पंक्ति जोड़ें।
%load_ext cudf.pandasटर्मिनल से pandas Accelerator Mode सक्षम करना
टर्मिनल से pandas Accelerator Mode सक्षम करने के लिए, Python स्क्रिप्ट चलाने के मानक कमांड को बदलें
python script.py
with
python -m cudf.pandas script.pyमुझे और क्या करना होगा?
सिर्फ GPU सक्षम करें, फिर अपने pandas कोड को सामान्य रूप से लिखें और चलाएँ।
क्या मैं pandas Accelerator Mode कोड का प्रोफाइल कर सकता/सकती हूँ?
-
नोटबुक में, जिस सेल का आप प्रोफाइल करना चाहते हैं उसमें
add %%cudf.pandas.profileजोड़ें। -
आपको GPU कॉल्स और CPU कॉल्स की संख्या + प्रत्येक प्रोसेसिंग यूनिट पर खर्च समय की सांख्यिकी (फ़ंक्शन कॉल के अनुसार या लाइन-दर-लाइन) मिलती है।
यदि आप cuDF का उपयोग कर रहे हैं, तो संभवतः आपके लिए यह महत्वपूर्ण है कि आपका कोड चलने में कितना समय लेता है। इसे अनुकूलित करने के लिए, आपको इसे मापने में सक्षम होना चाहिए। कोड के चलने में लगने वाले समय को मापने की तकनीक को प्रोफाइलिंग कहते हैं। pandas Accelerator Mode Jupyter नोटबुक्स में चलने वाले कोड के लिए एक प्रोफाइलिंग टूल प्रदान करता है।
किसी सेल के कोड का प्रोफाइल करने के लिए, सेल की शुरुआत में नीचे दी गई पंक्ति जोड़ें।
%%cudf.pandas.profileजब आप कोड चलाते हैं, तो आपको सांख्यिकी मिलेंगी—या तो फ़ंक्शन कॉल के आधार पर या लाइन-दर-लाइन—कि GPU और CPU पर गणना में कितना समय लगा।
क्या सारा pandas कोड समर्थित है?
घोषणा के समय, दो अपवादों को छोड़कर सारा pandas कोड समर्थित था: Apache Arrow पर बने pandas 2.0 DataFrames अभी समर्थित नहीं थे, हालाँकि इस पर काम चल रहा था। दूसरा, Numba या Cython द्वारा जनरेट किया गया कंपाइल्ड pandas कोड पूर्णतः समर्थित नहीं है।
दोनों ही स्थितियों में, जो कोड cuDF द्वारा समर्थित नहीं है, वह CPU पर चलेगा।
सीखते रहें
यदि आप जानना चाहते हैं कि डेटा वैज्ञानिक cuDF का उपयोग कैसे करते हैं, तो DataFramed का यह एपिसोड सुनें: Becoming a Kaggle Grandmaster, जिसमें NVIDIA के Distinguished Engineer और Kaggle Grandmaster, Jean-Francois Puget हैं।
आप Big Data with PySpark स्किल ट्रैक में PySpark का उपयोग करके Python में बिग डेटा के साथ काम करना सीख सकते हैं।
अंत में, NVIDIA की नवीनतम प्रगतियों से अपडेट रहें, जिसने scikit-learn, UMAP, और HDBSCAN में GPU Acceleration की घोषणा की। पढ़ें और सीखें कि अपने Python मशीन लर्निंग लाइब्रेरीज़ को GPUs पर कैसे चलाएँ।
रिची व्यक्तियों और संगठनों को डेटा और AI के बेहतर उपयोग में मदद करते हैं। वे उस समय से डेटा वैज्ञानिक रहे हैं जब इसे डेटा साइंस भी नहीं कहा जाता था, और इस विषय पर दो पुस्तकें लिख चुके हैं तथा DataCamp के कई कोर्स बनाए हैं। वे DataFramed पॉडकास्ट के होस्ट हैं और DataCamp के वेबिनार कार्यक्रम का संचालन करते हैं।
AI Richie से चैट करें DataFramed के हर एपिसोड पर — सभी डेटा चैंपियन आमंत्रित हैं!
NVIDIA ने अपने cuDF पैकेज के लिए "pandas Accelerator Mode" की घोषणा की है, जो आपको Python में डेटा मैनिपुलेशन के लिए उच्च-प्रदर्शन वाला pandas कोड लिखने देता है। यह उस सपने की ओर एक और कदम है जिसमें मानव-पठनीय Python कोड बड़े डेटासेट्स पर भी तेज़ी से चलता है।
इस पोस्ट में, हम समझेंगे कि यह आपकी कैसे मदद कर सकता है, कैसे शुरुआत करें, और इसके विकल्प क्या हैं।