Curso
Manipulación de datos con pandas
4 h
564.5K
NVIDIA ha anunciado un "pandas Accelerator Mode" para su paquete cuDF, que te permite escribir código de pandas de alto rendimiento para manipulación de datos en Python. Es otro paso hacia el sueño de escribir código Python legible para humanos que se ejecute rápido, incluso con conjuntos de datos grandes.
En este artículo, vemos cómo puede ayudarte, cómo empezar y qué alternativas existen.
pandas es la biblioteca de manipulación de datos más popular de Python, con 144 millones de descargas el mes pasado. Gran parte de su popularidad se debe a su facilidad de uso y a su amplio conjunto de funcionalidades para manipular datos.
Por desgracia, la larga trayectoria de desarrollo de pandas —se publicó por primera vez en 2011— hace que sea anterior a muchas innovaciones en computación de alto rendimiento (HPC). Eso implica que el código en pandas puede ir demasiado lento como para resultar útil con grandes volúmenes de datos.
Ha habido numerosos intentos de resolver este problema. El objetivo es poder escribir el mismo código de pandas que millones de usuarios ya conocen, pero que se ejecute más rápido. Algunas alternativas de alto rendimiento a pandas incluyen Polars, que acelera el procesamiento reescribiendo el backend en Rust; PySpark, que ofrece una interfaz de Python para la plataforma HPC Spark; Vaex, que emplea cómputo fuera de memoria; y DuckDB, que realiza el cálculo dentro de una base de datos optimizada para analítica.
Echa un vistazo a estos tutoriales, que analizan algunas de las alternativas con más detalle:
NVIDIA lleva tiempo desarrollando un conjunto de herramientas para ciencia de datos de alto rendimiento llamado RAPIDS. Este kit incluye cuDF, el paquete de Python de NVIDIA para ejecutar código de pandas a gran velocidad. (El nombre combina CUDA, el conjunto de herramientas de bajo nivel de NVIDIA para crear aplicaciones con GPU, y DataFrame, el objeto de pandas para almacenar datos analíticos. Este último inspiró el nombre del pódcast de DataCamp DataFramed).
El truco de cuDF para acelerar la manipulación de datos consiste en ejecutar el código en una GPU en lugar de en una CPU. Aunque las GPU se diseñaron originalmente para cálculos gráficos, son increíblemente eficientes en tareas de ciencia de datos.
Aunque cuDF ha tenido mucho éxito a la hora de permitir ejecutar más rápido código de pandas, presentaba varios problemas que han frenado su adopción generalizada.
Un gran obstáculo es que cuDF solo implementa alrededor del 60% de la API de pandas. Es decir, solo cerca del 60% de todo el código que podrías escribir en pandas se puede ejecutar en cuDF. Naturalmente, ese 60% corresponde a las operaciones más comunes que la mayoría quiere ejecutar, por lo que para análisis del día a día, cuDF suele ir bien. Sin embargo, si quieres hacer algo un poco inusual, te encontrarás con limitaciones.
cuDF solo permite ejecutar código en GPU. Eso significa que necesitas una GPU tanto al desarrollar el código como al probarlo. A menudo no es viable si quieres trabajar en local desde un portátil y puede resultar caro si ejecutas el código en la nube.
Otro problema es que la inmensa mayoría de paquetes de Python no están habilitados para GPU. Por tanto, en cualquier análisis que use otras bibliotecas —por ejemplo, prácticamente cualquier flujo de trabajo de machine learning— tendrías que gestionar cómo mover el cómputo de GPU a CPU y viceversa.
En conjunto, estos tres problemas implicaban que tenías que escribir dos versiones de tu código: una para cuando hubiera GPU disponible y cuDF pudiera calcularlo todo, y otra para cuando no la hubiera.
La mayoría de profesionales de datos prefieren centrarse en extraer información de los datos antes que en estos detalles de implementación. Históricamente, esto ha dificultado el uso de cuDF para muchas tareas de ciencia de datos.
La solución que aporta pandas Accelerator Mode a estos problemas es que solo necesitas una línea para habilitar el soporte de GPU y, a partir de ahí, puedes escribir código estándar de pandas.
Cuando haya soporte para cómputo en GPU (hay una GPU de NVIDIA disponible y cuDF sabe cómo ejecutar el código de pandas), tu código se ejecutará en la GPU. En los casos en que no sea posible, cuDF cambia automáticamente a la CPU. No necesitas escribir dos versiones ni ocuparte manualmente del cambio entre GPU y CPU.
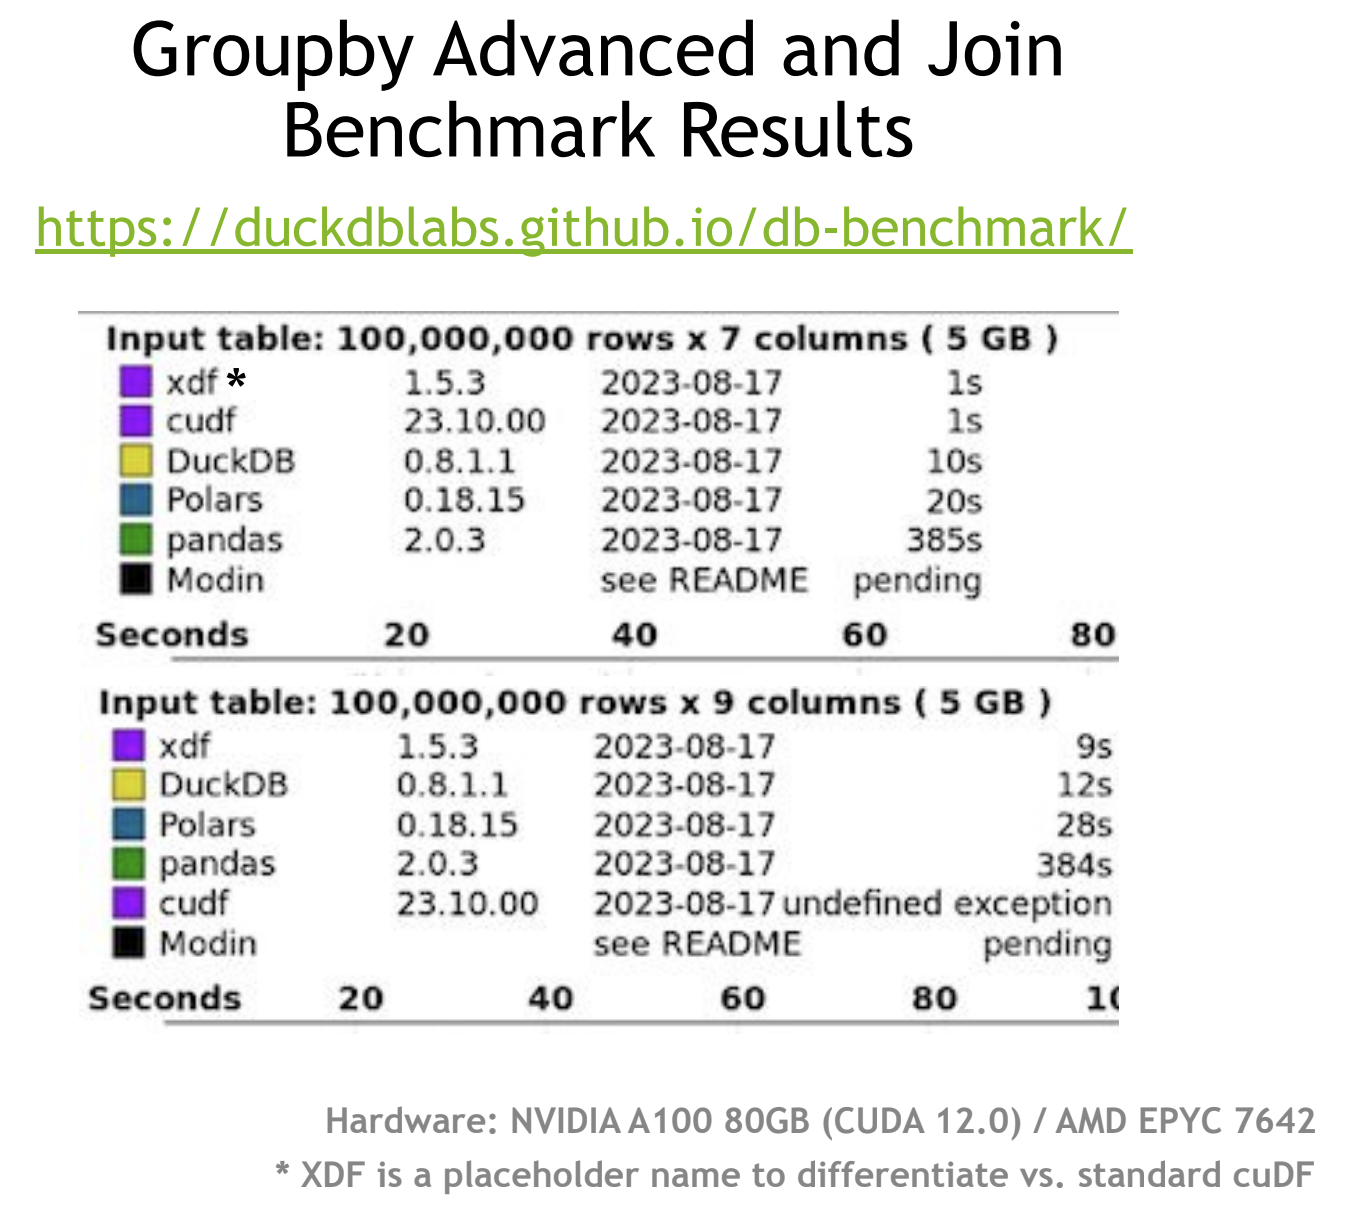
Imagen con copyright de NVIDIA.
NVIDIA probó pandas Accelerator Mode frente a otras herramientas de manipulación de datos en Python de alto rendimiento usando el benchmark Database-like ops de DuckDB. Este conjunto de retos de manipulación de datos mide la capacidad de una tecnología para tareas como calcular estadísticas agrupadas y realizar joins entre tablas con grandes volúmenes de datos.
Según NVIDIA, pandas Accelerator Mode (indicado como xdf en la imagen) ocupa el primer puesto en el benchmark. Es relevante porque la versión estándar de cuDF falla actualmente la prueba de joins al no poder realizar todas las operaciones requeridas en GPU. (Tendrías que combinar cuDF con otra herramienta para que todo funcionara.)
Conviene señalar que NVIDIA realizó la prueba con una GPU tope de gama NVIDIA A100 de 80 GB, y no se especifica la CPU utilizada. El rendimiento que obtengas variará según tu hardware, tu conjunto de datos y los cálculos que quieras realizar.
Veamos cómo empezar a usar Accelerator Mode en pandas:
La versión más reciente de cuDF, que incluye pandas Accelerator Mode, se llama cudf-cu11. Está disponible mediante una instalación estándar con pip, con la salvedad de que, por ahora, debes obtenerla del repositorio de PyPi de NVIDIA.
Ejecuta este comando para instalar el paquete.
pip install cudf-cu11 index-url=https://pypi.nvidia.comSi estás en un cuaderno de Juypter, antepone un signo de exclamación al comando
!pip install cudf-cu11 index-url=https://pypi.nvidia.comPara activar pandas Accelerator Mode en un cuaderno de Jupyter, añade la siguiente línea de código en una celda al principio del cuaderno.
%load_ext cudf.pandasPara activarlo desde una terminal, sustituye el comando estándar para ejecutar un script de Python
python script.py

with

python -m cudf.pandas script.pySimplemente habilita una GPU y luego escribe y ejecuta tu código de pandas como siempre.
En un cuaderno, añade %%cudf.pandas.profile a la celda que quieras perfilar.
Obtendrás estadísticas (por llamada de función o línea a línea) sobre el número de llamadas a GPU y CPU y el tiempo empleado en cada una.
Si usas cuDF, es probable que te importe cuánto tarda en ejecutarse tu código. Para optimizarlo, necesitas poder medirlo. La técnica para medir el tiempo de ejecución de un fragmento de código se llama profiling (perfilado). pandas Accelerator Mode incluye una herramienta de perfilado para el código que se ejecuta en cuadernos de Jupyter.
Para perfilar el código de una celda, añade esta línea al inicio de la celda.
%%cudf.pandas.profileCuando ejecutes el código, verás estadísticas, ya sea por llamada de función o línea a línea, sobre cuánto tiempo se ha dedicado a calcular en GPU y en CPU.
En el momento del anuncio, todo el código de pandas estaba soportado con dos excepciones: las DataFrames de pandas 2.0 basadas en Apache Arrow aún no estaban soportadas, aunque el soporte estaba en desarrollo. En segundo lugar, el código de pandas compilado generado por Numba o Cython no está totalmente soportado.
En ambos casos, el código no soportado por cuDF se ejecutará en CPU.
Si te interesa saber cómo usan cuDF los científicos de datos, escucha este episodio de DataFramed: Becoming a Kaggle Grandmaster con Jean-Francois Puget, Distinguished Engineer en NVIDIA y Kaggle Grandmaster.
Puedes aprender a trabajar con big data en Python usando PySpark en el itinerario de habilidades Big Data with PySpark.
Por último, no te pierdas las últimas novedades de NVIDIA, que anunció la aceleración por GPU en scikit-learn, UMAP y HDBSCAN. Lee y aprende cómo hacer que tus bibliotecas de machine learning en Python se ejecuten en GPU.
¡Empieza hoy tu camino con pandas!
Curso
Curso
Curso
blog
Abid Ali Awan
7 min
Tutorial
Karlijn Willems
15 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Satyam Tripathi
9 min
Tutorial
DataCamp Team
7 min
Tutorial
Kurtis Pykes
10 min