Kurs
Datenbearbeitung mit pandas
4 Std.
564.5K
NVIDIA hat einen "pandas Accelerator Mode" für sein cuDF-Paket angekündigt, mit dem du leistungsstarken pandas-Code für Datenmanipulation in Python schreiben kannst. Das ist ein weiterer Schritt hin zu dem Traum, menschenlesbaren Python-Code zu schreiben, der auch bei großen Datensätzen schnell läuft.
In diesem Beitrag zeigen wir, wie er dir hilft, wie du startest und welche Alternativen es gibt.
pandas ist das beliebteste Paket für Datenmanipulation in Python, mit 144 Millionen Downloads im letzten Monat. Ein großer Teil der Beliebtheit von pandas beruht auf der einfachen Bedienung und dem umfassenden Funktionsumfang für Datenmanipulation.
Leider liegt die lange Entwicklungshistorie von pandas—die erste öffentliche Version stammt aus dem Jahr 2011—vor vielen Innovationen im High-Performance-Computing (HPC). Daher ist pandas-Code für große Datensätze oft zu langsam.
Es gab zahlreiche Versuche, dieses Problem zu lösen. Ziel ist es, denselben pandas-Code zu schreiben, den Millionen kennen, der aber schneller läuft. Zu den leistungsstarken pandas-Alternativen zählen Polars, das durch ein Backend in Rust beschleunigt; PySpark, das eine Python-Schnittstelle zur Spark-HPC-Plattform bietet; Vaex, das mit Out-of-Memory-Berechnungen arbeitet; und DuckDB, das Berechnungen in einer für Analysen optimierten Datenbank ausführt.
Sieh dir diese Tutorials an, die einige Alternativen ausführlicher beleuchten:
NVIDIA entwickelt mit RAPIDS eine Suite für High-Performance Data Science. Dazu gehört cuDF, NVIDIAs Python-Paket für performanten pandas-Code. (Der Name kombiniert CUDA, NVIDIAs Low-Level-Toolkit für GPU-fähige Anwendungen, und DataFrame, das pandas-Objekt zur Speicherung von Analysedaten. Letzteres inspirierte auch den Namen des DataFramed-Podcasts von DataCamp.)
Der Trick von cuDF, Datenmanipulationscode zu beschleunigen, besteht darin, ihn auf einer GPU statt auf einer CPU auszuführen. GPUs wurden zwar für Grafikberechnungen entwickelt, sind aber für Data-Science-Workloads ausgesprochen effektiv.
Obwohl cuDF sehr erfolgreich dabei ist, pandas-Code schneller auszuführen, gab es mehrere Hürden, die eine breite Nutzung gebremst haben.
Ein großer Hemmschuh ist, dass cuDF nur rund 60% der Pandas-API implementiert. Das heißt, nur etwa 60% des möglichen pandas-Codes lassen sich in cuDF ausführen. Diese 60% decken naturgemäß die häufigsten Anwendungsfälle ab. Für Analysen im Tagesgeschäft ist cuDF also in Ordnung. Versuchst du jedoch etwas Ungewöhnliches, stößt du an Grenzen.
cuDF unterstützt die Ausführung nur auf GPUs. Du brauchst also eine GPU sowohl bei der Entwicklung als auch beim Testen. Lokal auf einem Laptop ist das oft nicht machbar, und in der Cloud wird es schnell teuer.
Ein weiteres Problem: Die große Mehrheit der Python-Pakete ist nicht GPU-fähig. Für Analysen, die andere Pakete einbinden—also praktisch jeden Machine-Learning-Workflow—musst du dann die Rechenlast zwischen GPU und CPU hin- und herschieben.
In Summe bedeutete das: Du musstest zwei Codevarianten pflegen—eine für Fälle mit GPU und vollständiger cuDF-Unterstützung und eine für Umgebungen ohne GPU.
Die meisten Data Scientists möchten lieber Erkenntnisse aus Daten gewinnen, statt sich mit solchen Code-Details aufzuhalten. Das machte cuDF historisch für viele Aufgaben unattraktiv.
Die Lösung des pandas Accelerator Mode: Du fügst nur eine einzige Codezeile hinzu, um GPU-Support zu aktivieren, und schreibst dann ganz normalen pandas-Code.
Wenn GPU-Berechnung möglich ist (eine NVIDIA-GPU ist verfügbar und cuDF kann den pandas-Code ausführen), läuft dein Code auf der GPU. Wo das nicht geht, wechselt cuDF automatisch auf die CPU. Du brauchst also keine zwei Codevarianten und musst den Wechsel zwischen GPU und CPU nicht manuell steuern.
Bildrechte NVIDIA.
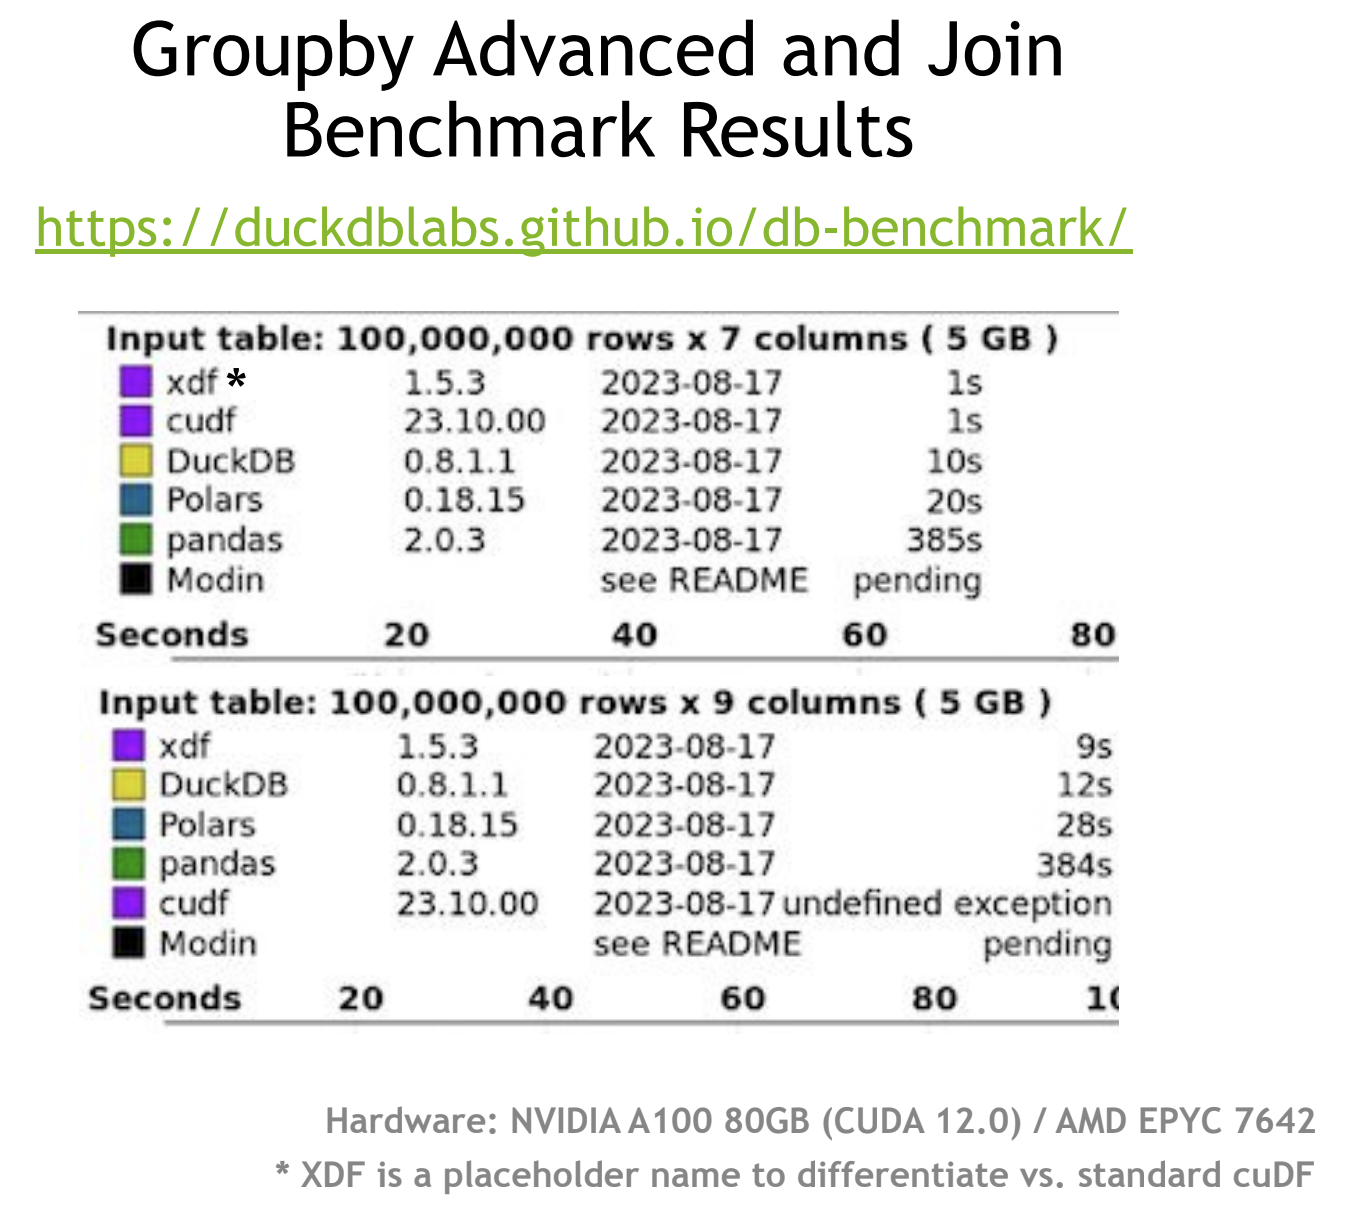
NVIDIA hat den pandas Accelerator Mode gegen andere leistungsfähige Python-Tools zur Datenmanipulation im DuckDB Database-like ops Benchmark getestet. Dieses Set an Datenmanipulationsaufgaben misst, wie gut eine Technologie Aufgaben wie gruppierte Kennzahlen und Joins auf großen Datensätzen bewältigt.
Laut NVIDIA belegt der pandas Accelerator Mode (im Bild als xdf bezeichnet) den ersten Platz im Benchmark. Bemerkenswert ist, dass die Standardversion von cuDF aktuell beim Join-Test scheitert, da nicht alle erforderlichen Operationen auf der GPU ausgeführt werden können. (Man müsste cuDF mit einem weiteren Tool kombinieren.)
Zu beachten ist, dass NVIDIA mit der High-End-GPU NVIDIA A100 80GB getestet hat und die verwendete CPU nicht spezifiziert wurde. Deine Performance hängt von deiner Hardware, deinem Datensatz und den geplanten Berechnungen ab.
Schauen wir uns an, wie du den Accelerator Mode in pandas aktivierst:
Die neueste cuDF-Version mit pandas Accelerator Mode heißt cudf-cu11. Sie ist per gewöhnlicher pip-Installation verfügbar, derzeit jedoch über das NVIDIA-PyPi-Repository.
Führe diesen Befehl aus, um das Paket zu installieren.
pip install cudf-cu11 index-url=https://pypi.nvidia.comWenn du in einem Juypter-Notebook arbeitest, setze ein Ausrufezeichen voran.
!pip install cudf-cu11 index-url=https://pypi.nvidia.comUm den pandas Accelerator Mode in einem Jupyter-Notebook zu aktivieren, füge früh im Notebook in einer Zelle folgende Zeile ein.
%load_ext cudf.pandasUm den pandas Accelerator Mode im Terminal zu aktivieren, ersetze den Standardbefehl zum Ausführen eines Python-Skripts
python script.py

with

python -m cudf.pandas script.pyAktiviere einfach eine GPU und schreibe und führe deinen pandas-Code wie gewohnt aus.
In einem Notebook füge %%cudf.pandas.profile in die Zelle ein, die du profilieren möchtest.
Du erhältst Statistiken (nach Funktionsaufruf oder zeilenweise) zur Anzahl der GPU- und CPU-Aufrufe sowie zur Zeit auf jeder Processing Unit.
Wenn du cuDF nutzt, spielt die Laufzeit deines Codes wahrscheinlich eine große Rolle. Um zu optimieren, musst du messen können. Das Verfahren dafür heißt Profiling. Der pandas Accelerator Mode bietet ein Profiling-Tool für Code, der in Jupyter-Notebooks läuft.
Um den Code in einer Zelle zu profilieren, füge zu Beginn der Zelle diese Zeile ein.
%%cudf.pandas.profileBeim Ausführen siehst du Statistiken—entweder pro Funktionsaufruf oder zeilenweise—darüber, wie viel Zeit auf der GPU und auf der CPU gerechnet wurde.
Zum Zeitpunkt der Ankündigung wurde nahezu der gesamte pandas-Code unterstützt, mit zwei Ausnahmen: pandas-2.0-DataFrames auf Basis von Apache Arrow waren noch nicht unterstützt, Support war jedoch in Arbeit. Außerdem ist kompilierter pandas-Code, der von Numba oder Cython erzeugt wird, nicht vollständig unterstützt.
In beiden Fällen läuft der von cuDF nicht unterstützte Code auf der CPU.
Wenn du wissen willst, wie Data Scientists cuDF einsetzen, hör in diese DataFramed-Folge rein: Becoming a Kaggle Grandmaster mit Jean-Francois Puget, Distinguished Engineer bei NVIDIA und Kaggle Grandmaster.
Du kannst lernen, wie du mit großen Datenmengen in Python mithilfe von PySpark arbeitest—im Skill-Lernpfad Big Data with PySpark.
Und bleib auf dem Laufenden über die neuesten Entwicklungen von NVIDIA, das kürzlich GPU-Beschleunigung in scikit-learn, UMAP und HDBSCAN angekündigt hat. Lies nach und erfahre, wie du deine Python-ML-Bibliotheken auf GPUs laufen lässt.
Starte heute deine pandas-Reise!
Kurs
Kurs
Kurs
Tutorial
DataCamp Team
3 Min.
Tutorial
Aditya Sharma
5 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Adel Nehme
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Stephen Gruppetta
12 Min.