Curso
Manipulação de dados com pandas
4 h
564.5K
A NVIDIA anunciou um "modo pandas Accelerator" para o pacote cuDF, que permite escrever código pandas de alta performance para manipulação de dados em Python. É mais um passo rumo ao sonho de escrever código Python legível que roda rápido, mesmo com conjuntos de dados gigantes.
Neste post, vamos explicar como isso pode ajudar você, como começar e quais são as alternativas.
pandas é o pacote de manipulação de dados mais popular do Python, com 144 milhões de downloads no último mês. Grande parte dessa popularidade vem da facilidade de uso e do conjunto amplo de recursos para manipulação de dados.
Infelizmente, o longo histórico de desenvolvimento do pandas — lançado publicamente em 2011 — faz com que ele anteceda muitas inovações em computação de alta performance (HPC). Resultado: código em pandas pode rodar devagar demais para ser útil em grandes volumes de dados.
Várias iniciativas tentaram resolver esse problema. A meta é permitir escrever o mesmo código pandas que milhões de usuários já conhecem, mas executá-lo muito mais rápido. Algumas alternativas de alta performance ao pandas incluem o Polars, que acelera o processamento com backend em Rust; o PySpark, que oferece uma interface Python para a plataforma HPC Spark; o Vaex, que usa computação out-of-memory; e o DuckDB, que realiza o processamento dentro de um banco otimizado para analytics.
Confira estes tutoriais, que detalham algumas alternativas:
A NVIDIA vem desenvolvendo um conjunto de ferramentas para data science de alta performance chamado RAPIDS. Esse toolbox inclui o cuDF, o pacote Python da NVIDIA para executar código no estilo pandas com alta performance. (O nome combina CUDA, o kit de ferramentas de baixo nível da NVIDIA para apps com GPU, e DataFrame, o objeto do pandas para armazenar dados analíticos. Este último inspirou o nome do podcast DataFramed da DataCamp.)
O truque do cuDF para acelerar a manipulação de dados é executar o código em GPU em vez de CPU. Embora tenham sido criadas para gráficos, as GPUs são incrivelmente eficientes para computações de data science.
Apesar do sucesso do cuDF em acelerar código estilo pandas, havia algumas questões que impediram sua adoção em larga escala.
Um grande entrave é que o cuDF implementa cerca de 60% da API do pandas. Ou seja, apenas em torno de 60% de todo o código possível no pandas roda no cuDF. Naturalmente, esses 60% cobrem as operações mais comuns que a maioria das pessoas quer executar no dia a dia, então, para análises rotineiras, o cuDF costuma dar conta. Mas, se você precisar de algo mais fora do padrão, pode esbarrar em limitações.
O cuDF só suporta execução em GPUs. Isso exige uma GPU tanto no desenvolvimento quanto nos testes. Muitas vezes isso é inviável localmente, num notebook, e caro ao rodar na nuvem.
Outra questão é que a grande maioria dos pacotes Python não é compatível com GPU. Para qualquer análise que use outras bibliotecas — por exemplo, praticamente qualquer workflow de machine learning — você teria de gerenciar a troca da computação entre GPU e CPU e vice-versa.
Somados, esses três problemas faziam com que você precisasse escrever duas versões do seu código: uma para quando há GPUs disponíveis e o cuDF consegue executar tudo, e outra para quando não há GPU.
A maioria dos cientistas de dados prefere focar em extrair insights dos dados, não em detalhes de infraestrutura. Historicamente, isso tornava o uso do cuDF problemático para muitas tarefas.
A solução trazida pelo modo pandas Accelerator é que basta uma única linha para habilitar o suporte a GPU, e então você escreve código pandas padrão.
Quando houver suporte à execução em GPU (há uma GPU NVIDIA disponível e o cuDF sabe como rodar aquele código pandas), seu código roda na GPU. Nos casos em que isso não for possível, o cuDF alterna automaticamente para CPU. Você não precisa manter duas versões do código nem fazer a troca manual entre GPU e CPU.
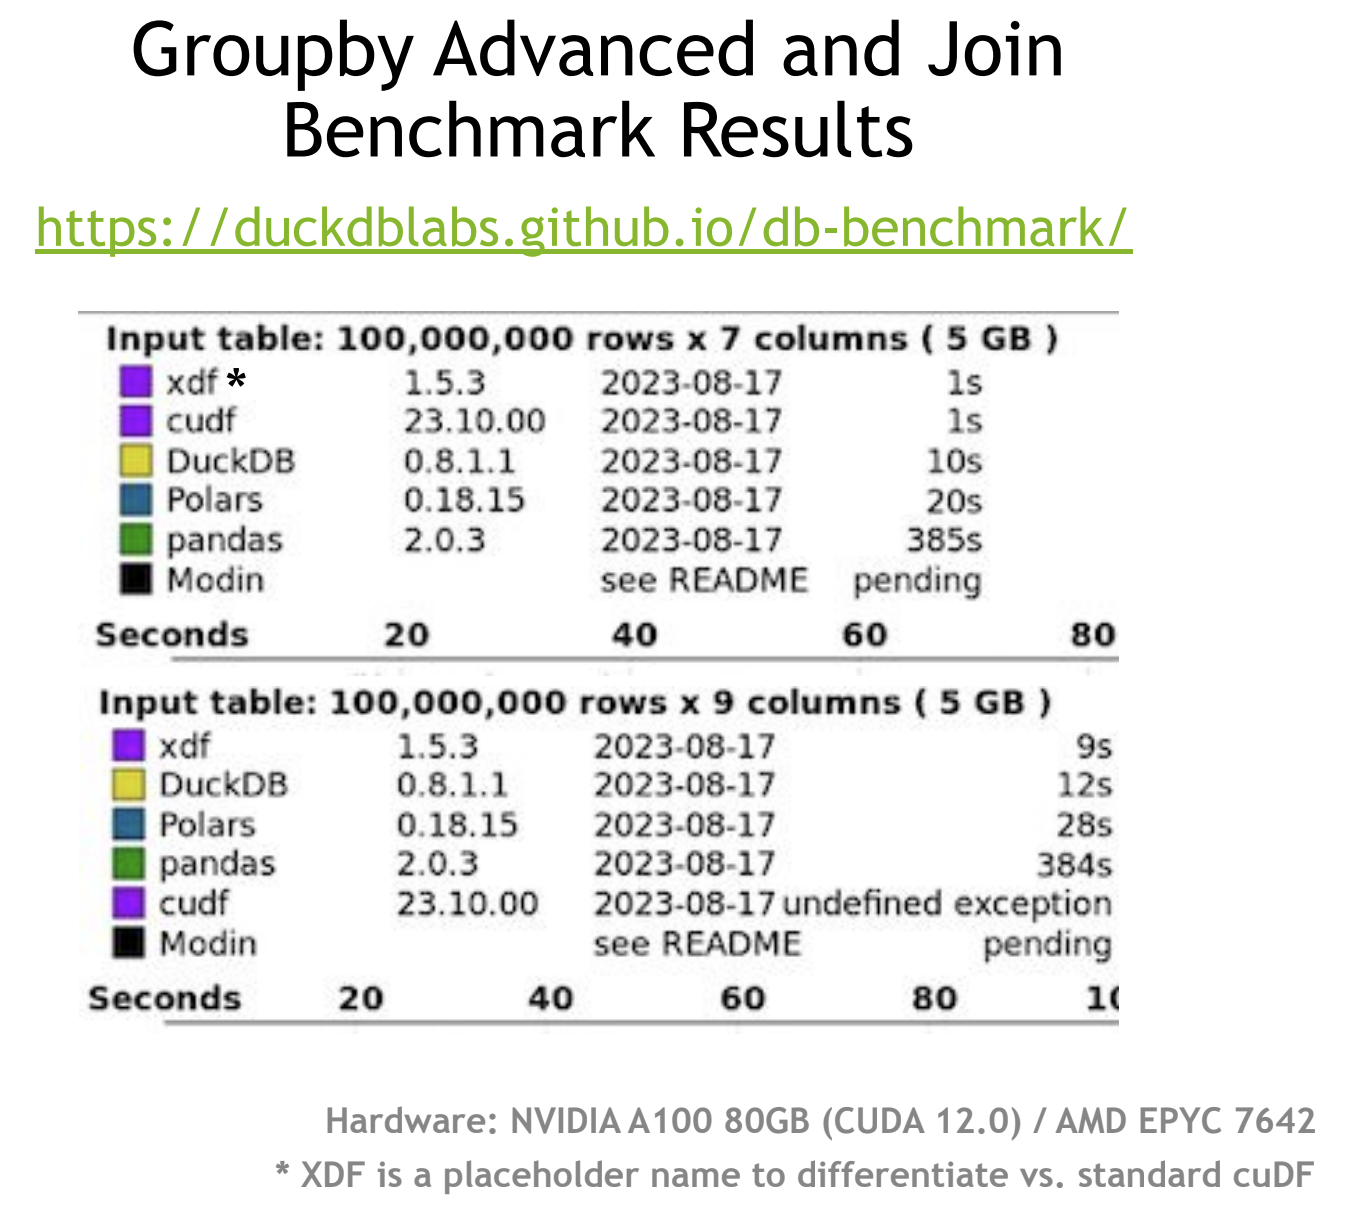
Imagem com direitos autorais da NVIDIA.
A NVIDIA testou o modo pandas Accelerator contra outras ferramentas Python de alta performance para manipulação de dados no benchmark DuckDB Database-like ops. Esse conjunto de desafios mede quão bem uma tecnologia executa tarefas como estatísticas agregadas por grupos e junções entre tabelas em grandes volumes de dados.
Segundo a NVIDIA, o modo pandas Accelerator (indicado como xdf na imagem) ficou em primeiro lugar no benchmark. Isso chama atenção porque a versão padrão do cuDF atualmente falha no teste de join, já que não consegue realizar todas as operações necessárias em GPU. (Seria preciso combinar o cuDF com outra ferramenta para fechar o pipeline.)
Vale observar que os testes foram feitos na GPU topo de linha NVIDIA A100 80GB, e a CPU utilizada não foi especificada. Seu desempenho vai variar conforme o hardware, o dataset e os cálculos que você quer fazer.
Veja como começar a usar o Accelerator Mode no pandas:
A versão mais recente do cuDF, que inclui o modo pandas Accelerator, é chamada cudf-cu11. Ela está disponível via pip padrão, com a ressalva de que, por enquanto, você precisa instalar a partir do repositório PyPi da NVIDIA.
Execute este comando para instalar o pacote.
pip install cudf-cu11 index-url=https://pypi.nvidia.comSe você estiver em um notebook Jupyter, prefixe o comando com um ponto de exclamação
!pip install cudf-cu11 index-url=https://pypi.nvidia.comPara habilitar o modo pandas Accelerator em um notebook Jupyter, adicione a linha abaixo em uma célula perto do início do notebook.
%load_ext cudf.pandasPara habilitar o modo pandas Accelerator pelo terminal, substitua o comando padrão de execução do script Python
python script.py

with

python -m cudf.pandas script.pyBasta ter uma GPU habilitada e escrever/rodar seu código pandas como de costume.
Em um notebook, adicione %%cudf.pandas.profile à célula que você quer analisar.
Você recebe estatísticas (por chamada de função ou linha a linha) sobre o número de chamadas à GPU e à CPU, além do tempo gasto em cada processador.
Se você usa cuDF, é provável que o tempo de execução do seu código seja importante. Para otimizar, é preciso medir. A técnica para medir o tempo de execução é chamada de profiling. O modo pandas Accelerator oferece uma ferramenta de profiling para código executado em notebooks Jupyter.
Para fazer o profiling do código de uma célula, adicione a seguinte linha ao início da célula.
%%cudf.pandas.profileAo executar, você verá estatísticas, por função ou linha a linha, de quanto tempo foi gasto em GPU e em CPU.
No momento do anúncio, todo o código pandas era suportado com duas exceções: DataFrames do pandas 2.0 baseados em Apache Arrow ainda não eram suportados, embora já houvesse desenvolvimento em andamento. Além disso, código pandas compilado gerado por Numba ou Cython não tem suporte total.
Em ambos os casos, o código não suportado pelo cuDF será executado na CPU.
Se você quer saber como cientistas de dados usam o cuDF, ouça este episódio do DataFramed: Becoming a Kaggle Grandmaster, com Jean-Francois Puget, Distinguished Engineer na NVIDIA e Kaggle Grandmaster.
Você pode aprender a trabalhar com big data em Python usando PySpark na trilha de habilidades Big Data with PySpark.
Por fim, fique por dentro das novidades da NVIDIA, que anunciou aceleração por GPU no scikit-learn, UMAP e HDBSCAN. Leia e descubra como fazer suas bibliotecas de machine learning em Python rodarem em GPUs.
Comece sua jornada com pandas hoje!
Curso
Curso
Curso
Tutorial
Karlijn Willems
15 min
Tutorial
Vidhi Chugh
15 min
Tutorial
Satyam Tripathi
9 min
Tutorial
Elena Kosourova
8 min
Tutorial
DataCamp Team
7 min
Tutorial
Kurtis Pykes
11 min