
Op weg naar de droom van high-performance pandas-code
Het probleem met pandas
pandas is het populairste pakket voor datamanipulatie in Python, met 144 miljoen downloads vorige maand. Een groot deel van de populariteit van pandas komt door het gebruiksgemak en de uitgebreide set functies voor datamanipulatie.
Helaas betekent de lange ontwikkelgeschiedenis van pandas—het werd in 2011 voor het eerst publiekelijk beschikbaar—dat het veel innovaties in high-performance computing (HPC) voorafgaat. Daardoor draait pandas-code te langzaam om nuttig te zijn voor grote datasets.
Veel pogingen om pandas sneller te maken
Er zijn veel pogingen gedaan om dit probleem op te lossen. Het doel is om dezelfde pandas-code te kunnen schrijven waar miljoenen gebruikers mee vertrouwd zijn, maar die dan sneller draait. Enkele high-performance alternatieven voor pandas zijn Polars, dat dingen versnelt door de backend in Rust te herschrijven; PySpark, dat een Python-interface biedt naar het Spark-HPC-platform; Vaex, dat gebruikmaakt van out-of-memory-berekeningen; en DuckDB, dat berekeningen uitvoert binnen een voor analytics geoptimaliseerde database.
Bekijk deze tutorials, die enkele van de alternatieven in meer detail bespreken:
- High Performance Data Manipulation in Python: pandas 2.0 vs. polars
- Benchmarking High-Performance pandas Alternatives
- An Introduction to DuckDB: What is It and Why Should You Use It?
NVIDIA's oplossing voor snellere pandas
NVIDIA ontwikkelt een reeks tools voor high-performance data science genaamd RAPIDS. Deze toolbox bevat cuDF, NVIDIA's Python-pakket voor high-performance pandas-code. (De naam combineert CUDA, NVIDIA's low-level toolkit voor het bouwen van GPU-enabled applicaties, en DataFrame, het pandas-object voor het opslaan van analytics-data. Het laatste inspireerde de naam van DataCamp's DataFramed-podcast.)
De truc van cuDF om datamanipulatiecode te versnellen, is door de code op een GPU in plaats van een CPU te laten draaien. Hoewel oorspronkelijk ontworpen voor berekeningen om graphics weer te geven, zijn GPU's ongelooflijk effectief bij data science-berekeningen.
cuDF had problemen
Hoewel cuDF erg succesvol is geweest in het sneller laten draaien van pandas-code, had het verschillende issues die brede adoptie in de weg stonden.
Niet alle onderdelen van pandas worden ondersteund
Een grote blokkade is dat cuDF slechts ongeveer 60% van de Pandas API implementeert. Met andere woorden, slechts zo'n 60% van alle mogelijke code die je in pandas kunt schrijven, kan in cuDF worden uitgevoerd. De 60% die wel kan draaien is natuurlijk de meest voorkomende 60% van de code die de meeste mensen willen draaien. Voor dagelijkse analyses zou cuDF-code dus prima moeten zijn. Maar als je iets wat ongebruikelijker wilt doen, loop je met cuDF tegen problemen aan.
Een GPU was vereist voor ontwikkeling en testen
cuDF ondersteunt het draaien van code alleen op GPU's. Dat betekent dat je een GPU nodig hebt bij het ontwikkelen van de code en bij het testen. Dit is vaak onhaalbaar als je code lokaal op een laptop wilt draaien en duur als je je code in de cloud wilt draaien.
Interactie met andere Python-pakketten vereiste wisselen tussen processors
Een ander probleem is dat de overgrote meerderheid van de Python-pakketten niet GPU-enabled is. Dat betekent dat je voor elke analyse die andere pakketten gebruikt—bijvoorbeeld vrijwel elke machine learning-workflow—moet uitzoeken hoe je de berekening van GPU naar CPU en weer terug verplaatst.
De bestaande oplossing voor het gebrek aan GPU's was omslachtig
Samen betekenden deze drie problemen dat je twee versies van je code moest schrijven: één die zou draaien als GPU's beschikbaar waren en cuDF alles kon uitrekenen, en één voor wanneer er geen GPU beschikbaar was.
De meeste data scientists willen zich liever richten op het halen van inzichten uit data dan op dit soort codedetails. Dit maakte het gebruik van cuDF historisch gezien problematisch voor veel data science-taken.
Hoe pandas Accelerator Mode cuDF verbetert
De oplossing die pandas Accelerator Mode voor deze problemen biedt, is dat je maar één regel code hoeft te schrijven om GPU-ondersteuning in te schakelen, waarna je standaard pandas-code kunt schrijven.
Wanneer GPU-berekening wordt ondersteund (er is een NVIDIA-GPU beschikbaar en cuDF weet hoe het de pandas-code moet draaien), draait je code op de GPU. In gevallen waar dit niet mogelijk is, schakelt cuDF automatisch over naar draaien op de CPU. Je hoeft geen twee versies van je code te schrijven en je hoeft het schakelen tussen GPU en CPU niet handmatig af te handelen.
Is pandas Accelerator Mode sneller dan de alternatieven?
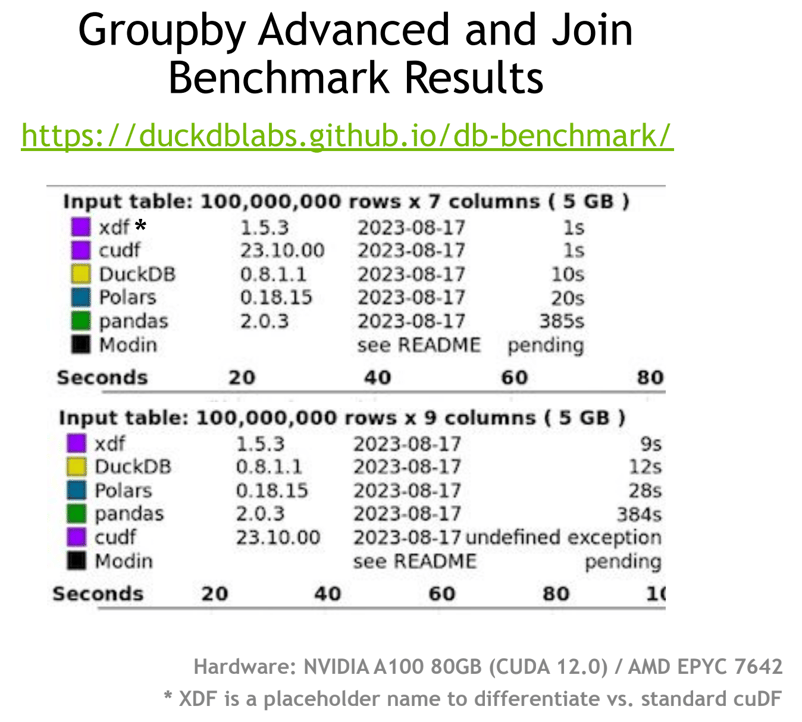
Afbeelding auteursrecht NVIDIA.
NVIDIA testte pandas Accelerator Mode tegen andere high-performance tools voor datamanipulatie in Python op de DuckDB Database-like ops benchmark. Deze reeks uitdagingen voor datamanipulatie meet hoe goed een technologie taken kan uitvoeren zoals gegroepeerde samenvattende statistieken en table joins op grote datasets.
Volgens NVIDIA komt pandas Accelerator Mode (aangeduid als xdf in de afbeelding) als eerste uit de benchmark. Dit is opmerkelijk omdat de standaardversie van cuDF momenteel faalt op de join-test, aangezien het niet alle vereiste bewerkingen op de GPU kan uitvoeren. (Je zou cuDF met een andere tool moeten combineren om alles te laten werken.)
Let wel dat NVIDIA dit testte op de topklasse NVIDIA A100 80GB GPU, en dat de gebruikte CPU niet is gespecificeerd. Je prestaties variëren afhankelijk van je hardware-opstelling, je dataset en de berekeningen die je wilt uitvoeren.
Hoe kan ik pandas Accelerator Mode gebruiken?
Laten we kijken hoe je aan de slag kunt gaan met Accelerator Mode in pandas:
De nieuwste cuDF installeren
De nieuwste versie van cuDF, die pandas Accelerator Mode bevat, heet cudf-cu11. Deze is beschikbaar via een standaard pip-installatie, met de kanttekening dat je hem momenteel uit de NVIDIA PyPi-repository moet halen.
Voer deze code uit om het pakket te installeren.
pip install cudf-cu11 index-url=https://pypi.nvidia.comAls je in een Juypter-notebook draait, zet dan een uitroepteken voor de code
!pip install cudf-cu11 index-url=https://pypi.nvidia.compandas Accelerator Mode inschakelen in een Jupyter-notebook
Om pandas Accelerator Mode in te schakelen in een Jupyter-notebook, voeg je de volgende regel code toe in een cel aan het begin van je notebook.
%load_ext cudf.pandaspandas Accelerator Mode inschakelen via een terminal
Om pandas Accelerator Mode via een terminal in te schakelen, vervang je de standaardopdracht om een Python-script te draaien
python script.py
with
python -m cudf.pandas script.pyWat moet ik nog meer doen?
Schakel simpelweg een GPU in en schrijf en draai vervolgens je pandas-code zoals gewoonlijk.
Kan ik code in pandas Accelerator Mode profileren?
-
In een notebook,
add %%cudf.pandas.profileaan de cel die je wilt profileren. -
Je krijgt statistieken (per functieaanroep of regel voor regel) over het aantal GPU- en CPU-aanroepen + de tijd die op elke PU is besteed.
Als je cuDF gebruikt, is de looptijd van je code waarschijnlijk belangrijk voor je. Om dit te optimaliseren, moet je het kunnen meten. De techniek om te meten hoelang code nodig heeft om te draaien, heet profileren. pandas Accelerator Mode biedt een profilingtool voor code die in Jupyter-notebooks wordt uitgevoerd.
Om de code in een cel te profileren, voeg je de volgende regel toe aan het begin van de cel.
%%cudf.pandas.profileWanneer je de code uitvoert, krijg je statistieken, per functieaanroep of regel voor regel, over hoeveel tijd werd besteed aan berekeningen op de GPU en op de CPU.
Wordt alle pandas-code ondersteund?
Op het moment van de aankondiging werd alle pandas-code ondersteund met twee uitzonderingen: pandas 2.0 DataFrames die zijn gebouwd op Apache Arrow werden nog niet ondersteund, hoewel ondersteuning in ontwikkeling was. Ten tweede wordt gecompileerde pandas-code die is gegenereerd door Numba of Cython niet volledig ondersteund.
In beide gevallen wordt code die niet door cuDF wordt ondersteund, op een CPU uitgevoerd.
Blijf leren
Als je geïnteresseerd bent in hoe data scientists cuDF gebruiken, luister dan naar deze aflevering van DataFramed: Becoming a Kaggle Grandmaster met Jean-Francois Puget, Distinguished Engineer bij NVIDIA en Kaggle Grandmaster.
Je kunt leren werken met big data in Python met PySpark in de skill track Big Data with PySpark.
Blijf tot slot op de hoogte van de nieuwste ontwikkelingen van NVIDIA, dat GPU-acceleratie in scikit-learn, UMAP en HDBSCAN aankondigde. Lees en leer hoe je je Python machine learning-bibliotheken op GPU's kunt laten draaien.
Richie helpt individuen en organisaties om beter met data en AI te werken. Hij is al data scientist sinds voordat het zo heette, en heeft twee boeken geschreven en veel DataCamp-cursussen over dit onderwerp gemaakt. Hij is host van de DataFramed-podcast en leidt het webinarprogramma van DataCamp.
Chat met AI Richie over elke aflevering van DataFramed - alle datahelden zijn welkom!


NVIDIA kondigde een "pandas Accelerator Mode" aan voor hun cuDF-pakket, waarmee je high-performance pandas-code kunt schrijven voor datamanipulatie in Python. Het is opnieuw een stap richting de droom om menselijk leesbare Python-code te schrijven die snel draait, zelfs op grote datasets.
In deze post leggen we uit hoe dit jou kan helpen, hoe je begint en wat de alternatieven zijn.