

Kurs
pandas ile Veri İşleme
4 sa
567.9K
Alıştırma and program your progress.
Google Ile Devam EdinNVIDIA, cuDF paketine yönelik bir “pandas Accelerator Mode” duyurdu ve bu sayede Python’da veri manipülasyonu için yüksek performanslı pandas kodu yazmanıza olanak tanıdı. Bu, büyük veri kümele rinde bile hızlı çalışan, insanların kolayca okuyabileceği Python kodu yazma hayaline doğru atılan başka bir adım.
Bu yazıda, söz konusu modun size nasıl yardımcı olabileceğini, nasıl başlayacağınızı ve alternatiflerin neler olduğunu ele alıyoruz.
pandas, geçen ay 144 milyon indirme ile Python için en popüler veri manipülasyonu paketidir. pandas’ın popülerliğinin büyük bir kısmı, kullanım kolaylığı ve veri manipülasyonu için geniş özellik setinden gelir.
Ne yazık ki pandas’ın geniş geliştirme geçmişi—ilk olarak 2011’de herkese açıklandı—yüksek performanslı hesaplama (HPC) alanındaki pek çok yenilikten önceye dayanır. Bu da pandas kodunun büyük veri kümele rinde işe yarayacak kadar hızlı çalışmadığı anlamına gelir.
Bu sorunu çözmek için pek çok girişim oldu. Amaç, milyonlarca kullanıcının aşina olduğu aynı pandas kodunu yazabilmek ancak bunu daha hızlı çalıştırmaktır. Bazı yüksek performanslı pandas alternatifleri arasında, arka ucu Rust ile yeniden yazarak hız kazandıran Polars; Spark HPC platformuna Python arabirimi sağlayan PySpark; belleğ e sığanmay an hesaplama kullanan Vaex; ve analitik için optimize edilmiş bir veritabanı içinde hesaplama yapan DuckDB bulunur.
Bazı alternatifleri daha ayrıntılı tartışan bu eğiticileri inceleyin:
NVIDIA, yüksek performanslı veri bilimi için RAPIDS adlı bir araç seti geliştiriyor. Bu araç seti, NVIDIA’nın yüksek performanslı pandas kodu için Python paketi olan cuDF’yi içerir. (Adı, NVIDIA’nın GPU destekli uygulamalar inşa etmek için düşük seviye araç takımı CUDA ile, analitik verileri depolamak için pandas nesnesi olan DataFrame’in birleşiminden gelir. Sonuncusu, DataCamp’in DataFramed podcast’inin adına da ilham vermiştir.)
cuDF’in veri manipülasyon kodunu hızlandırma yöntemi, kodu CPU yerine GPU’da çalıştırmaktır. Aslen grafik görüntüleme hesaplamaları için tasarlanmış olsalar da GPU’lar, veri bilimi hesaplamalarında olağanüstü derecede etkilidir.
cuDF, pandas kodunu daha hızlı çalıştırmanıza oldukça başarılı bir şekilde olanak tanımış olsa da, yaygın benimsenmesini engelleyen bazı sorunlar vardı.
Büyük bir engel, cuDF’in Pandas API’sinin yalnızca yaklaşık %60’ını gerçekleştirmesiydi. Yani pandas’ta yazabileceğiniz tüm olası kodların yalnızca %60’ı cuDF’de çalışabiliyordu. Doğal olarak bu %60’lık kısım, çoğu kişinin çalıştırmak isteyeceği en yaygın kodlardan oluşuyordu. Bu da günlük analizler için cuDF kodunun genellikle işinizi göreceği anlamına geliyordu. Ancak biraz alışılagelmişin dışına çıkmak istediğinizde cuDF ile sorun yaşardınız.
cuDF yalnızca GPU’larda kod çalıştırmayı destekler. Bu da kodu geliştirirken ve test ederken bir GPU’ya ihtiyacınız olduğu anlamına gelir. Kodu yerelde bir dizüstü bilgisayarda çalıştırmak istiyorsanız bu çoğu zaman mümkün değildir; bulutta çalıştırmak isterseniz de maliyetlidir.
Bir diğer sorun, Python paketlerinin büyük çoğunluğunun GPU destekli olmamasıydı. Yani, diğer paketleri kullanan her tür analizde—örneğin, hemen her makine öğrenmesi iş akışında—hesaplamayı GPU’dan CPU’ya ve tekrar geri nasıl taşıyacağınızı çözmeniz gerekiyordu.
Birlikte ele alındığında bu üc sorun, kodunuzun iki sürümünü yazmanız gerektiği anlamına geliyordu: Biri GPU mevcutsa ve cuDF her şeyi hesaplayabiliyorsa çalışacak olan; diğeri ise GPU olmadığında çalışacak olan.
Çoğu veri bilimci, böyle kod ayrıntılarıyla uğraşmak yerine veriden içgörü çıkarmaya odaklanmak ister. Bu da tarihsel olarak cuDF’in pek çok veri bilimi görevi için sorunlu olmasına yol açmıştır.
pandas Accelerator Mode’un bu sorunlara getirdiği çözüm, GPU desteğini etkinleştirmek için yalnızca bir satır kod yazmanızın yeterli olması ve sonrasında standart pandas kodu yazabilmenizdir.
GPU hesaplama desteklendiğinde (bir NVIDIA GPU mevcutsa ve cuDF pandas kodunu nasıl çalıştıracağını biliyorsa) kodunuz GPU’da çalışır. Bunun mümkün olmadığı durumlarda cuDF otomatik olarak CPU’da çalışmaya geçer. Kodunuzun iki sürümünü yazmanıza gerek kalmaz ve GPU ile CPU arasındaki geçişleri elle yönetmeniz gerekmez.
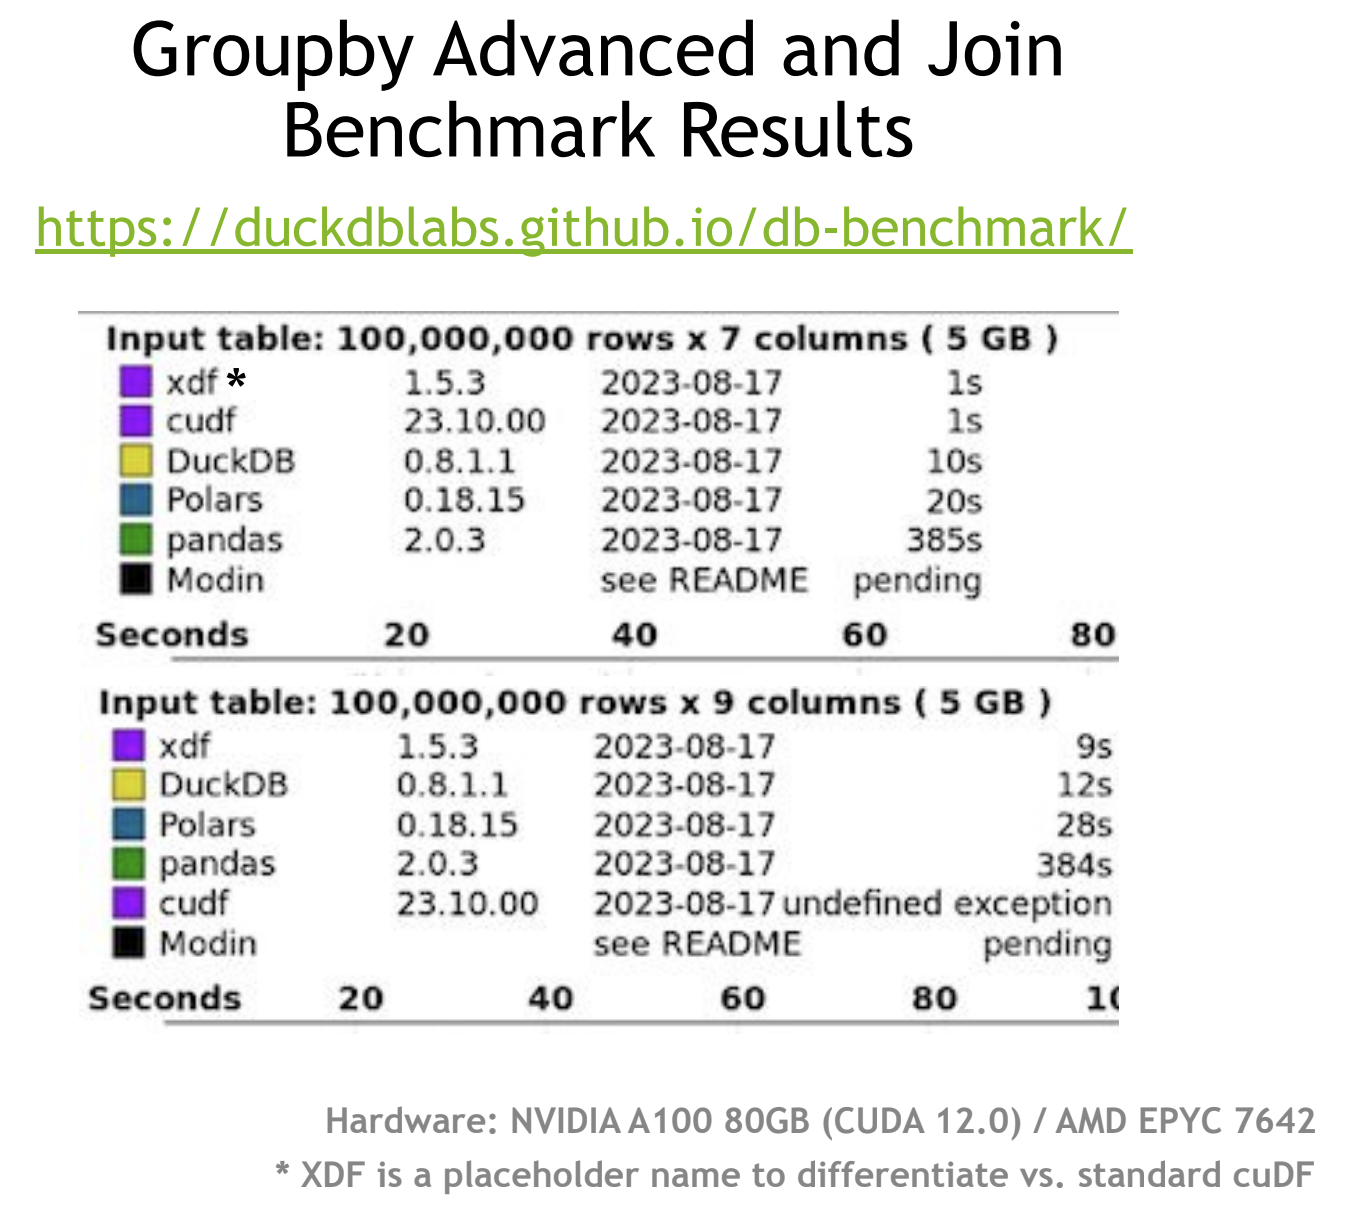
Görsel telif hakkı NVIDIA’ya aittir.
NVIDIA, pandas Accelerator Mode’u diğer yüksek performanslı Python veri manipülasyon araçlarına karşı DuckDB Database-like ops benchmark’ı üzerinde test etti. Bu veri manipülasyon zorlukları dizisi, bir teknolojinin büyük veri kümele rinde gruplanmış özet istatistikler ve tablo birleştirmeleri gibi görevleri ne kadar iyi yerine getirebildiğine dair bir ölçü sağlar.
NVIDIA’ya göre pandas Accelerator Mode (görselde xdf olarak gösteriliyor) kıyaslamada birinci sırayı alıyor. Bu dikkat çekici, çünkü cuDF’in standart sürümü, tüm gerekli işlemleri GPU’da gerçekleştir edemed iği için şu anda join testinde başarısız oluyor. (Her şeyin çalışması için cuDF’i başka bir araçla birlikte kullanmanız gerekir.)
Dikkat edilmesi gereken bir nokta, NVIDIA’nın bunu üst düzey NVIDIA A100 80GB GPU üzerinde test etmiş olması ve kullanılan CPU’nun belirtilmemiş olmasıdır. Donanım kurulumu nuz a, veri kümenize ve yapmak istediğiniz hesaplamalara bağlı olarak performansınız değişecektir.
Hadi pandas içinde Accelerator Mode’u nasıl kullanmaya başlayabileceğinize bakalım:
pandas Accelerator Mode’u içeren cuDF’in en son sürümü, cudf-cu11 olarak adlandırılır. Standart bir pip kurulumuyla edinilebilir; ancak şu an için NVIDIA PyPi deposundan almanız gerekir.
Paketi yüklemek için bu kodu çalıştırın.
pip install cudf-cu11 index-url=https://pypi.nvidia.comBir Juypter not defterinde çalıştırıyorsanız, koda bir ünlem işareti ekleyin
!pip install cudf-cu11 index-url=https://pypi.nvidia.comBir Jupyter not defterinde pandas Accelerator Mode’u etkinleştirmek için, not defterinizin başlarına yakın bir hucreye aşağıdaki kod satırını ekleyin.
%load_ext cudf.pandasTerminalden pandas Accelerator Mode’u etkinleştirmek için, bir Python betiğini çalıştırmanın standart komutunu değiştirin
python script.py

with

python -m cudf.pandas script.pySadece bir GPU’yu etkinleştirin, sonra her zamanki gibi pandas kodunuzu yazıp çalıştırın.
Bir not defterinde, profil almak istediğiniz hucreye add %%cudf.pandas.profile ekleyin.
GPU çağrılarının ve CPU çağrılarının sayısı + her işlem biriminde harcanan süre hakkında (fonksiyon çağrısına göre veya satır satır) istatistikler alırsınız.
cuDF kullanıyorsanız, muhtemelen kodunuzun çalışma süresinin sizin için önemli olması muhtemeldir. Bunu optimize edebilmek için ölçebilmeniz gerekir. Kodun çalışma süresini ölçme tekniğine profil çıkarma denir. pandas Accelerator Mode, Jupyter not defterlerinde çalışan kod için bir profil çıkarma aracı sunar.
Bir hucredeki kodu profillemek için, hucrenin başına aşağıdaki satırı ekleyin.
%%cudf.pandas.profileKodu çalıştırdığınızda, GPU’da ve CPU’da hesaplamaya ne kadar süre harcandığına ilişkin, fonksiyon çağrısına göre veya satır satır istatistikler elde edersiniz.
Duyuru sırasında, iki istisna dışında tüm pandas kodu destekleniyordu: Apache Arrow üzerinde inşa edilen pandas 2.0 DataFrame’leri henüz desteklenmiyordu ancak destek geliştirme aşamasındaydı. İkincisi, Numba veya Cython tarafından üretilen derlenmiş pandas kodu tam olarak desteklenmiyor.
Her iki durumda da, cuDF tarafından desteklenmeyen kod CPU’da çalışır.
Veri bilimcilerin cuDF’i nasıl kullandığıyla ilgileniyorsanız, DataFramed’in şu bölümünü dinleyin: NVIDIA’da Seçkin Mühendis ve Kaggle Grandmaster olan Jean-Francois Puget ile Bir Kaggle Grandmaster’ı Olmak.
Python’da PySpark kullanarak büyük verilerle nasıl çalışacağınızı PySpark ile Büyük Veri beceri yolunda öğrenebilirsiniz.
Son olarak, NVIDIA’nın scikit-learn, UMAP ve HDBSCAN’de GPU Hızlandırma duyurusu dahil en güncel gelişmelerinden haberdar kalın. Python makine öğrenmesi kütüphanelerinizi GPU’larda nasıl çalıştırabileceğinizi okuyun ve öğrenin.
pandas Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




