
Tiến gần tới giấc mơ viết mã pandas hiệu năng cao
Vấn đề với pandas
pandas là gói thao tác dữ liệu phổ biến nhất cho Python, với 144 triệu lượt tải xuống trong tháng trước. Phần lớn độ phổ biến của pandas đến từ việc dễ sử dụng và bộ tính năng phong phú cho thao tác dữ liệu.
Đáng tiếc, lịch sử phát triển lâu dài của pandas—nó được phát hành công khai lần đầu vào năm 2011—đồng nghĩa với việc nó ra đời trước nhiều đổi mới trong lĩnh vực điện toán hiệu năng cao (HPC). Điều đó khiến mã pandas chạy quá chậm để hữu ích cho các bộ dữ liệu lớn.
Nhiều nỗ lực tăng tốc pandas
Đã có nhiều nỗ lực để giải quyết vấn đề này. Mục tiêu là có thể viết cùng một mã pandas mà hàng triệu người dùng đã quen thuộc nhưng chạy nhanh hơn. Một số lựa chọn thay thế pandas hiệu năng cao gồm có Polars, tăng tốc bằng cách viết lại backend bằng Rust; PySpark, cung cấp giao diện Python cho nền tảng HPC Spark; Vaex, sử dụng tính toán ngoài bộ nhớ; và DuckDB, thực hiện tính toán bên trong một cơ sở dữ liệu tối ưu cho phân tích.
Xem các hướng dẫn sau, thảo luận chi tiết hơn về một số lựa chọn thay thế:
- Thao tác dữ liệu hiệu năng cao trong Python: pandas 2.0 vs. polars
- Đo điểm chuẩn các lựa chọn thay thế pandas hiệu năng cao
- Giới thiệu về DuckDB: Nó là gì và vì sao bạn nên dùng?
Giải pháp của NVIDIA để tăng tốc pandas
NVIDIA đã phát triển một bộ công cụ cho khoa học dữ liệu hiệu năng cao gọi là RAPIDS. Bộ công cụ này bao gồm cuDF, gói Python của NVIDIA dành cho mã pandas hiệu năng cao. (Tên gọi kết hợp CUDA, bộ công cụ cấp thấp của NVIDIA để xây dựng ứng dụng hỗ trợ GPU, và DataFrame, đối tượng pandas dùng để lưu trữ dữ liệu phân tích. Tên sau cũng truyền cảm hứng cho podcast DataFramed của DataCamp.)
Mẹo của cuDF để tăng tốc mã thao tác dữ liệu là khiến mã chạy trên GPU thay vì CPU. Dù ban đầu được thiết kế cho tính toán hiển thị đồ họa, GPU lại cực kỳ hiệu quả cho các phép tính khoa học dữ liệu.
Những vấn đề của cuDF
Dù cuDF đã rất thành công trong việc giúp bạn chạy mã pandas nhanh hơn, nó gặp một số vấn đề cản trở việc phổ biến rộng rãi.
Không hỗ trợ toàn bộ pandas
Một rào cản lớn là cuDF chỉ triển khai khoảng 60% API của Pandas. Tức là chỉ khoảng 60% tổng số mã bạn có thể viết trong pandas có thể chạy bằng cuDF. 60% mã có thể chạy này, dĩ nhiên, là 60% phổ biến nhất mà hầu hết mọi người muốn chạy. Điều này có nghĩa là đối với các phân tích hằng ngày, mã cuDF sẽ ổn. Tuy nhiên, nếu bạn muốn làm điều gì đó hơi khác thường, bạn sẽ gặp vấn đề với cuDF.
Cần GPU cho phát triển và kiểm thử
cuDF chỉ hỗ trợ chạy mã trên GPU. Điều đó có nghĩa là bạn cần GPU khi phát triển và khi kiểm thử. Điều này thường không khả thi nếu bạn muốn chạy mã cục bộ trên laptop và tốn kém nếu bạn muốn chạy mã trên đám mây.
Tương tác với gói Python khác cần hoán đổi bộ xử lý
Một vấn đề khác là phần lớn các gói Python không hỗ trợ GPU. Điều đó có nghĩa là với bất kỳ phân tích nào dùng các gói khác—ví dụ, hầu như mọi quy trình học máy—bạn sẽ phải tìm cách chuyển đổi tính toán giữa GPU và CPU rồi quay lại.
Giải pháp hiện có khi thiếu GPU rất tẻ nhạt
Cả ba vấn đề trên đồng nghĩa với việc bạn sẽ phải viết hai phiên bản mã: một phiên bản chạy khi có GPU và cuDF có thể tính toán mọi thứ, và một phiên bản khi không có GPU.
Hầu hết nhà khoa học dữ liệu muốn tập trung vào việc rút ra insight từ dữ liệu hơn là các chi tiết mã như vậy. Lịch sử trước đây điều này đã khiến việc dùng cuDF trở nên khó khăn cho nhiều tác vụ khoa học dữ liệu.
Chế độ Tăng tốc pandas cải thiện cuDF như thế nào
Giải pháp mà Chế độ Tăng tốc pandas mang lại cho những vấn đề này là bạn chỉ cần viết một dòng mã để bật hỗ trợ GPU, sau đó có thể viết mã pandas chuẩn.
Khi việc tính toán trên GPU được hỗ trợ (có GPU NVIDIA sẵn sàng và cuDF biết cách chạy mã pandas), mã của bạn sẽ chạy trên GPU. Trong các trường hợp không thể, cuDF sẽ tự động chuyển sang chạy trên CPU. Bạn không cần viết hai phiên bản mã, và không cần tự xử lý việc chuyển đổi giữa GPU và CPU.
Chế độ Tăng tốc pandas có nhanh hơn các lựa chọn thay thế không?
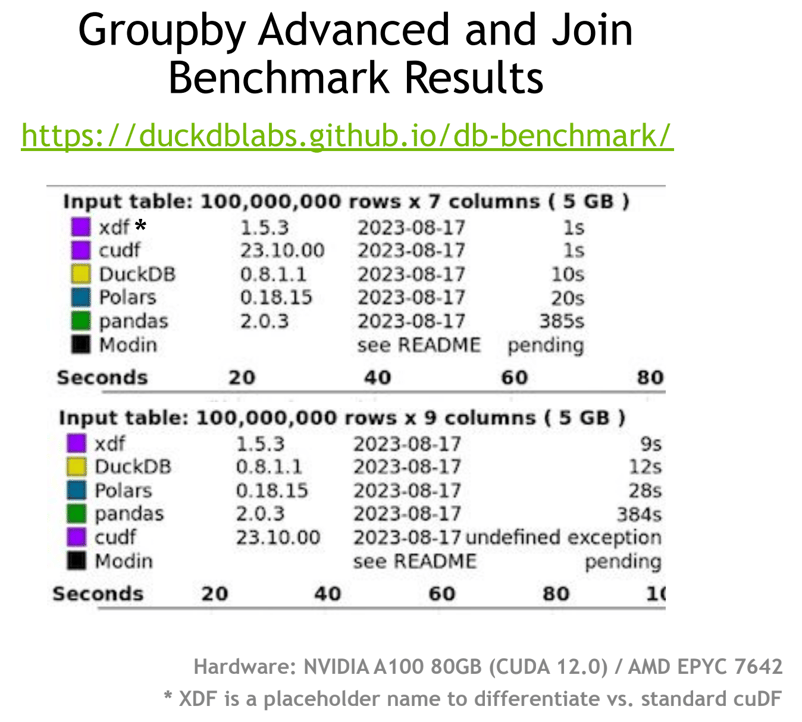
Bản quyền hình ảnh thuộc NVIDIA.
NVIDIA đã kiểm thử Chế độ Tăng tốc pandas so với các công cụ thao tác dữ liệu Python hiệu năng cao khác trên bộ đo chuẩn phép toán dạng cơ sở dữ liệu của DuckDB. Bộ thử thách thao tác dữ liệu này đo lường mức độ một công nghệ có thể thực hiện các nhiệm vụ như cung cấp thống kê tổng hợp theo nhóm và nối bảng trên các bộ dữ liệu lớn.
Theo NVIDIA, Chế độ Tăng tốc pandas (ký hiệu xdf trong hình) đứng đầu trong bài đo chuẩn. Điều này đáng chú ý vì phiên bản cuDF tiêu chuẩn hiện tại thất bại ở phép thử join do không thể thực hiện tất cả thao tác cần thiết trên GPU. (Bạn sẽ cần kết hợp cuDF với một công cụ khác để mọi thứ hoạt động.)
Cần lưu ý là NVIDIA kiểm thử trên GPU cao cấp NVIDIA A100 80GB, và CPU được dùng không được nêu rõ. Hiệu năng của bạn sẽ thay đổi tùy theo cấu hình phần cứng, bộ dữ liệu, và các phép tính bạn muốn thực hiện.
Tôi có thể sử dụng Chế độ Tăng tốc pandas như thế nào?
Hãy xem cách bạn có thể bắt đầu dùng Chế độ Tăng tốc trong pandas:
Cách cài đặt cuDF mới nhất
Phiên bản mới nhất của cuDF, bao gồm Chế độ Tăng tốc pandas, có tên là cudf-cu11. Nó có thể cài đặt qua pip tiêu chuẩn, với lưu ý là hiện bạn phải lấy từ kho PyPi của NVIDIA.
Chạy đoạn mã này để cài đặt gói.
pip install cudf-cu11 index-url=https://pypi.nvidia.comNếu bạn đang chạy trong sổ tay Juypter, hãy thêm dấu chấm than ở đầu dòng lệnh
!pip install cudf-cu11 index-url=https://pypi.nvidia.comBật Chế độ Tăng tốc pandas trong sổ tay Jupyter
Để bật Chế độ Tăng tốc pandas trong sổ tay Jupyter, thêm dòng mã sau vào một ô gần đầu sổ tay.
%load_ext cudf.pandasBật Chế độ Tăng tốc pandas từ terminal
Để bật Chế độ Tăng tốc pandas từ terminal, thay lệnh chuẩn để chạy một script Python
python script.py
with
python -m cudf.pandas script.pyTôi còn cần làm gì nữa?
Đơn giản là bật GPU, rồi viết và chạy mã pandas như bình thường.
Tôi có thể profile mã Chế độ Tăng tốc pandas không?
-
Trong sổ tay,
thêm %%cudf.pandas.profilevào ô bạn muốn profile. -
Bạn nhận được số liệu (theo lời gọi hàm hoặc từng dòng) về số lần gọi GPU và CPU + thời gian trên mỗi bộ xử lý.
Nếu bạn đang dùng cuDF, nhiều khả năng thời gian mã của bạn chạy bao lâu là quan trọng. Để tối ưu điều này, bạn cần có thể đo lường nó. Kỹ thuật đo thời gian thực thi mã được gọi là profiling. Chế độ Tăng tốc pandas cung cấp công cụ profiling cho mã chạy trong sổ tay Jupyter.
Để profile mã trong một ô, thêm dòng sau vào đầu ô.
%%cudf.pandas.profileKhi bạn chạy mã, bạn sẽ nhận được thống kê, theo lời gọi hàm hoặc từng dòng, về thời gian dành cho tính toán trên GPU và trên CPU.
Tất cả mã pandas đều được hỗ trợ?
Tại thời điểm công bố, toàn bộ mã pandas được hỗ trợ với hai ngoại lệ: DataFrame pandas 2.0 được xây dựng trên Apache Arrow thì chưa được hỗ trợ, dù đang được phát triển. Thứ hai, mã pandas biên dịch do Numba hoặc Cython tạo ra chưa được hỗ trợ đầy đủ.
Trong cả hai trường hợp, mã không được cuDF hỗ trợ sẽ chạy trên CPU.
Tiếp tục học
Nếu bạn quan tâm cách các nhà khoa học dữ liệu sử dụng cuDF, hãy nghe tập DataFramed này: Trở thành Kaggle Grandmaster với Jean-Francois Puget, Kỹ sư Danh dự tại NVIDIA và Kaggle Grandmaster.
Bạn có thể học cách làm việc với dữ liệu lớn trong Python bằng PySpark trong lộ trình kỹ năng Big Data with PySpark.
Cuối cùng, hãy đảm bảo cập nhật những phát triển mới nhất từ NVIDIA, đơn vị đã công bố Tăng tốc GPU cho scikit-learn, UMAP, và HDBSCAN. Đọc và tìm hiểu cách làm cho các thư viện máy học Python của bạn chạy trên GPU.
Richie giúp các cá nhân và tổ chức nâng cao khả năng sử dụng dữ liệu và AI. Anh đã làm khoa học dữ liệu từ trước khi lĩnh vực này được gọi là khoa học dữ liệu, và đã viết hai cuốn sách cùng nhiều khóa học trên DataCamp về chủ đề này. Anh là người dẫn chương trình podcast DataFramed và phụ trách chương trình webinar của DataCamp.
Trò chuyện với AI Richie về mọi tập của DataFramed - chào đón tất cả những nhà vô địch dữ liệu!


NVIDIA đã công bố một "Chế độ tăng tốc pandas" cho gói cuDF của họ, cho phép bạn viết mã pandas hiệu năng cao để thao tác dữ liệu trong Python. Đây là một bước nữa tiến gần tới giấc mơ viết mã Python dễ đọc cho con người nhưng chạy nhanh, ngay cả trên các bộ dữ liệu lớn.
Trong bài viết này, chúng tôi phân tích cách nó có thể giúp bạn, cách bắt đầu, và những lựa chọn thay thế là gì.