Nemotron 3 是 NVIDIA 针对多智能体 AI 系统新兴约束所做出的回应。我的意思是,随着 AI 系统转向多智能体工作流,推理成本上升、协作变难、长时间运行的任务也会拉紧上下文限制。
在 Nemotron 3 中,每个模型都建立在相同的架构基础之上,但面向不同的权衡:推理深度、吞吐量与效率。
本文将介绍 Nemotron 3 系列的结构变化、底层更新,以及它在常见智能体系统中的定位。
什么是 Nemotron 3?
Nemotron 3 的核心理念是专业化。一些智能体需要轻量且快速,处理诸如路由或摘要等常规任务。另一些则负责更深入的分析或长期规划。通过在同一代产品中提供多个模型,Nemotron 3 支持这种分工,同时保持透明且可自托管。
Nemotron 3 nano
Nemotron 3 Nano 是这一系列中最注重效率的模型。它是一个300 亿参数的模型,采用混合专家模型架构,每个 token 最多激活 30 亿参数。通过选择性激活,Nano 能在保持同级别竞争性精度的同时,实现高吞吐与低推理成本。
Nano 适用于摘要、检索、分类以及通用助理等工作流。在多智能体系统中,它可作为高并发的工作节点,处理频繁或中间步骤而不形成成本瓶颈。
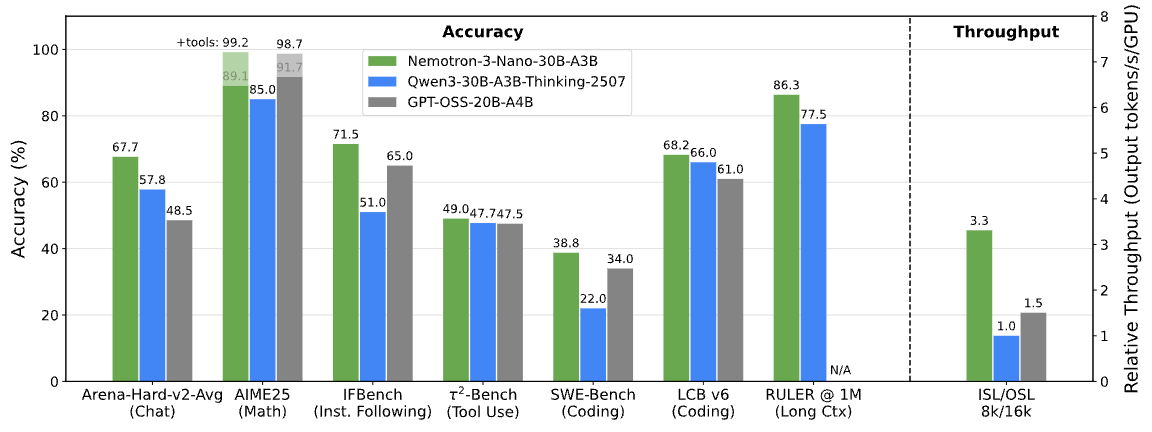
Nemotron 3 基准测试。图片来源:NVIDIA Research
Nemotron 3 super
Nemotron 3 Super 面向在时延约束下仍需更强推理能力的场景。它拥有约 1000 亿参数,每个 token 最多激活 100 亿,并针对协同的多智能体负载进行了优化。
Super 介于 Nano 与 Ultra 之间。它提供比 Nano 更强的推理能力,同时不需要最大模型的完整算力需求,适合需要整合多种输入或跨步骤推理的智能体。
Nemotron 3 ultra
Nemotron 3 Ultra 是该系列中能力最强的模型。其参数规模约为 5000 亿,每个 token 最多激活 500 亿,作为复杂智能体工作流的高端推理引擎。
Ultra 适用于涉及深度分析、长期规划或战略决策的任务。尽管其算力需求更高,但设计上与更小的 Nemotron 模型协同运行,只将最苛刻的任务路由给它。
Nemotron 3 架构的新变化
在明确了产品线之后,下一个问题是 NVIDIA 如何在不同层级之间平衡规模与效率。
Nemotron 3 并非依赖单一架构性突破,而是结合多项互补的设计选择,使大型多智能体系统的运行更具可行性。
混合潜在混合专家设计
Nemotron 3 的核心是一种混合潜在混合专家(MoE)架构。模型不会为每个 token 激活全部参数,而是将每个 token 路由到一小部分专门化的专家网络中。
这样既降低了推理成本,又保留了大型模型的容量。在基于智能体的系统中,许多智能体可能同时生成中间输出,选择性激活可随规模增长保持可控的算力需求。
训练中使用 4 位精度
Nemotron 3 Super 与 Ultra 在 Blackwell 架构上使用 NVIDIA 的 4 位 NVFP4 精度格式进行训练。低精度训练可降低内存占用并加速训练,使在现有基础设施上训练更大型 MoE 模型成为可能。
重要的是,与更高精度格式相比,这并不会带来显著的精度下降,这也解释了 Nemotron 3 如何在保持可部署性的同时实现扩展。
扩展长序列上下文窗口
Nemotron 3 Nano 支持最长达一百万个 token 的上下文窗口。这使模型能够在长文档、长日志或多步任务历史中持续保留信息。
对于将任务在规划、检索与执行智能体之间进行路由的工作流而言,更长的上下文减少了对激进切分或外部记忆系统的依赖。
Nemotron 3 的关键特性
这些架构决策并非抽象概念,而是直接体现在 Nemotron 3 在真实系统中的表现。
减少推理 token 生成
NVIDIA 报告称,Nemotron 3 Nano 生成的推理 token 最多比 Nemotron 2 Nano 少 60%。在多智能体系统中,中间推理步骤可能主导总 token 使用量,这样的减少将直接影响成本与可扩展性。
更短的推理轨迹有助于在不牺牲任务准确性的前提下保持高效推理。
更高的多步工作流吞吐量
MoE 路由与选择性参数激活的结合,使 Nemotron 3 能在工作流日益复杂时保持高吞吐。这更易于支持更长的任务链或更多并发智能体,而不会等比例增加时延。
百万级上下文窗口,支持长期推理
凭借 Nano 最多一百万个 token 的支持,Nemotron 3 能在超长输入上进行长期推理。智能体可引用更早的步骤或大型文档,而无需反复做摘要或重新加载状态,从而在时间维度上提升一致性。
综合来看,这些特性解释了为何 Nemotron 3 更强调效率与协同,而非单一模型的极限性能。
Nemotron 3 与 Nemotron 2:有哪些改进
至此,Nemotron 3 的设计目标已相当清晰。与 Nemotron 2 的对比有助于验证这些目标是否转化为可量化的改进。
Nemotron 3 优化了混合专家的路由、提高了吞吐量、减少了推理 token 生成,并显著扩展了上下文长度。NVIDIA 报告称,Nemotron 3 Nano 的 token 吞吐量最多比 Nemotron 2 Nano 提高 4 倍,同时显著降低了推理 token 数量。
另一个差异在于范围。Nemotron 3 不仅发布模型,还配套强化学习数据集、智能体安全数据,以及 NeMo Gym 与 NeMo RL 等开源工具。Nemotron 2 主要聚焦于模型发布,而 Nemotron 3 则定位为更完整的智能体开发栈。
Nemotron 3 与竞品对比
结合架构与基准结果,可以更清楚地看到 Nemotron 3 在当前模型版图中的位置。NVIDIA 并未将 Nemotron 3 定位为可直接替代最前沿的专有模型。相反,它瞄准的是另一项挑战:让基于智能体的 AI 系统在真实部署中更高效、可预测且可扩展。
与其他大型开源模型相比,Nemotron 3 较少强调最大化单模型基准分数,而更多关注系统层面的考量,如吞吐量、推理 token 效率、长上下文处理,以及跨智能体的协同。这种定位与 Mistral 的产品线有相似之处,但更侧重多智能体工作负载。
Nemotron 3 的优势(相较于其他模型)
下表总结了 Nemotron 3 相对于其他常见开源与专有模型所突出的关键维度。
|
维度
|
Nemotron 3
|
Mistral Large 3
|
DeepSeek 系列模型
|
前沿专有模型
|
|
主要设计目标
|
大规模多智能体效率
|
单模型能力
|
每次提示的推理深度
|
前沿推理与智能体
|
|
架构侧重
|
混合潜在 MoE
|
稀疏 MoE
|
稠密 / MoE
|
稠密,专有
|
|
吞吐(Tokens/秒)
|
极高(Nano 领先同侪)
|
高但算力开销大
|
中等
|
中等至高
|
|
推理 Token 使用
|
减少(Nano 最多减少约 60%)
|
中等
|
较高
|
较高
|
|
上下文窗口
|
最高 100 万 token(Nano)
|
最高约 256K
|
较长,但更小
|
较长(因模型而异)
|
|
多智能体适配性
|
优秀
|
中等
|
中等
|
强但成本高
|
|
自托管与可控性
|
完全(开放权重)
|
完全(开放权重)
|
完全(开放权重)
|
受限 / 无
|
|
最佳用例
|
智能体协同、路由与摘要
|
深度推理、编程
|
数学与推理任务
|
复杂规划、SWE
|
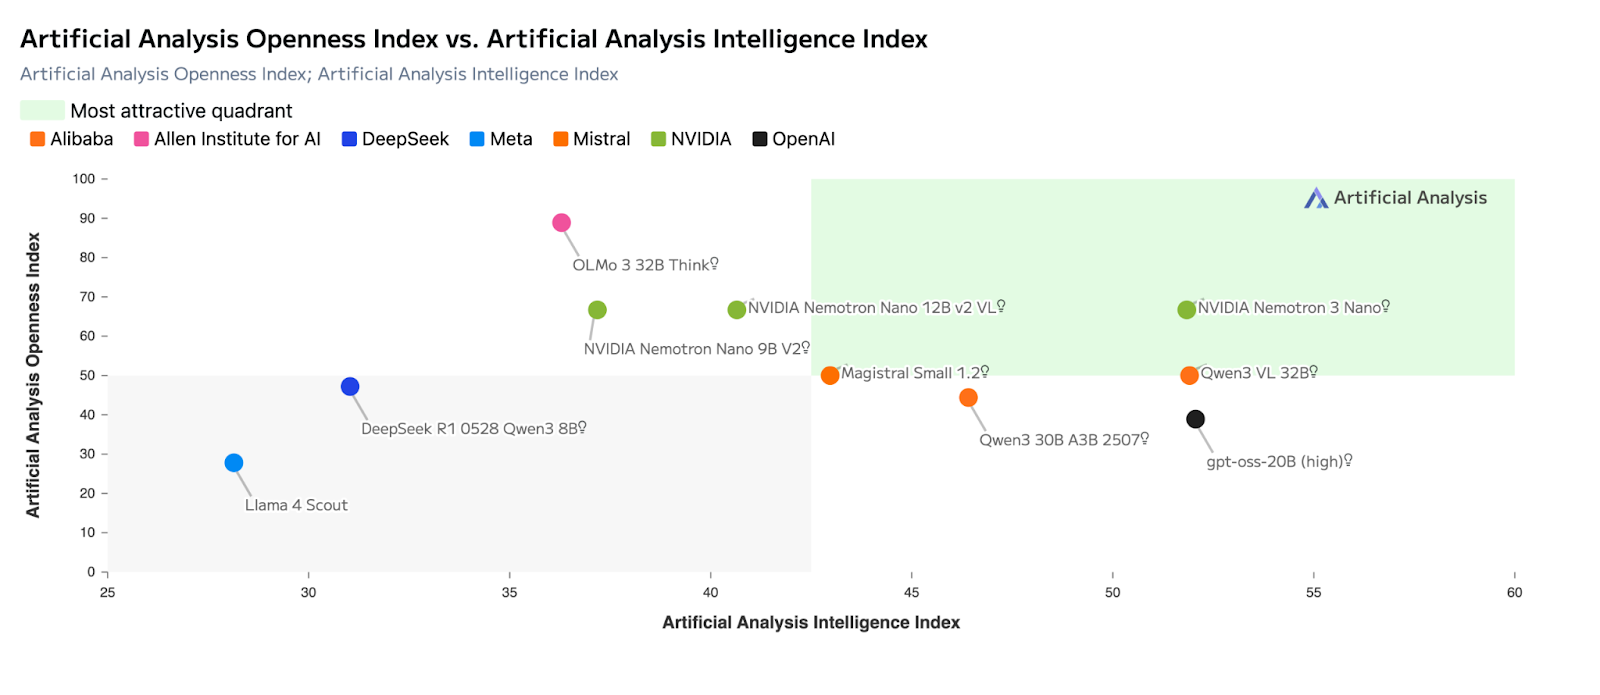
Nemotron 3 与 Mistral Large 3
Mistral Large 3 与 Nemotron 3 都依赖混合专家(MoE)架构,但它们优化的目标不同。
Mistral Large 3 旨在最大化单模型能力,在 LMArena 与 SWE 风格评估等推理、编程与通用基准上表现强劲。当期望由一个模型端到端完成整个任务时,它往往是更好的选择。
相较之下,Nemotron 3 优化的是系统层效率。其混合潜在 MoE 设计每个 token 激活更少参数,并以吞吐优先于峰值推理深度。这使其更适合以协作为主的角色——路由、摘要以及在多个智能体同时运作时的中间推理。
如何获取 Nemotron 3?
在明确设计目标之后,下一个问题是实践层面:您今天如何实际运行 Nemotron 3,以及在您的环境下哪些选项更合适?NVIDIA 提供多种访问路径,从完全托管的 API 到自管部署。
通过托管推理提供商的 API 访问
最快的入门方式是使用托管推理提供商。Nemotron 3 Nano 现已在诸如Baseten、DeepInfra、Fireworks、FriendliAI、OpenRouter 与 Together AI等平台上提供。这些服务提供标准 API 接口,便于您在无需自备硬件的情况下测试模型的行为、吞吐与长上下文处理能力。
此选项适用于原型化智能体工作流、进行性能基准测试,或以最少配置将 Nemotron 3 集成入现有应用。
开放权重与自托管
Nemotron 3 模型也以开放权重形式发布在Hugging Face 上,便于您完全掌控部署。此路径适合希望自托管模型、在领域数据上进行微调,或将其集成到自定义智能体流水线中的团队。
借助开放权重,您可以:
- 在自有基础设施上运行模型,
- 按需修改或微调,
- 并端到端管理时延、隐私与成本。
这种方式契合 NVIDIA 对长期、生产级智能体系统所强调的透明性与所有权。
Nvidia NIM 与部署框架
对于希望更“托管化”自托管体验的团队,Nemotron 3 Nano 也可作为NVIDIA NIM 微服务提供。NIM 将模型封装,便于在 NVIDIA 加速的基础设施上进行安全、可扩展的部署,无论本地还是云端。
随着生态的成熟,Nemotron 模型也有望与常见的本地与边缘推理部署框架和运行时集成。这些选项便于在受控环境中试验 Nemotron 3,而无需从零搭建部署栈。
模型可用性时间线
在发布时:
- Nemotron 3 Nano 现已通过托管 API、开放权重与 NVIDIA NIM 提供。
- Nemotron 3 Super 与 Ultra 预计在 2026 年上半年推出。
实际操作中,这意味着开发者可立即用 Nano 开始试验,而更大型模型将面向需要更强推理能力的后期部署。
Nemotron 3 的表现如何?
Nemotron 3 在其预期范围内表现出色。其主要贡献不在于推动单模型推理的上限,而在于让基于智能体的系统更易于部署与扩展。
这些架构选择转化为真实的运营收益,尤其适用于依赖多个协同智能体的工作流。话虽如此,如果您的首要需求是深度的单模型推理或复杂的工具驱动规划,前沿专有模型通常仍更为稳定。
从合适的角度看,Nemotron 3 是对这些模型的补充,而非替代。
Nemotron 3 的使用场景
Nemotron 3 最适合对效率、透明性与可扩展性要求较高的场景。
- 多智能体系统:路由、协作与中间推理
- 长文处理:在大规模输入上的摘要、抽取与分析
- 企业助理:需要可预测性能与自托管的内部工具
- 工作流自动化:大规模分类、检索与决策支持
- 隐私敏感部署:本地或主权 AI 环境
由于模型是开放的并被设计为协同工作,团队可以让不同规模的模型承担不同角色,而不必依赖单一的巨石型系统。
结语
NVIDIA 对效率、开放性与系统级设计的关注,反映了当下许多真实世界 AI 应用的构建方式。
要高效地使用 Nemotron 3 这类模型,既需要理解大语言模型的基础,也需要掌握系统集成。
我们的 大型语言模型(LLMs)概念课程提供概念基础,而 用 Python 构建 API技能路径则涵盖将模型集成到应用中的实务要点。
从更大的系统视角看,Nemotron 3 与其说是一次模型发布,不如说是当今基于智能体 AI 部署方式的一个基础。


Nemotron 3 是 NVIDIA 针对多智能体 AI 系统新兴约束所做出的回应。我的意思是,随着 AI 系统转向多智能体工作流,推理成本上升、协作变难、长时间运行的任务也会拉紧上下文限制。
在 Nemotron 3 中,每个模型都建立在相同的架构基础之上,但面向不同的权衡:推理深度、吞吐量与效率。
本文将介绍 Nemotron 3 系列的结构变化、底层更新,以及它在常见智能体系统中的定位。
什么是 Nemotron 3?
Nemotron 3 的核心理念是专业化。一些智能体需要轻量且快速,处理诸如路由或摘要等常规任务。另一些则负责更深入的分析或长期规划。通过在同一代产品中提供多个模型,Nemotron 3 支持这种分工,同时保持透明且可自托管。
Nemotron 3 nano
Nemotron 3 Nano 是这一系列中最注重效率的模型。它是一个300 亿参数的模型,采用混合专家模型架构,每个 token 最多激活 30 亿参数。通过选择性激活,Nano 能在保持同级别竞争性精度的同时,实现高吞吐与低推理成本。
Nano 适用于摘要、检索、分类以及通用助理等工作流。在多智能体系统中,它可作为高并发的工作节点,处理频繁或中间步骤而不形成成本瓶颈。
Nemotron 3 基准测试。图片来源:NVIDIA Research
Nemotron 3 super
Nemotron 3 Super 面向在时延约束下仍需更强推理能力的场景。它拥有约 1000 亿参数,每个 token 最多激活 100 亿,并针对协同的多智能体负载进行了优化。
Super 介于 Nano 与 Ultra 之间。它提供比 Nano 更强的推理能力,同时不需要最大模型的完整算力需求,适合需要整合多种输入或跨步骤推理的智能体。
Nemotron 3 ultra
Nemotron 3 Ultra 是该系列中能力最强的模型。其参数规模约为 5000 亿,每个 token 最多激活 500 亿,作为复杂智能体工作流的高端推理引擎。
Ultra 适用于涉及深度分析、长期规划或战略决策的任务。尽管其算力需求更高,但设计上与更小的 Nemotron 模型协同运行,只将最苛刻的任务路由给它。
Nemotron 3 架构的新变化
在明确了产品线之后,下一个问题是 NVIDIA 如何在不同层级之间平衡规模与效率。
Nemotron 3 并非依赖单一架构性突破,而是结合多项互补的设计选择,使大型多智能体系统的运行更具可行性。
混合潜在混合专家设计
Nemotron 3 的核心是一种混合潜在混合专家(MoE)架构。模型不会为每个 token 激活全部参数,而是将每个 token 路由到一小部分专门化的专家网络中。
这样既降低了推理成本,又保留了大型模型的容量。在基于智能体的系统中,许多智能体可能同时生成中间输出,选择性激活可随规模增长保持可控的算力需求。
训练中使用 4 位精度
Nemotron 3 Super 与 Ultra 在 Blackwell 架构上使用 NVIDIA 的 4 位 NVFP4 精度格式进行训练。低精度训练可降低内存占用并加速训练,使在现有基础设施上训练更大型 MoE 模型成为可能。
重要的是,与更高精度格式相比,这并不会带来显著的精度下降,这也解释了 Nemotron 3 如何在保持可部署性的同时实现扩展。
扩展长序列上下文窗口
Nemotron 3 Nano 支持最长达一百万个 token 的上下文窗口。这使模型能够在长文档、长日志或多步任务历史中持续保留信息。
对于将任务在规划、检索与执行智能体之间进行路由的工作流而言,更长的上下文减少了对激进切分或外部记忆系统的依赖。
Nemotron 3 的关键特性
这些架构决策并非抽象概念,而是直接体现在 Nemotron 3 在真实系统中的表现。
减少推理 token 生成
NVIDIA 报告称,Nemotron 3 Nano 生成的推理 token 最多比 Nemotron 2 Nano 少 60%。在多智能体系统中,中间推理步骤可能主导总 token 使用量,这样的减少将直接影响成本与可扩展性。
更短的推理轨迹有助于在不牺牲任务准确性的前提下保持高效推理。
更高的多步工作流吞吐量
MoE 路由与选择性参数激活的结合,使 Nemotron 3 能在工作流日益复杂时保持高吞吐。这更易于支持更长的任务链或更多并发智能体,而不会等比例增加时延。
百万级上下文窗口,支持长期推理
凭借 Nano 最多一百万个 token 的支持,Nemotron 3 能在超长输入上进行长期推理。智能体可引用更早的步骤或大型文档,而无需反复做摘要或重新加载状态,从而在时间维度上提升一致性。
综合来看,这些特性解释了为何 Nemotron 3 更强调效率与协同,而非单一模型的极限性能。
Nemotron 3 与 Nemotron 2:有哪些改进
至此,Nemotron 3 的设计目标已相当清晰。与 Nemotron 2 的对比有助于验证这些目标是否转化为可量化的改进。
Nemotron 3 优化了混合专家的路由、提高了吞吐量、减少了推理 token 生成,并显著扩展了上下文长度。NVIDIA 报告称,Nemotron 3 Nano 的 token 吞吐量最多比 Nemotron 2 Nano 提高 4 倍,同时显著降低了推理 token 数量。
另一个差异在于范围。Nemotron 3 不仅发布模型,还配套强化学习数据集、智能体安全数据,以及 NeMo Gym 与 NeMo RL 等开源工具。Nemotron 2 主要聚焦于模型发布,而 Nemotron 3 则定位为更完整的智能体开发栈。
Nemotron 3 与竞品对比
结合架构与基准结果,可以更清楚地看到 Nemotron 3 在当前模型版图中的位置。NVIDIA 并未将 Nemotron 3 定位为可直接替代最前沿的专有模型。相反,它瞄准的是另一项挑战:让基于智能体的 AI 系统在真实部署中更高效、可预测且可扩展。
与其他大型开源模型相比,Nemotron 3 较少强调最大化单模型基准分数,而更多关注系统层面的考量,如吞吐量、推理 token 效率、长上下文处理,以及跨智能体的协同。这种定位与 Mistral 的产品线有相似之处,但更侧重多智能体工作负载。
Nemotron 3 的优势(相较于其他模型)
下表总结了 Nemotron 3 相对于其他常见开源与专有模型所突出的关键维度。
维度
Nemotron 3
Mistral Large 3
DeepSeek 系列模型
前沿专有模型
主要设计目标
大规模多智能体效率
单模型能力
每次提示的推理深度
前沿推理与智能体
架构侧重
混合潜在 MoE
稀疏 MoE
稠密 / MoE
稠密,专有
吞吐(Tokens/秒)
极高(Nano 领先同侪)
高但算力开销大
中等
中等至高
推理 Token 使用
减少(Nano 最多减少约 60%)
中等
较高
较高
上下文窗口
最高 100 万 token(Nano)
最高约 256K
较长,但更小
较长(因模型而异)
多智能体适配性
优秀
中等
中等
强但成本高
自托管与可控性
完全(开放权重)
完全(开放权重)
完全(开放权重)
受限 / 无
最佳用例
智能体协同、路由与摘要
深度推理、编程
数学与推理任务
复杂规划、SWE
Nemotron 3 与 Mistral Large 3
Mistral Large 3 与 Nemotron 3 都依赖混合专家(MoE)架构,但它们优化的目标不同。
Mistral Large 3 旨在最大化单模型能力,在 LMArena 与 SWE 风格评估等推理、编程与通用基准上表现强劲。当期望由一个模型端到端完成整个任务时,它往往是更好的选择。
相较之下,Nemotron 3 优化的是系统层效率。其混合潜在 MoE 设计每个 token 激活更少参数,并以吞吐优先于峰值推理深度。这使其更适合以协作为主的角色——路由、摘要以及在多个智能体同时运作时的中间推理。
如何获取 Nemotron 3?
在明确设计目标之后,下一个问题是实践层面:您今天如何实际运行 Nemotron 3,以及在您的环境下哪些选项更合适?NVIDIA 提供多种访问路径,从完全托管的 API 到自管部署。
通过托管推理提供商的 API 访问
最快的入门方式是使用托管推理提供商。Nemotron 3 Nano 现已在诸如Baseten、DeepInfra、Fireworks、FriendliAI、OpenRouter 与 Together AI等平台上提供。这些服务提供标准 API 接口,便于您在无需自备硬件的情况下测试模型的行为、吞吐与长上下文处理能力。
此选项适用于原型化智能体工作流、进行性能基准测试,或以最少配置将 Nemotron 3 集成入现有应用。
开放权重与自托管
Nemotron 3 模型也以开放权重形式发布在Hugging Face 上,便于您完全掌控部署。此路径适合希望自托管模型、在领域数据上进行微调,或将其集成到自定义智能体流水线中的团队。
借助开放权重,您可以:
这种方式契合 NVIDIA 对长期、生产级智能体系统所强调的透明性与所有权。
Nvidia NIM 与部署框架
对于希望更“托管化”自托管体验的团队,Nemotron 3 Nano 也可作为NVIDIA NIM 微服务提供。NIM 将模型封装,便于在 NVIDIA 加速的基础设施上进行安全、可扩展的部署,无论本地还是云端。
随着生态的成熟,Nemotron 模型也有望与常见的本地与边缘推理部署框架和运行时集成。这些选项便于在受控环境中试验 Nemotron 3,而无需从零搭建部署栈。
模型可用性时间线
在发布时:
实际操作中,这意味着开发者可立即用 Nano 开始试验,而更大型模型将面向需要更强推理能力的后期部署。
Nemotron 3 的表现如何?
Nemotron 3 在其预期范围内表现出色。其主要贡献不在于推动单模型推理的上限,而在于让基于智能体的系统更易于部署与扩展。
这些架构选择转化为真实的运营收益,尤其适用于依赖多个协同智能体的工作流。话虽如此,如果您的首要需求是深度的单模型推理或复杂的工具驱动规划,前沿专有模型通常仍更为稳定。
从合适的角度看,Nemotron 3 是对这些模型的补充,而非替代。
Nemotron 3 的使用场景
Nemotron 3 最适合对效率、透明性与可扩展性要求较高的场景。
由于模型是开放的并被设计为协同工作,团队可以让不同规模的模型承担不同角色,而不必依赖单一的巨石型系统。
结语
NVIDIA 对效率、开放性与系统级设计的关注,反映了当下许多真实世界 AI 应用的构建方式。
要高效地使用 Nemotron 3 这类模型,既需要理解大语言模型的基础,也需要掌握系统集成。
我们的 大型语言模型(LLMs)概念课程提供概念基础,而 用 Python 构建 API技能路径则涵盖将模型集成到应用中的实务要点。
从更大的系统视角看,Nemotron 3 与其说是一次模型发布,不如说是当今基于智能体 AI 部署方式的一个基础。