Nemotron 3 è la risposta di NVIDIA ai nuovi vincoli dei sistemi di IA multi-agent. In altre parole, man mano che i sistemi di IA si spostano verso flussi di lavoro a più agenti, i costi di inferenza crescono, il coordinamento si complica e le attività di lunga durata mettono sotto stress i limiti di contesto.
Con Nemotron 3, ogni modello si basa sulla stessa fondazione architetturale ma punta a un diverso equilibrio tra profondità di ragionamento, throughput ed efficienza.
In questo articolo vedremo come è strutturata la famiglia Nemotron 3, cosa è cambiato sotto il cofano e dove si inserisce nei sistemi ad agenti più comuni.
Che cos’è Nemotron 3?
L’idea alla base di Nemotron 3 è la specializzazione. Alcuni agenti devono essere leggeri e veloci, per gestire attività di routine come il routing o il riassunto. Altri si occupano di analisi più approfondite o di pianificazione a lungo orizzonte. Offrendo più modelli all’interno della stessa generazione, Nemotron 3 supporta questa divisione del lavoro restando al contempo trasparente e self-hostable.
Nemotron 3 nano
Nemotron 3 Nano è il modello più orientato all’efficienza della famiglia. È un modello da 30 miliardi di parametri che attiva fino a 3 miliardi di parametri per token grazie a un’architettura ibrida mixture-of-experts. Questa attivazione selettiva permette a Nano di ottenere alto throughput e bassi costi di inferenza mantenendo un’accuratezza competitiva per la sua dimensione.
Nano è pensato per attività come riassunto, retrieval, classificazione e flussi da assistente generale. Nei sistemi multi-agent funziona bene come worker ad alto volume, gestendo passaggi frequenti o intermedi senza diventare un collo di bottiglia sui costi.
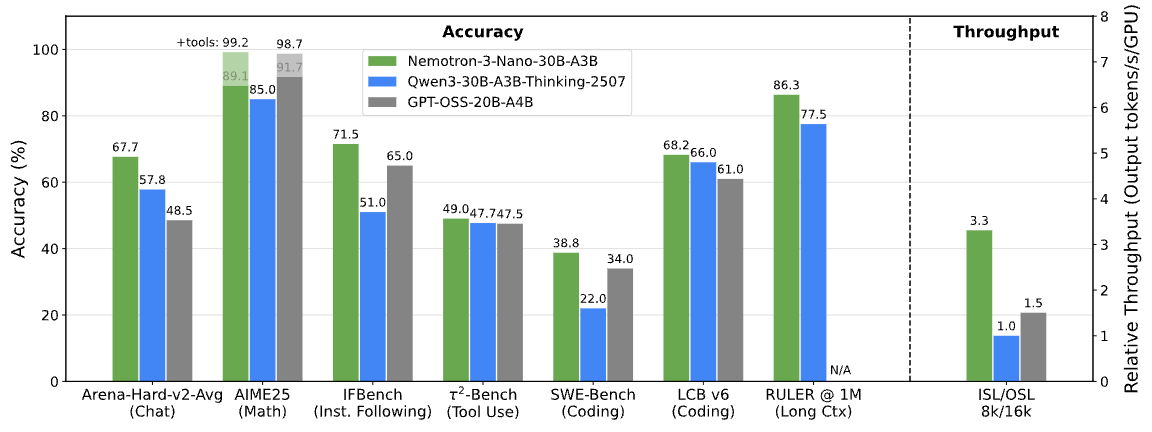
Benchmark di Nemotron 3. Immagine di NVIDIA Research
Nemotron 3 super
Nemotron 3 Super è pensato per scenari che richiedono un ragionamento più forte pur restando entro vincoli di latenza. Ha circa 100 miliardi di parametri, con fino a 10 miliardi attivi per token, ed è ottimizzato per carichi multi-agent coordinati.
Super si colloca tra Nano e Ultra. Offre una capacità di ragionamento superiore a Nano senza i requisiti computazionali del modello più grande, risultando adatto per agenti che devono combinare input multipli o ragionare su più passaggi.
Nemotron 3 ultra
Nemotron 3 Ultra è il modello più capace della linea. Con circa 500 miliardi di parametri e fino a 50 miliardi attivi per token, funge da motore di ragionamento di fascia alta per flussi agentici complessi.
Ultra è progettato per attività che richiedono analisi profonde, pianificazione a lungo orizzonte o decisioni strategiche. Pur avendo requisiti computazionali più elevati, è pensato per operare insieme ai modelli Nemotron più piccoli, instradando verso di sé solo i compiti più impegnativi.
Novità nell’architettura di Nemotron 3
Chiarita la lineup dei modelli, la domanda successiva è come NVIDIA bilanci scala ed efficienza su livelli così diversi.
Invece di puntare su una singola svolta architetturale, Nemotron 3 combina diverse scelte progettuali complementari per rendere pratico l’uso di grandi sistemi multi-agent.
Design ibrido latent mixture-of-experts
Al cuore di Nemotron 3 c’è un’architettura ibrida latent mixture-of-experts (MoE). Invece di attivare tutti i parametri per ogni token, il modello instrada ciascun token attraverso un piccolo sottoinsieme di reti esperte specializzate.
Questo riduce il costo di inferenza preservando la capacità di un modello molto più grande. Nei sistemi basati su agenti, dove molti agenti possono generare output intermedi simultaneamente, l’attivazione selettiva aiuta a mantenere gestibili i requisiti computazionali con l’aumentare della scala.
Uso della precisione a 4 bit in training
Nemotron 3 Super e Ultra sono addestrati usando il formato a 4 bit NVFP4 di NVIDIA su architettura Blackwell. Il training a precisione inferiore riduce l’uso di memoria e accelera l’addestramento, permettendo di lavorare con modelli MoE più grandi su infrastrutture esistenti.
È importante sottolineare che ciò avviene senza un calo significativo di accuratezza rispetto ai formati a precisione più alta, il che aiuta a spiegare come Nemotron 3 possa scalare restando pratico da distribuire.
Finestra di contesto ampliata per sequenze lunghe
Nemotron 3 Nano supporta finestre di contesto fino a un milione di token. Questo consente al modello di mantenere informazioni su documenti lunghi, log estesi o storici di attività multi-step.
Per flussi agentici come l’instradamento tra agenti di pianificazione, retrieval ed esecuzione, un contesto più lungo riduce la necessità di un chunking aggressivo o di sistemi di memoria esterni.
Caratteristiche chiave di Nemotron 3
Queste scelte architetturali non sono teoriche. Si riflettono direttamente nel comportamento di Nemotron 3 nei sistemi reali.
Riduzione dei token di ragionamento generati
NVIDIA riporta che Nemotron 3 Nano genera fino al 60% di token di ragionamento in meno rispetto a Nemotron 2 Nano. Nei sistemi multi-agent, dove i passaggi di ragionamento intermedi possono dominare l’uso totale di token, questa riduzione incide direttamente su costi e scalabilità.
Tracce di ragionamento più corte aiutano a mantenere efficiente l’inferenza senza sacrificare l’accuratezza del compito.
Throughput più alto per workflow multi-step
La combinazione di routing MoE e attivazione selettiva dei parametri consente a Nemotron 3 di mantenere un alto throughput man mano che i workflow diventano più complessi. Questo facilita il supporto di catene di attività più lunghe o di un numero maggiore di agenti concorrenti senza aumenti proporzionali della latenza.
Finestra di contesto da 1M per ragionamento a lungo orizzonte
Con il supporto fino a un milione di token in Nano, Nemotron 3 abilita il ragionamento a lungo orizzonte su input estesi. Gli agenti possono fare riferimento a passaggi precedenti o a documenti ampi senza dover riassumere o ricaricare lo stato di continuo, migliorando la coerenza nel tempo.
Nel complesso, queste funzionalità spiegano perché Nemotron 3 enfatizzi efficienza e coordinamento più che le prestazioni “pure” del singolo modello.
Nemotron 3 vs. Nemotron 2: cosa è migliorato
A questo punto dovrebbero essere chiari gli obiettivi di design di Nemotron 3. Il confronto con Nemotron 2 aiuta a verificare se tali obiettivi si sono tradotti in miglioramenti misurabili.
Nemotron 3 affina il routing mixture-of-experts, aumenta il throughput, riduce la generazione di token di ragionamento ed espande in modo significativo la lunghezza del contesto. NVIDIA riporta fino a 4× di throughput in token per Nemotron 3 Nano rispetto a Nemotron 2 Nano, insieme a una forte riduzione dei token di ragionamento.
Un’altra differenza è l’ampiezza dell’offerta. Nemotron 3 va oltre i soli modelli, includendo dataset per reinforcement learning, dati per la sicurezza degli agenti e strumenti open come NeMo Gym e NeMo RL. Nemotron 2 si concentrava principalmente sui rilasci di modelli, mentre Nemotron 3 si presenta come uno stack più completo per lo sviluppo di agenti.
Nemotron 3 vs. concorrenti
Considerando architettura e benchmark, risulta più chiaro dove si colloca Nemotron 3 nell’attuale panorama dei modelli. NVIDIA non posiziona Nemotron 3 come sostituto diretto dei modelli proprietari di frontiera. Al contrario, mira a una sfida diversa: rendere i sistemi di IA basati su agenti efficienti, prevedibili e scalabili nelle implementazioni reali.
Rispetto ad altri grandi modelli open, Nemotron 3 pone meno enfasi sulla massimizzazione dei punteggi di benchmark del singolo modello e più su aspetti di sistema come throughput, efficienza nei token di ragionamento, gestione del contesto lungo e coordinamento tra agenti. Un’impostazione simile a quella con cui Mistral presenta la propria lineup, ma con un’attenzione più marcata ai carichi multi-agent.
Dove Nemotron 3 eccelle (rispetto ad altri modelli)
La tabella seguente riassume le dimensioni chiave in cui Nemotron 3 si distingue rispetto ad altri modelli open e proprietari popolari.
|
Dimensione
|
Nemotron 3
|
Mistral Large 3
|
Modelli DeepSeek-Class
|
Modelli proprietari di frontiera
|
|
Obiettivo di design primario
|
Efficienza multi-agent su larga scala
|
Capacità del singolo modello
|
Profondità di ragionamento per prompt
|
Ragionamento di frontiera & agenti
|
|
Focus architetturale
|
MoE ibrido latente
|
MoE sparso
|
Denso / MoE
|
Denso, proprietario
|
|
Throughput (token/sec)
|
Molto alto (Nano supera i pari)
|
Alto ma compute-heavy
|
Moderato
|
Da moderato ad alto
|
|
Uso di token di ragionamento
|
Ridotto (fino a ~60% in meno in Nano)
|
Moderato
|
Più elevato
|
Più elevato
|
|
Finestra di contesto
|
Fino a 1M di token (Nano)
|
Fino a ~256K
|
Lunga, ma inferiore
|
Lunga (varia per modello)
|
|
Idoneità multi-agent
|
Eccellente
|
Moderata
|
Moderata
|
Forte ma costosa
|
|
Self-hosting & controllo
|
Completo (pesi open)
|
Completo (pesi open)
|
Completo (pesi open)
|
Limitato / nessuno
|
|
Miglior caso d’uso
|
Coordinamento agenti, routing, riassunto
|
Ragionamento profondo, coding
|
Task di matematica & ragionamento
|
Pianificazione complessa, SWE
|
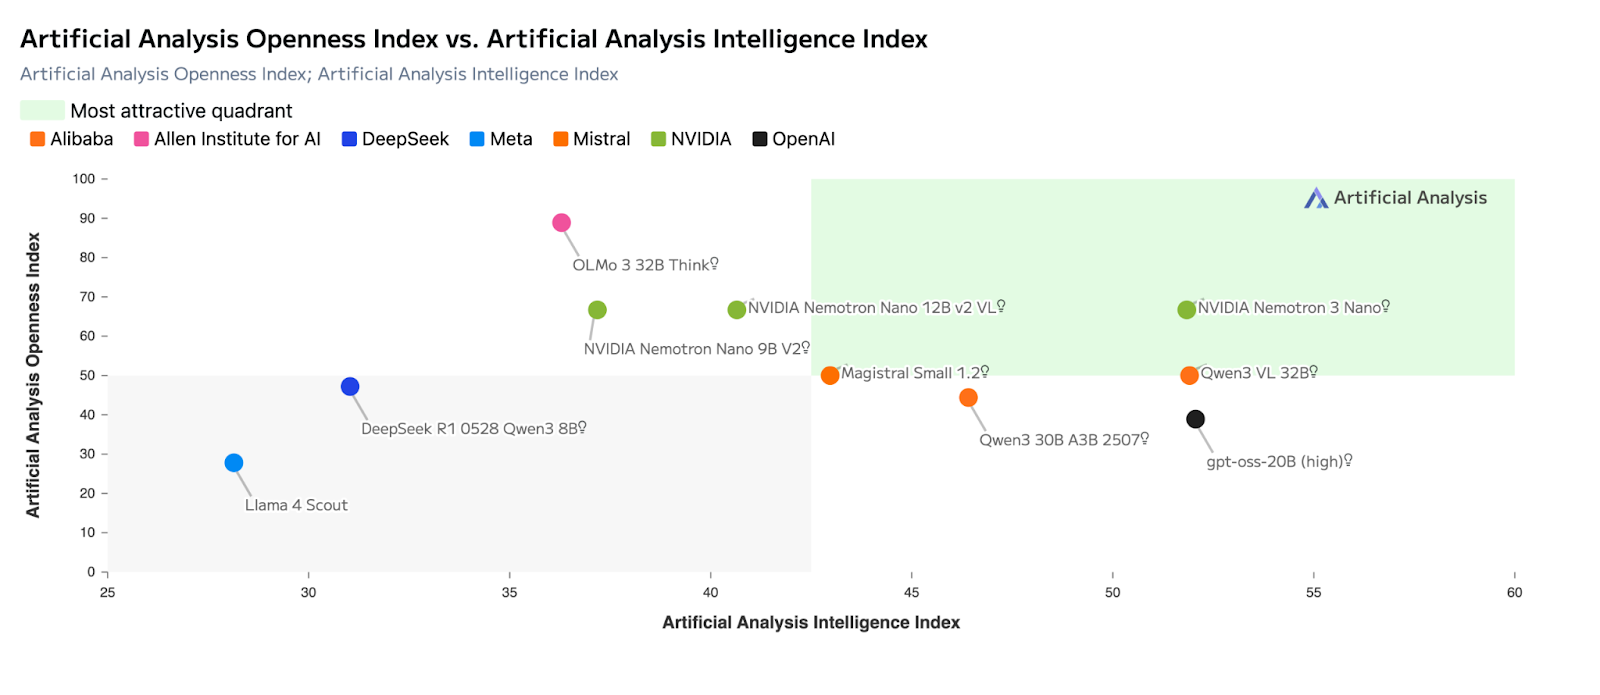
Nemotron 3 vs. Mistral Large 3
Mistral Large 3 e Nemotron 3 si basano entrambi su architetture mixture-of-experts, ma ottimizzano per risultati diversi.
Mistral Large 3 è progettato per massimizzare la capacità del singolo modello, con ottime prestazioni su ragionamento, coding e benchmark generali come LMArena e valutazioni in stile SWE. Spesso è la scelta migliore quando si prevede che un unico modello gestisca un intero compito end-to-end.
Nemotron 3, al contrario, è ottimizzato per l’efficienza a livello di sistema. Il suo design ibrido latent MoE attiva meno parametri per token e privilegia il throughput rispetto alla massima profondità di ragionamento. Questo lo rende più adatto a ruoli ricchi di coordinamento — routing, riassunto e ragionamento intermedio in cui molti agenti operano simultaneamente.
Come posso accedere a Nemotron 3?
Chiariti gli obiettivi di design, la domanda successiva è pratica: come puoi eseguire Nemotron 3 oggi e quali opzioni hanno senso per il tuo setup? NVIDIA offre diversi percorsi di accesso, da API completamente hosted a distribuzioni autogestite.
Accesso API tramite provider di inferenza hosted
Il modo più rapido per iniziare è tramite provider di inferenza hosted. Nemotron 3 Nano è disponibile oggi su piattaforme come Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter e Together AI. Questi servizi offrono API standard, permettendoti di testare comportamento, throughput e gestione del lungo contesto senza effettuare il provisioning dell’hardware.
Questa opzione è ideale per prototipare flussi ad agenti, fare benchmark delle prestazioni o integrare Nemotron 3 in applicazioni esistenti con setup minimo.
Pesi open e self-hosting
I modelli Nemotron 3 sono rilasciati anche con pesi open su Hugging Face, abilitando il pieno controllo sulla distribuzione. Questa via è pensata per i team che vogliono fare self-hosting dei modelli, affinarli su dati specifici di dominio o integrarli in pipeline agent personalizzate.
Con i pesi open puoi:
- eseguire i modelli sulla tua infrastruttura,
- modificarli o affinarli secondo necessità,
- e gestire end-to-end latenza, privacy e costi.
Questo approccio è in linea con l’enfasi di NVIDIA su trasparenza e proprietà per sistemi agentici di produzione e di lunga durata.
Nvidia NIM e framework di deployment
Per i team che vogliono un’esperienza di self-hosting più gestita, Nemotron 3 Nano è disponibile anche come microservizio NVIDIA NIM. NIM impacchetta il modello per una distribuzione sicura e scalabile su infrastrutture accelerate da NVIDIA, on-premises o nel cloud.
Con la maturazione dell’ecosistema, si prevede che i modelli Nemotron si integrino anche con framework e runtime di deployment comuni per l’inferenza locale ed edge. Queste opzioni semplificano la sperimentazione con Nemotron 3 in ambienti controllati senza dover costruire uno stack di deployment da zero.
Timeline di disponibilità dei modelli
Al momento del rilascio:
- Nemotron 3 Nano è disponibile ora tramite API hosted, pesi open e NVIDIA NIM.
- Nemotron 3 Super e Ultra dovrebbero essere disponibili nella prima metà del 2026.
In pratica, questo significa che gli sviluppatori possono iniziare subito a sperimentare con Nano, mentre i modelli più grandi sono pensati per distribuzioni successive che richiedono una capacità di ragionamento superiore.
Quanto è valido Nemotron 3?
Nemotron 3 è solido nel perimetro per cui è stato pensato. Il suo contributo principale non è spingere i limiti del ragionamento del singolo modello, ma rendere più pratici da distribuire e scalare i sistemi basati su agenti.
Le scelte architetturali si traducono in benefici operativi reali, soprattutto per i flussi che si affidano a molti agenti cooperanti. Detto questo, se la tua esigenza primaria è un ragionamento profondo del singolo modello o una pianificazione complessa guidata da strumenti, i modelli proprietari di frontiera tendono ancora a essere più consistenti.
Con la giusta prospettiva, Nemotron 3 completa questi modelli invece di sostituirli.
Casi d’uso di Nemotron 3
Nemotron 3 dà il meglio in scenari in cui contano efficienza, trasparenza e scalabilità.
- Sistemi multi-agent: routing, coordinamento e ragionamento intermedio
- Elaborazione di documenti lunghi: riassunto, estrazione e analisi su input di grandi dimensioni
- Assistenti enterprise: strumenti interni che richiedono prestazioni prevedibili e self-hosting
- Automazione dei workflow: classificazione, retrieval e supporto decisionale su larga scala
- Distribuzioni sensibili alla privacy: ambienti on-premises o di IA sovrana
Poiché i modelli sono open e progettati per lavorare insieme, i team possono assegnare ruoli diversi a dimensioni di modello diverse invece di affidarsi a un sistema singolo e monolitico.
Considerazioni finali
L’attenzione di NVIDIA su efficienza, apertura e design a livello di sistema riflette il modo in cui oggi vengono costruite molte applicazioni di IA reali.
Per costruire efficacemente con modelli come Nemotron 3, è utile comprendere sia le basi degli LLM sia l’integrazione di sistema.
Il nostro corso Large Language Models (LLMs) Concepts offre solide fondamenta concettuali, mentre lo skill track Building APIs in Python copre il lato pratico dell’integrazione dei modelli nelle applicazioni.
Visto come parte di un sistema più ampio, Nemotron 3 sembra meno un rilascio di modello e più una base per come l’IA basata su agenti viene distribuita oggi.



 Abid Ali Awan · 15 min


 Tim Lu · 12 min
Nemotron 3 è la risposta di NVIDIA ai nuovi vincoli dei sistemi di IA multi-agent. In altre parole, man mano che i sistemi di IA si spostano verso flussi di lavoro a più agenti, i costi di inferenza crescono, il coordinamento si complica e le attività di lunga durata mettono sotto stress i limiti di contesto.
Con Nemotron 3, ogni modello si basa sulla stessa fondazione architetturale ma punta a un diverso equilibrio tra profondità di ragionamento, throughput ed efficienza.
In questo articolo vedremo come è strutturata la famiglia Nemotron 3, cosa è cambiato sotto il cofano e dove si inserisce nei sistemi ad agenti più comuni.
Che cos’è Nemotron 3?
L’idea alla base di Nemotron 3 è la specializzazione. Alcuni agenti devono essere leggeri e veloci, per gestire attività di routine come il routing o il riassunto. Altri si occupano di analisi più approfondite o di pianificazione a lungo orizzonte. Offrendo più modelli all’interno della stessa generazione, Nemotron 3 supporta questa divisione del lavoro restando al contempo trasparente e self-hostable.
Nemotron 3 nano
Nemotron 3 Nano è il modello più orientato all’efficienza della famiglia. È un modello da 30 miliardi di parametri che attiva fino a 3 miliardi di parametri per token grazie a un’architettura ibrida mixture-of-experts. Questa attivazione selettiva permette a Nano di ottenere alto throughput e bassi costi di inferenza mantenendo un’accuratezza competitiva per la sua dimensione.
Nano è pensato per attività come riassunto, retrieval, classificazione e flussi da assistente generale. Nei sistemi multi-agent funziona bene come worker ad alto volume, gestendo passaggi frequenti o intermedi senza diventare un collo di bottiglia sui costi.
Benchmark di Nemotron 3. Immagine di NVIDIA Research
Nemotron 3 super
Nemotron 3 Super è pensato per scenari che richiedono un ragionamento più forte pur restando entro vincoli di latenza. Ha circa 100 miliardi di parametri, con fino a 10 miliardi attivi per token, ed è ottimizzato per carichi multi-agent coordinati.
Super si colloca tra Nano e Ultra. Offre una capacità di ragionamento superiore a Nano senza i requisiti computazionali del modello più grande, risultando adatto per agenti che devono combinare input multipli o ragionare su più passaggi.
Nemotron 3 ultra
Nemotron 3 Ultra è il modello più capace della linea. Con circa 500 miliardi di parametri e fino a 50 miliardi attivi per token, funge da motore di ragionamento di fascia alta per flussi agentici complessi.
Ultra è progettato per attività che richiedono analisi profonde, pianificazione a lungo orizzonte o decisioni strategiche. Pur avendo requisiti computazionali più elevati, è pensato per operare insieme ai modelli Nemotron più piccoli, instradando verso di sé solo i compiti più impegnativi.
Novità nell’architettura di Nemotron 3
Chiarita la lineup dei modelli, la domanda successiva è come NVIDIA bilanci scala ed efficienza su livelli così diversi.
Invece di puntare su una singola svolta architetturale, Nemotron 3 combina diverse scelte progettuali complementari per rendere pratico l’uso di grandi sistemi multi-agent.
Design ibrido latent mixture-of-experts
Al cuore di Nemotron 3 c’è un’architettura ibrida latent mixture-of-experts (MoE). Invece di attivare tutti i parametri per ogni token, il modello instrada ciascun token attraverso un piccolo sottoinsieme di reti esperte specializzate.
Questo riduce il costo di inferenza preservando la capacità di un modello molto più grande. Nei sistemi basati su agenti, dove molti agenti possono generare output intermedi simultaneamente, l’attivazione selettiva aiuta a mantenere gestibili i requisiti computazionali con l’aumentare della scala.
Uso della precisione a 4 bit in training
Nemotron 3 Super e Ultra sono addestrati usando il formato a 4 bit NVFP4 di NVIDIA su architettura Blackwell. Il training a precisione inferiore riduce l’uso di memoria e accelera l’addestramento, permettendo di lavorare con modelli MoE più grandi su infrastrutture esistenti.
È importante sottolineare che ciò avviene senza un calo significativo di accuratezza rispetto ai formati a precisione più alta, il che aiuta a spiegare come Nemotron 3 possa scalare restando pratico da distribuire.
Finestra di contesto ampliata per sequenze lunghe
Nemotron 3 Nano supporta finestre di contesto fino a un milione di token. Questo consente al modello di mantenere informazioni su documenti lunghi, log estesi o storici di attività multi-step.
Per flussi agentici come l’instradamento tra agenti di pianificazione, retrieval ed esecuzione, un contesto più lungo riduce la necessità di un chunking aggressivo o di sistemi di memoria esterni.
Caratteristiche chiave di Nemotron 3
Queste scelte architetturali non sono teoriche. Si riflettono direttamente nel comportamento di Nemotron 3 nei sistemi reali.
Riduzione dei token di ragionamento generati
NVIDIA riporta che Nemotron 3 Nano genera fino al 60% di token di ragionamento in meno rispetto a Nemotron 2 Nano. Nei sistemi multi-agent, dove i passaggi di ragionamento intermedi possono dominare l’uso totale di token, questa riduzione incide direttamente su costi e scalabilità.
Tracce di ragionamento più corte aiutano a mantenere efficiente l’inferenza senza sacrificare l’accuratezza del compito.
Throughput più alto per workflow multi-step
La combinazione di routing MoE e attivazione selettiva dei parametri consente a Nemotron 3 di mantenere un alto throughput man mano che i workflow diventano più complessi. Questo facilita il supporto di catene di attività più lunghe o di un numero maggiore di agenti concorrenti senza aumenti proporzionali della latenza.
Finestra di contesto da 1M per ragionamento a lungo orizzonte
Con il supporto fino a un milione di token in Nano, Nemotron 3 abilita il ragionamento a lungo orizzonte su input estesi. Gli agenti possono fare riferimento a passaggi precedenti o a documenti ampi senza dover riassumere o ricaricare lo stato di continuo, migliorando la coerenza nel tempo.
Nel complesso, queste funzionalità spiegano perché Nemotron 3 enfatizzi efficienza e coordinamento più che le prestazioni “pure” del singolo modello.
Nemotron 3 vs. Nemotron 2: cosa è migliorato
A questo punto dovrebbero essere chiari gli obiettivi di design di Nemotron 3. Il confronto con Nemotron 2 aiuta a verificare se tali obiettivi si sono tradotti in miglioramenti misurabili.
Nemotron 3 affina il routing mixture-of-experts, aumenta il throughput, riduce la generazione di token di ragionamento ed espande in modo significativo la lunghezza del contesto. NVIDIA riporta fino a 4× di throughput in token per Nemotron 3 Nano rispetto a Nemotron 2 Nano, insieme a una forte riduzione dei token di ragionamento.
Un’altra differenza è l’ampiezza dell’offerta. Nemotron 3 va oltre i soli modelli, includendo dataset per reinforcement learning, dati per la sicurezza degli agenti e strumenti open come NeMo Gym e NeMo RL. Nemotron 2 si concentrava principalmente sui rilasci di modelli, mentre Nemotron 3 si presenta come uno stack più completo per lo sviluppo di agenti.
Nemotron 3 vs. concorrenti
Considerando architettura e benchmark, risulta più chiaro dove si colloca Nemotron 3 nell’attuale panorama dei modelli. NVIDIA non posiziona Nemotron 3 come sostituto diretto dei modelli proprietari di frontiera. Al contrario, mira a una sfida diversa: rendere i sistemi di IA basati su agenti efficienti, prevedibili e scalabili nelle implementazioni reali.
Rispetto ad altri grandi modelli open, Nemotron 3 pone meno enfasi sulla massimizzazione dei punteggi di benchmark del singolo modello e più su aspetti di sistema come throughput, efficienza nei token di ragionamento, gestione del contesto lungo e coordinamento tra agenti. Un’impostazione simile a quella con cui Mistral presenta la propria lineup, ma con un’attenzione più marcata ai carichi multi-agent.
Dove Nemotron 3 eccelle (rispetto ad altri modelli)
La tabella seguente riassume le dimensioni chiave in cui Nemotron 3 si distingue rispetto ad altri modelli open e proprietari popolari.
Dimensione
Nemotron 3
Mistral Large 3
Modelli DeepSeek-Class
Modelli proprietari di frontiera
Obiettivo di design primario
Efficienza multi-agent su larga scala
Capacità del singolo modello
Profondità di ragionamento per prompt
Ragionamento di frontiera & agenti
Focus architetturale
MoE ibrido latente
MoE sparso
Denso / MoE
Denso, proprietario
Throughput (token/sec)
Molto alto (Nano supera i pari)
Alto ma compute-heavy
Moderato
Da moderato ad alto
Uso di token di ragionamento
Ridotto (fino a ~60% in meno in Nano)
Moderato
Più elevato
Più elevato
Finestra di contesto
Fino a 1M di token (Nano)
Fino a ~256K
Lunga, ma inferiore
Lunga (varia per modello)
Idoneità multi-agent
Eccellente
Moderata
Moderata
Forte ma costosa
Self-hosting & controllo
Completo (pesi open)
Completo (pesi open)
Completo (pesi open)
Limitato / nessuno
Miglior caso d’uso
Coordinamento agenti, routing, riassunto
Ragionamento profondo, coding
Task di matematica & ragionamento
Pianificazione complessa, SWE
Nemotron 3 vs. Mistral Large 3
Mistral Large 3 e Nemotron 3 si basano entrambi su architetture mixture-of-experts, ma ottimizzano per risultati diversi.
Mistral Large 3 è progettato per massimizzare la capacità del singolo modello, con ottime prestazioni su ragionamento, coding e benchmark generali come LMArena e valutazioni in stile SWE. Spesso è la scelta migliore quando si prevede che un unico modello gestisca un intero compito end-to-end.
Nemotron 3, al contrario, è ottimizzato per l’efficienza a livello di sistema. Il suo design ibrido latent MoE attiva meno parametri per token e privilegia il throughput rispetto alla massima profondità di ragionamento. Questo lo rende più adatto a ruoli ricchi di coordinamento — routing, riassunto e ragionamento intermedio in cui molti agenti operano simultaneamente.
Come posso accedere a Nemotron 3?
Chiariti gli obiettivi di design, la domanda successiva è pratica: come puoi eseguire Nemotron 3 oggi e quali opzioni hanno senso per il tuo setup? NVIDIA offre diversi percorsi di accesso, da API completamente hosted a distribuzioni autogestite.
Accesso API tramite provider di inferenza hosted
Il modo più rapido per iniziare è tramite provider di inferenza hosted. Nemotron 3 Nano è disponibile oggi su piattaforme come Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter e Together AI. Questi servizi offrono API standard, permettendoti di testare comportamento, throughput e gestione del lungo contesto senza effettuare il provisioning dell’hardware.
Questa opzione è ideale per prototipare flussi ad agenti, fare benchmark delle prestazioni o integrare Nemotron 3 in applicazioni esistenti con setup minimo.
Pesi open e self-hosting
I modelli Nemotron 3 sono rilasciati anche con pesi open su Hugging Face, abilitando il pieno controllo sulla distribuzione. Questa via è pensata per i team che vogliono fare self-hosting dei modelli, affinarli su dati specifici di dominio o integrarli in pipeline agent personalizzate.
Con i pesi open puoi:
Questo approccio è in linea con l’enfasi di NVIDIA su trasparenza e proprietà per sistemi agentici di produzione e di lunga durata.
Nvidia NIM e framework di deployment
Per i team che vogliono un’esperienza di self-hosting più gestita, Nemotron 3 Nano è disponibile anche come microservizio NVIDIA NIM. NIM impacchetta il modello per una distribuzione sicura e scalabile su infrastrutture accelerate da NVIDIA, on-premises o nel cloud.
Con la maturazione dell’ecosistema, si prevede che i modelli Nemotron si integrino anche con framework e runtime di deployment comuni per l’inferenza locale ed edge. Queste opzioni semplificano la sperimentazione con Nemotron 3 in ambienti controllati senza dover costruire uno stack di deployment da zero.
Timeline di disponibilità dei modelli
Al momento del rilascio:
In pratica, questo significa che gli sviluppatori possono iniziare subito a sperimentare con Nano, mentre i modelli più grandi sono pensati per distribuzioni successive che richiedono una capacità di ragionamento superiore.
Quanto è valido Nemotron 3?
Nemotron 3 è solido nel perimetro per cui è stato pensato. Il suo contributo principale non è spingere i limiti del ragionamento del singolo modello, ma rendere più pratici da distribuire e scalare i sistemi basati su agenti.
Le scelte architetturali si traducono in benefici operativi reali, soprattutto per i flussi che si affidano a molti agenti cooperanti. Detto questo, se la tua esigenza primaria è un ragionamento profondo del singolo modello o una pianificazione complessa guidata da strumenti, i modelli proprietari di frontiera tendono ancora a essere più consistenti.
Con la giusta prospettiva, Nemotron 3 completa questi modelli invece di sostituirli.
Casi d’uso di Nemotron 3
Nemotron 3 dà il meglio in scenari in cui contano efficienza, trasparenza e scalabilità.
Poiché i modelli sono open e progettati per lavorare insieme, i team possono assegnare ruoli diversi a dimensioni di modello diverse invece di affidarsi a un sistema singolo e monolitico.
Considerazioni finali
L’attenzione di NVIDIA su efficienza, apertura e design a livello di sistema riflette il modo in cui oggi vengono costruite molte applicazioni di IA reali.
Per costruire efficacemente con modelli come Nemotron 3, è utile comprendere sia le basi degli LLM sia l’integrazione di sistema.
Il nostro corso Large Language Models (LLMs) Concepts offre solide fondamenta concettuali, mentre lo skill track Building APIs in Python copre il lato pratico dell’integrazione dei modelli nelle applicazioni.
Visto come parte di un sistema più ampio, Nemotron 3 sembra meno un rilascio di modello e più una base per come l’IA basata su agenti viene distribuita oggi.