Nemotron 3 là phản hồi của NVIDIA trước những ràng buộc mới nổi của các hệ thống AI đa tác tử. Ý tôi là, khi các hệ thống AI chuyển sang quy trình làm việc đa tác tử, chi phí suy luận tăng, việc phối hợp trở nên khó khăn và các tác vụ chạy dài làm căng giới hạn ngữ cảnh.
Với Nemotron 3, mỗi mô hình được xây dựng trên cùng một nền tảng kiến trúc nhưng nhắm đến sự cân bằng khác nhau giữa độ sâu lập luận, thông lượng và hiệu quả.
Trong bài viết này, chúng ta sẽ xem cách gia đình Nemotron 3 được cấu trúc, những thay đổi bên trong, và vị trí của nó trong các hệ thống tác tử thường dùng.
Nemotron 3 là gì?
Ý tưởng cốt lõi đằng sau Nemotron 3 là chuyên môn hóa. Một số tác tử cần nhẹ và nhanh, xử lý các tác vụ thường quy như định tuyến hoặc tóm tắt. Những tác tử khác đảm nhiệm phân tích sâu hoặc lập kế hoạch dài hạn. Bằng cách cung cấp nhiều mô hình trong cùng một thế hệ, Nemotron 3 hỗ trợ sự phân công đó đồng thời vẫn minh bạch và có thể tự lưu trữ.
Nemotron 3 nano
Nemotron 3 Nano là mô hình tập trung vào hiệu suất cao nhất trong gia đình. Đây là mô hình 30B tham số kích hoạt tối đa 3B tham số trên mỗi token bằng kiến trúc mixture-of-experts lai. Kích hoạt có chọn lọc này cho phép Nano đạt thông lượng cao và chi phí suy luận thấp trong khi vẫn duy trì độ chính xác cạnh tranh so với kích thước của nó.
Nano dành cho các tác vụ như tóm tắt, truy xuất, phân loại và quy trình trợ lý tổng quát. Trong hệ thống đa tác tử, nó hoạt động tốt như một "công nhân" khối lượng lớn xử lý các bước thường xuyên hoặc trung gian mà không trở thành nút thắt chi phí.
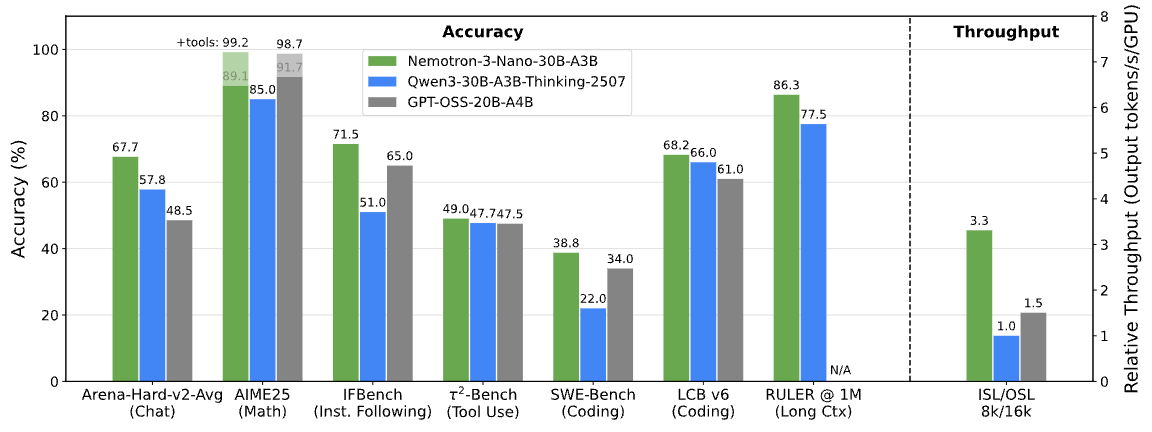
Điểm chuẩn Nemotron 3. Ảnh bởi NVIDIA Research
Nemotron 3 super
Nemotron 3 Super nhắm đến các kịch bản cần khả năng lập luận mạnh hơn nhưng vẫn hoạt động trong ràng buộc độ trễ. Nó có khoảng 100B tham số, với tối đa 10B kích hoạt trên mỗi token, và được tối ưu cho khối lượng công việc đa tác tử phối hợp.
Super nằm giữa Nano và Ultra. Nó cung cấp khả năng lập luận cao hơn Nano mà không đòi hỏi toàn bộ tài nguyên tính toán của mô hình lớn nhất, phù hợp với các tác tử cần kết hợp nhiều đầu vào hoặc lập luận qua nhiều bước.
Nemotron 3 ultra
Nemotron 3 Ultra là mô hình mạnh mẽ nhất trong danh mục. Với xấp xỉ 500B tham số và tối đa 50B kích hoạt trên mỗi token, nó đóng vai trò như một động cơ lập luận cao cấp cho các quy trình tác tử phức tạp.
Ultra được thiết kế cho các tác vụ liên quan đến phân tích sâu, lập kế hoạch dài hạn hoặc ra quyết định chiến lược. Dù yêu cầu tính toán cao hơn, nó được dùng cùng các mô hình Nemotron nhỏ hơn, chỉ những tác vụ đòi hỏi khắt khe nhất mới được định tuyến đến đó.
Có gì mới trong kiến trúc của Nemotron 3
Giờ danh mục mô hình đã rõ, câu hỏi tiếp theo là NVIDIA cân bằng quy mô và hiệu quả ra sao trên các tầng rất khác nhau như vậy.
Thay vì dựa vào một đột phá kiến trúc duy nhất, Nemotron 3 kết hợp một số lựa chọn thiết kế bổ trợ để giúp các hệ thống lớn, đa tác tử trở nên khả thi khi vận hành.
Thiết kế mixture-of-experts tiềm ẩn lai
Trung tâm của Nemotron 3 là kiến trúc mixture-of-experts (MoE) tiềm ẩn lai. Thay vì kích hoạt tất cả tham số cho mọi token, mô hình định tuyến mỗi token qua một tập con nhỏ các mạng chuyên gia chuyên biệt.
Điều này giảm chi phí suy luận trong khi vẫn giữ được dung lượng của một mô hình lớn hơn nhiều. Trong các hệ thống dựa trên tác tử, nơi nhiều tác tử có thể tạo đầu ra trung gian cùng lúc, kích hoạt chọn lọc giúp yêu cầu tính toán vẫn trong tầm kiểm soát khi mở rộng.
Sử dụng độ chính xác 4-bit trong huấn luyện
Nemotron 3 Super và Ultra được huấn luyện bằng định dạng độ chính xác 4-bit NVFP4 của NVIDIA trên kiến trúc Blackwell. Huấn luyện với độ chính xác thấp hơn giúp giảm sử dụng bộ nhớ và tăng tốc quá trình, cho phép làm việc với các mô hình MoE lớn hơn trên hạ tầng sẵn có.
Quan trọng là điều này được thực hiện mà không làm giảm đáng kể độ chính xác so với các định dạng có độ chính xác cao hơn, phần nào lý giải cách Nemotron 3 có thể mở rộng nhưng vẫn thực tế khi triển khai.
Mở rộng cửa sổ ngữ cảnh cho chuỗi dài
Nemotron 3 Nano hỗ trợ cửa sổ ngữ cảnh lên đến một triệu token. Điều này cho phép mô hình giữ thông tin xuyên suốt các tài liệu dài, nhật ký kéo dài, hoặc lịch sử tác vụ nhiều bước.
Với các quy trình tác tử như định tuyến tác vụ giữa tác tử lập kế hoạch, truy xuất và thực thi, ngữ cảnh dài hơn giúp giảm nhu cầu chia nhỏ mạnh tay hoặc dùng hệ thống bộ nhớ bên ngoài.
Tính năng chính của Nemotron 3
Những quyết định kiến trúc này không hề trừu tượng. Chúng thể hiện trực tiếp trong cách Nemotron 3 vận hành trong các hệ thống thực tế.
Giảm sinh token lập luận
NVIDIA báo cáo Nemotron 3 Nano tạo ra ít hơn tới 60% token lập luận so với Nemotron 2 Nano. Trong hệ thống đa tác tử, nơi các bước lập luận trung gian có thể chiếm ưu thế trong tổng số token, mức giảm này tác động trực tiếp đến chi phí và khả năng mở rộng.
Chuỗi lập luận ngắn hơn giúp giữ hiệu quả suy luận mà không đánh đổi độ chính xác nhiệm vụ.
Thông lượng cao hơn cho quy trình nhiều bước
Sự kết hợp giữa định tuyến MoE và kích hoạt tham số có chọn lọc cho phép Nemotron 3 duy trì thông lượng cao khi quy trình làm việc trở nên phức tạp hơn. Điều này giúp dễ hỗ trợ các chuỗi tác vụ dài hơn hoặc nhiều tác tử đồng thời hơn mà không làm tăng độ trễ tương ứng.
Cửa sổ ngữ cảnh 1M cho lập luận dài hạn
Với hỗ trợ lên đến một triệu token trong Nano, Nemotron 3 cho phép lập luận dài hạn trên các đầu vào mở rộng. Các tác tử có thể tham chiếu các bước trước đó hoặc tài liệu lớn mà không cần liên tục tóm tắt hoặc tải lại trạng thái, cải thiện tính nhất quán theo thời gian.
Tổng hòa các tính năng này lý giải vì sao Nemotron 3 nhấn mạnh hiệu quả và phối hợp hơn là hiệu năng đỉnh của một mô hình đơn lẻ.
Nemotron 3 so với Nemotron 2: Những điểm cải thiện
Đến lúc này, mục tiêu thiết kế của Nemotron 3 đã rõ. So sánh với Nemotron 2 giúp xác tín liệu những mục tiêu đó đã chuyển thành cải thiện đo lường được hay chưa.
Nemotron 3 tinh chỉnh định tuyến mixture-of-experts, tăng thông lượng, giảm sinh token lập luận và mở rộng đáng kể độ dài ngữ cảnh. NVIDIA báo cáo thông lượng token cao hơn đến 4× cho Nemotron 3 Nano so với Nemotron 2 Nano, cùng với mức giảm lớn về token lập luận.
Một khác biệt nữa là phạm vi. Nemotron 3 vượt ra ngoài chỉ phát hành mô hình, kèm theo bộ dữ liệu học tăng cường, dữ liệu an toàn cho tác tử và bộ công cụ mở như NeMo Gym và NeMo RL. Nemotron 2 chủ yếu tập trung vào phát hành mô hình, trong khi Nemotron 3 được định vị như một ngăn xếp đầy đủ hơn cho phát triển tác tử.
Nemotron 3 so với đối thủ
Khi đã có bối cảnh về kiến trúc và điểm chuẩn, sẽ rõ hơn Nemotron 3 nằm ở đâu trong bức tranh mô hình hiện tại. NVIDIA không định vị Nemotron 3 là sự thay thế trực tiếp cho các mô hình độc quyền tuyến đầu. Thay vào đó, nó nhắm đến một thách thức khác: khiến các hệ thống AI dựa trên tác tử trở nên hiệu quả, có thể dự đoán và mở rộng trong triển khai thực tế.
So với các mô hình mở lớn khác, Nemotron 3 ít nhấn mạnh tối đa hóa điểm số điểm chuẩn của một mô hình đơn lẻ và chú trọng hơn đến các mối quan tâm ở cấp hệ thống như thông lượng, hiệu quả token lập luận, xử lý ngữ cảnh dài và phối hợp giữa các tác tử. Cách định vị này tương tự cách Mistral định vị danh mục của mình, nhưng tập trung mạnh hơn vào khối lượng công việc đa tác tử.
Điểm Nemotron 3 vượt trội (so với các mô hình khác)
Bảng dưới đây tóm tắt các khía cạnh chính nơi Nemotron 3 nổi bật, so với các mô hình mở và độc quyền phổ biến khác.
|
Khía cạnh
|
Nemotron 3
|
Mistral Large 3
|
Mô hình DeepSeek-Class
|
Mô hình độc quyền tuyến đầu
|
|
Mục tiêu thiết kế chính
|
Hiệu quả đa tác tử ở quy mô lớn
|
Năng lực của mô hình đơn
|
Độ sâu lập luận cho mỗi lượt nhắc
|
Lập luận tuyến đầu & tác tử
|
|
Trọng tâm kiến trúc
|
MoE tiềm ẩn lai
|
MoE thưa
|
Dày đặc / MoE
|
Dày đặc, độc quyền
|
|
Thông lượng (Token/giây)
|
Rất cao (Nano dẫn đầu nhóm)
|
Cao nhưng tốn tài nguyên
|
Trung bình
|
Từ trung bình đến cao
|
|
Tiêu thụ token lập luận
|
Giảm (ít hơn đến ~60% ở Nano)
|
Trung bình
|
Cao hơn
|
Cao hơn
|
|
Cửa sổ ngữ cảnh
|
Tối đa 1M token (Nano)
|
Tối đa ~256K
|
Dài, nhưng nhỏ hơn
|
Dài (tùy mô hình)
|
|
Phù hợp đa tác tử
|
Xuất sắc
|
Trung bình
|
Trung bình
|
Mạnh nhưng tốn kém
|
|
Tự lưu trữ & kiểm soát
|
Đầy đủ (trọng số mở)
|
Đầy đủ (trọng số mở)
|
Đầy đủ (trọng số mở)
|
Hạn chế / không có
|
|
Trường hợp sử dụng tốt nhất
|
Phối hợp tác tử, định tuyến, tóm tắt
|
Lập luận sâu, lập trình
|
Nhiệm vụ toán & lập luận
|
Lập kế hoạch phức tạp, SWE
|
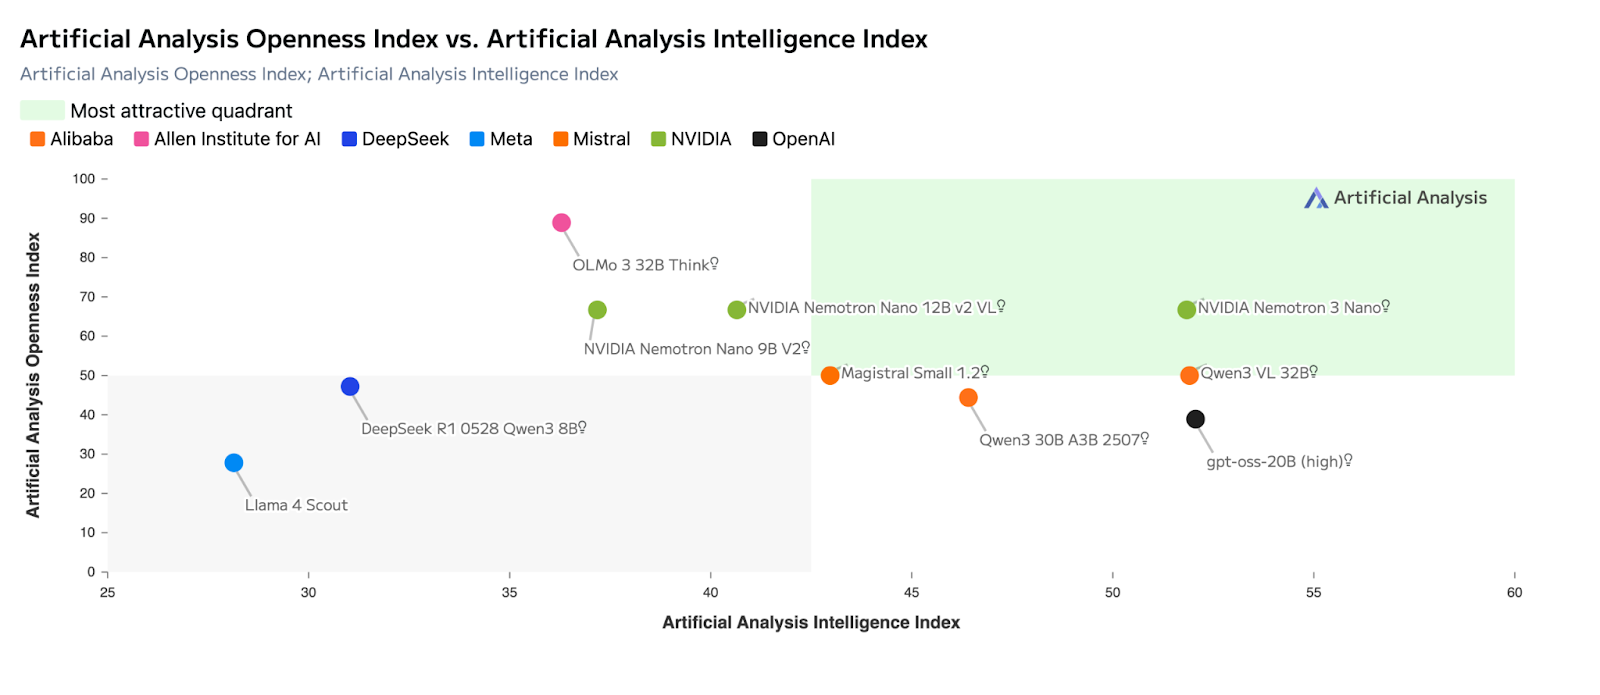
Nemotron 3 so với Mistral Large 3
Mistral Large 3 và Nemotron 3 đều dựa vào kiến trúc mixture-of-experts, nhưng chúng tối ưu cho các kết quả khác nhau.
Mistral Large 3 được thiết kế để tối đa hóa năng lực của một mô hình đơn, thể hiện tốt ở các điểm chuẩn lập luận, lập trình và mục đích chung như LMArena và đánh giá kiểu SWE. Thường đây là lựa chọn tốt hơn khi kỳ vọng một mô hình xử lý trọn vẹn một tác vụ đầu-cuối.
Ngược lại, Nemotron 3 được tối ưu cho hiệu quả ở cấp hệ thống. Thiết kế MoE tiềm ẩn lai của nó kích hoạt ít tham số hơn trên mỗi token và ưu tiên thông lượng hơn độ sâu lập luận đỉnh. Điều này khiến nó phù hợp hơn cho các vai trò đòi hỏi phối hợp nhiều—định tuyến, tóm tắt và lập luận trung gian nơi nhiều tác tử hoạt động đồng thời.
Tôi có thể truy cập Nemotron 3 như thế nào?
Khi mục tiêu thiết kế đã rõ, câu hỏi tiếp theo mang tính thực tiễn: bạn có thể chạy Nemotron 3 ngay hôm nay bằng cách nào, và lựa chọn nào phù hợp với thiết lập của bạn? NVIDIA cung cấp vài con đường truy cập, từ API được lưu trữ hoàn toàn đến triển khai tự quản lý.
Truy cập API qua nhà cung cấp suy luận lưu trữ
Cách bắt đầu nhanh nhất là thông qua các nhà cung cấp suy luận lưu trữ. Nemotron 3 Nano hiện có trên các nền tảng như Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter, và Together AI. Các dịch vụ này cung cấp giao diện API tiêu chuẩn, cho phép bạn thử nghiệm hành vi của mô hình, thông lượng và xử lý ngữ cảnh dài mà không cần cấp phát phần cứng.
Tùy chọn này phù hợp để dựng thử quy trình tác tử, đo hiệu năng hoặc tích hợp Nemotron 3 vào ứng dụng hiện có với thiết lập tối thiểu.
Trọng số mở và tự lưu trữ
Các mô hình Nemotron 3 cũng được phát hành với trọng số mở trên Hugging Face, cho phép toàn quyền kiểm soát triển khai. Cách này dành cho các nhóm muốn tự lưu trữ mô hình, tinh chỉnh trên dữ liệu theo miền, hoặc tích hợp vào các pipeline tác tử tùy chỉnh.
Với trọng số mở, bạn có thể:
- chạy mô hình trên hạ tầng của riêng bạn,
- sửa đổi hoặc tinh chỉnh khi cần,
- và quản lý đầu-cuối độ trễ, quyền riêng tư, cũng như chi phí.
Cách tiếp cận này phù hợp với nhấn mạnh của NVIDIA về tính minh bạch và quyền sở hữu cho các hệ thống tác tử bền vững, đạt chuẩn sản xuất.
Nvidia nim và các khung triển khai
Với các nhóm muốn trải nghiệm tự lưu trữ được quản lý hơn, Nemotron 3 Nano cũng có dưới dạng microservice NVIDIA NIM. NIM đóng gói mô hình để triển khai an toàn, có thể mở rộng trên hạ tầng tăng tốc bởi NVIDIA, cả on-premises hoặc trên đám mây.
Khi hệ sinh thái trưởng thành, các mô hình Nemotron cũng được kỳ vọng tích hợp với các khung và runtime triển khai phổ biến dùng cho suy luận cục bộ và biên. Những lựa chọn này giúp dễ thử nghiệm Nemotron 3 trong môi trường kiểm soát mà không cần xây dựng ngăn xếp triển khai từ đầu.
Dòng thời gian khả dụng của mô hình
Tại thời điểm phát hành:
- Nemotron 3 Nano đã khả dụng qua API lưu trữ, trọng số mở và NVIDIA NIM.
- Nemotron 3 Super và Ultra dự kiến khả dụng trong nửa đầu năm 2026.
Thực tế, điều này nghĩa là nhà phát triển có thể bắt đầu thử nghiệm với Nano ngay lập tức, trong khi các mô hình lớn hơn được định vị cho giai đoạn triển khai sau, khi cần năng lực lập luận mạnh hơn.
Nemotron 3 tốt đến mức nào?
Nemotron 3 mạnh trong phạm vi dự định của nó. Đóng góp chính của nó không phải đẩy giới hạn lập luận của một mô hình đơn, mà là giúp các hệ thống dựa trên tác tử trở nên thực tế hơn để triển khai và mở rộng.
Các lựa chọn kiến trúc chuyển hóa thành lợi ích vận hành thực sự, đặc biệt cho các quy trình dựa vào nhiều tác tử hợp tác. Dù vậy, nếu yêu cầu chính của bạn là lập luận sâu bằng một mô hình đơn hoặc lập kế hoạch phức tạp dựa trên công cụ, các mô hình độc quyền tuyến đầu vẫn có xu hướng ổn định hơn.
Nhìn đúng góc độ, Nemotron 3 bổ sung cho các mô hình đó hơn là thay thế chúng.
Trường hợp sử dụng Nemotron 3
Nemotron 3 phù hợp nhất trong các kịch bản đề cao hiệu quả, minh bạch và khả năng mở rộng.
- Hệ thống đa tác tử: định tuyến, phối hợp và lập luận trung gian
- Xử lý tài liệu dài: tóm tắt, trích xuất và phân tích trên đầu vào lớn
- Trợ lý doanh nghiệp: công cụ nội bộ cần hiệu năng có thể dự đoán và tự lưu trữ
- Tự động hóa quy trình: phân loại, truy xuất và hỗ trợ quyết định ở quy mô
- Triển khai nhạy cảm với quyền riêng tư: on-premises hoặc môi trường AI có chủ quyền
Vì các mô hình là mở và được thiết kế để hoạt động cùng nhau, các nhóm có thể giao vai trò khác nhau cho các kích cỡ mô hình khác nhau thay vì phụ thuộc vào một hệ thống đơn khối.
Kết luận
Sự tập trung của NVIDIA vào hiệu quả, tính mở và thiết kế ở cấp hệ thống phản ánh cách nhiều ứng dụng AI thực tế hiện đang được xây dựng.
Giờ đây, để xây dựng hiệu quả với các mô hình như Nemotron 3, sẽ hữu ích nếu bạn hiểu cả nền tảng LLM và tích hợp hệ thống.
Khóa học Khái niệm về Mô hình Ngôn ngữ Lớn (LLM) của chúng tôi cung cấp nền tảng khái niệm, trong khi lộ trình kỹ năng Xây dựng API bằng Python bao quát khía cạnh thực hành tích hợp mô hình vào ứng dụng.
Khi được nhìn như một phần của hệ thống lớn hơn, Nemotron 3 giống một nền tảng cho cách AI dựa trên tác tử đang được triển khai ngày nay hơn là chỉ một lần phát hành mô hình.


 Matt Crabtree · 10 min
Nemotron 3 là phản hồi của NVIDIA trước những ràng buộc mới nổi của các hệ thống AI đa tác tử. Ý tôi là, khi các hệ thống AI chuyển sang quy trình làm việc đa tác tử, chi phí suy luận tăng, việc phối hợp trở nên khó khăn và các tác vụ chạy dài làm căng giới hạn ngữ cảnh.
Với Nemotron 3, mỗi mô hình được xây dựng trên cùng một nền tảng kiến trúc nhưng nhắm đến sự cân bằng khác nhau giữa độ sâu lập luận, thông lượng và hiệu quả.
Trong bài viết này, chúng ta sẽ xem cách gia đình Nemotron 3 được cấu trúc, những thay đổi bên trong, và vị trí của nó trong các hệ thống tác tử thường dùng.
Nemotron 3 là gì?
Ý tưởng cốt lõi đằng sau Nemotron 3 là chuyên môn hóa. Một số tác tử cần nhẹ và nhanh, xử lý các tác vụ thường quy như định tuyến hoặc tóm tắt. Những tác tử khác đảm nhiệm phân tích sâu hoặc lập kế hoạch dài hạn. Bằng cách cung cấp nhiều mô hình trong cùng một thế hệ, Nemotron 3 hỗ trợ sự phân công đó đồng thời vẫn minh bạch và có thể tự lưu trữ.
Nemotron 3 nano
Nemotron 3 Nano là mô hình tập trung vào hiệu suất cao nhất trong gia đình. Đây là mô hình 30B tham số kích hoạt tối đa 3B tham số trên mỗi token bằng kiến trúc mixture-of-experts lai. Kích hoạt có chọn lọc này cho phép Nano đạt thông lượng cao và chi phí suy luận thấp trong khi vẫn duy trì độ chính xác cạnh tranh so với kích thước của nó.
Nano dành cho các tác vụ như tóm tắt, truy xuất, phân loại và quy trình trợ lý tổng quát. Trong hệ thống đa tác tử, nó hoạt động tốt như một "công nhân" khối lượng lớn xử lý các bước thường xuyên hoặc trung gian mà không trở thành nút thắt chi phí.
Điểm chuẩn Nemotron 3. Ảnh bởi NVIDIA Research
Nemotron 3 super
Nemotron 3 Super nhắm đến các kịch bản cần khả năng lập luận mạnh hơn nhưng vẫn hoạt động trong ràng buộc độ trễ. Nó có khoảng 100B tham số, với tối đa 10B kích hoạt trên mỗi token, và được tối ưu cho khối lượng công việc đa tác tử phối hợp.
Super nằm giữa Nano và Ultra. Nó cung cấp khả năng lập luận cao hơn Nano mà không đòi hỏi toàn bộ tài nguyên tính toán của mô hình lớn nhất, phù hợp với các tác tử cần kết hợp nhiều đầu vào hoặc lập luận qua nhiều bước.
Nemotron 3 ultra
Nemotron 3 Ultra là mô hình mạnh mẽ nhất trong danh mục. Với xấp xỉ 500B tham số và tối đa 50B kích hoạt trên mỗi token, nó đóng vai trò như một động cơ lập luận cao cấp cho các quy trình tác tử phức tạp.
Ultra được thiết kế cho các tác vụ liên quan đến phân tích sâu, lập kế hoạch dài hạn hoặc ra quyết định chiến lược. Dù yêu cầu tính toán cao hơn, nó được dùng cùng các mô hình Nemotron nhỏ hơn, chỉ những tác vụ đòi hỏi khắt khe nhất mới được định tuyến đến đó.
Có gì mới trong kiến trúc của Nemotron 3
Giờ danh mục mô hình đã rõ, câu hỏi tiếp theo là NVIDIA cân bằng quy mô và hiệu quả ra sao trên các tầng rất khác nhau như vậy.
Thay vì dựa vào một đột phá kiến trúc duy nhất, Nemotron 3 kết hợp một số lựa chọn thiết kế bổ trợ để giúp các hệ thống lớn, đa tác tử trở nên khả thi khi vận hành.
Thiết kế mixture-of-experts tiềm ẩn lai
Trung tâm của Nemotron 3 là kiến trúc mixture-of-experts (MoE) tiềm ẩn lai. Thay vì kích hoạt tất cả tham số cho mọi token, mô hình định tuyến mỗi token qua một tập con nhỏ các mạng chuyên gia chuyên biệt.
Điều này giảm chi phí suy luận trong khi vẫn giữ được dung lượng của một mô hình lớn hơn nhiều. Trong các hệ thống dựa trên tác tử, nơi nhiều tác tử có thể tạo đầu ra trung gian cùng lúc, kích hoạt chọn lọc giúp yêu cầu tính toán vẫn trong tầm kiểm soát khi mở rộng.
Sử dụng độ chính xác 4-bit trong huấn luyện
Nemotron 3 Super và Ultra được huấn luyện bằng định dạng độ chính xác 4-bit NVFP4 của NVIDIA trên kiến trúc Blackwell. Huấn luyện với độ chính xác thấp hơn giúp giảm sử dụng bộ nhớ và tăng tốc quá trình, cho phép làm việc với các mô hình MoE lớn hơn trên hạ tầng sẵn có.
Quan trọng là điều này được thực hiện mà không làm giảm đáng kể độ chính xác so với các định dạng có độ chính xác cao hơn, phần nào lý giải cách Nemotron 3 có thể mở rộng nhưng vẫn thực tế khi triển khai.
Mở rộng cửa sổ ngữ cảnh cho chuỗi dài
Nemotron 3 Nano hỗ trợ cửa sổ ngữ cảnh lên đến một triệu token. Điều này cho phép mô hình giữ thông tin xuyên suốt các tài liệu dài, nhật ký kéo dài, hoặc lịch sử tác vụ nhiều bước.
Với các quy trình tác tử như định tuyến tác vụ giữa tác tử lập kế hoạch, truy xuất và thực thi, ngữ cảnh dài hơn giúp giảm nhu cầu chia nhỏ mạnh tay hoặc dùng hệ thống bộ nhớ bên ngoài.
Tính năng chính của Nemotron 3
Những quyết định kiến trúc này không hề trừu tượng. Chúng thể hiện trực tiếp trong cách Nemotron 3 vận hành trong các hệ thống thực tế.
Giảm sinh token lập luận
NVIDIA báo cáo Nemotron 3 Nano tạo ra ít hơn tới 60% token lập luận so với Nemotron 2 Nano. Trong hệ thống đa tác tử, nơi các bước lập luận trung gian có thể chiếm ưu thế trong tổng số token, mức giảm này tác động trực tiếp đến chi phí và khả năng mở rộng.
Chuỗi lập luận ngắn hơn giúp giữ hiệu quả suy luận mà không đánh đổi độ chính xác nhiệm vụ.
Thông lượng cao hơn cho quy trình nhiều bước
Sự kết hợp giữa định tuyến MoE và kích hoạt tham số có chọn lọc cho phép Nemotron 3 duy trì thông lượng cao khi quy trình làm việc trở nên phức tạp hơn. Điều này giúp dễ hỗ trợ các chuỗi tác vụ dài hơn hoặc nhiều tác tử đồng thời hơn mà không làm tăng độ trễ tương ứng.
Cửa sổ ngữ cảnh 1M cho lập luận dài hạn
Với hỗ trợ lên đến một triệu token trong Nano, Nemotron 3 cho phép lập luận dài hạn trên các đầu vào mở rộng. Các tác tử có thể tham chiếu các bước trước đó hoặc tài liệu lớn mà không cần liên tục tóm tắt hoặc tải lại trạng thái, cải thiện tính nhất quán theo thời gian.
Tổng hòa các tính năng này lý giải vì sao Nemotron 3 nhấn mạnh hiệu quả và phối hợp hơn là hiệu năng đỉnh của một mô hình đơn lẻ.
Nemotron 3 so với Nemotron 2: Những điểm cải thiện
Đến lúc này, mục tiêu thiết kế của Nemotron 3 đã rõ. So sánh với Nemotron 2 giúp xác tín liệu những mục tiêu đó đã chuyển thành cải thiện đo lường được hay chưa.
Nemotron 3 tinh chỉnh định tuyến mixture-of-experts, tăng thông lượng, giảm sinh token lập luận và mở rộng đáng kể độ dài ngữ cảnh. NVIDIA báo cáo thông lượng token cao hơn đến 4× cho Nemotron 3 Nano so với Nemotron 2 Nano, cùng với mức giảm lớn về token lập luận.
Một khác biệt nữa là phạm vi. Nemotron 3 vượt ra ngoài chỉ phát hành mô hình, kèm theo bộ dữ liệu học tăng cường, dữ liệu an toàn cho tác tử và bộ công cụ mở như NeMo Gym và NeMo RL. Nemotron 2 chủ yếu tập trung vào phát hành mô hình, trong khi Nemotron 3 được định vị như một ngăn xếp đầy đủ hơn cho phát triển tác tử.
Nemotron 3 so với đối thủ
Khi đã có bối cảnh về kiến trúc và điểm chuẩn, sẽ rõ hơn Nemotron 3 nằm ở đâu trong bức tranh mô hình hiện tại. NVIDIA không định vị Nemotron 3 là sự thay thế trực tiếp cho các mô hình độc quyền tuyến đầu. Thay vào đó, nó nhắm đến một thách thức khác: khiến các hệ thống AI dựa trên tác tử trở nên hiệu quả, có thể dự đoán và mở rộng trong triển khai thực tế.
So với các mô hình mở lớn khác, Nemotron 3 ít nhấn mạnh tối đa hóa điểm số điểm chuẩn của một mô hình đơn lẻ và chú trọng hơn đến các mối quan tâm ở cấp hệ thống như thông lượng, hiệu quả token lập luận, xử lý ngữ cảnh dài và phối hợp giữa các tác tử. Cách định vị này tương tự cách Mistral định vị danh mục của mình, nhưng tập trung mạnh hơn vào khối lượng công việc đa tác tử.
Điểm Nemotron 3 vượt trội (so với các mô hình khác)
Bảng dưới đây tóm tắt các khía cạnh chính nơi Nemotron 3 nổi bật, so với các mô hình mở và độc quyền phổ biến khác.
Khía cạnh
Nemotron 3
Mistral Large 3
Mô hình DeepSeek-Class
Mô hình độc quyền tuyến đầu
Mục tiêu thiết kế chính
Hiệu quả đa tác tử ở quy mô lớn
Năng lực của mô hình đơn
Độ sâu lập luận cho mỗi lượt nhắc
Lập luận tuyến đầu & tác tử
Trọng tâm kiến trúc
MoE tiềm ẩn lai
MoE thưa
Dày đặc / MoE
Dày đặc, độc quyền
Thông lượng (Token/giây)
Rất cao (Nano dẫn đầu nhóm)
Cao nhưng tốn tài nguyên
Trung bình
Từ trung bình đến cao
Tiêu thụ token lập luận
Giảm (ít hơn đến ~60% ở Nano)
Trung bình
Cao hơn
Cao hơn
Cửa sổ ngữ cảnh
Tối đa 1M token (Nano)
Tối đa ~256K
Dài, nhưng nhỏ hơn
Dài (tùy mô hình)
Phù hợp đa tác tử
Xuất sắc
Trung bình
Trung bình
Mạnh nhưng tốn kém
Tự lưu trữ & kiểm soát
Đầy đủ (trọng số mở)
Đầy đủ (trọng số mở)
Đầy đủ (trọng số mở)
Hạn chế / không có
Trường hợp sử dụng tốt nhất
Phối hợp tác tử, định tuyến, tóm tắt
Lập luận sâu, lập trình
Nhiệm vụ toán & lập luận
Lập kế hoạch phức tạp, SWE
Nemotron 3 so với Mistral Large 3
Mistral Large 3 và Nemotron 3 đều dựa vào kiến trúc mixture-of-experts, nhưng chúng tối ưu cho các kết quả khác nhau.
Mistral Large 3 được thiết kế để tối đa hóa năng lực của một mô hình đơn, thể hiện tốt ở các điểm chuẩn lập luận, lập trình và mục đích chung như LMArena và đánh giá kiểu SWE. Thường đây là lựa chọn tốt hơn khi kỳ vọng một mô hình xử lý trọn vẹn một tác vụ đầu-cuối.
Ngược lại, Nemotron 3 được tối ưu cho hiệu quả ở cấp hệ thống. Thiết kế MoE tiềm ẩn lai của nó kích hoạt ít tham số hơn trên mỗi token và ưu tiên thông lượng hơn độ sâu lập luận đỉnh. Điều này khiến nó phù hợp hơn cho các vai trò đòi hỏi phối hợp nhiều—định tuyến, tóm tắt và lập luận trung gian nơi nhiều tác tử hoạt động đồng thời.
Tôi có thể truy cập Nemotron 3 như thế nào?
Khi mục tiêu thiết kế đã rõ, câu hỏi tiếp theo mang tính thực tiễn: bạn có thể chạy Nemotron 3 ngay hôm nay bằng cách nào, và lựa chọn nào phù hợp với thiết lập của bạn? NVIDIA cung cấp vài con đường truy cập, từ API được lưu trữ hoàn toàn đến triển khai tự quản lý.
Truy cập API qua nhà cung cấp suy luận lưu trữ
Cách bắt đầu nhanh nhất là thông qua các nhà cung cấp suy luận lưu trữ. Nemotron 3 Nano hiện có trên các nền tảng như Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter, và Together AI. Các dịch vụ này cung cấp giao diện API tiêu chuẩn, cho phép bạn thử nghiệm hành vi của mô hình, thông lượng và xử lý ngữ cảnh dài mà không cần cấp phát phần cứng.
Tùy chọn này phù hợp để dựng thử quy trình tác tử, đo hiệu năng hoặc tích hợp Nemotron 3 vào ứng dụng hiện có với thiết lập tối thiểu.
Trọng số mở và tự lưu trữ
Các mô hình Nemotron 3 cũng được phát hành với trọng số mở trên Hugging Face, cho phép toàn quyền kiểm soát triển khai. Cách này dành cho các nhóm muốn tự lưu trữ mô hình, tinh chỉnh trên dữ liệu theo miền, hoặc tích hợp vào các pipeline tác tử tùy chỉnh.
Với trọng số mở, bạn có thể:
Cách tiếp cận này phù hợp với nhấn mạnh của NVIDIA về tính minh bạch và quyền sở hữu cho các hệ thống tác tử bền vững, đạt chuẩn sản xuất.
Nvidia nim và các khung triển khai
Với các nhóm muốn trải nghiệm tự lưu trữ được quản lý hơn, Nemotron 3 Nano cũng có dưới dạng microservice NVIDIA NIM. NIM đóng gói mô hình để triển khai an toàn, có thể mở rộng trên hạ tầng tăng tốc bởi NVIDIA, cả on-premises hoặc trên đám mây.
Khi hệ sinh thái trưởng thành, các mô hình Nemotron cũng được kỳ vọng tích hợp với các khung và runtime triển khai phổ biến dùng cho suy luận cục bộ và biên. Những lựa chọn này giúp dễ thử nghiệm Nemotron 3 trong môi trường kiểm soát mà không cần xây dựng ngăn xếp triển khai từ đầu.
Dòng thời gian khả dụng của mô hình
Tại thời điểm phát hành:
Thực tế, điều này nghĩa là nhà phát triển có thể bắt đầu thử nghiệm với Nano ngay lập tức, trong khi các mô hình lớn hơn được định vị cho giai đoạn triển khai sau, khi cần năng lực lập luận mạnh hơn.
Nemotron 3 tốt đến mức nào?
Nemotron 3 mạnh trong phạm vi dự định của nó. Đóng góp chính của nó không phải đẩy giới hạn lập luận của một mô hình đơn, mà là giúp các hệ thống dựa trên tác tử trở nên thực tế hơn để triển khai và mở rộng.
Các lựa chọn kiến trúc chuyển hóa thành lợi ích vận hành thực sự, đặc biệt cho các quy trình dựa vào nhiều tác tử hợp tác. Dù vậy, nếu yêu cầu chính của bạn là lập luận sâu bằng một mô hình đơn hoặc lập kế hoạch phức tạp dựa trên công cụ, các mô hình độc quyền tuyến đầu vẫn có xu hướng ổn định hơn.
Nhìn đúng góc độ, Nemotron 3 bổ sung cho các mô hình đó hơn là thay thế chúng.
Trường hợp sử dụng Nemotron 3
Nemotron 3 phù hợp nhất trong các kịch bản đề cao hiệu quả, minh bạch và khả năng mở rộng.
Vì các mô hình là mở và được thiết kế để hoạt động cùng nhau, các nhóm có thể giao vai trò khác nhau cho các kích cỡ mô hình khác nhau thay vì phụ thuộc vào một hệ thống đơn khối.
Kết luận
Sự tập trung của NVIDIA vào hiệu quả, tính mở và thiết kế ở cấp hệ thống phản ánh cách nhiều ứng dụng AI thực tế hiện đang được xây dựng.
Giờ đây, để xây dựng hiệu quả với các mô hình như Nemotron 3, sẽ hữu ích nếu bạn hiểu cả nền tảng LLM và tích hợp hệ thống.
Khóa học Khái niệm về Mô hình Ngôn ngữ Lớn (LLM) của chúng tôi cung cấp nền tảng khái niệm, trong khi lộ trình kỹ năng Xây dựng API bằng Python bao quát khía cạnh thực hành tích hợp mô hình vào ứng dụng.
Khi được nhìn như một phần của hệ thống lớn hơn, Nemotron 3 giống một nền tảng cho cách AI dựa trên tác tử đang được triển khai ngày nay hơn là chỉ một lần phát hành mô hình.