Nemotron 3 adalah respons NVIDIA terhadap keterbatasan yang muncul pada sistem AI multiagen. Maksudnya, saat sistem AI beralih ke alur kerja multiagen, biaya inferensi meningkat, koordinasi menjadi sulit, dan tugas jangka panjang membebani batas konteks.
Dengan Nemotron 3, setiap model dibangun di atas fondasi arsitektur yang sama namun menargetkan keseimbangan berbeda antara kedalaman penalaran, throughput, dan efisiensi.
Dalam artikel ini, kita akan melihat bagaimana keluarga Nemotron 3 disusun, apa yang berubah di balik layar, dan di mana posisinya dalam sistem agen yang umum digunakan.
Apa Itu Nemotron 3?
Gagasan inti di balik Nemotron 3 adalah spesialisasi. Beberapa agen perlu ringan dan cepat untuk menangani tugas rutin seperti perutean atau peringkasan. Yang lain bertanggung jawab atas analisis yang lebih mendalam atau perencanaan jangka panjang. Dengan menawarkan beberapa model dalam generasi yang sama, Nemotron 3 mendukung pembagian tugas tersebut sekaligus tetap transparan dan dapat dihosting sendiri.
Nemotron 3 nano
Nemotron 3 Nano adalah model yang paling berfokus pada efisiensi dalam keluarga ini. Ini adalah model dengan 30 miliar parameter yang mengaktifkan hingga 3 miliar parameter per token menggunakan arsitektur hybrid mixture-of-experts. Aktivasi selektif ini memungkinkan Nano mencapai throughput tinggi dan biaya inferensi rendah sekaligus mempertahankan akurasi yang kompetitif untuk ukurannya.
Nano ditujukan untuk tugas seperti peringkasan, pengambilan, klasifikasi, dan alur kerja asisten umum. Dalam sistem multiagen, model ini cocok sebagai pekerja ber-volume tinggi yang menangani langkah-langkah sering atau perantara tanpa menjadi penghambat biaya.
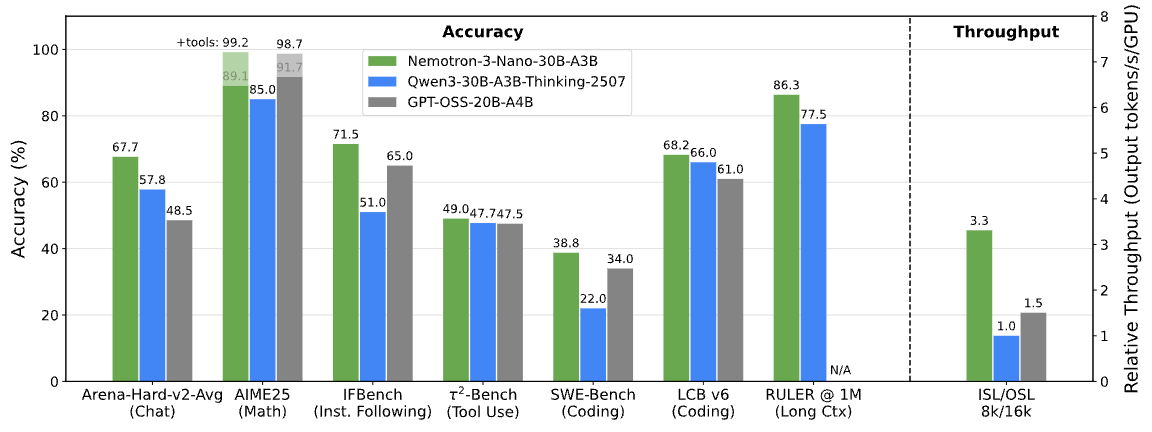
Tolok Ukur Nemotron 3. Gambar oleh NVIDIA Research
Nemotron 3 super
Nemotron 3 Super menargetkan skenario yang memerlukan penalaran lebih kuat namun tetap berada dalam batas latensi. Model ini memiliki sekitar 100 miliar parameter, dengan hingga 10 miliar aktif per token, dan dioptimalkan untuk beban kerja multiagen yang terkoordinasi.
Super berada di antara Nano dan Ultra. Model ini menawarkan kemampuan penalaran lebih tinggi daripada Nano tanpa memerlukan komputasi penuh dari model terbesar, sehingga cocok untuk agen yang perlu menggabungkan banyak masukan atau bernalar lintas langkah.
Nemotron 3 ultra
Nemotron 3 Ultra adalah model paling andal dalam jajaran ini. Dengan sekitar 500 miliar parameter dan hingga 50 miliar aktif per token, model ini berfungsi sebagai mesin penalaran kelas atas untuk alur kerja agen yang kompleks.
Ultra dirancang untuk tugas yang melibatkan analisis mendalam, perencanaan jangka panjang, atau pengambilan keputusan strategis. Meskipun persyaratan komputasinya lebih tinggi, model ini dimaksudkan untuk beroperasi bersama model Nemotron yang lebih kecil, dengan hanya tugas paling menuntut yang dialihkan kepadanya.
Apa yang Baru di Arsitektur Nemotron 3
Setelah jajaran model jelas, pertanyaan berikutnya adalah bagaimana NVIDIA menyeimbangkan skala dan efisiensi di berbagai tingkatan yang berbeda.
Alih-alih mengandalkan satu terobosan arsitektural, Nemotron 3 menggabungkan beberapa pilihan desain yang saling melengkapi untuk membuat sistem besar berbasis agen menjadi praktis dijalankan.
Desain hybrid latent mixture-of-experts
Inti Nemotron 3 adalah arsitektur hybrid latent mixture-of-experts (MoE). Alih-alih mengaktifkan semua parameter untuk setiap token, model merutekan setiap token melalui sebagian kecil jaringan ahli yang terspesialisasi.
Ini mengurangi biaya inferensi sambil mempertahankan kapasitas model yang jauh lebih besar. Dalam sistem berbasis agen di mana banyak agen dapat menghasilkan keluaran perantara secara bersamaan, aktivasi selektif membantu menjaga kebutuhan komputasi tetap terkelola seiring peningkatan skala.
Penggunaan presisi 4-bit dalam pelatihan
Nemotron 3 Super dan Ultra dilatih menggunakan format presisi 4-bit NVFP4 milik NVIDIA pada arsitektur Blackwell. Pelatihan berpresisi lebih rendah mengurangi penggunaan memori dan mempercepat pelatihan, memungkinkan pengerjaan model MoE yang lebih besar pada infrastruktur yang ada.
Pentingnya, hal ini dilakukan tanpa penurunan akurasi yang berarti dibandingkan format berpresisi lebih tinggi, yang membantu menjelaskan bagaimana Nemotron 3 dapat diskalakan sekaligus tetap praktis untuk diterapkan.
Perluasan jendela konteks untuk sekuens panjang
Nemotron 3 Nano mendukung jendela konteks hingga satu juta token. Ini memungkinkan model mempertahankan informasi di seluruh dokumen panjang, log yang diperluas, atau riwayat tugas multi-langkah.
Untuk alur kerja agen seperti perutean tugas antara agen perencanaan, pengambilan, dan eksekusi, konteks yang lebih panjang mengurangi kebutuhan akan pemenggalan agresif atau sistem memori eksternal.
Fitur Utama Nemotron 3
Keputusan arsitektur ini bukan abstraksi. Semuanya tampak langsung pada bagaimana Nemotron 3 berperilaku dalam sistem nyata.
Pengurangan generasi token penalaran
NVIDIA melaporkan bahwa Nemotron 3 Nano menghasilkan hingga 60% lebih sedikit token penalaran dibanding Nemotron 2 Nano. Dalam sistem multiagen, di mana langkah penalaran perantara dapat mendominasi penggunaan total token, pengurangan ini berdampak langsung pada biaya dan skalabilitas.
Jejak penalaran yang lebih singkat membantu menjaga inferensi tetap efisien tanpa mengorbankan akurasi tugas.
Throughput lebih tinggi untuk alur kerja multi-langkah
Kombinasi perutean MoE dan aktivasi parameter selektif memungkinkan Nemotron 3 mempertahankan throughput tinggi seiring alur kerja menjadi lebih kompleks. Ini memudahkan dukungan rantai tugas yang lebih panjang atau lebih banyak agen bersamaan tanpa peningkatan latensi yang proporsional.
Jendela konteks 1 juta untuk penalaran jangka panjang
Dengan dukungan hingga satu juta token pada Nano, Nemotron 3 memungkinkan penalaran jangka panjang atas masukan yang diperluas. Agen dapat merujuk langkah sebelumnya atau dokumen besar tanpa perlu berulang kali meringkas atau memuat ulang status, sehingga meningkatkan konsistensi dari waktu ke waktu.
Jika digabungkan, fitur-fitur ini menjelaskan mengapa Nemotron 3 menekankan efisiensi dan koordinasi dibanding performa mentah satu model.
Nemotron 3 vs. Nemotron 2: Apa yang Meningkat
Pada titik ini, tujuan desain Nemotron 3 seharusnya sudah jelas. Membandingkannya dengan Nemotron 2 membantu memvalidasi apakah tujuan tersebut diterjemahkan menjadi peningkatan yang terukur.
Nemotron 3 menyempurnakan perutean mixture-of-experts, meningkatkan throughput, mengurangi generasi token penalaran, dan secara signifikan memperluas panjang konteks. NVIDIA melaporkan hingga 4× throughput token yang lebih tinggi untuk Nemotron 3 Nano dibanding Nemotron 2 Nano, bersama pengurangan besar pada token penalaran.
Perbedaan lain adalah cakupan. Nemotron 3 meluas melampaui model semata, hadir dengan dataset reinforcement learning, data keamanan agen, dan perangkat terbuka seperti NeMo Gym dan NeMo RL. Nemotron 2 berfokus terutama pada rilis model, sementara Nemotron 3 diposisikan sebagai tumpukan yang lebih lengkap untuk pengembangan agen.
Nemotron 3 vs. Pesaing
Dengan arsitektur dan tolok ukur dalam konteks, menjadi lebih jelas di mana posisi Nemotron 3 dalam lanskap model saat ini. NVIDIA tidak memosisikan Nemotron 3 sebagai pengganti langsung untuk model proprietary terdepan. Sebaliknya, model ini menargetkan tantangan berbeda: membuat sistem AI berbasis agen menjadi efisien, dapat diprediksi, dan skalabel dalam penerapan nyata.
Dibanding model terbuka besar lainnya, Nemotron 3 menekankan lebih sedikit pada memaksimalkan skor tolok ukur satu model dan lebih pada perhatian tingkat sistem seperti throughput, efisiensi token penalaran, penanganan konteks panjang, dan koordinasi lintas agen. Kerangka ini mirip dengan cara Mistral memosisikan jajaran produknya, tetapi dengan fokus lebih kuat pada beban kerja multiagen.
Di mana Nemotron 3 unggul (dibanding model lain)
Tabel di bawah ini merangkum dimensi kunci tempat Nemotron 3 menonjol, relatif terhadap model populer lain yang terbuka maupun proprietary.
|
Dimensi
|
Nemotron 3
|
Mistral Large 3
|
Model Kelas DeepSeek
|
Model Proprietary Terdepan
|
|
Tujuan Desain Utama
|
Efisiensi multiagen dalam skala besar
|
Kemampuan satu model
|
Kedalaman penalaran per prompt
|
Penalaran terdepan & agen
|
|
Fokus Arsitektur
|
Hybrid latent MoE
|
Sparse MoE
|
Dense / MoE
|
Dense, proprietary
|
|
Throughput (Token/detik)
|
Sangat tinggi (Nano memimpin rekanan)
|
Tinggi namun boros komputasi
|
Sedang
|
Sedang hingga tinggi
|
|
Penggunaan Token Penalaran
|
Berkurang (hingga ~60% lebih sedikit pada Nano)
|
Sedang
|
Lebih tinggi
|
Lebih tinggi
|
|
Jendela Konteks
|
Hingga 1 juta token (Nano)
|
Hingga ~256 ribu
|
Panjang, namun lebih kecil
|
Panjang (bervariasi per model)
|
|
Kesesuaian Multiagen
|
Sangat baik
|
Sedang
|
Sedang
|
Kuat namun mahal
|
|
Self-Hosting & Kontrol
|
Penuh (bobot terbuka)
|
Penuh (bobot terbuka)
|
Penuh (bobot terbuka)
|
Terbatas / tidak ada
|
|
Kasus Penggunaan Terbaik
|
Koordinasi agen, perutean, peringkasan
|
Penalaran mendalam, pemrograman
|
Tugas matematika & penalaran
|
Perencanaan kompleks, SWE
|
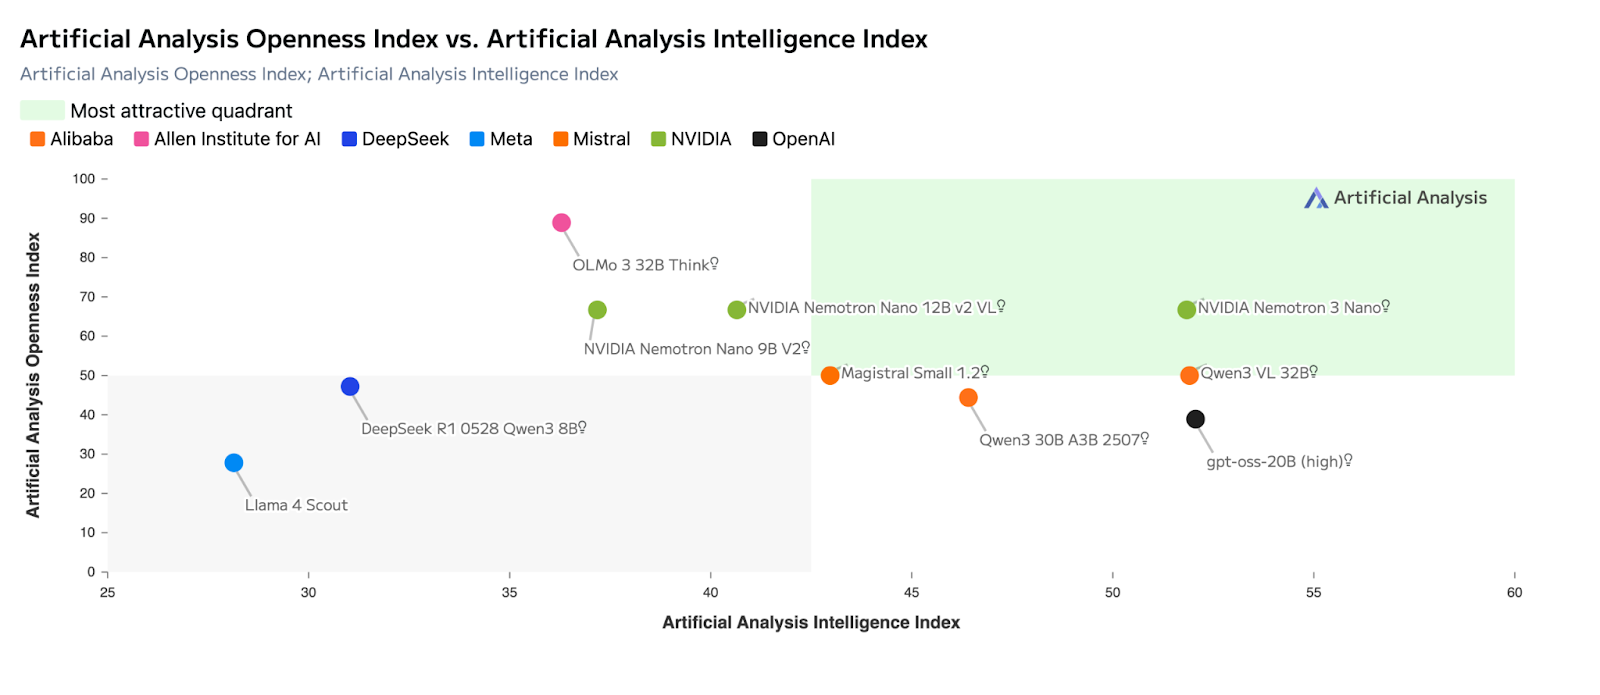
Nemotron 3 vs. Mistral Large 3
Mistral Large 3 dan Nemotron 3 sama-sama bergantung pada arsitektur mixture-of-experts, tetapi dioptimalkan untuk hasil berbeda.
Mistral Large 3 dirancang untuk memaksimalkan kemampuan satu model, berkinerja kuat pada penalaran, pemrograman, dan tolok ukur tujuan umum seperti LMArena dan evaluasi bergaya SWE. Sering kali ini menjadi pilihan yang lebih baik ketika satu model diharapkan menangani seluruh tugas dari awal hingga akhir.
Sebaliknya, Nemotron 3 dioptimalkan untuk efisiensi tingkat sistem. Desain hybrid latent MoE-nya mengaktifkan lebih sedikit parameter per token dan memprioritaskan throughput dibanding kedalaman penalaran puncak. Ini membuatnya lebih cocok untuk peran yang sarat koordinasi—perutean, peringkasan, dan penalaran perantara saat banyak agen beroperasi secara simultan.
Bagaimana Cara Mengakses Nemotron 3?
Setelah tujuan desainnya jelas, pertanyaan berikutnya bersifat praktis: bagaimana Anda dapat menjalankan Nemotron 3 hari ini, dan opsi mana yang masuk akal sesuai pengaturan Anda? NVIDIA menawarkan beberapa jalur akses, mulai dari API yang sepenuhnya dihosting hingga penerapan yang dikelola sendiri.
Akses API melalui penyedia inferensi terkelola
Cara tercepat untuk memulai adalah melalui penyedia inferensi terkelola. Nemotron 3 Nano tersedia hari ini di platform seperti Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter, dan Together AI. Layanan ini menyediakan antarmuka API standar, memungkinkan Anda menguji perilaku model, throughput, dan penanganan konteks panjang tanpa menyediakan perangkat keras.
Opsi ini cocok untuk membuat prototipe alur kerja agen, melakukan tolok ukur kinerja, atau mengintegrasikan Nemotron 3 ke aplikasi yang ada dengan penyiapan minimal.
Bobot terbuka dan hosting mandiri
Model Nemotron 3 juga dirilis dengan bobot terbuka di Hugging Face, memungkinkan kontrol penuh atas penerapan. Jalur ini ditujukan bagi tim yang ingin meng-host model sendiri, menyetelnya dengan data khusus domain, atau mengintegrasikannya ke dalam pipeline agen kustom.
Dengan bobot terbuka, Anda dapat:
- menjalankan model di infrastruktur Anda sendiri,
- memodifikasi atau menyetelnya sesuai kebutuhan,
- dan mengelola latensi, privasi, serta biaya dari ujung ke ujung.
Pendekatan ini selaras dengan penekanan NVIDIA pada transparansi dan kepemilikan untuk sistem agen yang tahan lama dan siap produksi.
Nvidia nim dan kerangka penerapan
Untuk tim yang menginginkan pengalaman hosting mandiri yang lebih terkelola, Nemotron 3 Nano juga tersedia sebagai layanan mikro NVIDIA NIM. NIM mengemas model untuk penerapan yang aman dan skalabel pada infrastruktur yang dipercepat NVIDIA, baik di lokasi (on-premises) maupun di cloud.
Seiring ekosistem matang, model Nemotron juga diharapkan terintegrasi dengan kerangka dan runtime penerapan umum yang digunakan untuk inferensi lokal dan edge. Opsi ini memudahkan untuk bereksperimen dengan Nemotron 3 di lingkungan terkontrol tanpa membangun tumpukan penerapan dari nol.
Linimasa ketersediaan model
Pada saat rilis:
- Nemotron 3 Nano tersedia sekarang melalui API terkelola, bobot terbuka, dan NVIDIA NIM.
- Nemotron 3 Super dan Ultra diperkirakan tersedia pada paruh pertama 2026.
Dalam praktiknya, ini berarti pengembang dapat mulai bereksperimen dengan Nano segera, sementara model yang lebih besar diposisikan untuk penerapan tahap lanjut yang memerlukan kapasitas penalaran lebih kuat.
Seberapa Baik Nemotron 3?
Nemotron 3 kuat dalam cakupan yang dimaksudkan. Kontribusi utamanya bukan mendorong batas penalaran satu model, melainkan membuat sistem berbasis agen lebih praktis diterapkan dan diskalakan.
Pilihan arsitekturalnya diterjemahkan menjadi manfaat operasional nyata, terutama untuk alur kerja yang bergantung pada banyak agen yang bekerja sama. Meski begitu, jika kebutuhan utama Anda adalah penalaran satu model yang mendalam atau perencanaan kompleks berbasis alat, model proprietary terdepan masih cenderung lebih konsisten.
Dilihat melalui lensa yang tepat, Nemotron 3 melengkapi model-model tersebut alih-alih menggantikannya.
Kasus Penggunaan Nemotron 3
Nemotron 3 paling cocok untuk skenario di mana efisiensi, transparansi, dan skalabilitas penting.
- Sistem multiagen: perutean, koordinasi, dan penalaran perantara
- Pemrosesan dokumen panjang: peringkasan, ekstraksi, dan analisis atas masukan besar
- Asisten perusahaan: alat internal yang memerlukan kinerja prediktabel dan hosting mandiri
- Otomasi alur kerja: klasifikasi, pengambilan, dan dukungan keputusan dalam skala besar
- Penerapan sensitif privasi: lingkungan on-premises atau AI kedaulatan
Karena modelnya terbuka dan dirancang untuk bekerja bersama, tim dapat menetapkan peran berbeda pada ukuran model yang berbeda alih-alih bergantung pada satu sistem monolitik.
Penutup
Fokus NVIDIA pada efisiensi, keterbukaan, dan desain tingkat sistem mencerminkan bagaimana banyak aplikasi AI dunia nyata kini dibangun.
Kini, untuk membangun secara efektif dengan model seperti Nemotron 3, akan membantu jika Anda memahami dasar-dasar LLM dan integrasi sistem.
Kursus Konsep Large Language Models (LLMs) kami memberikan landasan konseptual, sementara rute keterampilan Membangun API di Python membahas sisi praktis mengintegrasikan model ke dalam aplikasi.
Dilihat sebagai bagian dari sistem yang lebih besar, Nemotron 3 terasa kurang seperti rilis model dan lebih seperti fondasi untuk bagaimana AI berbasis agen diterapkan saat ini.



 Javier Canales Luna · 14 min

 Dario Radečić · 15 min

 Hugo Bowne-Anderson · 13 min


Nemotron 3 adalah respons NVIDIA terhadap keterbatasan yang muncul pada sistem AI multiagen. Maksudnya, saat sistem AI beralih ke alur kerja multiagen, biaya inferensi meningkat, koordinasi menjadi sulit, dan tugas jangka panjang membebani batas konteks.
Dengan Nemotron 3, setiap model dibangun di atas fondasi arsitektur yang sama namun menargetkan keseimbangan berbeda antara kedalaman penalaran, throughput, dan efisiensi.
Dalam artikel ini, kita akan melihat bagaimana keluarga Nemotron 3 disusun, apa yang berubah di balik layar, dan di mana posisinya dalam sistem agen yang umum digunakan.
Apa Itu Nemotron 3?
Gagasan inti di balik Nemotron 3 adalah spesialisasi. Beberapa agen perlu ringan dan cepat untuk menangani tugas rutin seperti perutean atau peringkasan. Yang lain bertanggung jawab atas analisis yang lebih mendalam atau perencanaan jangka panjang. Dengan menawarkan beberapa model dalam generasi yang sama, Nemotron 3 mendukung pembagian tugas tersebut sekaligus tetap transparan dan dapat dihosting sendiri.
Nemotron 3 nano
Nemotron 3 Nano adalah model yang paling berfokus pada efisiensi dalam keluarga ini. Ini adalah model dengan 30 miliar parameter yang mengaktifkan hingga 3 miliar parameter per token menggunakan arsitektur hybrid mixture-of-experts. Aktivasi selektif ini memungkinkan Nano mencapai throughput tinggi dan biaya inferensi rendah sekaligus mempertahankan akurasi yang kompetitif untuk ukurannya.
Nano ditujukan untuk tugas seperti peringkasan, pengambilan, klasifikasi, dan alur kerja asisten umum. Dalam sistem multiagen, model ini cocok sebagai pekerja ber-volume tinggi yang menangani langkah-langkah sering atau perantara tanpa menjadi penghambat biaya.
Tolok Ukur Nemotron 3. Gambar oleh NVIDIA Research
Nemotron 3 super
Nemotron 3 Super menargetkan skenario yang memerlukan penalaran lebih kuat namun tetap berada dalam batas latensi. Model ini memiliki sekitar 100 miliar parameter, dengan hingga 10 miliar aktif per token, dan dioptimalkan untuk beban kerja multiagen yang terkoordinasi.
Super berada di antara Nano dan Ultra. Model ini menawarkan kemampuan penalaran lebih tinggi daripada Nano tanpa memerlukan komputasi penuh dari model terbesar, sehingga cocok untuk agen yang perlu menggabungkan banyak masukan atau bernalar lintas langkah.
Nemotron 3 ultra
Nemotron 3 Ultra adalah model paling andal dalam jajaran ini. Dengan sekitar 500 miliar parameter dan hingga 50 miliar aktif per token, model ini berfungsi sebagai mesin penalaran kelas atas untuk alur kerja agen yang kompleks.
Ultra dirancang untuk tugas yang melibatkan analisis mendalam, perencanaan jangka panjang, atau pengambilan keputusan strategis. Meskipun persyaratan komputasinya lebih tinggi, model ini dimaksudkan untuk beroperasi bersama model Nemotron yang lebih kecil, dengan hanya tugas paling menuntut yang dialihkan kepadanya.
Apa yang Baru di Arsitektur Nemotron 3
Setelah jajaran model jelas, pertanyaan berikutnya adalah bagaimana NVIDIA menyeimbangkan skala dan efisiensi di berbagai tingkatan yang berbeda.
Alih-alih mengandalkan satu terobosan arsitektural, Nemotron 3 menggabungkan beberapa pilihan desain yang saling melengkapi untuk membuat sistem besar berbasis agen menjadi praktis dijalankan.
Desain hybrid latent mixture-of-experts
Inti Nemotron 3 adalah arsitektur hybrid latent mixture-of-experts (MoE). Alih-alih mengaktifkan semua parameter untuk setiap token, model merutekan setiap token melalui sebagian kecil jaringan ahli yang terspesialisasi.
Ini mengurangi biaya inferensi sambil mempertahankan kapasitas model yang jauh lebih besar. Dalam sistem berbasis agen di mana banyak agen dapat menghasilkan keluaran perantara secara bersamaan, aktivasi selektif membantu menjaga kebutuhan komputasi tetap terkelola seiring peningkatan skala.
Penggunaan presisi 4-bit dalam pelatihan
Nemotron 3 Super dan Ultra dilatih menggunakan format presisi 4-bit NVFP4 milik NVIDIA pada arsitektur Blackwell. Pelatihan berpresisi lebih rendah mengurangi penggunaan memori dan mempercepat pelatihan, memungkinkan pengerjaan model MoE yang lebih besar pada infrastruktur yang ada.
Pentingnya, hal ini dilakukan tanpa penurunan akurasi yang berarti dibandingkan format berpresisi lebih tinggi, yang membantu menjelaskan bagaimana Nemotron 3 dapat diskalakan sekaligus tetap praktis untuk diterapkan.
Perluasan jendela konteks untuk sekuens panjang
Nemotron 3 Nano mendukung jendela konteks hingga satu juta token. Ini memungkinkan model mempertahankan informasi di seluruh dokumen panjang, log yang diperluas, atau riwayat tugas multi-langkah.
Untuk alur kerja agen seperti perutean tugas antara agen perencanaan, pengambilan, dan eksekusi, konteks yang lebih panjang mengurangi kebutuhan akan pemenggalan agresif atau sistem memori eksternal.
Fitur Utama Nemotron 3
Keputusan arsitektur ini bukan abstraksi. Semuanya tampak langsung pada bagaimana Nemotron 3 berperilaku dalam sistem nyata.
Pengurangan generasi token penalaran
NVIDIA melaporkan bahwa Nemotron 3 Nano menghasilkan hingga 60% lebih sedikit token penalaran dibanding Nemotron 2 Nano. Dalam sistem multiagen, di mana langkah penalaran perantara dapat mendominasi penggunaan total token, pengurangan ini berdampak langsung pada biaya dan skalabilitas.
Jejak penalaran yang lebih singkat membantu menjaga inferensi tetap efisien tanpa mengorbankan akurasi tugas.
Throughput lebih tinggi untuk alur kerja multi-langkah
Kombinasi perutean MoE dan aktivasi parameter selektif memungkinkan Nemotron 3 mempertahankan throughput tinggi seiring alur kerja menjadi lebih kompleks. Ini memudahkan dukungan rantai tugas yang lebih panjang atau lebih banyak agen bersamaan tanpa peningkatan latensi yang proporsional.
Jendela konteks 1 juta untuk penalaran jangka panjang
Dengan dukungan hingga satu juta token pada Nano, Nemotron 3 memungkinkan penalaran jangka panjang atas masukan yang diperluas. Agen dapat merujuk langkah sebelumnya atau dokumen besar tanpa perlu berulang kali meringkas atau memuat ulang status, sehingga meningkatkan konsistensi dari waktu ke waktu.
Jika digabungkan, fitur-fitur ini menjelaskan mengapa Nemotron 3 menekankan efisiensi dan koordinasi dibanding performa mentah satu model.
Nemotron 3 vs. Nemotron 2: Apa yang Meningkat
Pada titik ini, tujuan desain Nemotron 3 seharusnya sudah jelas. Membandingkannya dengan Nemotron 2 membantu memvalidasi apakah tujuan tersebut diterjemahkan menjadi peningkatan yang terukur.
Nemotron 3 menyempurnakan perutean mixture-of-experts, meningkatkan throughput, mengurangi generasi token penalaran, dan secara signifikan memperluas panjang konteks. NVIDIA melaporkan hingga 4× throughput token yang lebih tinggi untuk Nemotron 3 Nano dibanding Nemotron 2 Nano, bersama pengurangan besar pada token penalaran.
Perbedaan lain adalah cakupan. Nemotron 3 meluas melampaui model semata, hadir dengan dataset reinforcement learning, data keamanan agen, dan perangkat terbuka seperti NeMo Gym dan NeMo RL. Nemotron 2 berfokus terutama pada rilis model, sementara Nemotron 3 diposisikan sebagai tumpukan yang lebih lengkap untuk pengembangan agen.
Nemotron 3 vs. Pesaing
Dengan arsitektur dan tolok ukur dalam konteks, menjadi lebih jelas di mana posisi Nemotron 3 dalam lanskap model saat ini. NVIDIA tidak memosisikan Nemotron 3 sebagai pengganti langsung untuk model proprietary terdepan. Sebaliknya, model ini menargetkan tantangan berbeda: membuat sistem AI berbasis agen menjadi efisien, dapat diprediksi, dan skalabel dalam penerapan nyata.
Dibanding model terbuka besar lainnya, Nemotron 3 menekankan lebih sedikit pada memaksimalkan skor tolok ukur satu model dan lebih pada perhatian tingkat sistem seperti throughput, efisiensi token penalaran, penanganan konteks panjang, dan koordinasi lintas agen. Kerangka ini mirip dengan cara Mistral memosisikan jajaran produknya, tetapi dengan fokus lebih kuat pada beban kerja multiagen.
Di mana Nemotron 3 unggul (dibanding model lain)
Tabel di bawah ini merangkum dimensi kunci tempat Nemotron 3 menonjol, relatif terhadap model populer lain yang terbuka maupun proprietary.
Dimensi
Nemotron 3
Mistral Large 3
Model Kelas DeepSeek
Model Proprietary Terdepan
Tujuan Desain Utama
Efisiensi multiagen dalam skala besar
Kemampuan satu model
Kedalaman penalaran per prompt
Penalaran terdepan & agen
Fokus Arsitektur
Hybrid latent MoE
Sparse MoE
Dense / MoE
Dense, proprietary
Throughput (Token/detik)
Sangat tinggi (Nano memimpin rekanan)
Tinggi namun boros komputasi
Sedang
Sedang hingga tinggi
Penggunaan Token Penalaran
Berkurang (hingga ~60% lebih sedikit pada Nano)
Sedang
Lebih tinggi
Lebih tinggi
Jendela Konteks
Hingga 1 juta token (Nano)
Hingga ~256 ribu
Panjang, namun lebih kecil
Panjang (bervariasi per model)
Kesesuaian Multiagen
Sangat baik
Sedang
Sedang
Kuat namun mahal
Self-Hosting & Kontrol
Penuh (bobot terbuka)
Penuh (bobot terbuka)
Penuh (bobot terbuka)
Terbatas / tidak ada
Kasus Penggunaan Terbaik
Koordinasi agen, perutean, peringkasan
Penalaran mendalam, pemrograman
Tugas matematika & penalaran
Perencanaan kompleks, SWE
Nemotron 3 vs. Mistral Large 3
Mistral Large 3 dan Nemotron 3 sama-sama bergantung pada arsitektur mixture-of-experts, tetapi dioptimalkan untuk hasil berbeda.
Mistral Large 3 dirancang untuk memaksimalkan kemampuan satu model, berkinerja kuat pada penalaran, pemrograman, dan tolok ukur tujuan umum seperti LMArena dan evaluasi bergaya SWE. Sering kali ini menjadi pilihan yang lebih baik ketika satu model diharapkan menangani seluruh tugas dari awal hingga akhir.
Sebaliknya, Nemotron 3 dioptimalkan untuk efisiensi tingkat sistem. Desain hybrid latent MoE-nya mengaktifkan lebih sedikit parameter per token dan memprioritaskan throughput dibanding kedalaman penalaran puncak. Ini membuatnya lebih cocok untuk peran yang sarat koordinasi—perutean, peringkasan, dan penalaran perantara saat banyak agen beroperasi secara simultan.
Bagaimana Cara Mengakses Nemotron 3?
Setelah tujuan desainnya jelas, pertanyaan berikutnya bersifat praktis: bagaimana Anda dapat menjalankan Nemotron 3 hari ini, dan opsi mana yang masuk akal sesuai pengaturan Anda? NVIDIA menawarkan beberapa jalur akses, mulai dari API yang sepenuhnya dihosting hingga penerapan yang dikelola sendiri.
Akses API melalui penyedia inferensi terkelola
Cara tercepat untuk memulai adalah melalui penyedia inferensi terkelola. Nemotron 3 Nano tersedia hari ini di platform seperti Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter, dan Together AI. Layanan ini menyediakan antarmuka API standar, memungkinkan Anda menguji perilaku model, throughput, dan penanganan konteks panjang tanpa menyediakan perangkat keras.
Opsi ini cocok untuk membuat prototipe alur kerja agen, melakukan tolok ukur kinerja, atau mengintegrasikan Nemotron 3 ke aplikasi yang ada dengan penyiapan minimal.
Bobot terbuka dan hosting mandiri
Model Nemotron 3 juga dirilis dengan bobot terbuka di Hugging Face, memungkinkan kontrol penuh atas penerapan. Jalur ini ditujukan bagi tim yang ingin meng-host model sendiri, menyetelnya dengan data khusus domain, atau mengintegrasikannya ke dalam pipeline agen kustom.
Dengan bobot terbuka, Anda dapat:
Pendekatan ini selaras dengan penekanan NVIDIA pada transparansi dan kepemilikan untuk sistem agen yang tahan lama dan siap produksi.
Nvidia nim dan kerangka penerapan
Untuk tim yang menginginkan pengalaman hosting mandiri yang lebih terkelola, Nemotron 3 Nano juga tersedia sebagai layanan mikro NVIDIA NIM. NIM mengemas model untuk penerapan yang aman dan skalabel pada infrastruktur yang dipercepat NVIDIA, baik di lokasi (on-premises) maupun di cloud.
Seiring ekosistem matang, model Nemotron juga diharapkan terintegrasi dengan kerangka dan runtime penerapan umum yang digunakan untuk inferensi lokal dan edge. Opsi ini memudahkan untuk bereksperimen dengan Nemotron 3 di lingkungan terkontrol tanpa membangun tumpukan penerapan dari nol.
Linimasa ketersediaan model
Pada saat rilis:
Dalam praktiknya, ini berarti pengembang dapat mulai bereksperimen dengan Nano segera, sementara model yang lebih besar diposisikan untuk penerapan tahap lanjut yang memerlukan kapasitas penalaran lebih kuat.
Seberapa Baik Nemotron 3?
Nemotron 3 kuat dalam cakupan yang dimaksudkan. Kontribusi utamanya bukan mendorong batas penalaran satu model, melainkan membuat sistem berbasis agen lebih praktis diterapkan dan diskalakan.
Pilihan arsitekturalnya diterjemahkan menjadi manfaat operasional nyata, terutama untuk alur kerja yang bergantung pada banyak agen yang bekerja sama. Meski begitu, jika kebutuhan utama Anda adalah penalaran satu model yang mendalam atau perencanaan kompleks berbasis alat, model proprietary terdepan masih cenderung lebih konsisten.
Dilihat melalui lensa yang tepat, Nemotron 3 melengkapi model-model tersebut alih-alih menggantikannya.
Kasus Penggunaan Nemotron 3
Nemotron 3 paling cocok untuk skenario di mana efisiensi, transparansi, dan skalabilitas penting.
Karena modelnya terbuka dan dirancang untuk bekerja bersama, tim dapat menetapkan peran berbeda pada ukuran model yang berbeda alih-alih bergantung pada satu sistem monolitik.
Penutup
Fokus NVIDIA pada efisiensi, keterbukaan, dan desain tingkat sistem mencerminkan bagaimana banyak aplikasi AI dunia nyata kini dibangun.
Kini, untuk membangun secara efektif dengan model seperti Nemotron 3, akan membantu jika Anda memahami dasar-dasar LLM dan integrasi sistem.
Kursus Konsep Large Language Models (LLMs) kami memberikan landasan konseptual, sementara rute keterampilan Membangun API di Python membahas sisi praktis mengintegrasikan model ke dalam aplikasi.
Dilihat sebagai bagian dari sistem yang lebih besar, Nemotron 3 terasa kurang seperti rilis model dan lebih seperti fondasi untuk bagaimana AI berbasis agen diterapkan saat ini.