कोर्स
Understanding Artificial Intelligence
2 घंटा
427.4K
Nemotron 3, मल्टी-एजेंट AI सिस्टम्स की उभरती सीमाओं पर NVIDIA की प्रतिक्रिया है। मतलब यह कि जैसे-जैसे AI सिस्टम्स मल्टी-एजेंट वर्कफ़्लोज़ की ओर बढ़ते हैं, इन्फेरेंस लागत बढ़ती है, समन्वय कठिन होता है, और लंबे समय तक चलने वाले कार्य संदर्भ सीमाओं पर दबाव डालते हैं।
Nemotron 3 के साथ, हर मॉडल एक ही आर्किटेक्चरल नींव पर बना है, लेकिन तर्क की गहराई, थ्रूपुट, और दक्षता के अलग-अलग संतुलन को लक्षित करता है।
इस लेख में, हम देखेंगे कि Nemotron 3 परिवार कैसे संरचित है, अंदरूनी तौर पर क्या बदला है, और यह आमतौर पर उपयोग होने वाले एजेंट सिस्टम्स में कहां फिट बैठता है।
Nemotron 3 के पीछे का मूल विचार है विशेषज्ञता। कुछ एजेंट्स को हल्का और तेज़ होना चाहिए, जो रूटिंग या सार-संक्षेप जैसी नियमित गतिविधियां संभालें। अन्य एजेंट्स गहरी विश्लेषणात्मक क्षमता या लंबी-अवधि की योजना के लिए ज़िम्मेदार होते हैं। एक ही पीढ़ी में कई मॉडल उपलब्ध कराकर, Nemotron 3 इस कार्य-विभाजन का समर्थन करता है, साथ ही पारदर्शी और स्व-होस्टेबल बना रहता है।
Nemotron 3 Nano इस परिवार का सबसे दक्षता-केंद्रित मॉडल है। यह एक 30B-पैरामीटर मॉडल है, जो हाइब्रिड मिक्सचर-ऑफ-एक्सपर्ट्स आर्किटेक्चर का उपयोग करके प्रति टोकन अधिकतम 3B पैरामीटर सक्रिय करता है। यह चयनात्मक सक्रियण Nano को उच्च थ्रूपुट और कम इन्फेरेंस लागत हासिल करने देता है, जबकि अपने आकार के लिए प्रतिस्पर्धी सटीकता बनाए रखता है।
Nano का उद्देश्य सार-संक्षेप, रिट्रीवल, वर्गीकरण, और सामान्य सहायक वर्कफ़्लोज़ जैसे कार्य हैं। मल्टी-एजेंट सिस्टम्स में, यह एक उच्च-वॉल्यूम वर्कर के रूप में अच्छा काम करता है, जो बार-बार या मध्यवर्ती चरणों को संभालते हुए भी लागत की बाधा नहीं बनता।
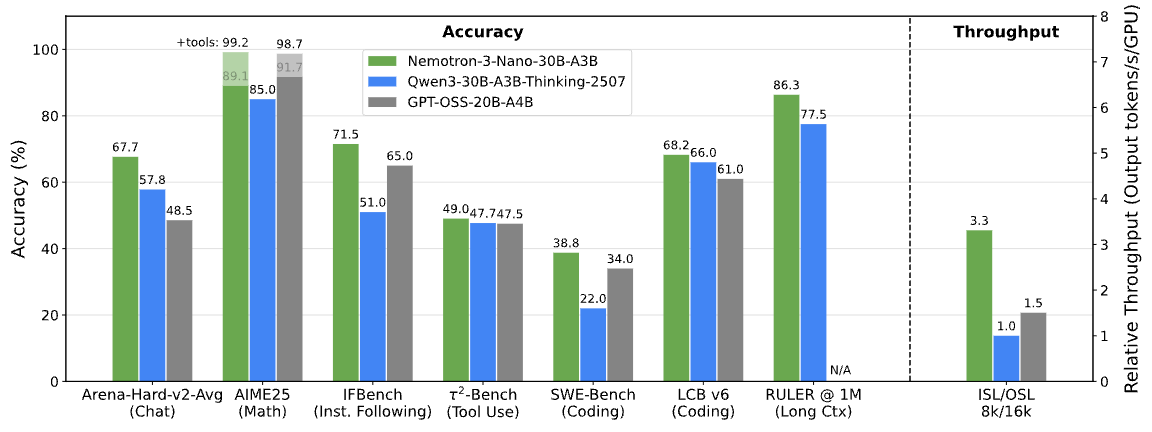
Nemotron 3 बेंचमार्क। छवि: NVIDIA Research
Nemotron 3 Super उन परिदृश्यों को लक्षित करता है जिन्हें अधिक मजबूत तर्कक्षमता चाहिए, जबकि विलंबता सीमाओं के भीतर काम करना हो। इसमें लगभग 100B पैरामीटर हैं, जिनमें प्रति टोकन 10B तक सक्रिय होते हैं, और यह समन्वित मल्टी-एजेंट वर्कलोड्स के लिए अनुकूलित है।
Super, Nano और Ultra के बीच में बैठता है। यह Nano से अधिक तर्कक्षमता देता है, बिना सबसे बड़े मॉडल की पूरी कंप्यूट आवश्यकताओं के, जिससे यह उन एजेंट्स के लिए उपयुक्त बनता है जिन्हें कई इनपुट्स को संयोजित करना या चरणों में तर्क करना होता है।
Nemotron 3 Ultra इस लाइनअप का सबसे सक्षम मॉडल है। लगभग 500B पैरामीटर और प्रति टोकन 50B तक सक्रियण के साथ, यह जटिल एजेंटिक वर्कफ़्लोज़ के लिए एक हाई-एंड तर्क इंजन के रूप में काम करता है।
Ultra को गहन विश्लेषण, लंबी-अवधि की योजना, या सामरिक निर्णय-निर्माण वाले कार्यों के लिए डिज़ाइन किया गया है। यद्यपि इसकी कंप्यूट आवश्यकताएं अधिक हैं, इसे छोटे Nemotron मॉडलों के साथ मिलकर काम करने के लिए बनाया गया है, ताकि केवल सबसे मांग वाले कार्य ही इसकी ओर रूट हों।
अब जब मॉडल लाइनअप स्पष्ट है, अगला सवाल यह है कि NVIDIA इतने भिन्न स्तरों पर स्केल और दक्षता का संतुलन कैसे बनाता है।
एकल आर्किटेक्चरल ब्रेकथ्रू पर निर्भर होने के बजाय, Nemotron 3 कई परस्पर पूरक डिज़ाइन विकल्पों को जोड़ता है ताकि बड़े, मल्टी-एजेंट सिस्टम्स को व्यावहारिक रूप से चलाया जा सके।
Nemotron 3 के केंद्र में एक हाइब्रिड लेटेंट mixture-of-experts (MoE) आर्किटेक्चर है। हर टोकन के लिए सभी पैरामीटर सक्रिय करने के बजाय, मॉडल हर टोकन को कुछ विशेषीकृत विशेषज्ञ नेटवर्क्स के छोटे उपसमूह के माध्यम से रूट करता है।
यह इन्फेरेंस लागत कम करता है, जबकि कहीं अधिक बड़े मॉडल की क्षमता को संरक्षित रखता है। एजेंट-आधारित सिस्टम्स में, जहां कई एजेंट्स एक साथ मध्यवर्ती आउटपुट उत्पन्न कर सकते हैं, चयनात्मक सक्रियण स्केल बढ़ने पर कंप्यूट आवश्यकताओं को प्रबंधनीय बनाए रखने में मदद करता है।
Nemotron 3 Super और Ultra को NVIDIA के 4-बिट NVFP4 प्रिसिशन फ़ॉर्मैट का उपयोग करके Blackwell आर्किटेक्चर पर प्रशिक्षित किया गया है। कम-प्रिसिशन ट्रेनिंग से मेमोरी उपयोग घटता है और ट्रेनिंग तेज़ होती है, जिससे मौजूदा इन्फ्रास्ट्रक्चर पर बड़े MoE मॉडलों के साथ काम संभव होता है।
महत्वपूर्ण बात यह है कि यह उच्च-प्रिसिशन फ़ॉर्मैट्स की तुलना में सटीकता में किसी सार्थक गिरावट के बिना किया जाता है, जो समझाता है कि Nemotron 3 कैसे स्केल कर सकता है और फिर भी परिनियोजन के लिए व्यावहारिक बना रहता है।
Nemotron 3 Nano एक मिलियन टोकन तक के संदर्भ विंडो का समर्थन करता है। इससे मॉडल को लंबे दस्तावेज़ों, विस्तारित लॉग्स, या बहु-चरणीय कार्य इतिहासों में जानकारी बनाए रखने में मदद मिलती है।
रूटिंग, रिट्रीवल, और निष्पादन एजेंट्स के बीच कार्यों को पास करने जैसी एजेंट वर्कफ़्लोज़ के लिए, लंबा संदर्भ आक्रामक चंकिंग या बाहरी मेमोरी सिस्टम्स की आवश्यकता को घटाता है।
ये आर्किटेक्चरल फैसले सैद्धांतिक नहीं हैं। वे सीधे इस बात में दिखाई देते हैं कि Nemotron 3 वास्तविक सिस्टम्स में कैसा व्यवहार करता है।
NVIDIA का कहना है कि Nemotron 3 Nano, Nemotron 2 Nano की तुलना में अधिकतम 60% तक कम रीजनिंग टोकन उत्पन्न करता है। मल्टी-एजेंट सिस्टम्स में, जहां मध्यवर्ती तर्क-चरण कुल टोकन उपयोग पर हावी हो सकते हैं, यह कमी सीधे लागत और स्केलेबिलिटी पर असर डालती है।
छोटे तर्क-ट्रेसेज़, कार्य-सटीकता से समझौता किए बिना, इन्फेरेंस को कुशल बनाए रखने में मदद करते हैं।
MoE रूटिंग और चयनात्मक पैरामीटर सक्रियण का संयोजन, वर्कफ़्लोज़ के अधिक जटिल होने पर भी Nemotron 3 को उच्च थ्रूपुट बनाए रखने देता है। इससे लंबी टास्क-चेन या अधिक समवर्ती एजेंट्स का समर्थन करना आसान हो जाता है, बिना विलंबता में आनुपातिक वृद्धि के।
Nano में एक मिलियन टोकन तक के समर्थन के साथ, Nemotron 3 विस्तृत इनपुट्स पर लंबी-अवधि का तर्क सक्षम करता है। एजेंट्स बड़े दस्तावेज़ों या पहले के चरणों का संदर्भ ले सकते हैं, बिना बार-बार संक्षेपण करने या स्टेट को फिर से लोड करने के—समय के साथ स्थिरता में सुधार होता है।
इन विशेषताओं को साथ रखकर देखें, तो स्पष्ट होता है कि Nemotron 3 क्यों एकल-मॉडल के कच्चे प्रदर्शन के बजाय दक्षता और समन्वय पर ज़ोर देता है।
इस बिंदु तक, Nemotron 3 के डिज़ाइन लक्ष्यों को स्पष्ट होना चाहिए। इसे Nemotron 2 से तुलना करना यह सत्यापित करने में मदद करता है कि क्या वे लक्ष्य मापनीय सुधारों में बदले।
Nemotron 3, mixture-of-experts रूटिंग को परिष्कृत करता है, थ्रूपुट बढ़ाता है, रीजनिंग टोकन जनरेशन घटाता है, और संदर्भ लंबाई को उल्लेखनीय रूप से विस्तारित करता है। NVIDIA, Nemotron 2 Nano की तुलना में Nemotron 3 Nano के लिए टोकन थ्रूपुट में 4× तक वृद्धि की रिपोर्ट करता है, साथ ही रीजनिंग टोकन्स में बड़ी कमी भी।
एक और अंतर दायरे का है। Nemotron 3 मॉडलों से आगे बढ़कर, रिइन्फोर्समेंट लर्निंग डेटासेट्स, एजेंट सेफ़्टी डेटा, और NeMo Gym तथा NeMo RL जैसे ओपन टूलिंग के साथ आता है। Nemotron 2 मुख्यतः मॉडल रिलीज़ पर केंद्रित था, जबकि Nemotron 3 को एजेंट डेवलपमेंट के लिए एक अधिक संपूर्ण स्टैक के रूप में पेश किया गया है।
आर्किटेक्चर और बेंचमार्क के संदर्भ में, यह स्पष्ट हो जाता है कि वर्तमान मॉडल परिदृश्य में Nemotron 3 कहां फिट बैठता है। NVIDIA, Nemotron 3 को सीमांत स्वामित्व वाले मॉडलों के ड्रॉप-इन रिप्लेसमेंट के रूप में पेश नहीं कर रहा है। इसके बजाय, यह एक अलग चुनौती को लक्षित करता है: वास्तविक परिनियोजनों में एजेंट-आधारित AI सिस्टम्स को कुशल, पूर्वानुमेय, और स्केलेबल बनाना।
अन्य बड़े ओपन मॉडलों की तुलना में, Nemotron 3 एकल-मॉडल बेंचमार्क स्कोर को अधिकतम करने पर कम, और थ्रूपुट, रीजनिंग-टोकन दक्षता, लंबे संदर्भ का प्रबंधन, और एजेंट्स के बीच समन्वय जैसे सिस्टम-स्तरीय मुद्दों पर अधिक जोर देता है। यह फ्रेमिंग कुछ वैसी ही है जैसी Mistral अपने लाइनअप को प्रस्तुत करता है, लेकिन मल्टी-एजेंट वर्कलोड्स पर अधिक सशक्त फोकस के साथ।
नीचे दी गई तालिका उन प्रमुख आयामों का सार प्रस्तुत करती है जिनमें Nemotron 3 उभरकर सामने आता है, लोकप्रिय ओपन और स्वामित्व वाले मॉडलों की तुलना में।
|
आयाम |
Nemotron 3 |
Mistral Large 3 |
DeepSeek-श्रेणी के मॉडल |
सीमांत स्वामित्व वाले मॉडल |
|
मुख्य डिज़ाइन लक्ष्य |
स्केल पर मल्टी-एजेंट दक्षता |
एकल-मॉडल क्षमता |
प्रति प्रॉम्प्ट तर्क की गहराई |
सीमांत तर्क व एजेंट्स |
|
आर्किटेक्चर फोकस |
हाइब्रिड लेटेंट MoE |
स्पार्स MoE |
डेंस / MoE |
डेंस, स्वामित्व |
|
थ्रूपुट (टोकन/सेकंड) |
बहुत उच्च (Nano समकक्षों से आगे) |
उच्च लेकिन कंप्यूट-भारी |
मध्यम |
मध्यम से उच्च |
|
रीजनिंग टोकन उपयोग |
घटा हुआ (Nano में ~60% तक कम) |
मध्यम |
अधिक |
अधिक |
|
संदर्भ विंडो |
1M टोकन तक (Nano) |
~256K तक |
लंबा, पर छोटा |
लंबा (मॉडल पर निर्भर) |
|
मल्टी-एजेंट उपयुक्तता |
उत्कृष्ट |
मध्यम |
मध्यम |
मजबूत, पर महंगा |
|
स्व-होस्टिंग और नियंत्रण |
पूर्ण (ओपन वेट्स) |
पूर्ण (ओपन वेट्स) |
पूर्ण (ओपन वेट्स) |
सीमित / नहीं |
|
सर्वश्रेष्ठ उपयोग मामला |
एजेंट समन्वय, रूटिंग, सार-संक्षेप |
गहन तर्क, कोडिंग |
गणित और तर्क कार्य |
जटिल योजना, SWE |
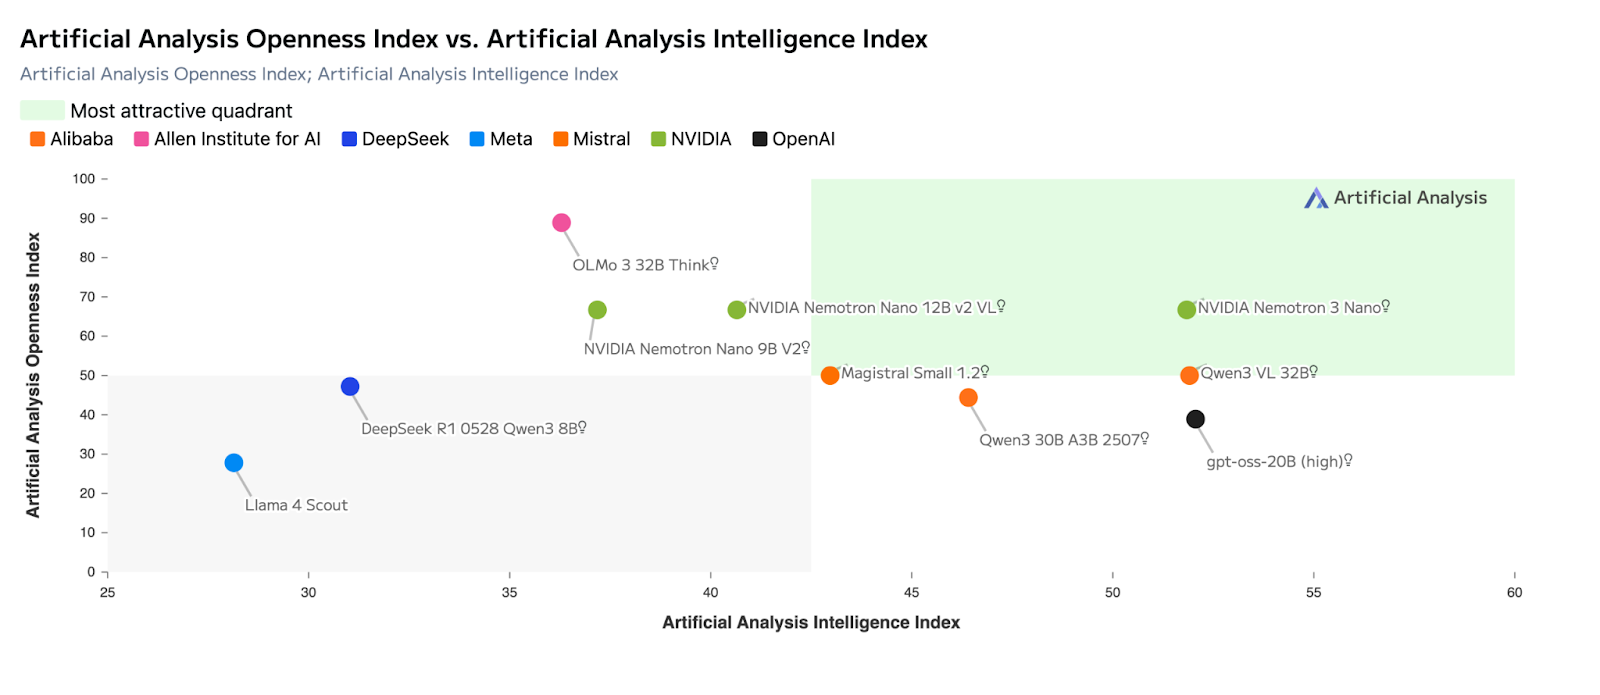
Mistral Large 3 और Nemotron 3, दोनों mixture-of-experts आर्किटेक्चर पर निर्भर हैं, लेकिन वे अलग-अलग परिणामों के लिए अनुकूलित हैं।
Mistral Large 3 को एकल-मॉडल क्षमता को अधिकतम करने के लिए डिज़ाइन किया गया है, जो तर्क, कोडिंग, और LMArena तथा SWE-शैली के मूल्यांकन जैसे सामान्य प्रयोजन बेंचमार्क्स पर मजबूत प्रदर्शन करता है। जब एक ही मॉडल से किसी कार्य को एंड-टू-एंड संभालने की उम्मीद हो, तो यह अक्सर बेहतर विकल्प होता है।
इसके विपरीत, Nemotron 3 को सिस्टम-स्तरीय दक्षता के लिए अनुकूलित किया गया है। इसका हाइब्रिड लेटेंट MoE डिज़ाइन प्रति टोकन कम पैरामीटर सक्रिय करता है और चरम तर्क-गहराई पर थ्रूपुट को प्राथमिकता देता है। यह इसे समन्वय-भारी भूमिकाओं—रूटिंग, सार-संक्षेप, और मध्यवर्ती तर्क—के लिए अधिक उपयुक्त बनाता है, जहां कई एजेंट्स एक साथ काम करते हैं।
जब डिज़ाइन लक्ष्य स्पष्ट हो जाएं, तो अगला सवाल व्यावहारिक होता है: आप आज Nemotron 3 को वास्तव में कैसे चला सकते हैं, और आपकी सेटअप के अनुसार कौन से विकल्प उपयुक्त हैं? NVIDIA कई एक्सेस मार्ग प्रदान करता है, जो पूरी तरह से होस्टेड APIs से लेकर स्व-प्रबंधित परिनियोजन तक फैले हैं।
शुरू करने का सबसे तेज़ तरीका है होस्टेड इन्फेरेंस प्रदाता। Nemotron 3 Nano आज इन प्लेटफ़ॉर्म्स पर उपलब्ध है: Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter, और Together AI। ये सेवाएं मानक API इंटरफेसेज़ उपलब्ध कराती हैं, जिससे आप हार्डवेयर प्रोविज़न किए बिना मॉडल के व्यवहार, थ्रूपुट, और लंबे संदर्भ-प्रबंधन का परीक्षण कर सकते हैं।
यह विकल्प एजेंट वर्कफ़्लोज़ के प्रोटोटाइपिंग, प्रदर्शन के बेंचमार्किंग, या न्यूनतम सेटअप के साथ मौजूदा अनुप्रयोगों में Nemotron 3 के एकीकरण के लिए उपयुक्त है।
Nemotron 3 मॉडल्स, Hugging Face पर ओपन वेट्स के साथ भी जारी किए गए हैं, जिससे परिनियोजन पर पूर्ण नियंत्रण सक्षम होता है। यह मार्ग उन टीमों के लिए है जो मॉडलों को स्वयं-होस्ट करना चाहती हैं, उन्हें डोमेन-विशिष्ट डेटा पर फाइन-ट्यून करना चाहती हैं, या उन्हें कस्टम एजेंट पाइपलाइन्स में एकीकृत करना चाहती हैं।
ओपन वेट्स के साथ, आप:
यह दृष्टिकोण दीर्घकालिक, प्रोडक्शन-ग्रेड एजेंट सिस्टम्स के लिए पारदर्शिता और स्वामित्व पर NVIDIA के जोर के अनुरूप है।
जो टीमें अधिक प्रबंधित स्व-होस्टिंग अनुभव चाहती हैं, उनके लिए Nemotron 3 Nano एक NVIDIA NIM माइक्रोसर्विस के रूप में भी उपलब्ध है। NIM, मॉडल को सुरक्षित, स्केलेबल परिनियोजन के लिए पैकेज करता है—चाहे ऑन-प्रिमाइसेज़ हो या क्लाउड में—NVIDIA-त्वरित इन्फ्रास्ट्रक्चर पर।
इकोसिस्टम के परिपक्व होने के साथ, उम्मीद है कि Nemotron मॉडल्स स्थानीय और एज इन्फेरेंस के लिए उपयोग किए जाने वाले सामान्य परिनियोजन फ़्रेमवर्क्स और रनटाइम्स के साथ भी एकीकृत होंगे। ये विकल्प बिना शून्य से परिनियोजन स्टैक बनाने के, नियंत्रित वातावरणों में Nemotron 3 के साथ प्रयोग करना आसान बनाते हैं।
रिलीज़ के समय:
व्यवहार में, इसका मतलब है कि डेवलपर्स तुरंत Nano के साथ प्रयोग शुरू कर सकते हैं, जबकि बड़े मॉडल्स उन बाद के चरणों के परिनियोजनों के लिए पोजिशन किए गए हैं जिन्हें मजबूत तर्क क्षमता चाहिए।
Nemotron 3 अपने निर्धारित दायरे में मजबूत है। इसका मुख्य योगदान एकल-मॉडल तर्क की सीमाओं को आगे बढ़ाना नहीं, बल्कि एजेंट-आधारित सिस्टम्स को परिनियोजित और स्केल करना अधिक व्यावहारिक बनाना है।
आर्किटेक्चरल चुनाव वास्तविक ऑपरेशनल लाभों में बदलते हैं, खासकर उन वर्कफ़्लोज़ के लिए जो कई सहकारी एजेंट्स पर निर्भर हैं। यह कहा जाए तो, यदि आपकी प्राथमिक आवश्यकता गहन, एकल-मॉडल तर्क या जटिल टूल-चालित योजना है, तो सीमांत स्वामित्व वाले मॉडल प्रायः अधिक स्थिर रहते हैं।
सही दृष्टिकोण से देखें तो, Nemotron 3 उन मॉडलों का स्थानापन्न नहीं, बल्कि पूरक लगता है।
Nemotron 3 उन परिदृश्यों में सबसे उपयुक्त है जहां दक्षता, पारदर्शिता, और स्केलेबिलिटी मायने रखते हैं।
क्योंकि मॉडल ओपन हैं और साथ मिलकर काम करने के लिए बनाए गए हैं, टीमें एक ही, एकात्मक सिस्टम पर निर्भर होने के बजाय अलग-अलग मॉडल आकारों को अलग-अलग भूमिकाएं सौंप सकती हैं।
दक्षता, ओपननेस, और सिस्टम-स्तरीय डिज़ाइन पर NVIDIA का फोकस दर्शाता है कि आज कई वास्तविक-जीवन AI एप्लिकेशंस कैसे बनाए जा रहे हैं।
अब, Nemotron 3 जैसे मॉडलों के साथ प्रभावी ढंग से निर्माण करने के लिए, LLM के मूल सिद्धांतों और सिस्टम इंटीग्रेशन—दोनों को समझना सहायक होता है।
हमारा Large Language Models (LLMs) Concepts कोर्स वैचारिक आधार प्रदान करता है, जबकि हमारा Building APIs in Python स्किल ट्रैक, मॉडलों को एप्लिकेशंस में इंटीग्रेट करने के व्यावहारिक पक्ष को कवर करता है।
एक बड़े सिस्टम के हिस्से के रूप में देखें तो, Nemotron 3 एक मॉडल रिलीज़ कम और आज एजेंट-आधारित AI को परिनियोजित करने की नींव अधिक प्रतीत होता है।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स