Nemotron 3 is NVIDIA’s antwoord op de nieuwe beperkingen van multi-agent AI-systemen. Wat ik bedoel: naarmate AI-systemen richting multi-agent-workflows bewegen, nemen de inferentiekosten toe, wordt coördinatie lastiger en belasten langlopende taken de contextlimieten.
Met Nemotron 3 is elk model gebouwd op dezelfde architectuur, maar richt het zich op een andere balans tussen redeneerdiepte, doorvoer en efficiëntie.
In dit artikel bekijken we hoe de Nemotron 3-familie is opgebouwd, wat er onder de motorkap is veranderd en waar het past binnen gangbare agentsystemen.
Wat is Nemotron 3?
Het kernidee achter Nemotron 3 is specialisatie. Sommige agents moeten licht en snel zijn, en routinetaken afhandelen zoals routering of samenvatting. Andere agents zijn verantwoordelijk voor diepere analyses of planning op lange termijn. Door meerdere modellen binnen dezelfde generatie aan te bieden, ondersteunt Nemotron 3 die taakverdeling, terwijl het transparant en zelf te hosten blijft.
Nemotron 3 nano
Nemotron 3 Nano is het meest op efficiëntie gerichte model in de familie. Het is een model met 30B parameters dat tot 3B parameters per token activeert via een hybride mixture-of-experts-architectuur. Door selectieve activatie kan Nano een hoge doorvoer en lage inferentiekosten behalen, met behoud van concurrerende nauwkeurigheid voor zijn formaat.
Nano is bedoeld voor taken zoals samenvatten, ophalen, classificeren en algemene assistent-workflows. In multi-agent-systemen functioneert het goed als een high-volume werker die frequente of tussentijdse stappen afhandelt zonder een kostenknelpunt te worden.
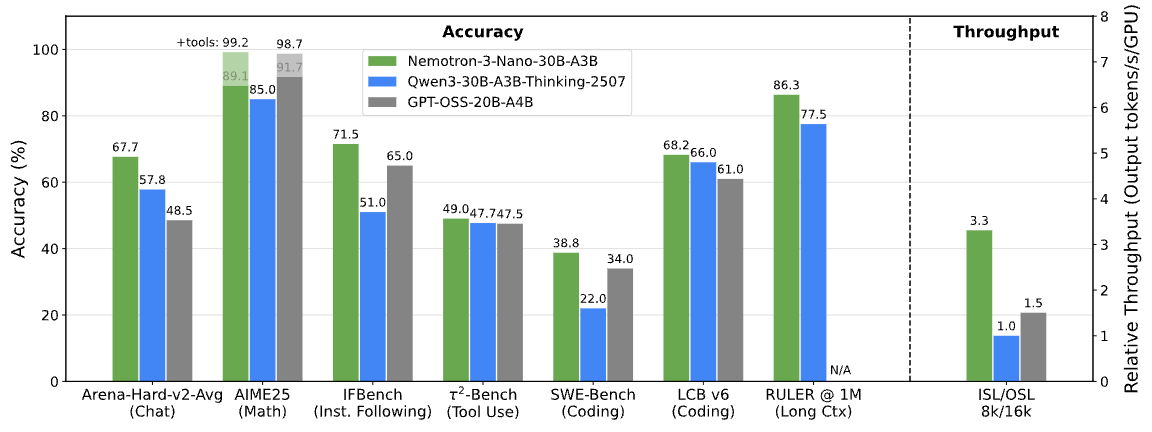
Nemotron 3-benchmarks. Afbeelding door NVIDIA Research
Nemotron 3 super
Nemotron 3 Super richt zich op scenario’s die sterker redeneren vereisen, maar toch binnen latentiegrenzen moeten blijven. Het heeft ongeveer 100B parameters, met tot 10B actief per token, en is geoptimaliseerd voor gecoördineerde multi-agent-workloads.
Super zit tussen Nano en Ultra in. Het biedt meer redeneercapaciteit dan Nano, zonder de volledige rekenvereisten van het grootste model, en is daardoor geschikt voor agents die meerdere inputbronnen moeten combineren of over stappen heen moeten redeneren.
Nemotron 3 ultra
Nemotron 3 Ultra is het meest capabele model in de reeks. Met ongeveer 500B parameters en tot 50B actief per token fungeert het als een high-end redeneermotor voor complexe agentische workflows.
Ultra is ontworpen voor taken die diepe analyse, planning op lange termijn of strategische besluitvorming vereisen. Hoewel het hogere rekenvereisten heeft, is het bedoeld om naast kleinere Nemotron-modellen te draaien, waarbij alleen de meest veeleisende taken ernaartoe worden gerouteerd.
Wat is er nieuw in de architectuur van Nemotron 3
Nu de modellijn duidelijk is, is de volgende vraag hoe NVIDIA schaal en efficiëntie in balans brengt over zulke verschillende niveaus.
In plaats van te leunen op één architecturale doorbraak, combineert Nemotron 3 meerdere complementaire ontwerpkeuzes om grote, multi-agent-systemen praktisch uitvoerbaar te maken.
Hybride latente mixture-of-experts-ontwerp
De kern van Nemotron 3 is een hybride latente mixture-of-experts- (MoE) architectuur. In plaats van alle parameters voor elke token te activeren, leidt het model elke token door een kleine subset van gespecialiseerde expertnetwerken.
Dit verlaagt de inferentiekosten terwijl de capaciteit van een veel groter model behouden blijft. In agentgebaseerde systemen, waar veel agents gelijktijdig tussentijdse output kunnen genereren, helpt selectieve activatie de rekeneisen beheersbaar te houden naarmate de schaal toeneemt.
Gebruik van 4-bit-precisie bij training
Nemotron 3 Super en Ultra zijn getraind met NVIDIA’s 4-bit NVFP4-precisieformaat op de Blackwell-architectuur. Training met lagere precisie vermindert het geheugengebruik en versnelt de training, waardoor met grotere MoE-modellen kan worden gewerkt op bestaande infrastructuur.
Belangrijk is dat dit gebeurt zonder een noemenswaardige daling in nauwkeurigheid ten opzichte van formaten met hogere precisie, wat helpt verklaren hoe Nemotron 3 kan opschalen en toch praktisch inzetbaar blijft.
Uitgebreide contextwindow voor lange sequenties
Nemotron 3 Nano ondersteunt contextwindows tot één miljoen tokens. Hierdoor kan het model informatie vasthouden over lange documenten, uitgebreide logs of meerstapstaakgeschiedenissen.
Voor agent-workflows zoals het routeren van taken tussen plannings-, retrieval- en uitvoeringsagents vermindert een langer contextwindow de noodzaak voor agressieve chunking of externe geheugensystemen.
Belangrijkste features van Nemotron 3
Deze architecturale keuzes zijn niet abstract. Ze komen direct terug in hoe Nemotron 3 zich gedraagt in echte systemen.
Minder generatie van redeneertokens
NVIDIA meldt dat Nemotron 3 Nano tot 60% minder redeneertokens genereert dan Nemotron 2 Nano. In multi-agent-systemen, waar tussentijdse redeneerstappen het totale tokenverbruik kunnen domineren, heeft deze reductie direct invloed op kosten en schaalbaarheid.
Kortere redeneertraces helpen de inferentie efficiënt te houden zonder in te leveren op taaknauwkeurigheid.
Hogere doorvoer voor meerstaps-workflows
De combinatie van MoE-routering en selectieve parameteractivatie stelt Nemotron 3 in staat een hoge doorvoer te behouden naarmate workflows complexer worden. Dit maakt het makkelijker om langere taakketens of meer gelijktijdige agents te ondersteunen zonder evenredige toename in latentie.
Contextwindow van 1M voor redeneren op lange termijn
Met ondersteuning voor tot één miljoen tokens in Nano maakt Nemotron 3 redeneren op lange termijn over uitgebreide input mogelijk. Agents kunnen eerdere stappen of grote documenten refereren zonder telkens samen te vatten of de status opnieuw te laden, wat de consistentie in de tijd verbetert.
Gezamenlijk verklaren deze features waarom Nemotron 3 efficiëntie en coördinatie benadrukt boven ruwe single-model-prestaties.
Nemotron 3 vs. Nemotron 2: wat is verbeterd
Op dit punt zouden de ontwerpdoelen van Nemotron 3 duidelijk moeten zijn. Vergelijking met Nemotron 2 helpt te valideren of deze doelen zich vertalen in meetbare verbeteringen.
Nemotron 3 verfijnt mixture-of-experts-routering, verhoogt de doorvoer, vermindert de generatie van redeneertokens en breidt de contextlengte aanzienlijk uit. NVIDIA rapporteert tot 4× hogere tokendoorvoer voor Nemotron 3 Nano vergeleken met Nemotron 2 Nano, samen met een grote afname in redeneertokens.
Een ander verschil is de scope. Nemotron 3 gaat verder dan alleen modellen en wordt geleverd met reinforcement learning-datasets, agentveiligheidsdata en open tooling zoals NeMo Gym en NeMo RL. Nemotron 2 richtte zich primair op modelreleases, terwijl Nemotron 3 is gepositioneerd als een meer complete stack voor agentontwikkeling.
Nemotron 3 vs. concurrenten
Met de architectuur en benchmarks in context wordt duidelijker waar Nemotron 3 past in het huidige modellandschap. NVIDIA positioneert Nemotron 3 niet als een drop-invervanging voor frontier-propriëtaire modellen. In plaats daarvan richt het zich op een andere uitdaging: agentgebaseerde AI-systemen efficiënt, voorspelbaar en schaalbaar maken in echte implementaties.
Vergeleken met andere grote open modellen legt Nemotron 3 minder nadruk op het maximaliseren van single-model-benchmarkscores en meer op systeemniveau-aspecten zoals doorvoer, efficiëntie van redeneertokens, omgang met lange context en coördinatie tussen agents. Deze insteek lijkt op hoe Mistral zijn eigen reeks positioneert, maar met een sterkere focus op multi-agent-workloads.
Waar Nemotron 3 in uitblinkt (vergeleken met andere modellen)
De tabel hieronder vat de belangrijkste dimensies samen waarop Nemotron 3 opvalt ten opzichte van andere populaire open en propriëtaire modellen.
|
Dimensie
|
Nemotron 3
|
Mistral Large 3
|
DeepSeek-klasse modellen
|
Frontier-propriëtaire modellen
|
|
Primair ontwerpdoel
|
Multi-agent-efficiëntie op schaal
|
Single-model-capaciteit
|
Redeneerdiepte per prompt
|
Frontier-redeneren & agents
|
|
Architectuurfocus
|
Hybride latente MoE
|
Sparse MoE
|
Dense / MoE
|
Dense, propriëtair
|
|
Doorvoer (tokens/sec)
|
Zeer hoog (Nano loopt voor op peers)
|
Hoog maar rekenintensief
|
Gemiddeld
|
Gemiddeld tot hoog
|
|
Gebruik van redeneertokens
|
Verminderd (tot ~60% minder in Nano)
|
Gemiddeld
|
Hoger
|
Hoger
|
|
Contextwindow
|
Tot 1M tokens (Nano)
|
Tot ~256K
|
Lang, maar kleiner
|
Lang (verschilt per model)
|
|
Geschikt voor multi-agent
|
Uitstekend
|
Gemiddeld
|
Gemiddeld
|
Sterk maar kostbaar
|
|
Zelf-hosting & controle
|
Volledig (open gewichten)
|
Volledig (open gewichten)
|
Volledig (open gewichten)
|
Beperkt / geen
|
|
Beste usecase
|
Agentcoördinatie, routering, samenvatten
|
Diep redeneren, coderen
|
Wiskunde & redeneertaken
|
Complexe planning, SWE
|
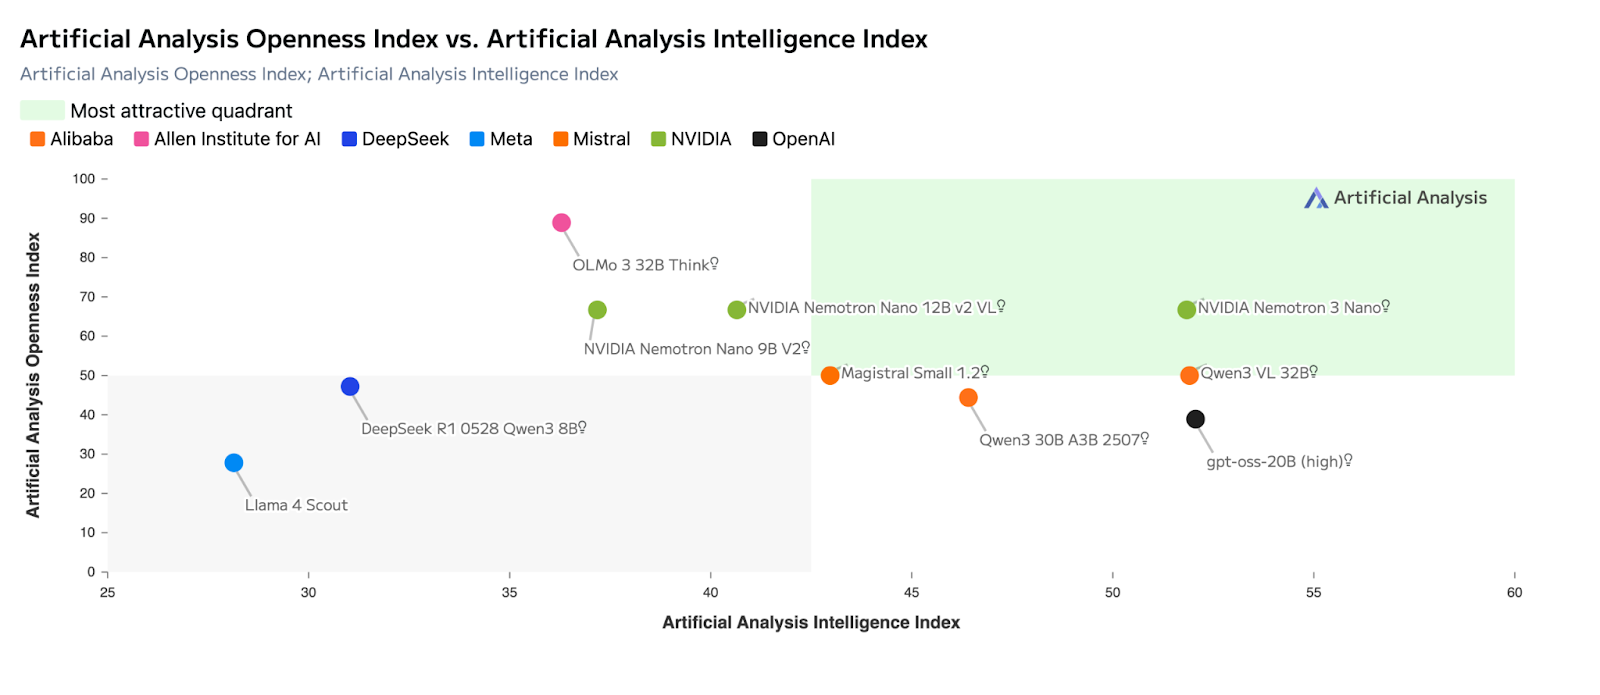
Nemotron 3 vs. Mistral Large 3
Mistral Large 3 en Nemotron 3 vertrouwen allebei op mixture-of-experts-architecturen, maar optimaliseren voor verschillende uitkomsten.
Mistral Large 3 is ontworpen om de single-model-capaciteit te maximaliseren en presteert sterk op redeneren, coderen en algemene benchmarks zoals LMArena en SWE-achtige evaluaties. Het is vaak de betere keuze wanneer één model een volledige taak end-to-end moet afhandelen.
Nemotron 3 daarentegen is geoptimaliseerd voor systeemefficiëntie. Het hybride latente MoE-ontwerp activeert minder parameters per token en geeft prioriteit aan doorvoer boven piekredeneerdiepte. Dit maakt het beter geschikt voor rollen met veel coördinatie—routering, samenvatten en tussentijds redeneren, waar veel agents gelijktijdig actief zijn.
Hoe krijg ik toegang tot Nemotron 3?
Als de ontwerpdoelen duidelijk zijn, is de volgende vraag praktisch: hoe kun je Nemotron 3 vandaag draaien, en welke opties passen bij jouw setup? NVIDIA biedt verschillende toegangspaden, variërend van volledig gehoste API’s tot zelf beheerde implementaties.
API-toegang via gehoste inferenceproviders
De snelste manier om te starten is via gehoste inferenceproviders. Nemotron 3 Nano is vandaag beschikbaar op platforms zoals Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter en Together AI. Deze services bieden standaard API-interfaces, zodat je het gedrag, de doorvoer en de omgang met lange context van het model kunt testen zonder hardware te hoeven inrichten.
Deze optie is geschikt voor het prototypen van agent-workflows, het benchmarken van prestaties of het integreren van Nemotron 3 in bestaande applicaties met minimale setup.
Open gewichten en zelf-hosting
De Nemotron 3-modellen worden ook uitgebracht met open gewichten op Hugging Face, waardoor je volledige controle over de implementatie krijgt. Deze route is bedoeld voor teams die de modellen zelf willen hosten, ze willen fine-tunen op domeinspecifieke data of ze willen integreren in maatwerk agent-pijplijnen.
Met open gewichten kun je:
- de modellen op je eigen infrastructuur draaien,
- ze naar behoefte aanpassen of fine-tunen,
- en latentie, privacy en kosten end-to-end beheren.
Deze aanpak sluit aan bij NVIDIA’s nadruk op transparantie en eigenaarschap voor langlevende, productierijpe agentsystemen.
NVIDIA NIM en implementatiekaders
Voor teams die een meer beheerde zelf-hostingervaring willen, is Nemotron 3 Nano ook beschikbaar als een NVIDIA NIM-microservice. NIM verpakt het model voor veilige, schaalbare implementatie op door NVIDIA versneld infrastructuur, zowel on-premises als in de cloud.
Naarmate het ecosysteem volwassener wordt, zullen Nemotron-modellen naar verwachting ook integreren met gangbare implementatiekaders en runtimes voor lokale en edge-inferentie. Deze opties maken het eenvoudiger om met Nemotron 3 te experimenteren in gecontroleerde omgevingen zonder een implementatiestack vanaf nul op te bouwen.
Tijdlijn modelbeschikbaarheid
Op het moment van release:
- Nemotron 3 Nano is nu beschikbaar via gehoste API’s, open gewichten en NVIDIA NIM.
- Nemotron 3 Super en Ultra worden verwacht in de eerste helft van 2026 beschikbaar te komen.
In de praktijk betekent dit dat ontwikkelaars direct met Nano kunnen experimenteren, terwijl de grotere modellen zijn gepositioneerd voor latere implementaties die sterkere redeneercapaciteit vereisen.
Hoe goed is Nemotron 3?
Nemotron 3 is sterk binnen de beoogde scope. De belangrijkste bijdrage is niet het oprekken van de grenzen van single-model-redeneren, maar het praktischer maken van agentgebaseerde systemen voor implementatie en opschaling.
De architecturale keuzes vertalen zich in echte operationele voordelen, vooral voor workflows die steunen op veel samenwerkende agents. Dat gezegd hebbende: als je primaire eis diep single-model-redeneren of complexe, toolgestuurde planning is, blijven frontier-propriëtaire modellen doorgaans consistenter.
Gezien door de juiste lens vult Nemotron 3 die modellen aan in plaats van ze te vervangen.
Usecases voor Nemotron 3
Nemotron 3 komt het best tot zijn recht in scenario’s waar efficiëntie, transparantie en schaalbaarheid ertoe doen.
- Multi-agent-systemen: routering, coördinatie en tussentijds redeneren
- Langdocumentverwerking: samenvatten, extraheren en analyseren van grote input
- Enterprise-assistenten: interne tools met voorspelbare prestaties en zelf-hosting
- Workflow-automatisering: classificatie, retrieval en besluitvorming op schaal
- Privacygevoelige implementaties: on-premises of soevereine AI-omgevingen
Omdat de modellen open zijn en ontworpen om samen te werken, kunnen teams verschillende rollen toewijzen aan verschillende modelgroottes in plaats van te vertrouwen op één monolithisch systeem.
Tot slot
NVIDIA’s focus op efficiëntie, openheid en systeemontwerp weerspiegelt hoe veel AI-toepassingen in de echte wereld tegenwoordig worden gebouwd.
Om effectief te bouwen met modellen zoals Nemotron 3 helpt het om zowel LLM-basics als systeemintegratie te begrijpen.
Onze cursus Large Language Models (LLMs) Concepts biedt conceptuele basis, terwijl onze skill track Building APIs in Python de praktische kant van het integreren van modellen in applicaties behandelt.
Gezien als onderdeel van een groter systeem voelt Nemotron 3 minder als een modelrelease en meer als een fundament voor hoe agentgebaseerde AI vandaag wordt ingezet.



 Adel Nehme · 15 min
Nemotron 3 is NVIDIA’s antwoord op de nieuwe beperkingen van multi-agent AI-systemen. Wat ik bedoel: naarmate AI-systemen richting multi-agent-workflows bewegen, nemen de inferentiekosten toe, wordt coördinatie lastiger en belasten langlopende taken de contextlimieten.
Met Nemotron 3 is elk model gebouwd op dezelfde architectuur, maar richt het zich op een andere balans tussen redeneerdiepte, doorvoer en efficiëntie.
In dit artikel bekijken we hoe de Nemotron 3-familie is opgebouwd, wat er onder de motorkap is veranderd en waar het past binnen gangbare agentsystemen.
Wat is Nemotron 3?
Het kernidee achter Nemotron 3 is specialisatie. Sommige agents moeten licht en snel zijn, en routinetaken afhandelen zoals routering of samenvatting. Andere agents zijn verantwoordelijk voor diepere analyses of planning op lange termijn. Door meerdere modellen binnen dezelfde generatie aan te bieden, ondersteunt Nemotron 3 die taakverdeling, terwijl het transparant en zelf te hosten blijft.
Nemotron 3 nano
Nemotron 3 Nano is het meest op efficiëntie gerichte model in de familie. Het is een model met 30B parameters dat tot 3B parameters per token activeert via een hybride mixture-of-experts-architectuur. Door selectieve activatie kan Nano een hoge doorvoer en lage inferentiekosten behalen, met behoud van concurrerende nauwkeurigheid voor zijn formaat.
Nano is bedoeld voor taken zoals samenvatten, ophalen, classificeren en algemene assistent-workflows. In multi-agent-systemen functioneert het goed als een high-volume werker die frequente of tussentijdse stappen afhandelt zonder een kostenknelpunt te worden.
Nemotron 3-benchmarks. Afbeelding door NVIDIA Research
Nemotron 3 super
Nemotron 3 Super richt zich op scenario’s die sterker redeneren vereisen, maar toch binnen latentiegrenzen moeten blijven. Het heeft ongeveer 100B parameters, met tot 10B actief per token, en is geoptimaliseerd voor gecoördineerde multi-agent-workloads.
Super zit tussen Nano en Ultra in. Het biedt meer redeneercapaciteit dan Nano, zonder de volledige rekenvereisten van het grootste model, en is daardoor geschikt voor agents die meerdere inputbronnen moeten combineren of over stappen heen moeten redeneren.
Nemotron 3 ultra
Nemotron 3 Ultra is het meest capabele model in de reeks. Met ongeveer 500B parameters en tot 50B actief per token fungeert het als een high-end redeneermotor voor complexe agentische workflows.
Ultra is ontworpen voor taken die diepe analyse, planning op lange termijn of strategische besluitvorming vereisen. Hoewel het hogere rekenvereisten heeft, is het bedoeld om naast kleinere Nemotron-modellen te draaien, waarbij alleen de meest veeleisende taken ernaartoe worden gerouteerd.
Wat is er nieuw in de architectuur van Nemotron 3
Nu de modellijn duidelijk is, is de volgende vraag hoe NVIDIA schaal en efficiëntie in balans brengt over zulke verschillende niveaus.
In plaats van te leunen op één architecturale doorbraak, combineert Nemotron 3 meerdere complementaire ontwerpkeuzes om grote, multi-agent-systemen praktisch uitvoerbaar te maken.
Hybride latente mixture-of-experts-ontwerp
De kern van Nemotron 3 is een hybride latente mixture-of-experts- (MoE) architectuur. In plaats van alle parameters voor elke token te activeren, leidt het model elke token door een kleine subset van gespecialiseerde expertnetwerken.
Dit verlaagt de inferentiekosten terwijl de capaciteit van een veel groter model behouden blijft. In agentgebaseerde systemen, waar veel agents gelijktijdig tussentijdse output kunnen genereren, helpt selectieve activatie de rekeneisen beheersbaar te houden naarmate de schaal toeneemt.
Gebruik van 4-bit-precisie bij training
Nemotron 3 Super en Ultra zijn getraind met NVIDIA’s 4-bit NVFP4-precisieformaat op de Blackwell-architectuur. Training met lagere precisie vermindert het geheugengebruik en versnelt de training, waardoor met grotere MoE-modellen kan worden gewerkt op bestaande infrastructuur.
Belangrijk is dat dit gebeurt zonder een noemenswaardige daling in nauwkeurigheid ten opzichte van formaten met hogere precisie, wat helpt verklaren hoe Nemotron 3 kan opschalen en toch praktisch inzetbaar blijft.
Uitgebreide contextwindow voor lange sequenties
Nemotron 3 Nano ondersteunt contextwindows tot één miljoen tokens. Hierdoor kan het model informatie vasthouden over lange documenten, uitgebreide logs of meerstapstaakgeschiedenissen.
Voor agent-workflows zoals het routeren van taken tussen plannings-, retrieval- en uitvoeringsagents vermindert een langer contextwindow de noodzaak voor agressieve chunking of externe geheugensystemen.
Belangrijkste features van Nemotron 3
Deze architecturale keuzes zijn niet abstract. Ze komen direct terug in hoe Nemotron 3 zich gedraagt in echte systemen.
Minder generatie van redeneertokens
NVIDIA meldt dat Nemotron 3 Nano tot 60% minder redeneertokens genereert dan Nemotron 2 Nano. In multi-agent-systemen, waar tussentijdse redeneerstappen het totale tokenverbruik kunnen domineren, heeft deze reductie direct invloed op kosten en schaalbaarheid.
Kortere redeneertraces helpen de inferentie efficiënt te houden zonder in te leveren op taaknauwkeurigheid.
Hogere doorvoer voor meerstaps-workflows
De combinatie van MoE-routering en selectieve parameteractivatie stelt Nemotron 3 in staat een hoge doorvoer te behouden naarmate workflows complexer worden. Dit maakt het makkelijker om langere taakketens of meer gelijktijdige agents te ondersteunen zonder evenredige toename in latentie.
Contextwindow van 1M voor redeneren op lange termijn
Met ondersteuning voor tot één miljoen tokens in Nano maakt Nemotron 3 redeneren op lange termijn over uitgebreide input mogelijk. Agents kunnen eerdere stappen of grote documenten refereren zonder telkens samen te vatten of de status opnieuw te laden, wat de consistentie in de tijd verbetert.
Gezamenlijk verklaren deze features waarom Nemotron 3 efficiëntie en coördinatie benadrukt boven ruwe single-model-prestaties.
Nemotron 3 vs. Nemotron 2: wat is verbeterd
Op dit punt zouden de ontwerpdoelen van Nemotron 3 duidelijk moeten zijn. Vergelijking met Nemotron 2 helpt te valideren of deze doelen zich vertalen in meetbare verbeteringen.
Nemotron 3 verfijnt mixture-of-experts-routering, verhoogt de doorvoer, vermindert de generatie van redeneertokens en breidt de contextlengte aanzienlijk uit. NVIDIA rapporteert tot 4× hogere tokendoorvoer voor Nemotron 3 Nano vergeleken met Nemotron 2 Nano, samen met een grote afname in redeneertokens.
Een ander verschil is de scope. Nemotron 3 gaat verder dan alleen modellen en wordt geleverd met reinforcement learning-datasets, agentveiligheidsdata en open tooling zoals NeMo Gym en NeMo RL. Nemotron 2 richtte zich primair op modelreleases, terwijl Nemotron 3 is gepositioneerd als een meer complete stack voor agentontwikkeling.
Nemotron 3 vs. concurrenten
Met de architectuur en benchmarks in context wordt duidelijker waar Nemotron 3 past in het huidige modellandschap. NVIDIA positioneert Nemotron 3 niet als een drop-invervanging voor frontier-propriëtaire modellen. In plaats daarvan richt het zich op een andere uitdaging: agentgebaseerde AI-systemen efficiënt, voorspelbaar en schaalbaar maken in echte implementaties.
Vergeleken met andere grote open modellen legt Nemotron 3 minder nadruk op het maximaliseren van single-model-benchmarkscores en meer op systeemniveau-aspecten zoals doorvoer, efficiëntie van redeneertokens, omgang met lange context en coördinatie tussen agents. Deze insteek lijkt op hoe Mistral zijn eigen reeks positioneert, maar met een sterkere focus op multi-agent-workloads.
Waar Nemotron 3 in uitblinkt (vergeleken met andere modellen)
De tabel hieronder vat de belangrijkste dimensies samen waarop Nemotron 3 opvalt ten opzichte van andere populaire open en propriëtaire modellen.
Dimensie
Nemotron 3
Mistral Large 3
DeepSeek-klasse modellen
Frontier-propriëtaire modellen
Primair ontwerpdoel
Multi-agent-efficiëntie op schaal
Single-model-capaciteit
Redeneerdiepte per prompt
Frontier-redeneren & agents
Architectuurfocus
Hybride latente MoE
Sparse MoE
Dense / MoE
Dense, propriëtair
Doorvoer (tokens/sec)
Zeer hoog (Nano loopt voor op peers)
Hoog maar rekenintensief
Gemiddeld
Gemiddeld tot hoog
Gebruik van redeneertokens
Verminderd (tot ~60% minder in Nano)
Gemiddeld
Hoger
Hoger
Contextwindow
Tot 1M tokens (Nano)
Tot ~256K
Lang, maar kleiner
Lang (verschilt per model)
Geschikt voor multi-agent
Uitstekend
Gemiddeld
Gemiddeld
Sterk maar kostbaar
Zelf-hosting & controle
Volledig (open gewichten)
Volledig (open gewichten)
Volledig (open gewichten)
Beperkt / geen
Beste usecase
Agentcoördinatie, routering, samenvatten
Diep redeneren, coderen
Wiskunde & redeneertaken
Complexe planning, SWE
Nemotron 3 vs. Mistral Large 3
Mistral Large 3 en Nemotron 3 vertrouwen allebei op mixture-of-experts-architecturen, maar optimaliseren voor verschillende uitkomsten.
Mistral Large 3 is ontworpen om de single-model-capaciteit te maximaliseren en presteert sterk op redeneren, coderen en algemene benchmarks zoals LMArena en SWE-achtige evaluaties. Het is vaak de betere keuze wanneer één model een volledige taak end-to-end moet afhandelen.
Nemotron 3 daarentegen is geoptimaliseerd voor systeemefficiëntie. Het hybride latente MoE-ontwerp activeert minder parameters per token en geeft prioriteit aan doorvoer boven piekredeneerdiepte. Dit maakt het beter geschikt voor rollen met veel coördinatie—routering, samenvatten en tussentijds redeneren, waar veel agents gelijktijdig actief zijn.
Hoe krijg ik toegang tot Nemotron 3?
Als de ontwerpdoelen duidelijk zijn, is de volgende vraag praktisch: hoe kun je Nemotron 3 vandaag draaien, en welke opties passen bij jouw setup? NVIDIA biedt verschillende toegangspaden, variërend van volledig gehoste API’s tot zelf beheerde implementaties.
API-toegang via gehoste inferenceproviders
De snelste manier om te starten is via gehoste inferenceproviders. Nemotron 3 Nano is vandaag beschikbaar op platforms zoals Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter en Together AI. Deze services bieden standaard API-interfaces, zodat je het gedrag, de doorvoer en de omgang met lange context van het model kunt testen zonder hardware te hoeven inrichten.
Deze optie is geschikt voor het prototypen van agent-workflows, het benchmarken van prestaties of het integreren van Nemotron 3 in bestaande applicaties met minimale setup.
Open gewichten en zelf-hosting
De Nemotron 3-modellen worden ook uitgebracht met open gewichten op Hugging Face, waardoor je volledige controle over de implementatie krijgt. Deze route is bedoeld voor teams die de modellen zelf willen hosten, ze willen fine-tunen op domeinspecifieke data of ze willen integreren in maatwerk agent-pijplijnen.
Met open gewichten kun je:
Deze aanpak sluit aan bij NVIDIA’s nadruk op transparantie en eigenaarschap voor langlevende, productierijpe agentsystemen.
NVIDIA NIM en implementatiekaders
Voor teams die een meer beheerde zelf-hostingervaring willen, is Nemotron 3 Nano ook beschikbaar als een NVIDIA NIM-microservice. NIM verpakt het model voor veilige, schaalbare implementatie op door NVIDIA versneld infrastructuur, zowel on-premises als in de cloud.
Naarmate het ecosysteem volwassener wordt, zullen Nemotron-modellen naar verwachting ook integreren met gangbare implementatiekaders en runtimes voor lokale en edge-inferentie. Deze opties maken het eenvoudiger om met Nemotron 3 te experimenteren in gecontroleerde omgevingen zonder een implementatiestack vanaf nul op te bouwen.
Tijdlijn modelbeschikbaarheid
Op het moment van release:
In de praktijk betekent dit dat ontwikkelaars direct met Nano kunnen experimenteren, terwijl de grotere modellen zijn gepositioneerd voor latere implementaties die sterkere redeneercapaciteit vereisen.
Hoe goed is Nemotron 3?
Nemotron 3 is sterk binnen de beoogde scope. De belangrijkste bijdrage is niet het oprekken van de grenzen van single-model-redeneren, maar het praktischer maken van agentgebaseerde systemen voor implementatie en opschaling.
De architecturale keuzes vertalen zich in echte operationele voordelen, vooral voor workflows die steunen op veel samenwerkende agents. Dat gezegd hebbende: als je primaire eis diep single-model-redeneren of complexe, toolgestuurde planning is, blijven frontier-propriëtaire modellen doorgaans consistenter.
Gezien door de juiste lens vult Nemotron 3 die modellen aan in plaats van ze te vervangen.
Usecases voor Nemotron 3
Nemotron 3 komt het best tot zijn recht in scenario’s waar efficiëntie, transparantie en schaalbaarheid ertoe doen.
Omdat de modellen open zijn en ontworpen om samen te werken, kunnen teams verschillende rollen toewijzen aan verschillende modelgroottes in plaats van te vertrouwen op één monolithisch systeem.
Tot slot
NVIDIA’s focus op efficiëntie, openheid en systeemontwerp weerspiegelt hoe veel AI-toepassingen in de echte wereld tegenwoordig worden gebouwd.
Om effectief te bouwen met modellen zoals Nemotron 3 helpt het om zowel LLM-basics als systeemintegratie te begrijpen.
Onze cursus Large Language Models (LLMs) Concepts biedt conceptuele basis, terwijl onze skill track Building APIs in Python de praktische kant van het integreren van modellen in applicaties behandelt.
Gezien als onderdeel van een groter systeem voelt Nemotron 3 minder als een modelrelease en meer als een fundament voor hoe agentgebaseerde AI vandaag wordt ingezet.