Anthropic hat soeben Claude Opus 5.5 veröffentlicht – und das Thema sind ganz klar Wirtschaftlichkeit und Sicherheit. Das Modell ist in der Ausführung 40% günstiger als Opus 5 (das selbst zum gleichen Preis wie seine Vorgänger Opus 4.6, 4.7 und 4.8 gestartet ist), generiert Ausgaben über 30% schneller und erzielt die besten Werte, die Anthropic je in seiner internen Alignment-Suite gemessen hat. In Sachen Leistung liegt es bei den meisten Aufgaben nahe an Claude Fable 5.1 – allerdings zu einem Bruchteil der Kosten.
Wir hatten mit einer Veröffentlichung in dieser Woche gerechnet und die Nachrichtenlage genau verfolgt. Es ist das erste Release, seit Anthropic-CEO Dario Amodei öffentlich dazu aufgerufen hat, die „Frontier zu takten“ – also Sicherheitsarbeit vor Fähigkeitsgewinne zu stellen, statt um das leistungsstärkste Modell zu konkurrieren. Auf den ersten Blick mag es widersprüchlich wirken, eine Woche nach einem Plädoyer für ein KI-Tempo-Limit ein neues Modell herauszubringen. So inkonsequent ist es aber vielleicht gar nicht. Opus 5.5 dreht sich nicht um rohe Intelligenz. Es liefert vergleichbare Leistung – nur günstiger und mit strengerem Alignment.
Wenige Stunden später reagierte OpenAI mit den neuen Sol- und Luna-Modellen. Lies mehr dazu in unserem GPT-6 Sol und Luna Guide und unserem Hands-on-Vergleich GPT-6 Sol vs. Claude Opus 5.5.
Was ist Claude Opus 5.5?
Claude Opus 5.5 ist das erste Release in Anthropics neuer „5.5“-Generation. Es steht jetzt an der Spitze der Modellreihe von Anthropic. Sonnet- und Haiku-Versionen sollen in den nächsten Tagen oder Wochen folgen.
Opus 5.5 ist für dieselben anspruchsvollen Jobs gebaut, auf die Opus-Modelle schon immer abgezielt haben: lange, agentische Coding-Runs, komplexe Recherche und Analyse sowie mehrstufige Workflows, die über viele Stunden stabil bleiben müssen, ohne zu driften.
Der Unterschied diesmal: Opus 5.5 ist eine schlankere, effizientere Version dessen, was Opus 5 bereits konnte – vergleichbare Arbeit mit weniger Tokens pro Aufgabe. Genau daraus resultieren die meisten Kosten- und Geschwindigkeitsvorteile.
Was ist neu in Claude Opus 5.5?
Starten wir mit den Kosten, denn das ist die eigentliche Headline.
Spürbar günstiger und schneller
Cache-Reads, die laut Anthropic den Großteil der agentischen Coding-Kosten ausmachen, sinken um 60% von 0,50 $ auf 0,20 $ pro Million Tokens. Input- und Output-Tokens sind ebenfalls um 20% günstiger, und das Modell generiert Ausgaben über 30% schneller als Opus 5. Ebenfalls im Release, wenn auch weniger prominent: Anthropic lockert die Fünf-Stunden-Nutzungslimits für Pro-, Max- und Team-Pläne und führt einen anrechenbaren Rate-Limit-Reset ein, den Abonnierende speichern und wiederverwenden können.
Leistung, die vor allem bei langen, unübersichtlichen Jobs auffällt
Anthropic sagt, die größten Zugewinne zeigen sich bei weit verzweigten, realen Aufgaben – weniger bei kurzen Benchmark-Problemen. Ein Early Tester soll eine Code-Migration mit 680.000 Zeilen in unter einem Tag abgeschlossen haben – Arbeit, für die ein Engineering-Team sonst Wochen gebraucht hätte.
In einem internen Test, in dem Opus 5.5 die Ladezeiten jeder Seite einer Web-App reduzieren sollte, gelang das 39 von 40 Mal – ein Hinweis auf bemerkenswerte Konstanz.
Bessere Kommunikation
Anthropic hebt den Schreibstil als Fix für eine der häufigsten Beschwerden über Opus 5 hervor: Weitschweifigkeit und Jargon. Opus 5.5 soll mit den wichtigsten Informationen einsteigen, weniger idiosynkratische Formulierungen verwenden und näher an der vorgegebenen Hausstilistik bleiben. Im Release gibt es ein Beispiel zur Bug-Erklärung im Side-by-Side-Vergleich – die Opus-5.5-Version ist merklich kürzer und nennt die eigentliche Ursache direkt zu Beginn, statt darauf hinzuarbeiten.
Claude Opus 5.5: Benchmark-Ergebnisse
So schneidet Opus 5.5 laut Anthropics eigener Veröffentlichung im Vergleich zu Fable 5.1, Opus 5 und der Konkurrenz ab.
| | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|
| Agentisches Coding — Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| Agentisches Coding — FrontierCode v1.1 (Main) | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| Agentisches Coding — CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| Wissensarbeit — GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| Geschäfts-Workflows — AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Multidisziplinäres Reasoning — Humanity's Last Exam (mit Tools) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Agentische wissenschaftliche Recherche — Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| Computerbedienung — OSWorld 2.0 (teilweise) | 81,8% | 80,7% | 74,0% | — | — |
| Visuelle Diagrammerkennung — Chartography (mit Tools) | 89,0% | 88,4% | 83,4% | — | — |
Ein paar Dinge stechen hervor. Opus 5.5 schlägt Fable 5.1 in jedem hier gezeigten Benchmark – bemerkenswert, da Anthropic 5.5 eher als „Fable-Leistung zum günstigeren Preis“ denn als direktes Upgrade positioniert. Ich vermute, Anthropic betont das nicht, weil sie ihre Tier-Struktur schützen wollen. Heißt: Fable wird als Premium an der Spitze verkauft. Wenn Opus 5.5 weithin als besser als Fable gilt – dann ist das eine unangenehme Frage für alle, die Fable-Preise zahlen.
Gerade beim agentischen Coding ist der Abstand zu Opus 5 über alle drei Benchmarks groß. Der Sprung bei CursorBench ist die größte Einzel-Verbesserung in der Tabelle.
Auch die Ausnahmen sollte man benennen. GPT-6 Astra liegt sowohl bei AutomationBench (Geschäfts-Workflows) als auch bei Terminal-Bench-Science (agentische wissenschaftliche Recherche) knapp vor Opus 5.5 – beim zweiten mit deutlicherem Vorsprung. Man kann also sagen: Bei einigen realen Workflow- und Science-Aufgaben liegt Opus 5.5 noch hinten.
Moment, was ist mit „Pacing the Frontier“?
Optisch wirkte es zunächst seltsam. Wenige Tage nach Amodeis Appell, die KI-Entwicklung zu bremsen, bringt Anthropic ein neues Flaggschiff.
Eine zynische Lesart wäre: „Pacing the frontier“ drehte sich nie wirklich um Sicherheit. Es ist leichter, zur Verlangsamung aufzurufen, wenn man vorne liegt – und gemessen am Umsatz liegt Anthropic vorne.
Eine andere Interpretation: „Pacing the frontier“ war nie ein Argument gegen Releases an sich, sondern dafür, welche Art von Modellen man veröffentlicht. Unter dieser Lesart passt Opus 5.5 zur Botschaft.
Anthropic sagt, Opus 5.5 performt in etwa auf dem Niveau von Fable 5.1 – ein Modell, das es bereits gab. Die Fähigkeitsdecke hat sich nicht verschoben. Geändert hat sich, dass die gleiche Arbeitsebene jetzt 40% weniger kostet und über 30% schneller läuft. Außerdem erzielt es bessere interne Alignment-Scores.
Claude Opus 5.5: Preise
| Pro 1 Mio. Tokens | Opus 5.5 | Opus 5 |
|---|
| Input | $4 | $5 |
| Output | $20 | $25 |
| Cache-Reads | $0,20 | $0,50 |
| Cache-Writes | $5 | $6,25 |
Der Fast Mode – mit bis zu 2,5-facher Geschwindigkeit – ist in Claude Code und auf der Claude Platform für $8 pro Million Input-Tokens und $40 pro Million Output-Tokens verfügbar.
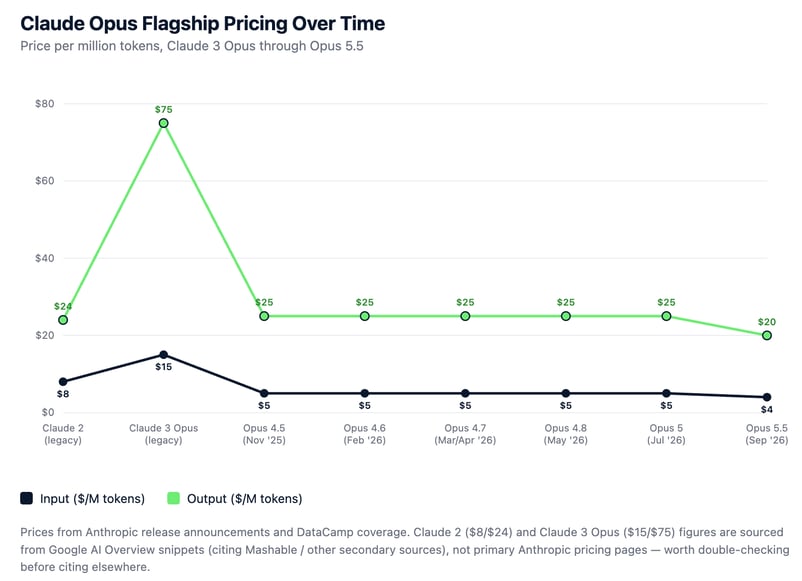
Ich habe ein Diagramm erstellt, um die Entwicklung der Claude-Opus-Preise über die Zeit zu zeigen. Sie sind im Laufe der Zeit gesunken.
Was wir über die neuen Schutzmechanismen wissen
Das geht aus den Release Notes hervor:
Opus 5.5 erhält die gleiche Klasse von Schutzmaßnahmen, die Anthropic für Fable 5.1 in drei sensiblen Bereichen vorsieht: Cybersecurity, Biologie und Distillation.
Anthropic beschreibt den Erkennungsmechanismus nicht im Detail, aber das Ergebnis ist ein Screening-Schritt auf eingehenden Anfragen: Wird etwas im Prompt einer der drei Kategorien zugeordnet, geht die Anfrage nicht an Opus 5.5, sondern wird vor der Beantwortung umgeroutet. Ein als Cybersecurity markierter Prompt fällt zum Beispiel auf das ältere Opus 4.8 zurück, während ein Biologie-Prompt stattdessen an Opus 5 weitergereicht wird. Der Schutz ist also kein Output-Filter, sondern eine Routing-Entscheidung vor der Generierung – und welches Modell die Anfrage übernimmt, hängt von der ausgelösten Kategorie ab.
Vor dem Release wurde das Modell außerdem extern von METR und Frontier Design evaluiert (Details zu diesen Organisationen stehen in den FAQs) – ein unabhängiger Check der Sicherheitsaussagen statt nur Anthropics eigener Einschätzung.
Verfügbarkeit von Claude Opus 5.5
Claude Opus 5.5 ist jetzt auf Anthropics eigenen Plattformen sowie über Amazon Web Services, Google Cloud und Microsoft Azure verfügbar. Entwicklerinnen und Entwickler auf der Claude Platform können direkt über claude-opus-5-5 zugreifen.
Fazit
Claude Opus 5.5 ist ein Gewinn für Nutzende. Es ist günstiger, schneller und sicherer als sein Vorgänger.
Die Sicherheitsdimension ist langfristig die spannendere Geschichte. Direkt nach Amodeis „Pacing the frontier“-Reden hätten die Optiken schlecht sein können – ein neues Flaggschiff, eine Woche nach dem öffentlichen Ruf nach Verlangsamung. Doch das Release, ob bewusst oder nicht, trifft genau die Balance: Keine Fähigkeitsdecke wurde angehoben, Opus 5.5 bringt die gleiche Schutzklasse wie zuvor Fable – und eine signifikant niedrigere Rate an Sandbox-Escape-Versuchen im Test. Ob das nun „Pacing the frontier“ in der Praxis ist oder einfach gutes Timing – es ist zumindest konsistent mit Amodeis Argument.





Anthropic hat soeben Claude Opus 5.5 veröffentlicht – und das Thema sind ganz klar Wirtschaftlichkeit und Sicherheit. Das Modell ist in der Ausführung 40% günstiger als Opus 5 (das selbst zum gleichen Preis wie seine Vorgänger Opus 4.6, 4.7 und 4.8 gestartet ist), generiert Ausgaben über 30% schneller und erzielt die besten Werte, die Anthropic je in seiner internen Alignment-Suite gemessen hat. In Sachen Leistung liegt es bei den meisten Aufgaben nahe an Claude Fable 5.1 – allerdings zu einem Bruchteil der Kosten.
Wir hatten mit einer Veröffentlichung in dieser Woche gerechnet und die Nachrichtenlage genau verfolgt. Es ist das erste Release, seit Anthropic-CEO Dario Amodei öffentlich dazu aufgerufen hat, die „Frontier zu takten“ – also Sicherheitsarbeit vor Fähigkeitsgewinne zu stellen, statt um das leistungsstärkste Modell zu konkurrieren. Auf den ersten Blick mag es widersprüchlich wirken, eine Woche nach einem Plädoyer für ein KI-Tempo-Limit ein neues Modell herauszubringen. So inkonsequent ist es aber vielleicht gar nicht. Opus 5.5 dreht sich nicht um rohe Intelligenz. Es liefert vergleichbare Leistung – nur günstiger und mit strengerem Alignment.
Wenige Stunden später reagierte OpenAI mit den neuen Sol- und Luna-Modellen. Lies mehr dazu in unserem GPT-6 Sol und Luna Guide und unserem Hands-on-Vergleich GPT-6 Sol vs. Claude Opus 5.5.
Was ist Claude Opus 5.5?
Claude Opus 5.5 ist das erste Release in Anthropics neuer „5.5“-Generation. Es steht jetzt an der Spitze der Modellreihe von Anthropic. Sonnet- und Haiku-Versionen sollen in den nächsten Tagen oder Wochen folgen.
Opus 5.5 ist für dieselben anspruchsvollen Jobs gebaut, auf die Opus-Modelle schon immer abgezielt haben: lange, agentische Coding-Runs, komplexe Recherche und Analyse sowie mehrstufige Workflows, die über viele Stunden stabil bleiben müssen, ohne zu driften.
Der Unterschied diesmal: Opus 5.5 ist eine schlankere, effizientere Version dessen, was Opus 5 bereits konnte – vergleichbare Arbeit mit weniger Tokens pro Aufgabe. Genau daraus resultieren die meisten Kosten- und Geschwindigkeitsvorteile.
Was ist neu in Claude Opus 5.5?
Starten wir mit den Kosten, denn das ist die eigentliche Headline.
Spürbar günstiger und schneller
Cache-Reads, die laut Anthropic den Großteil der agentischen Coding-Kosten ausmachen, sinken um 60% von 0,50 $ auf 0,20 $ pro Million Tokens. Input- und Output-Tokens sind ebenfalls um 20% günstiger, und das Modell generiert Ausgaben über 30% schneller als Opus 5. Ebenfalls im Release, wenn auch weniger prominent: Anthropic lockert die Fünf-Stunden-Nutzungslimits für Pro-, Max- und Team-Pläne und führt einen anrechenbaren Rate-Limit-Reset ein, den Abonnierende speichern und wiederverwenden können.
Leistung, die vor allem bei langen, unübersichtlichen Jobs auffällt
Anthropic sagt, die größten Zugewinne zeigen sich bei weit verzweigten, realen Aufgaben – weniger bei kurzen Benchmark-Problemen. Ein Early Tester soll eine Code-Migration mit 680.000 Zeilen in unter einem Tag abgeschlossen haben – Arbeit, für die ein Engineering-Team sonst Wochen gebraucht hätte.
In einem internen Test, in dem Opus 5.5 die Ladezeiten jeder Seite einer Web-App reduzieren sollte, gelang das 39 von 40 Mal – ein Hinweis auf bemerkenswerte Konstanz.
Bessere Kommunikation
Anthropic hebt den Schreibstil als Fix für eine der häufigsten Beschwerden über Opus 5 hervor: Weitschweifigkeit und Jargon. Opus 5.5 soll mit den wichtigsten Informationen einsteigen, weniger idiosynkratische Formulierungen verwenden und näher an der vorgegebenen Hausstilistik bleiben. Im Release gibt es ein Beispiel zur Bug-Erklärung im Side-by-Side-Vergleich – die Opus-5.5-Version ist merklich kürzer und nennt die eigentliche Ursache direkt zu Beginn, statt darauf hinzuarbeiten.
Claude Opus 5.5: Benchmark-Ergebnisse
So schneidet Opus 5.5 laut Anthropics eigener Veröffentlichung im Vergleich zu Fable 5.1, Opus 5 und der Konkurrenz ab.
Ein paar Dinge stechen hervor. Opus 5.5 schlägt Fable 5.1 in jedem hier gezeigten Benchmark – bemerkenswert, da Anthropic 5.5 eher als „Fable-Leistung zum günstigeren Preis“ denn als direktes Upgrade positioniert. Ich vermute, Anthropic betont das nicht, weil sie ihre Tier-Struktur schützen wollen. Heißt: Fable wird als Premium an der Spitze verkauft. Wenn Opus 5.5 weithin als besser als Fable gilt – dann ist das eine unangenehme Frage für alle, die Fable-Preise zahlen.
Gerade beim agentischen Coding ist der Abstand zu Opus 5 über alle drei Benchmarks groß. Der Sprung bei CursorBench ist die größte Einzel-Verbesserung in der Tabelle.
Auch die Ausnahmen sollte man benennen. GPT-6 Astra liegt sowohl bei AutomationBench (Geschäfts-Workflows) als auch bei Terminal-Bench-Science (agentische wissenschaftliche Recherche) knapp vor Opus 5.5 – beim zweiten mit deutlicherem Vorsprung. Man kann also sagen: Bei einigen realen Workflow- und Science-Aufgaben liegt Opus 5.5 noch hinten.
Moment, was ist mit „Pacing the Frontier“?
Optisch wirkte es zunächst seltsam. Wenige Tage nach Amodeis Appell, die KI-Entwicklung zu bremsen, bringt Anthropic ein neues Flaggschiff.
Eine zynische Lesart wäre: „Pacing the frontier“ drehte sich nie wirklich um Sicherheit. Es ist leichter, zur Verlangsamung aufzurufen, wenn man vorne liegt – und gemessen am Umsatz liegt Anthropic vorne.
Eine andere Interpretation: „Pacing the frontier“ war nie ein Argument gegen Releases an sich, sondern dafür, welche Art von Modellen man veröffentlicht. Unter dieser Lesart passt Opus 5.5 zur Botschaft.
Anthropic sagt, Opus 5.5 performt in etwa auf dem Niveau von Fable 5.1 – ein Modell, das es bereits gab. Die Fähigkeitsdecke hat sich nicht verschoben. Geändert hat sich, dass die gleiche Arbeitsebene jetzt 40% weniger kostet und über 30% schneller läuft. Außerdem erzielt es bessere interne Alignment-Scores.
Claude Opus 5.5: Preise
Der Fast Mode – mit bis zu 2,5-facher Geschwindigkeit – ist in Claude Code und auf der Claude Platform für $8 pro Million Input-Tokens und $40 pro Million Output-Tokens verfügbar.
Ich habe ein Diagramm erstellt, um die Entwicklung der Claude-Opus-Preise über die Zeit zu zeigen. Sie sind im Laufe der Zeit gesunken.
Was wir über die neuen Schutzmechanismen wissen
Das geht aus den Release Notes hervor:
Opus 5.5 erhält die gleiche Klasse von Schutzmaßnahmen, die Anthropic für Fable 5.1 in drei sensiblen Bereichen vorsieht: Cybersecurity, Biologie und Distillation.
Anthropic beschreibt den Erkennungsmechanismus nicht im Detail, aber das Ergebnis ist ein Screening-Schritt auf eingehenden Anfragen: Wird etwas im Prompt einer der drei Kategorien zugeordnet, geht die Anfrage nicht an Opus 5.5, sondern wird vor der Beantwortung umgeroutet. Ein als Cybersecurity markierter Prompt fällt zum Beispiel auf das ältere Opus 4.8 zurück, während ein Biologie-Prompt stattdessen an Opus 5 weitergereicht wird. Der Schutz ist also kein Output-Filter, sondern eine Routing-Entscheidung vor der Generierung – und welches Modell die Anfrage übernimmt, hängt von der ausgelösten Kategorie ab.
Vor dem Release wurde das Modell außerdem extern von METR und Frontier Design evaluiert (Details zu diesen Organisationen stehen in den FAQs) – ein unabhängiger Check der Sicherheitsaussagen statt nur Anthropics eigener Einschätzung.
Verfügbarkeit von Claude Opus 5.5
Claude Opus 5.5 ist jetzt auf Anthropics eigenen Plattformen sowie über Amazon Web Services, Google Cloud und Microsoft Azure verfügbar. Entwicklerinnen und Entwickler auf der Claude Platform können direkt über
claude-opus-5-5zugreifen.Fazit
Claude Opus 5.5 ist ein Gewinn für Nutzende. Es ist günstiger, schneller und sicherer als sein Vorgänger.
Die Sicherheitsdimension ist langfristig die spannendere Geschichte. Direkt nach Amodeis „Pacing the frontier“-Reden hätten die Optiken schlecht sein können – ein neues Flaggschiff, eine Woche nach dem öffentlichen Ruf nach Verlangsamung. Doch das Release, ob bewusst oder nicht, trifft genau die Balance: Keine Fähigkeitsdecke wurde angehoben, Opus 5.5 bringt die gleiche Schutzklasse wie zuvor Fable – und eine signifikant niedrigere Rate an Sandbox-Escape-Versuchen im Test. Ob das nun „Pacing the frontier“ in der Praxis ist oder einfach gutes Timing – es ist zumindest konsistent mit Amodeis Argument.