Anthropic acaba de lanzar Claude Opus 5.5, y la noticia va de economía y seguridad. El modelo cuesta un 40% menos de ejecutar que Opus 5 (que ya salió al mismo precio que sus predecesores Opus 4.6, 4.7 y 4.8), genera resultados más de un 30% más rápido y alcanza las mejores puntuaciones medidas por Anthropic en su batería interna de alineación. En rendimiento, se sitúa cerca de Claude Fable 5.1 en la mayoría de tareas, pero a una fracción del precio.
Esperábamos un lanzamiento esta semana y estábamos muy atentos. Es la primera versión desde que el CEO de Anthropic, Dario Amodei, pidió públicamente "regular el ritmo de la frontera", es decir, priorizar el trabajo en seguridad por delante de los avances en capacidades, en lugar de competir por sacar el modelo más potente posible. A primera vista, podría parecer contradictorio, hipócrita o incoherente publicar un modelo nuevo una semana después de pedir frenar la IA. Pero quizá no sea tan incoherente. Opus 5.5 no va de inteligencia bruta. Va de mantener el rendimiento pero más barato y con una alineación más estricta.
A las pocas horas, OpenAI respondió con sus nuevos modelos Sol y Luna. Léelo en nuestra guía de GPT-6 Sol y Luna y en nuestra comparativa práctica entre GPT-6 Sol y Claude Opus 5.5.
¿Qué es Claude Opus 5.5?
Claude Opus 5.5 es la primera versión de la nueva generación "5.5" de Anthropic. Pasa a encabezar la gama de modelos de Anthropic. Se esperan versiones Sonnet y Haiku en los próximos días o semanas.
Opus 5.5 está pensado para los mismos trabajos exigentes a los que siempre han apuntado los modelos Opus: ejecuciones largas y "agénticas" de código, investigación y análisis complejos, y flujos de trabajo de varios pasos que deben mantenerse estables durante horas sin desviarse.
¿Dónde cambia esta vez? Opus 5.5 es una versión más ligera y eficiente de lo que ya hacía Opus 5: realizar el mismo trabajo con menos tokens por tarea, que es de donde vienen la mayor parte de las mejoras en coste y velocidad.
¿Qué hay de nuevo en Claude Opus 5.5?
Empecemos por el coste, porque es realmente el gran titular.
Sensiblemente más barato y rápido
Las lecturas de caché, que según Anthropic representan la mayor parte de los costes de agentes y programación, bajan un 60%, de $0.50 a $0.20 por millón de tokens. Los tokens de entrada y salida también caen un 20%, y el modelo genera respuestas más de un 30% más rápido que Opus 5. Además, aunque con menos foco en la nota de lanzamiento: Anthropic está relajando los límites de uso de cinco horas en los planes Pro, Max y Team, y ofrece a los suscriptores un reinicio de límite de tasa acumulable que pueden guardar y reutilizar.
Rendimiento que más se nota en trabajos largos y desordenados
Anthropic afirma que las mayores ganancias se ven en tareas extensas y reales, no en problemas cortos de benchmark. Un probador temprano completó supuestamente una migración de 680.000 líneas de código en menos de un día: un trabajo que a un equipo de ingeniería le habría llevado semanas.
En una prueba interna en la que se pidió a Opus 5.5 reducir los tiempos de carga en todas las páginas de una aplicación web, lo logró 39 de 40 veces, lo que también muestra que el modelo es consistente.
Mejor comunicación
Anthropic destaca el estilo de escritura como solución a una de las quejas más comunes sobre Opus 5: la verbosidad y el argot. Opus 5.5 se describe como un modelo que empieza por la información más importante, usa menos giros idiosincráticos y se ajusta mejor al libro de estilo que se le marque. La versión incluye un ejemplo comparado de explicación de un bug, y la de Opus 5.5 es notablemente más breve y va directa a la causa raíz en lugar de prepararla poco a poco.
Resultados de benchmarks de Claude Opus 5.5
Así queda Opus 5.5 frente a Fable 5.1, Opus 5 y la competencia, según la propia Anthropic.
| | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|
| Programación agéntica — Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| Programación agéntica — FrontierCode v1.1 (Main) | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| Programación agéntica — CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| Trabajo de conocimiento — GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| Flujos de negocio — AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Razonamiento multidisciplinar — Humanity's Last Exam (con herramientas) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| Investigación científica agéntica — Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| Uso de ordenador — OSWorld 2.0 (parcial) | 81.8% | 80.7% | 74.0% | — | — |
| Reconocimiento de gráficos — Chartography (con herramientas) | 89.0% | 88.4% | 83.4% | — | — |
Hay varias cosas llamativas. Opus 5.5 supera a Fable 5.1 en todos los benchmarks mostrados aquí, lo cual sorprende porque Anthropic ha presentado 5.5 como "rendimiento tipo Fable, más barato" más que como una mejora directa. Creo que Anthropic no lo enfatiza porque quiere proteger su estructura de gamas. Es decir: Anthropic vende Fable como el tope de la línea a un precio premium. Si Opus 5.5 se ve como que supera a Fable, es una pregunta incómoda para quien paga precios de Fable.
En programación agéntica, la ventaja sobre Opus 5 es grande en los tres benchmarks. El salto en CursorBench es la mayor mejora en un único benchmark de toda la tabla.
También conviene señalar las excepciones. GPT-6 Astra supera ligeramente a Opus 5.5 en AutomationBench (flujos de negocio) y en Terminal-Bench-Science (investigación científica agéntica), y con un margen claro en el segundo. Así que se puede decir que Opus 5.5 aún va por detrás en algunas tareas reales de flujos de trabajo y de investigación científica.
Espera, ¿y eso de "regular el ritmo de la frontera"?
La imagen sí parecía rara al principio. Días después de que Amodei pidiera frenar el avance de la IA, Anthropic lanzó un nuevo buque insignia.
Una lectura cínica es que "regular el ritmo de la frontera" nunca fue realmente sobre seguridad. Es más fácil pedir que el sector se ralentice cuando llevas la delantera y, por ingresos, Anthropic va en cabeza.
Pero, en otra interpretación, "regular el ritmo" no era ir contra publicar modelos, sino sobre qué tipo de modelos publicar. Con esa lectura, Opus 5.5 encaja con el mensaje.
Anthropic afirma que Opus 5.5 rinde aproximadamente al nivel de Fable 5.1, un modelo que ya existía. El techo de capacidad no se ha movido. Lo que cambia es que el mismo tipo de trabajo ahora cuesta un 40% menos y funciona más de un 30% más rápido. Además, tiene mejores puntuaciones de alineación interna.
Precios de Claude Opus 5.5
| Por 1M de tokens | Opus 5.5 | Opus 5 |
|---|
| Entrada | $4 | $5 |
| Salida | $20 | $25 |
| Lecturas de caché | $0.20 | $0.50 |
| Escrituras de caché | $5 | $6.25 |
El modo rápido — hasta 2.5x de velocidad — está disponible en Claude Code y en Claude Platform a $8 por millón de tokens de entrada y $40 por millón de tokens de salida.
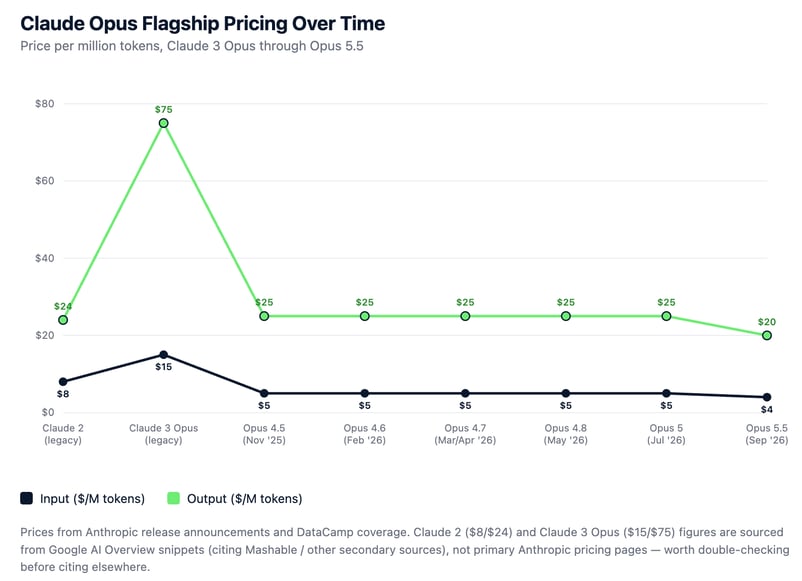
He creado un gráfico para ver la evolución del precio de Claude Opus con el tiempo. Ha ido bajando.
Lo que sabemos sobre cómo funcionan las nuevas salvaguardas
Esto es lo que sabemos por las notas de la versión:
Opus 5.5 incorpora la misma clase de medidas de protección que Anthropic reserva para Fable 5.1 en tres áreas señaladas: ciberseguridad, biología y destilación.
Anthropic no detalla el mecanismo de detección, pero el resultado es una fase de cribado que se aplica a las solicitudes entrantes: si algo del prompt se marca como perteneciente a una de esas tres categorías, en lugar de ir a Opus 5.5, se redirige antes de responder. Por ejemplo, un prompt marcado por ciberseguridad baja al modelo Opus 4.8 más antiguo, mientras que uno relacionado con biología se eleva a Opus 5. Así que la salvaguarda no es un filtro de salida, sino una decisión de enrutamiento antes de empezar a generar, y el modelo que procesa la solicitud depende de la categoría activada.
Anthropic también sometió el modelo a una evaluación externa por parte de METR y Frontier Design antes del lanzamiento (detalles sobre estas organizaciones en las FAQs), aportando una verificación independiente a sus afirmaciones de seguridad y no solo la palabra de Anthropic.
Disponibilidad de Claude Opus 5.5
Claude Opus 5.5 ya está disponible en las plataformas de Anthropic y también en Amazon Web Services, Google Cloud y Microsoft Azure. Los desarrolladores en Claude Platform pueden acceder directamente como claude-opus-5-5.
Conclusión
Claude Opus 5.5 es una buena noticia para los usuarios. Es más barato, más rápido y más seguro que su predecesor.
La parte de seguridad es la historia más interesante a largo plazo. Justo después de los discursos de Amodei sobre "regular el ritmo de la frontera", la imagen podía ser mala: un nuevo buque insignia una semana después de pedir frenar. Pero el lanzamiento, intencionadamente o no, hila fino: no se elevó el techo de capacidad, y Opus 5.5 llega con el mismo nivel de salvaguardas antes reservado para Fable, y con una tasa sensiblemente menor de intentos de fuga de sandbox en pruebas. No sé si eso es "regular el ritmo" en la práctica o simplemente buen timing. Pero al menos es coherente con el argumento de Amodei.


Anthropic acaba de lanzar Claude Opus 5.5, y la noticia va de economía y seguridad. El modelo cuesta un 40% menos de ejecutar que Opus 5 (que ya salió al mismo precio que sus predecesores Opus 4.6, 4.7 y 4.8), genera resultados más de un 30% más rápido y alcanza las mejores puntuaciones medidas por Anthropic en su batería interna de alineación. En rendimiento, se sitúa cerca de Claude Fable 5.1 en la mayoría de tareas, pero a una fracción del precio.
Esperábamos un lanzamiento esta semana y estábamos muy atentos. Es la primera versión desde que el CEO de Anthropic, Dario Amodei, pidió públicamente "regular el ritmo de la frontera", es decir, priorizar el trabajo en seguridad por delante de los avances en capacidades, en lugar de competir por sacar el modelo más potente posible. A primera vista, podría parecer contradictorio, hipócrita o incoherente publicar un modelo nuevo una semana después de pedir frenar la IA. Pero quizá no sea tan incoherente. Opus 5.5 no va de inteligencia bruta. Va de mantener el rendimiento pero más barato y con una alineación más estricta.
A las pocas horas, OpenAI respondió con sus nuevos modelos Sol y Luna. Léelo en nuestra guía de GPT-6 Sol y Luna y en nuestra comparativa práctica entre GPT-6 Sol y Claude Opus 5.5.
¿Qué es Claude Opus 5.5?
Claude Opus 5.5 es la primera versión de la nueva generación "5.5" de Anthropic. Pasa a encabezar la gama de modelos de Anthropic. Se esperan versiones Sonnet y Haiku en los próximos días o semanas.
Opus 5.5 está pensado para los mismos trabajos exigentes a los que siempre han apuntado los modelos Opus: ejecuciones largas y "agénticas" de código, investigación y análisis complejos, y flujos de trabajo de varios pasos que deben mantenerse estables durante horas sin desviarse.
¿Dónde cambia esta vez? Opus 5.5 es una versión más ligera y eficiente de lo que ya hacía Opus 5: realizar el mismo trabajo con menos tokens por tarea, que es de donde vienen la mayor parte de las mejoras en coste y velocidad.
¿Qué hay de nuevo en Claude Opus 5.5?
Empecemos por el coste, porque es realmente el gran titular.
Sensiblemente más barato y rápido
Las lecturas de caché, que según Anthropic representan la mayor parte de los costes de agentes y programación, bajan un 60%, de $0.50 a $0.20 por millón de tokens. Los tokens de entrada y salida también caen un 20%, y el modelo genera respuestas más de un 30% más rápido que Opus 5. Además, aunque con menos foco en la nota de lanzamiento: Anthropic está relajando los límites de uso de cinco horas en los planes Pro, Max y Team, y ofrece a los suscriptores un reinicio de límite de tasa acumulable que pueden guardar y reutilizar.
Rendimiento que más se nota en trabajos largos y desordenados
Anthropic afirma que las mayores ganancias se ven en tareas extensas y reales, no en problemas cortos de benchmark. Un probador temprano completó supuestamente una migración de 680.000 líneas de código en menos de un día: un trabajo que a un equipo de ingeniería le habría llevado semanas.
En una prueba interna en la que se pidió a Opus 5.5 reducir los tiempos de carga en todas las páginas de una aplicación web, lo logró 39 de 40 veces, lo que también muestra que el modelo es consistente.
Mejor comunicación
Anthropic destaca el estilo de escritura como solución a una de las quejas más comunes sobre Opus 5: la verbosidad y el argot. Opus 5.5 se describe como un modelo que empieza por la información más importante, usa menos giros idiosincráticos y se ajusta mejor al libro de estilo que se le marque. La versión incluye un ejemplo comparado de explicación de un bug, y la de Opus 5.5 es notablemente más breve y va directa a la causa raíz en lugar de prepararla poco a poco.
Resultados de benchmarks de Claude Opus 5.5
Así queda Opus 5.5 frente a Fable 5.1, Opus 5 y la competencia, según la propia Anthropic.
Hay varias cosas llamativas. Opus 5.5 supera a Fable 5.1 en todos los benchmarks mostrados aquí, lo cual sorprende porque Anthropic ha presentado 5.5 como "rendimiento tipo Fable, más barato" más que como una mejora directa. Creo que Anthropic no lo enfatiza porque quiere proteger su estructura de gamas. Es decir: Anthropic vende Fable como el tope de la línea a un precio premium. Si Opus 5.5 se ve como que supera a Fable, es una pregunta incómoda para quien paga precios de Fable.
En programación agéntica, la ventaja sobre Opus 5 es grande en los tres benchmarks. El salto en CursorBench es la mayor mejora en un único benchmark de toda la tabla.
También conviene señalar las excepciones. GPT-6 Astra supera ligeramente a Opus 5.5 en AutomationBench (flujos de negocio) y en Terminal-Bench-Science (investigación científica agéntica), y con un margen claro en el segundo. Así que se puede decir que Opus 5.5 aún va por detrás en algunas tareas reales de flujos de trabajo y de investigación científica.
Espera, ¿y eso de "regular el ritmo de la frontera"?
La imagen sí parecía rara al principio. Días después de que Amodei pidiera frenar el avance de la IA, Anthropic lanzó un nuevo buque insignia.
Una lectura cínica es que "regular el ritmo de la frontera" nunca fue realmente sobre seguridad. Es más fácil pedir que el sector se ralentice cuando llevas la delantera y, por ingresos, Anthropic va en cabeza.
Pero, en otra interpretación, "regular el ritmo" no era ir contra publicar modelos, sino sobre qué tipo de modelos publicar. Con esa lectura, Opus 5.5 encaja con el mensaje.
Anthropic afirma que Opus 5.5 rinde aproximadamente al nivel de Fable 5.1, un modelo que ya existía. El techo de capacidad no se ha movido. Lo que cambia es que el mismo tipo de trabajo ahora cuesta un 40% menos y funciona más de un 30% más rápido. Además, tiene mejores puntuaciones de alineación interna.
Precios de Claude Opus 5.5
El modo rápido — hasta 2.5x de velocidad — está disponible en Claude Code y en Claude Platform a $8 por millón de tokens de entrada y $40 por millón de tokens de salida.
He creado un gráfico para ver la evolución del precio de Claude Opus con el tiempo. Ha ido bajando.
Lo que sabemos sobre cómo funcionan las nuevas salvaguardas
Esto es lo que sabemos por las notas de la versión:
Opus 5.5 incorpora la misma clase de medidas de protección que Anthropic reserva para Fable 5.1 en tres áreas señaladas: ciberseguridad, biología y destilación.
Anthropic no detalla el mecanismo de detección, pero el resultado es una fase de cribado que se aplica a las solicitudes entrantes: si algo del prompt se marca como perteneciente a una de esas tres categorías, en lugar de ir a Opus 5.5, se redirige antes de responder. Por ejemplo, un prompt marcado por ciberseguridad baja al modelo Opus 4.8 más antiguo, mientras que uno relacionado con biología se eleva a Opus 5. Así que la salvaguarda no es un filtro de salida, sino una decisión de enrutamiento antes de empezar a generar, y el modelo que procesa la solicitud depende de la categoría activada.
Anthropic también sometió el modelo a una evaluación externa por parte de METR y Frontier Design antes del lanzamiento (detalles sobre estas organizaciones en las FAQs), aportando una verificación independiente a sus afirmaciones de seguridad y no solo la palabra de Anthropic.
Disponibilidad de Claude Opus 5.5
Claude Opus 5.5 ya está disponible en las plataformas de Anthropic y también en Amazon Web Services, Google Cloud y Microsoft Azure. Los desarrolladores en Claude Platform pueden acceder directamente como
claude-opus-5-5.Conclusión
Claude Opus 5.5 es una buena noticia para los usuarios. Es más barato, más rápido y más seguro que su predecesor.
La parte de seguridad es la historia más interesante a largo plazo. Justo después de los discursos de Amodei sobre "regular el ritmo de la frontera", la imagen podía ser mala: un nuevo buque insignia una semana después de pedir frenar. Pero el lanzamiento, intencionadamente o no, hila fino: no se elevó el techo de capacidad, y Opus 5.5 llega con el mismo nivel de salvaguardas antes reservado para Fable, y con una tasa sensiblemente menor de intentos de fuga de sandbox en pruebas. No sé si eso es "regular el ritmo" en la práctica o simplemente buen timing. Pero al menos es coherente con el argumento de Amodei.