Anthropic baru saja merilis Claude Opus 5.5, dan fokusnya adalah ekonomi dan keselamatan. Model ini 40% lebih murah untuk dijalankan dibandingkan Opus 5 (yang sendiri dirilis dengan harga yang sama seperti pendahulunya Opus 4.6, 4.7, dan 4.8), menghasilkan output lebih dari 30% lebih cepat, dan mencatat skor terbaik yang pernah diukur Anthropic pada rangkaian alignment internalnya. Dari sisi performa, kinerjanya mendekati Claude Fable 5.1 pada sebagian besar tugas, tetapi dengan harga jauh lebih murah.
Kami telah menantikan rilis pekan ini dan memantau berita dengan saksama. Ini adalah rilis pertama sejak CEO Anthropic Dario Amodei secara terbuka menyerukan untuk "mengatur laju frontier," yang dimaksudkan menjaga pekerjaan keselamatan berada di depan peningkatan kapabilitas alih-alih berlomba merilis model paling kuat. Sekilas, merilis model baru seminggu setelah menyerukan perlambatan AI mungkin tampak kontradiktif, munafik, atau tidak konsisten. Namun mungkin tidak begitu tidak konsisten setelah dipikir lagi. Opus 5.5 bukan tentang kecerdasan mentah. Ini tentang kinerja setara tetapi lebih murah dan dengan alignment yang lebih ketat.
Dalam hitungan jam, OpenAI merespons dengan model Sol dan Luna terbaru mereka. Baca di panduan GPT-6 Sol dan Luna kami dan perbandingan praktis GPT-6 Sol versus Claude Opus 5.5.
Apa Itu Claude Opus 5.5?
Claude Opus 5.5 adalah rilis pertama dalam generasi baru "5.5" Anthropic. Kini ia berada di puncak jajaran model Anthropic. Versi Sonnet dan Haiku diperkirakan menyusul dalam beberapa hari atau minggu ke depan.
Opus 5.5 dibangun untuk jenis pekerjaan menuntut yang selalu menjadi target model Opus: sesi coding agen panjang, riset dan analisis kompleks, serta alur kerja multi-langkah yang harus stabil selama berjam-jam tanpa menyimpang.
Perbedaannya kali ini: Opus 5.5 adalah versi yang lebih ramping dan efisien dari apa yang sudah dilakukan Opus 5, yakni menyelesaikan pekerjaan serupa dengan lebih sedikit token per tugas, yang menjadi sumber utama penghematan biaya dan peningkatan kecepatan.
Apa yang Baru di Claude Opus 5.5?
Mari mulai dari biaya karena memang itu klaim utama.
Jauh lebih murah dan lebih cepat
Cache read, yang menurut Anthropic menyumbang sebagian besar biaya agen dan coding, turun 60%, dari $0,50 menjadi $0,20 per sejuta token. Token input dan output juga turun 20%, dan model menghasilkan output lebih dari 30% lebih cepat daripada Opus 5. Juga disertakan dalam rilis ini meski tidak terlalu disorot: Anthropic melonggarkan batas penggunaan lima jam pada paket Pro, Max, dan Team, serta memberi pelanggan reset rate-limit yang dapat disimpan dan digunakan kembali.
Anthropic mengatakan peningkatan terbesar muncul pada tugas dunia nyata yang luas alih-alih masalah benchmark singkat. Seorang penguji awal dilaporkan menyelesaikan migrasi kode 680.000 baris dalam waktu kurang dari sehari — pekerjaan yang biasanya memakan waktu berminggu-minggu bagi sebuah tim engineer.
Dalam uji internal di mana Opus 5.5 diminta memangkas waktu muat di setiap halaman sebuah aplikasi web, model ini berhasil 39 dari 40 kali, yang menunjukkan konsistensi model tersebut.
Komunikasi lebih baik
Anthropic menyoroti gaya penulisan sebagai perbaikan untuk salah satu keluhan paling umum tentang Opus 5: terlalu bertele-tele dan penuh jargon. Opus 5.5 digambarkan menyajikan informasi terpenting terlebih dahulu, menggunakan frasa yang kurang idiosinkratik, dan lebih patuh pada gaya rumah yang diberikan. Rilis ini menyertakan contoh penjelasan bug secara berdampingan, dan versi Opus 5.5 terasa lebih singkat dan langsung memaparkan akar masalah alih-alih membangun narasi panjang sebelumnya.
Hasil Benchmark Claude Opus 5.5
Begini perbandingan Opus 5.5 dengan Fable 5.1, Opus 5, dan para pesaingnya, menurut rilis Anthropic.
| | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|
| Koding agen — Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| Koding agen — FrontierCode v1.1 (Utama) | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| Koding agen — CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| Pekerjaan berbasis pengetahuan — GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| Alur kerja bisnis — AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Penalaran multidisiplin — Humanity's Last Exam (dengan tools) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Riset ilmiah agen — Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| Penggunaan komputer — OSWorld 2.0 (parsial) | 81,8% | 80,7% | 74,0% | — | — |
| Pengenalan bagan visual — Chartography (dengan tools) | 89,0% | 88,4% | 83,4% | — | — |
Beberapa hal menonjol. Opus 5.5 mengungguli Fable 5.1 pada setiap benchmark yang ditampilkan di sini, yang patut dicatat mengingat Anthropic memosisikan 5.5 sebagai "kinerja setara Fable, lebih murah" alih-alih peningkatan langsung. Menurut saya, Anthropic tidak menyoroti hal ini karena mereka ingin melindungi struktur tier mereka. Maksudnya: Anthropic menjual Fable sebagai produk premium di puncak lini. Jika Opus 5.5 diketahui banyak mengalahkan Fable — yah, itu pertanyaan yang canggung bagi siapa pun yang membayar harga Fable.
Khusus pada koding agen, jaraknya atas Opus 5 besar di ketiga benchmark. Lompatan di CursorBench adalah peningkatan terbesar pada satu benchmark dalam tabel.
Pengecualian juga patut dicatat. GPT-6 Astra unggul tipis atas Opus 5.5 pada AutomationBench (alur kerja bisnis) dan Terminal-Bench-Science (riset ilmiah agen), dan dengan margin yang cukup jelas pada yang kedua. Jadi bisa dibilang Opus 5.5 masih tertinggal pada sebagian tugas alur kerja dunia nyata dan riset sains.
Tunggu, Bagaimana dengan "Mengatur Laju Frontier"?
Sekilas, tampilannya memang aneh. Beberapa hari setelah Amodei menyerukan perlambatan kemajuan AI, Anthropic merilis flagship baru.
Pandangan sinisnya: "mengatur laju frontier" tidak pernah benar-benar soal keselamatan. Lebih mudah menyerukan industri untuk melambat saat Anda memimpin, dan dari sisi pendapatan, Anthropic memang memimpin.
Namun dengan interpretasi lain, "mengatur laju frontier" mungkin bukan argumen melawan merilis model, melainkan argumen tentang jenis model apa yang dirilis. Dengan interpretasi itu, Opus 5.5 selaras dengan pesannya.
Anthropic mengatakan Opus 5.5 berkinerja kira-kira setara dengan Fable 5.1, model yang sudah ada. Batas atas kapabilitas tidak bergeser. Yang berubah adalah tingkat pekerjaan yang sama kini 40% lebih murah dan berjalan lebih dari 30% lebih cepat. Ia juga memiliki skor alignment internal yang lebih baik.
Harga Claude Opus 5.5
| Per 1M token | Opus 5.5 | Opus 5 |
|---|
| Input | $4 | $5 |
| Output | $20 | $25 |
| Cache read | $0,20 | $0,50 |
| Cache write | $5 | $6,25 |
Mode cepat — berjalan hingga 2,5x — tersedia di Claude Code dan Claude Platform seharga $8 per sejuta token input dan $40 per sejuta token output.
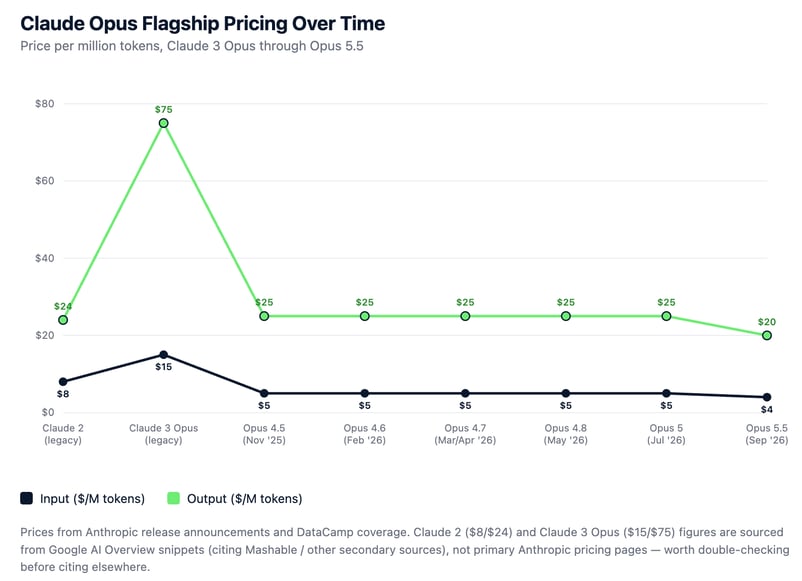
Saya membuat bagan agar kita bisa melihat harga Claude Opus dari waktu ke waktu. Harganya semakin turun seiring waktu.
Yang Kita Ketahui tentang Cara Kerja Perlindungan Baru
Berikut yang kami ketahui dari catatan rilis:
Opus 5.5 mendapatkan kelas perlindungan yang sama yang disediakan Anthropic untuk Fable 5.1 pada tiga area yang ditandai: keamanan siber, biologi, dan distilasi.
Anthropic tidak merinci mekanisme deteksinya, tetapi hasilnya adalah langkah penyaringan yang berjalan pada permintaan masuk: sesuatu dalam prompt ditandai masuk ke salah satu dari tiga kategori itu, dan alih-alih permintaan diteruskan ke Opus 5.5, ia dialihkan sebelum dijawab. Misalnya, prompt yang ditandai keamanan siber dialihkan ke Opus 4.8 yang lebih lama, sementara prompt terkait biologi dinaikkan ke Opus 5. Jadi perlindungan ini bukan filter pada output — ini keputusan perutean yang dibuat sebelum generasi dimulai, dan model yang menangani permintaan bergantung pada kategori yang memicunya.
Anthropic juga menjalani evaluasi eksternal oleh METR dan Frontier Design sebelum rilis (detail tentang organisasi tersebut ada di FAQ), sehingga klaim keselamatannya mendapat verifikasi eksternal, bukan hanya pernyataan Anthropic sendiri.
Ketersediaan Claude Opus 5.5
Claude Opus 5.5 sudah tersedia di platform Anthropic sendiri serta Amazon Web Services, Google Cloud, dan Microsoft Azure. Pengembang di Claude Platform dapat mengaksesnya langsung sebagai claude-opus-5-5.
Kesimpulan
Claude Opus 5.5 menguntungkan pengguna. Lebih murah, lebih cepat, dan lebih aman daripada pendahulunya.
Aspek keselamatan adalah cerita yang lebih menarik dalam jangka panjang. Datang tepat setelah pidato Amodei tentang "mengatur laju frontier", tampilannya bisa saja buruk — model flagship baru, seminggu setelah seruan publik untuk melambat. Namun rilis ini, disengaja atau tidak, berhasil meniti garis itu: tidak ada kenaikan batas kapabilitas, dan Opus 5.5 hadir dengan tingkat perlindungan yang sama seperti yang sebelumnya hanya ada di Fable, serta tingkat upaya keluar dari sandbox yang secara bermakna lebih rendah dalam pengujian. Saya tidak tahu apakah itu wujud "mengatur laju frontier" dalam praktik atau hanya timing yang pas. Namun setidaknya konsisten dengan argumen yang disampaikan Amodei.





Anthropic baru saja merilis Claude Opus 5.5, dan fokusnya adalah ekonomi dan keselamatan. Model ini 40% lebih murah untuk dijalankan dibandingkan Opus 5 (yang sendiri dirilis dengan harga yang sama seperti pendahulunya Opus 4.6, 4.7, dan 4.8), menghasilkan output lebih dari 30% lebih cepat, dan mencatat skor terbaik yang pernah diukur Anthropic pada rangkaian alignment internalnya. Dari sisi performa, kinerjanya mendekati Claude Fable 5.1 pada sebagian besar tugas, tetapi dengan harga jauh lebih murah.
Kami telah menantikan rilis pekan ini dan memantau berita dengan saksama. Ini adalah rilis pertama sejak CEO Anthropic Dario Amodei secara terbuka menyerukan untuk "mengatur laju frontier," yang dimaksudkan menjaga pekerjaan keselamatan berada di depan peningkatan kapabilitas alih-alih berlomba merilis model paling kuat. Sekilas, merilis model baru seminggu setelah menyerukan perlambatan AI mungkin tampak kontradiktif, munafik, atau tidak konsisten. Namun mungkin tidak begitu tidak konsisten setelah dipikir lagi. Opus 5.5 bukan tentang kecerdasan mentah. Ini tentang kinerja setara tetapi lebih murah dan dengan alignment yang lebih ketat.
Dalam hitungan jam, OpenAI merespons dengan model Sol dan Luna terbaru mereka. Baca di panduan GPT-6 Sol dan Luna kami dan perbandingan praktis GPT-6 Sol versus Claude Opus 5.5.
Apa Itu Claude Opus 5.5?
Claude Opus 5.5 adalah rilis pertama dalam generasi baru "5.5" Anthropic. Kini ia berada di puncak jajaran model Anthropic. Versi Sonnet dan Haiku diperkirakan menyusul dalam beberapa hari atau minggu ke depan.
Opus 5.5 dibangun untuk jenis pekerjaan menuntut yang selalu menjadi target model Opus: sesi coding agen panjang, riset dan analisis kompleks, serta alur kerja multi-langkah yang harus stabil selama berjam-jam tanpa menyimpang.
Perbedaannya kali ini: Opus 5.5 adalah versi yang lebih ramping dan efisien dari apa yang sudah dilakukan Opus 5, yakni menyelesaikan pekerjaan serupa dengan lebih sedikit token per tugas, yang menjadi sumber utama penghematan biaya dan peningkatan kecepatan.
Apa yang Baru di Claude Opus 5.5?
Mari mulai dari biaya karena memang itu klaim utama.
Jauh lebih murah dan lebih cepat
Cache read, yang menurut Anthropic menyumbang sebagian besar biaya agen dan coding, turun 60%, dari $0,50 menjadi $0,20 per sejuta token. Token input dan output juga turun 20%, dan model menghasilkan output lebih dari 30% lebih cepat daripada Opus 5. Juga disertakan dalam rilis ini meski tidak terlalu disorot: Anthropic melonggarkan batas penggunaan lima jam pada paket Pro, Max, dan Team, serta memberi pelanggan reset rate-limit yang dapat disimpan dan digunakan kembali.
Performa paling terasa pada pekerjaan panjang dan berantakan
Anthropic mengatakan peningkatan terbesar muncul pada tugas dunia nyata yang luas alih-alih masalah benchmark singkat. Seorang penguji awal dilaporkan menyelesaikan migrasi kode 680.000 baris dalam waktu kurang dari sehari — pekerjaan yang biasanya memakan waktu berminggu-minggu bagi sebuah tim engineer.
Dalam uji internal di mana Opus 5.5 diminta memangkas waktu muat di setiap halaman sebuah aplikasi web, model ini berhasil 39 dari 40 kali, yang menunjukkan konsistensi model tersebut.
Komunikasi lebih baik
Anthropic menyoroti gaya penulisan sebagai perbaikan untuk salah satu keluhan paling umum tentang Opus 5: terlalu bertele-tele dan penuh jargon. Opus 5.5 digambarkan menyajikan informasi terpenting terlebih dahulu, menggunakan frasa yang kurang idiosinkratik, dan lebih patuh pada gaya rumah yang diberikan. Rilis ini menyertakan contoh penjelasan bug secara berdampingan, dan versi Opus 5.5 terasa lebih singkat dan langsung memaparkan akar masalah alih-alih membangun narasi panjang sebelumnya.
Hasil Benchmark Claude Opus 5.5
Begini perbandingan Opus 5.5 dengan Fable 5.1, Opus 5, dan para pesaingnya, menurut rilis Anthropic.
Beberapa hal menonjol. Opus 5.5 mengungguli Fable 5.1 pada setiap benchmark yang ditampilkan di sini, yang patut dicatat mengingat Anthropic memosisikan 5.5 sebagai "kinerja setara Fable, lebih murah" alih-alih peningkatan langsung. Menurut saya, Anthropic tidak menyoroti hal ini karena mereka ingin melindungi struktur tier mereka. Maksudnya: Anthropic menjual Fable sebagai produk premium di puncak lini. Jika Opus 5.5 diketahui banyak mengalahkan Fable — yah, itu pertanyaan yang canggung bagi siapa pun yang membayar harga Fable.
Khusus pada koding agen, jaraknya atas Opus 5 besar di ketiga benchmark. Lompatan di CursorBench adalah peningkatan terbesar pada satu benchmark dalam tabel.
Pengecualian juga patut dicatat. GPT-6 Astra unggul tipis atas Opus 5.5 pada AutomationBench (alur kerja bisnis) dan Terminal-Bench-Science (riset ilmiah agen), dan dengan margin yang cukup jelas pada yang kedua. Jadi bisa dibilang Opus 5.5 masih tertinggal pada sebagian tugas alur kerja dunia nyata dan riset sains.
Tunggu, Bagaimana dengan "Mengatur Laju Frontier"?
Sekilas, tampilannya memang aneh. Beberapa hari setelah Amodei menyerukan perlambatan kemajuan AI, Anthropic merilis flagship baru.
Pandangan sinisnya: "mengatur laju frontier" tidak pernah benar-benar soal keselamatan. Lebih mudah menyerukan industri untuk melambat saat Anda memimpin, dan dari sisi pendapatan, Anthropic memang memimpin.
Namun dengan interpretasi lain, "mengatur laju frontier" mungkin bukan argumen melawan merilis model, melainkan argumen tentang jenis model apa yang dirilis. Dengan interpretasi itu, Opus 5.5 selaras dengan pesannya.
Anthropic mengatakan Opus 5.5 berkinerja kira-kira setara dengan Fable 5.1, model yang sudah ada. Batas atas kapabilitas tidak bergeser. Yang berubah adalah tingkat pekerjaan yang sama kini 40% lebih murah dan berjalan lebih dari 30% lebih cepat. Ia juga memiliki skor alignment internal yang lebih baik.
Harga Claude Opus 5.5
Mode cepat — berjalan hingga 2,5x — tersedia di Claude Code dan Claude Platform seharga $8 per sejuta token input dan $40 per sejuta token output.
Saya membuat bagan agar kita bisa melihat harga Claude Opus dari waktu ke waktu. Harganya semakin turun seiring waktu.
Yang Kita Ketahui tentang Cara Kerja Perlindungan Baru
Berikut yang kami ketahui dari catatan rilis:
Opus 5.5 mendapatkan kelas perlindungan yang sama yang disediakan Anthropic untuk Fable 5.1 pada tiga area yang ditandai: keamanan siber, biologi, dan distilasi.
Anthropic tidak merinci mekanisme deteksinya, tetapi hasilnya adalah langkah penyaringan yang berjalan pada permintaan masuk: sesuatu dalam prompt ditandai masuk ke salah satu dari tiga kategori itu, dan alih-alih permintaan diteruskan ke Opus 5.5, ia dialihkan sebelum dijawab. Misalnya, prompt yang ditandai keamanan siber dialihkan ke Opus 4.8 yang lebih lama, sementara prompt terkait biologi dinaikkan ke Opus 5. Jadi perlindungan ini bukan filter pada output — ini keputusan perutean yang dibuat sebelum generasi dimulai, dan model yang menangani permintaan bergantung pada kategori yang memicunya.
Anthropic juga menjalani evaluasi eksternal oleh METR dan Frontier Design sebelum rilis (detail tentang organisasi tersebut ada di FAQ), sehingga klaim keselamatannya mendapat verifikasi eksternal, bukan hanya pernyataan Anthropic sendiri.
Ketersediaan Claude Opus 5.5
Claude Opus 5.5 sudah tersedia di platform Anthropic sendiri serta Amazon Web Services, Google Cloud, dan Microsoft Azure. Pengembang di Claude Platform dapat mengaksesnya langsung sebagai
claude-opus-5-5.Kesimpulan
Claude Opus 5.5 menguntungkan pengguna. Lebih murah, lebih cepat, dan lebih aman daripada pendahulunya.
Aspek keselamatan adalah cerita yang lebih menarik dalam jangka panjang. Datang tepat setelah pidato Amodei tentang "mengatur laju frontier", tampilannya bisa saja buruk — model flagship baru, seminggu setelah seruan publik untuk melambat. Namun rilis ini, disengaja atau tidak, berhasil meniti garis itu: tidak ada kenaikan batas kapabilitas, dan Opus 5.5 hadir dengan tingkat perlindungan yang sama seperti yang sebelumnya hanya ada di Fable, serta tingkat upaya keluar dari sandbox yang secara bermakna lebih rendah dalam pengujian. Saya tidak tahu apakah itu wujud "mengatur laju frontier" dalam praktik atau hanya timing yang pas. Namun setidaknya konsisten dengan argumen yang disampaikan Amodei.