
Corso
Introduzione ai modelli Claude
3 ore
14.7K
Anthropic ha appena rilasciato Claude Opus 5.5, e la storia qui riguarda soprattutto economia e sicurezza. Il modello costa il 40% in meno da eseguire rispetto a Opus 5 (che a sua volta era uscito allo stesso prezzo del suo predecessore Opus 4.6, 4.7 e 4.8), genera output oltre il 30% più velocemente e registra i migliori punteggi mai misurati da Anthropic sulla sua suite interna di allineamento. In termini di prestazioni, si avvicina a Claude Fable 5.1 sulla maggior parte dei task, ma a una frazione del prezzo.
Ci aspettavamo un lancio questa settimana e stavamo seguendo le notizie da vicino. È la prima release dopo l’appello pubblico del CEO di Anthropic, Dario Amodei, a "regolare il passo sulla frontiera", ovvero mantenere il lavoro sulla sicurezza in vantaggio rispetto ai progressi di capacità, invece di correre per pubblicare il modello più potente possibile. A prima vista, potrebbe sembrare contraddittorio, ipocrita o incoerente rilasciare un nuovo modello una settimana dopo aver invocato un rallentamento dell’IA. Ma forse non è così incoerente dopotutto. Opus 5.5 non punta all’intelligenza bruta. Offre le stesse prestazioni, ma a un costo inferiore e con un allineamento più stretto.
Nel giro di poche ore, OpenAI ha risposto con i nuovi modelli Sol e Luna. Leggine di più nella nostra guida a GPT-6 Sol e Luna e nel nostro confronto pratico tra GPT-6 Sol e Claude Opus 5.5.
Claude Opus 5.5 è la prima release della nuova generazione "5.5" di Anthropic. Si colloca ora al vertice della gamma di modelli Anthropic. Le versioni Sonnet e Haiku sono attese nei prossimi giorni o settimane.
Opus 5.5 è pensato per gli stessi lavori impegnativi a cui i modelli Opus hanno sempre mirato: lunghe sessioni di coding agentico, ricerca e analisi complesse e workflow multi-step che devono reggere per molte ore senza deragliare.
La differenza questa volta: Opus 5.5 è una versione più snella ed efficiente di ciò che Opus 5 già faceva, cioè svolgere lavori comparabili con meno token per task. È qui che si concentrano gran parte dei guadagni in termini di costi e velocità.
Partiamo dai costi, visto che è davvero il punto principale.
Le letture della cache, che secondo Anthropic rappresentano la maggior parte dei costi di agentic e coding, scendono del 60%, da $0,50 a $0,20 per milione di token. Anche i token in input e output calano del 20%, e il modello genera output oltre il 30% più velocemente rispetto a Opus 5. Nella release, anche se meno in evidenza: Anthropic sta allentando i limiti di utilizzo di cinque ore sui piani Pro, Max e Team, e offre agli abbonati un reset del rate limit accumulabile che possono salvare e riutilizzare.
Anthropic afferma che i maggiori guadagni si vedono su task estesi e reali, piuttosto che su brevi benchmark. Un tester iniziale avrebbe completato una migrazione di 680.000 righe di codice in meno di un giorno — un lavoro che altrimenti avrebbe richiesto settimane a un team di ingegneri.
In un test interno in cui a Opus 5.5 è stato chiesto di ridurre i tempi di caricamento su ogni pagina di una web app, è riuscito nell’obiettivo 39 volte su 40, segno che il modello è anche coerente.
Anthropic mette in evidenza lo stile di scrittura come correzione a una delle lamentele più comuni su Opus 5: verbosità e gergo. Opus 5.5 è descritto come più diretto sulle informazioni importanti, con meno formulazioni idiosincratiche e più vicino allo stile editoriale indicato. La release include un esempio affiancato di spiegazione di un bug: la versione Opus 5.5 è visibilmente più breve e anticipa la causa radice invece di costruirci sopra per arrivarci.
Ecco come Opus 5.5 si confronta con Fable 5.1, Opus 5 e la concorrenza, secondo il comunicato di Anthropic.
| Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol | |
|---|---|---|---|---|---|
| Agentic coding — Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| Agentic coding — FrontierCode v1.1 (Main) | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| Agentic coding — CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| Lavoro di conoscenza — GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| Workflow aziendali — AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Ragionamento multidisciplinare — Humanity's Last Exam (con strumenti) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Ricerca scientifica agentica — Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| Uso del computer — OSWorld 2.0 (parziale) | 81,8% | 80,7% | 74,0% | — | — |
| Riconoscimento di grafici — Chartography (con strumenti) | 89,0% | 88,4% | 83,4% | — | — |
Alcune cose saltano all’occhio. Opus 5.5 batte Fable 5.1 in ogni benchmark mostrato qui, notevole considerando che Anthropic ha presentato la 5.5 come "prestazioni al livello di Fable, a meno" piuttosto che un upgrade diretto. Penso che Anthropic non lo sottolinei perché vuole proteggere la struttura dei livelli. Cioè: Anthropic vende Fable a un prezzo premium come top di gamma. Se si sa troppo che Opus 5.5 batte Fable — beh, è una domanda scomoda per chi paga i prezzi di Fable.
Sull’agentic coding in particolare, il distacco rispetto a Opus 5 è ampio su tutti e tre i benchmark. Il salto su CursorBench è il miglioramento più grande su un singolo benchmark nella tabella.
Vale la pena segnalare anche le eccezioni. GPT-6 Astra supera di poco Opus 5.5 sia su AutomationBench (workflow aziendali) sia su Terminal-Bench-Science (ricerca scientifica agentica), e con un margine abbastanza netto sul secondo. Si potrebbe quindi dire che Opus 5.5 resta indietro su alcuni task reali di workflow e ricerca scientifica.
All’inizio, l’effetto ottico sembrava strano. Pochi giorni dopo che Amodei ha chiesto di rallentare il progresso dell’IA, Anthropic ha pubblicato un nuovo flagship.
Una lettura cinica è che "regolare il passo sulla frontiera" non riguardasse affatto la sicurezza. È più facile chiedere all’industria di rallentare quando sei in testa e, per ricavi, Anthropic è in testa.
Ma in un’altra interpretazione, "regolare il passo sulla frontiera" potrebbe non essere mai stato un argomento contro il rilascio dei modelli, bensì una tesi sul tipo di modelli da rilasciare. In questa lettura, Opus 5.5 è coerente con il messaggio.
Anthropic dice che Opus 5.5 si comporta grossomodo al livello di Fable 5.1, un modello che già esisteva. Il soffitto delle capacità non si è alzato. È cambiato che lo stesso livello di lavoro ora costa il 40% in meno e gira oltre il 30% più veloce. Ha anche punteggi di allineamento interni migliori.
| Per 1M token | Opus 5.5 | Opus 5 |
|---|---|---|
| Input | $4 | $5 |
| Output | $20 | $25 |
| Letture cache | $0,20 | $0,50 |
| Scritture cache | $5 | $6,25 |
La modalità Fast — fino a 2,5x di velocità — è disponibile in Claude Code e sulla Claude Platform a $8 per milione di token in input e $40 per milione di token in output.
Ho creato un grafico per vedere l’andamento dei prezzi di Claude Opus nel tempo. Si è fatto meno costoso nel tempo.
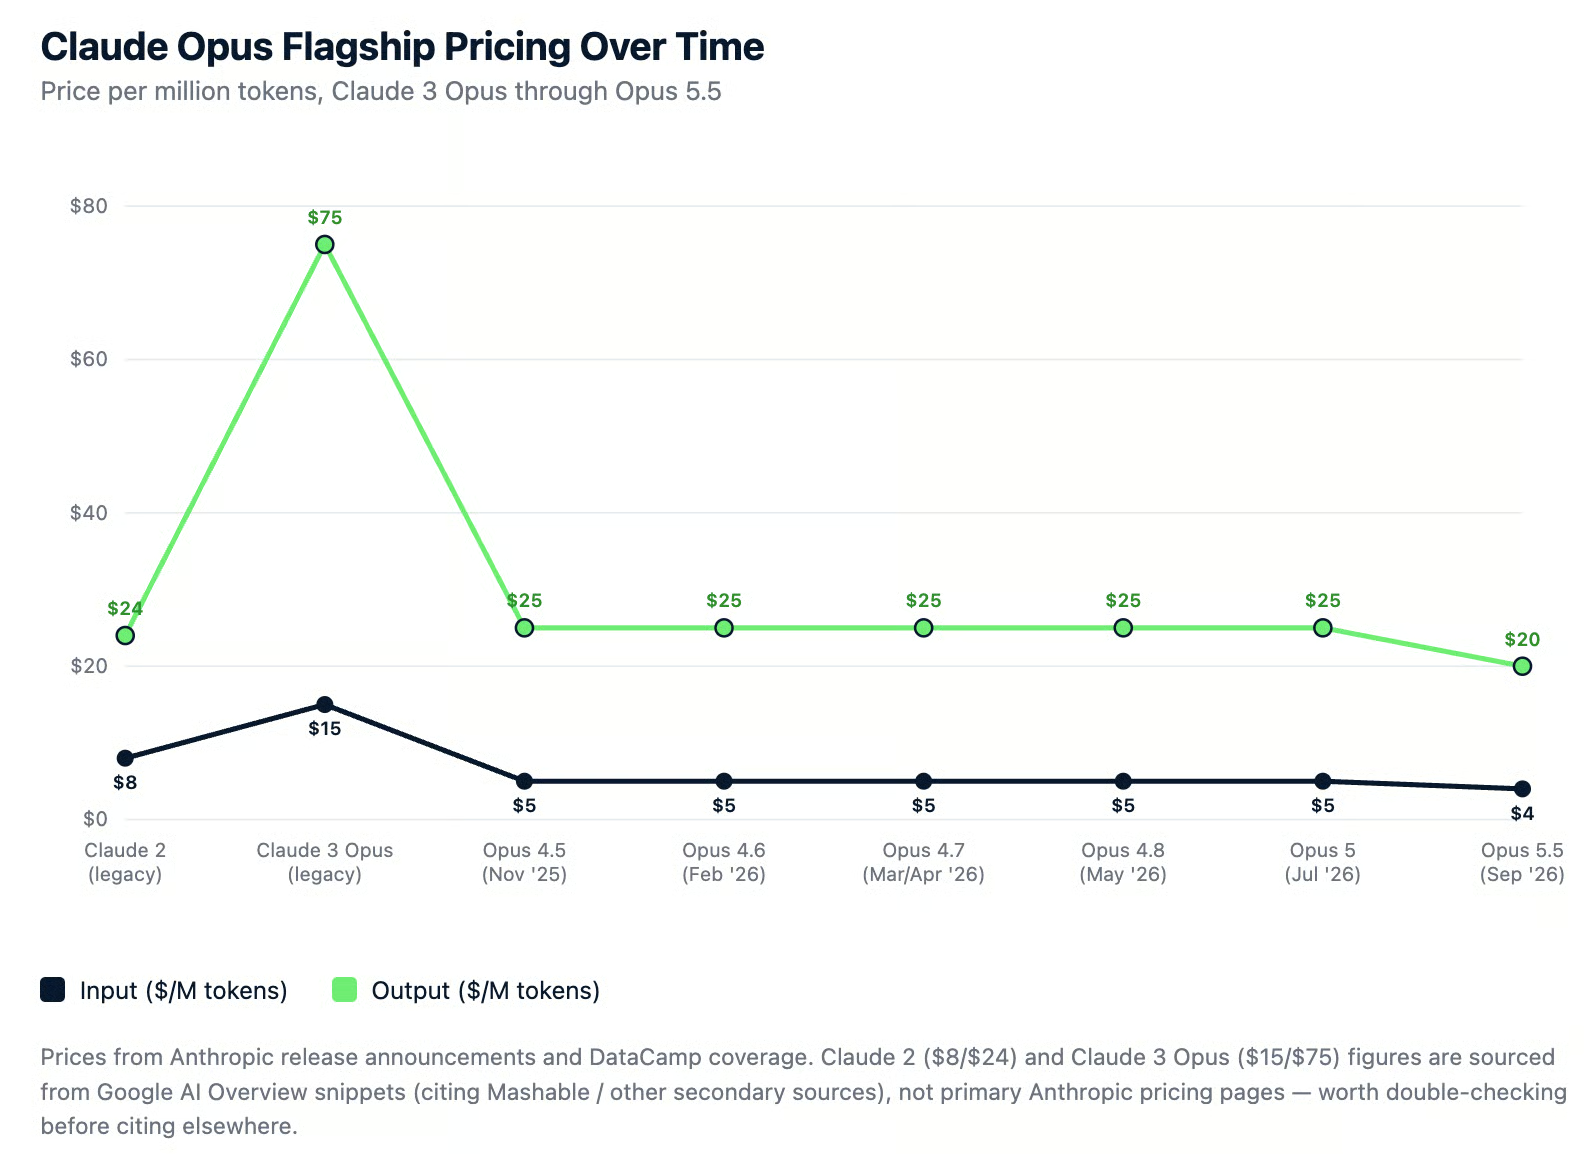
Ecco cosa sappiamo dalle note di rilascio:
Opus 5.5 ottiene la stessa classe di misure protettive che Anthropic riserva a Fable 5.1 in tre aree sensibili: cybersecurity, biologia e distillazione.
Anthropic non dettaglia il meccanismo di rilevamento in sé, ma il risultato è uno step di screening che si attiva sulle richieste in arrivo: qualcosa nel prompt viene segnalato come rientrante in una di queste tre categorie e, invece di inviare la richiesta a Opus 5.5, questa viene reindirizzata prima di ricevere risposta. Per esempio, un prompt segnalato per cybersecurity viene dirottato verso il vecchio Opus 4.8, mentre un prompt relativo alla biologia viene dirottato verso Opus 5. Quindi la salvaguardia non è un filtro sull’output — è una decisione di instradamento presa prima che inizi la generazione, e quale modello gestisce la richiesta dipende da quale categoria l’ha fatta scattare.
Anthropic ha anche fatto valutare esternamente il modello da METR e Frontier Design prima del rilascio (dettagli su cosa sono queste organizzazioni nelle FAQ), dando alle sue affermazioni sulla sicurezza una verifica esterna e non solo la propria parola.
Claude Opus 5.5 è già disponibile sulle piattaforme di Anthropic e su Amazon Web Services, Google Cloud e Microsoft Azure. Gli sviluppatori sulla Claude Platform possono accedervi direttamente come claude-opus-5-5.
Claude Opus 5.5 è una buona notizia per chi lo usa. È più economico, più veloce e più sicuro del suo predecessore.
L’aspetto sicurezza è la storia più interessante nel lungo periodo. Subito dopo i discorsi di Amodei sul "regolare il passo sulla frontiera", l’effetto ottico poteva essere negativo — un nuovo modello di punta, una settimana dopo un appello pubblico al rallentamento. Ma la release, volutamente o no, riesce a tenere insieme i due aspetti: il soffitto delle capacità non è stato alzato, e Opus 5.5 arriva con lo stesso livello di salvaguardie prima riservate a Fable, e con un tasso significativamente più basso di tentativi di fuga dalla sandbox nei test. Non so se questo sia "regolare il passo sulla frontiera" in pratica o solo tempismo fortunato. Ma è almeno coerente con l’argomentazione di Amodei.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min



