Anthropic vient de lancer Claude Opus 5.5, et l’enjeu est clairement économique et sécuritaire. Le modèle coûte 40 % moins cher à faire tourner que Opus 5 (lui-même sorti au même prix que ses prédécesseurs Opus 4.6, 4.7 et 4.8), génère des résultats plus de 30 % plus vite et affiche les meilleurs scores qu’Anthropic ait mesurés sur sa batterie interne d’alignement. Côté performances, il se place au niveau de Claude Fable 5.1 sur la plupart des tâches, mais pour une fraction du prix.
Nous anticipions une sortie cette semaine et suivions l’actualité de près. C’est la première version depuis l’appel public du CEO d’Anthropic, Dario Amodei, à « ralentir la frontière », c’est-à-dire à faire passer le travail sur la sécurité avant les gains de capacité plutôt que de courir vers le modèle le plus puissant possible. Publier un nouveau modèle une semaine après avoir appelé à freiner l’IA peut sembler contradictoire, voire hypocrite, au premier abord. Mais ce n’est peut-être pas si incohérent. Opus 5.5 n’a pas pour objet de repousser le plafond d’intelligence : il vise la même performance, à moindre coût et avec un alignement plus strict.
Quelques heures plus tard, OpenAI a répondu avec ses nouveaux modèles Sol et Luna. À lire dans notre guide GPT-6 Sol et Luna et notre comparatif pratique entre GPT-6 Sol et Claude Opus 5.5.
Qu’est-ce que Claude Opus 5.5 ?
Claude Opus 5.5 est la première sortie de la nouvelle génération « 5.5 » d’Anthropic. Il prend désormais la tête de la gamme de modèles Anthropic. Des versions Sonnet et Haiku sont attendues dans les prochains jours ou semaines.
Opus 5.5 vise les mêmes missions exigeantes que les modèles Opus ciblent depuis toujours : longues sessions de code agentique, recherche et analyse complexes, et chaînes de tâches multiétapes qui doivent tenir la distance pendant des heures sans dériver.
La différence cette fois-ci : Opus 5.5 est une version plus économe et plus efficiente de ce que faisait déjà Opus 5, capable d’accomplir un travail comparable avec moins de jetons par tâche — c’est là que se jouent l’essentiel des gains de coût et de vitesse.
Quoi de neuf avec Claude Opus 5.5 ?
Commençons par les coûts, car c’est le principal enseignement.
Vraiment plus abordable et plus rapide
Les lectures de cache, qui représentent selon Anthropic la majeure partie des coûts liés aux agents et au code, baissent de 60 %, de 0,50 $ à 0,20 $ par million de jetons. Les jetons en entrée et en sortie diminuent aussi de 20 %, et le modèle génère des réponses plus de 30 % plus vite qu’Opus 5. Également au programme, mais moins mis en avant : Anthropic assouplit les limites d’usage de cinq heures sur les offres Pro, Max et Team, et offre aux abonnés une remise à zéro de seuil de requêtes « bancable » qu’ils peuvent conserver et réutiliser.
Anthropic indique que les plus grands gains apparaissent sur des tâches étalées et réalistes, plutôt que sur de courts benchmarks. Un testeur précoce aurait réussi une migration de 680 000 lignes de code en moins d’une journée — un travail qui aurait sinon pris des semaines à une équipe d’ingénierie.
Dans un test interne où Opus 5.5 devait réduire les temps de chargement de chaque page d’une application web, il a réussi 39 fois sur 40, ce qui montre aussi sa régularité.
Une communication plus claire
Anthropic met en avant le style d’écriture comme réponse à l’une des critiques fréquentes d’Opus 5 : la verbosité et le jargon. Opus 5.5 est décrit comme allant droit à l’essentiel, avec moins de tournures idiosyncratiques, et une meilleure adhérence à la charte éditoriale fournie. La version inclut un exemple comparatif d’explication de bug : la réponse d’Opus 5.5 est nettement plus courte et met d’entrée la cause racine, au lieu d’y mener progressivement.
Résultats des benchmarks de Claude Opus 5.5
Voici comment Opus 5.5 se compare à Fable 5.1, Opus 5 et à la concurrence, d’après la communication d’Anthropic.
| | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|
| Code agentique — Terminal-Bench 4.0 | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| Code agentique — FrontierCode v1.1 (Main) | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| Code agentique — CursorBench 4.0 | 57,8 % | 51,8 % | 46,6 % | — | 41,7 % |
| Travail de connaissance — GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| Flux métiers — AutomationBench | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Raisonnement pluridisciplinaire — Humanity's Last Exam (avec outils) | 67,7 % | 65,6 % | 63,6 % | 57,2 % | — |
| Recherche scientifique agentique — Terminal-Bench-Science 0.1 | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| Utilisation d’ordinateur — OSWorld 2.0 (partiel) | 81,8 % | 80,7 % | 74,0 % | — | — |
| Reconnaissance de graphiques — Chartography (avec outils) | 89,0 % | 88,4 % | 83,4 % | — | — |
Plusieurs points sautent aux yeux. Opus 5.5 dépasse Fable 5.1 sur chaque benchmark présenté ici, ce qui est notable alors qu’Anthropic positionne 5.5 comme « des performances de niveau Fable, pour moins cher » plutôt que comme une montée en gamme nette. À mon avis, Anthropic ne le souligne pas pour protéger sa segmentation. En clair : Fable est vendu comme le haut de gamme à un tarif premium. Si Opus 5.5 est perçu comme supérieur à Fable, la question devient délicate pour ceux qui paient le prix Fable.
Sur le code agentique en particulier, l’écart avec Opus 5 est important sur les trois benchmarks. Le bond sur CursorBench est la plus forte progression sur un benchmark unique du tableau.
Les exceptions méritent aussi d’être notées. GPT-6 Astra devance Opus 5.5 sur AutomationBench (flux métiers) et Terminal-Bench-Science (recherche scientifique agentique), avec un avantage net sur le second. On peut donc dire qu’Opus 5.5 reste derrière sur certains cas d’usage réalistes en workflows et recherche scientifique.
Et l’idée de « ralentir la frontière », alors ?
L’image pouvait effectivement surprendre au départ. Quelques jours après l’appel d’Amodei à ralentir les progrès de l’IA, Anthropic lance un nouveau fleuron.
Une lecture cynique voudrait que « ralentir la frontière » n’ait jamais été une question de sécurité. Il est plus facile d’appeler l’industrie à lever le pied quand on est en tête et, en termes de revenus, Anthropic est en tête.
Mais on peut aussi l’interpréter autrement : « ralentir la frontière » ne s’oppose pas à publier de nouveaux modèles, mais oriente le type de modèles à publier. Dans cette lecture, Opus 5.5 est cohérent avec le message.
Anthropic affirme qu’Opus 5.5 opère à peu près au niveau de Fable 5.1, un modèle déjà existant. Le plafond de capacité n’a pas bougé. Ce qui change, c’est que le même niveau de travail coûte désormais 40 % de moins et s’exécute plus de 30 % plus vite. Il présente aussi de meilleurs scores d’alignement interne.
Tarification de Claude Opus 5.5
| Pour 1 M de jetons | Opus 5.5 | Opus 5 |
|---|
| Entrée | 4 $ | 5 $ |
| Sortie | 20 $ | 25 $ |
| Lectures de cache | 0,20 $ | 0,50 $ |
| Écritures de cache | 5 $ | 6,25 $ |
Le mode rapide — jusqu’à 2,5× plus vite — est disponible dans Claude Code et sur Claude Platform à 8 $ par million de jetons en entrée et 40 $ par million de jetons en sortie.
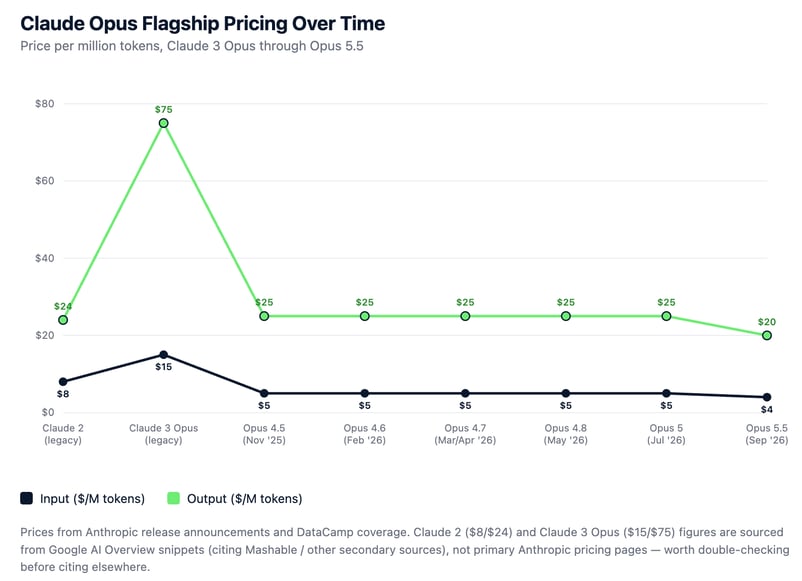
J’ai créé un graphique pour visualiser l’évolution des tarifs de Claude Opus dans le temps. Les prix ont baissé au fil des versions.
Ce que nous savons du fonctionnement des nouvelles protections
Voici ce qui ressort des notes de version :
Opus 5.5 bénéficie de la même classe de mesures de protection qu’Anthropic réserve à Fable 5.1 dans trois domaines sensibles : cybersécurité, biologie et distillation.
Anthropic ne détaille pas le mécanisme de détection lui-même, mais le résultat est une étape de filtrage à l’arrivée des requêtes : si un élément du prompt est repéré dans l’une de ces trois catégories, au lieu d’être envoyé à Opus 5.5, il est redirigé avant réponse. Par exemple, un prompt marqué cybersécurité descend vers l’ancien Opus 4.8, tandis qu’un prompt lié à la biologie est élevé vers Opus 5. La protection n’est donc pas un simple filtre de sortie : c’est une décision de routage prise avant la génération, et le modèle choisi dépend de la catégorie déclenchée.
Anthropic a également fait évaluer le modèle en externe par METR et Frontier Design avant la sortie (détails sur ces organisations dans la FAQ), offrant ainsi une vérification indépendante de ses affirmations en matière de sécurité.
Disponibilité de Claude Opus 5.5
Claude Opus 5.5 est désormais disponible sur les plateformes d’Anthropic ainsi que sur Amazon Web Services, Google Cloud et Microsoft Azure. Les développeurs sur Claude Platform peuvent y accéder directement via claude-opus-5-5.
Conclusion
Claude Opus 5.5 est une excellente nouvelle pour les utilisateurs. Il est plus abordable, plus rapide et plus sûr que son prédécesseur.
L’angle sécurité est sans doute le plus intéressant sur le long terme. Publié juste après les interventions d’Amodei sur le « ralentissement de la frontière », le timing aurait pu prêter à confusion : un nouveau fleuron, une semaine après un appel public à lever le pied. Mais la sortie, volontairement ou non, réconcilie les deux : aucun plafond de capacité n’a été relevé, Opus 5.5 embarque le même niveau de protections auparavant réservé à Fable, et réduit sensiblement les tentatives d’évasion de bac à sable lors des tests. Est-ce là une mise en pratique de « ralentir la frontière » ou juste un bon alignement des astres ? Difficile à dire, mais c’est cohérent avec l’argument d’Amodei.






Anthropic vient de lancer Claude Opus 5.5, et l’enjeu est clairement économique et sécuritaire. Le modèle coûte 40 % moins cher à faire tourner que Opus 5 (lui-même sorti au même prix que ses prédécesseurs Opus 4.6, 4.7 et 4.8), génère des résultats plus de 30 % plus vite et affiche les meilleurs scores qu’Anthropic ait mesurés sur sa batterie interne d’alignement. Côté performances, il se place au niveau de Claude Fable 5.1 sur la plupart des tâches, mais pour une fraction du prix.
Nous anticipions une sortie cette semaine et suivions l’actualité de près. C’est la première version depuis l’appel public du CEO d’Anthropic, Dario Amodei, à « ralentir la frontière », c’est-à-dire à faire passer le travail sur la sécurité avant les gains de capacité plutôt que de courir vers le modèle le plus puissant possible. Publier un nouveau modèle une semaine après avoir appelé à freiner l’IA peut sembler contradictoire, voire hypocrite, au premier abord. Mais ce n’est peut-être pas si incohérent. Opus 5.5 n’a pas pour objet de repousser le plafond d’intelligence : il vise la même performance, à moindre coût et avec un alignement plus strict.
Quelques heures plus tard, OpenAI a répondu avec ses nouveaux modèles Sol et Luna. À lire dans notre guide GPT-6 Sol et Luna et notre comparatif pratique entre GPT-6 Sol et Claude Opus 5.5.
Qu’est-ce que Claude Opus 5.5 ?
Claude Opus 5.5 est la première sortie de la nouvelle génération « 5.5 » d’Anthropic. Il prend désormais la tête de la gamme de modèles Anthropic. Des versions Sonnet et Haiku sont attendues dans les prochains jours ou semaines.
Opus 5.5 vise les mêmes missions exigeantes que les modèles Opus ciblent depuis toujours : longues sessions de code agentique, recherche et analyse complexes, et chaînes de tâches multiétapes qui doivent tenir la distance pendant des heures sans dériver.
La différence cette fois-ci : Opus 5.5 est une version plus économe et plus efficiente de ce que faisait déjà Opus 5, capable d’accomplir un travail comparable avec moins de jetons par tâche — c’est là que se jouent l’essentiel des gains de coût et de vitesse.
Quoi de neuf avec Claude Opus 5.5 ?
Commençons par les coûts, car c’est le principal enseignement.
Vraiment plus abordable et plus rapide
Les lectures de cache, qui représentent selon Anthropic la majeure partie des coûts liés aux agents et au code, baissent de 60 %, de 0,50 $ à 0,20 $ par million de jetons. Les jetons en entrée et en sortie diminuent aussi de 20 %, et le modèle génère des réponses plus de 30 % plus vite qu’Opus 5. Également au programme, mais moins mis en avant : Anthropic assouplit les limites d’usage de cinq heures sur les offres Pro, Max et Team, et offre aux abonnés une remise à zéro de seuil de requêtes « bancable » qu’ils peuvent conserver et réutiliser.
Des performances qui se voient surtout sur les tâches longues et complexes
Anthropic indique que les plus grands gains apparaissent sur des tâches étalées et réalistes, plutôt que sur de courts benchmarks. Un testeur précoce aurait réussi une migration de 680 000 lignes de code en moins d’une journée — un travail qui aurait sinon pris des semaines à une équipe d’ingénierie.
Dans un test interne où Opus 5.5 devait réduire les temps de chargement de chaque page d’une application web, il a réussi 39 fois sur 40, ce qui montre aussi sa régularité.
Une communication plus claire
Anthropic met en avant le style d’écriture comme réponse à l’une des critiques fréquentes d’Opus 5 : la verbosité et le jargon. Opus 5.5 est décrit comme allant droit à l’essentiel, avec moins de tournures idiosyncratiques, et une meilleure adhérence à la charte éditoriale fournie. La version inclut un exemple comparatif d’explication de bug : la réponse d’Opus 5.5 est nettement plus courte et met d’entrée la cause racine, au lieu d’y mener progressivement.
Résultats des benchmarks de Claude Opus 5.5
Voici comment Opus 5.5 se compare à Fable 5.1, Opus 5 et à la concurrence, d’après la communication d’Anthropic.
Plusieurs points sautent aux yeux. Opus 5.5 dépasse Fable 5.1 sur chaque benchmark présenté ici, ce qui est notable alors qu’Anthropic positionne 5.5 comme « des performances de niveau Fable, pour moins cher » plutôt que comme une montée en gamme nette. À mon avis, Anthropic ne le souligne pas pour protéger sa segmentation. En clair : Fable est vendu comme le haut de gamme à un tarif premium. Si Opus 5.5 est perçu comme supérieur à Fable, la question devient délicate pour ceux qui paient le prix Fable.
Sur le code agentique en particulier, l’écart avec Opus 5 est important sur les trois benchmarks. Le bond sur CursorBench est la plus forte progression sur un benchmark unique du tableau.
Les exceptions méritent aussi d’être notées. GPT-6 Astra devance Opus 5.5 sur AutomationBench (flux métiers) et Terminal-Bench-Science (recherche scientifique agentique), avec un avantage net sur le second. On peut donc dire qu’Opus 5.5 reste derrière sur certains cas d’usage réalistes en workflows et recherche scientifique.
Et l’idée de « ralentir la frontière », alors ?
L’image pouvait effectivement surprendre au départ. Quelques jours après l’appel d’Amodei à ralentir les progrès de l’IA, Anthropic lance un nouveau fleuron.
Une lecture cynique voudrait que « ralentir la frontière » n’ait jamais été une question de sécurité. Il est plus facile d’appeler l’industrie à lever le pied quand on est en tête et, en termes de revenus, Anthropic est en tête.
Mais on peut aussi l’interpréter autrement : « ralentir la frontière » ne s’oppose pas à publier de nouveaux modèles, mais oriente le type de modèles à publier. Dans cette lecture, Opus 5.5 est cohérent avec le message.
Anthropic affirme qu’Opus 5.5 opère à peu près au niveau de Fable 5.1, un modèle déjà existant. Le plafond de capacité n’a pas bougé. Ce qui change, c’est que le même niveau de travail coûte désormais 40 % de moins et s’exécute plus de 30 % plus vite. Il présente aussi de meilleurs scores d’alignement interne.
Tarification de Claude Opus 5.5
Le mode rapide — jusqu’à 2,5× plus vite — est disponible dans Claude Code et sur Claude Platform à 8 $ par million de jetons en entrée et 40 $ par million de jetons en sortie.
J’ai créé un graphique pour visualiser l’évolution des tarifs de Claude Opus dans le temps. Les prix ont baissé au fil des versions.
Ce que nous savons du fonctionnement des nouvelles protections
Voici ce qui ressort des notes de version :
Opus 5.5 bénéficie de la même classe de mesures de protection qu’Anthropic réserve à Fable 5.1 dans trois domaines sensibles : cybersécurité, biologie et distillation.
Anthropic ne détaille pas le mécanisme de détection lui-même, mais le résultat est une étape de filtrage à l’arrivée des requêtes : si un élément du prompt est repéré dans l’une de ces trois catégories, au lieu d’être envoyé à Opus 5.5, il est redirigé avant réponse. Par exemple, un prompt marqué cybersécurité descend vers l’ancien Opus 4.8, tandis qu’un prompt lié à la biologie est élevé vers Opus 5. La protection n’est donc pas un simple filtre de sortie : c’est une décision de routage prise avant la génération, et le modèle choisi dépend de la catégorie déclenchée.
Anthropic a également fait évaluer le modèle en externe par METR et Frontier Design avant la sortie (détails sur ces organisations dans la FAQ), offrant ainsi une vérification indépendante de ses affirmations en matière de sécurité.
Disponibilité de Claude Opus 5.5
Claude Opus 5.5 est désormais disponible sur les plateformes d’Anthropic ainsi que sur Amazon Web Services, Google Cloud et Microsoft Azure. Les développeurs sur Claude Platform peuvent y accéder directement via
claude-opus-5-5.Conclusion
Claude Opus 5.5 est une excellente nouvelle pour les utilisateurs. Il est plus abordable, plus rapide et plus sûr que son prédécesseur.
L’angle sécurité est sans doute le plus intéressant sur le long terme. Publié juste après les interventions d’Amodei sur le « ralentissement de la frontière », le timing aurait pu prêter à confusion : un nouveau fleuron, une semaine après un appel public à lever le pied. Mais la sortie, volontairement ou non, réconcilie les deux : aucun plafond de capacité n’a été relevé, Opus 5.5 embarque le même niveau de protections auparavant réservé à Fable, et réduit sensiblement les tentatives d’évasion de bac à sable lors des tests. Est-ce là une mise en pratique de « ralentir la frontière » ou juste un bon alignement des astres ? Difficile à dire, mais c’est cohérent avec l’argument d’Amodei.