下一个方块的预览显示的是四方块的字母 — O、I、T、S、Z — 而非绘制出形状。熟悉记法后当然能看懂,但每次扫一眼都要停顿一拍,在速度上这会有影响。提示中并未要求任何预览,这是 Sol 主动添加却略显不足的一个点。也是唯一一个更精致的构建在可读性上反而略逊的地方。
Claude Opus 5.5 的产物
Opus 5.5 用了 3 个回合与 2 次工具调用(一次通配读取、一次写入),交付了一个 19 KB 的 index.html,名为“Flip Tetris”。其头部注释在两者中更为严谨:固定种子的 7-袋随机、带墙踢的旋转、按堆叠侧各自消行,并注明当引力翻转时,下落中的方块仅反转方向。
游戏如描述般运作,且与 Sol 一样稳定,带有幽灵影子与在翻转前变红的倒计时条。它的下一个方块预览绘制实际形状,这是更好的选择,也是相较 Sol 在“扫一眼即可获取信息”层面做得更好的唯一一点。
它还加了一个没人要求的关卡计数,我认为这不算加分:关卡上升很慢,实际影响要到远超这两个构建的常见游玩深度才显现。Opus 失分更多在手感而非逻辑:布局较为素朴,软降落不够顺滑,因此在视觉与手感上丢 1 分,在完整性上也丢 1 分。
结果
| 指标 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| 回合数 | 6 | 3 |
| 工具调用 | 9 | 2 |
| 成本 | $0.26 | $0.87 |
| 总 tokens | 120,226 | 107,958 |
| 推理 tokens | 8,123 | 22,551 |
| 可运行性 | 通过 | 通过 |
| 翻转机制 | 5 | 5 |
| 游戏完整性 | 5 | 4 |
| 视觉与手感 | 5 | 4 |
| 评分(3 轴均值) | 5 | 4.3 |
GPT-6 Sol 在这次测试中取胜,但优势不在难点上。两者都正确实现了引力翻转,因此差距落在打磨程度上,而 Sol 的响应性与视觉精致度让它略胜一筹。
两者差异更明显的是成本。Opus 5.5 花了 $0.87,而 Sol 仅 $0.26,超过三倍差距,且前者用的总 tokens 还更少:108k vs 120k。区别在于推理:Opus 每回合的思考强度大约是对方的三倍,用一半回合达到正确构建后即收手;Sol 则在文件内迭代,成本低,且在手感上略微更优。
这只是一次任务、一个努力度的单轮结果,且测试的是单文件的游戏循环逻辑,并非两家所强调的长周期仓库级工作。成本数字各只有一个样本点,并非均值。
何时选择 GPT-6 Sol 或 Claude Opus 5.5
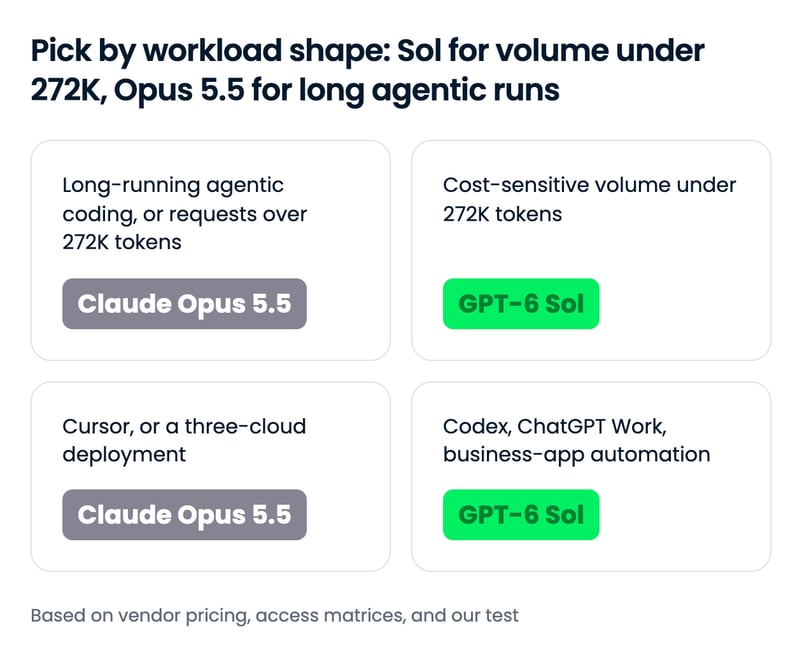
分叉点在于请求大小与工作负载形态,而非裸性能:单次请求低于 272K tokens 时,Sol 的折扣是真实的;高于该值,或在重度缓存循环中,两者账单逐渐靠拢,此时您为 Opus 5.5 所付出的,是其在代理式工作上已公布的领先成绩。
在以下情形选择 GPT-6 Sol…
- 您运行高并发代理,且每次请求都低于长上下文阈值。标价砍半在数百万次请求中会被无限放大,且缓存读取价格本就一致。
- 您的团队已在使用 Codex 或 ChatGPT Work。Sol 在所有付费方案中均可用,且 Codex 正是 OpenAI 为其调校的载体。
- 您要在预算内自动化业务工作流。Sol 的 AutomationBench 单任务成本为 $0.27,OpenAI 的单任务成本论据最具说服力。
- 您需要从最低到最高的努力度阶梯。Sol 的
none设置与不破坏缓存的努力度切换,让代理能以低成本跑后续步骤,只在难点上再抬杠杆。
在以下情形选择 Claude Opus 5.5…
- 您的核心工作是长时间运行的代理式编码:迁移、审计与多仓库任务。Opus 5.5 在其报告的每项代理式编码基准上都更强,且测试者案例多为以小时计的长作业。
- 您的请求经常超过 Sol 的长上下文阈值。Anthropic 对完整的 100 万窗口按标准费率计费,而 Sol 的附加费会在该规模上抹平大部分价格差。
- 您需要立刻在 Cursor 或三大超大规模云上可用。Opus 5.5 已出现在 Cursor,以及 Bedrock、Vertex AI 与 Microsoft Foundry;Sol 尚未在 Cursor 与 Vertex AI 上架。
- 您运行无人值守代理并偏好更保守的模型。Anthropic 的隔离评测与 Fable 级护栏正是为此而设,前提是您的工作不涉及网络安全。
如何开始使用 GPT-6 Sol 与 Claude Opus 5.5
| 接入面 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| 消费级应用 | ChatGPT Work 与 Codex(Plus、Pro、Business、Enterprise、Edu);尚未进入 ChatGPT 的聊天 | Claude 应用;发布时 Pro、Max、Team、Enterprise 提升限额 |
| 一方 API | 是,OpenAI API(推荐 Responses API) | 是,Claude API |
| 云平台 | Azure AI Foundry、AWS Bedrock | AWS Bedrock、Google Cloud Vertex AI、Microsoft Foundry |
| 编码代理 | Codex、GitHub Copilot | Claude Code、Cursor、GitHub Copilot |
| 第三方路由 | OpenRouter、Vercel AI Gateway | OpenRouter、Vercel AI Gateway |
| API 模型 ID | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 在首日即登陆三大云与 Cursor,而 Sol 目前上了两家云,且未出现在 Cursor 的模型列表中。API 上,两者的字符串分别是 gpt-6-sol 与 claude-opus-5-5。
在编码代理中使用 GPT-6 Sol 与 Claude Opus 5.5
各自的模型都封装在自家代理中:Sol 对应 Codex,Opus 5.5 对应 Claude Code,且两者都可在 GitHub Copilot 中选择。若您想用同一套框架跑两者,OpenCode 这类由路由器支撑的代理可通过 OpenRouter 访问,模型名为 openai/gpt-6-sol 与 anthropic/claude-opus-5.5,我们的测试正是以此在相同工具面下运行的。
直接调用 API 则需不同 SDK,因此切换的是客户端与模型字符串,而非一行替换:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)关于完整的代理搭建,我们的《Codex CLI 教程》与《Claude Code 教程》介绍了安装与工作流,另有《Codex vs Claude Code 对比》权衡两种载体本身。
结语
若您的工作负载是长时间的代理式编码,或请求会越过长上下文阈值,使用 Claude Opus 5.5:它公布的代理式数据更强,且其定价不会惩罚大型请求。若您的量大且低于该阈值、日常在 Codex 或 ChatGPT Work、或要在预算内自动化业务应用,使用 GPT-6 Sol 并把省下的预算留作它用。
更有意思的是,双方都没能把对方的新模型纳入自家表格,而在我们唯一能亲自对照的自包含构建里,更便宜的那款在打磨度上反而胜出。
若您想用任一模型上手构建,推荐我们的《Working with the OpenAI API》与《Introduction to Claude Models》课程。
常见问题
什么时候该用 GPT-6 Sol 而不是 Claude Opus 5.5?
当您的请求低于 272K 输入 tokens 且量级重要时,使用 GPT-6 Sol:其标价为每 100 万输入 tokens $2、输出 $10,正好是 Claude Opus 5.5($4 与 $20)的一半。若您的团队在 Codex 或 ChatGPT Work 中工作,Sol 也更自然。若是长时间运行的代理式编码、请求超过 272K tokens,或需要模型立刻用于 Cursor 或三大云平台,则选择 Opus 5.5。
GPT-6 Sol 比 Claude Opus 5.5 便宜多少?
按标价,Claude Opus 5.5 在输入($4 vs $2/100 万 tokens)、输出($20 vs $10)与缓存写入($5 vs $2.50)上均为 GPT-6 Sol 的两倍。缓存读取两者同为每 100 万 tokens $0.20。Sol 对超过 272K 输入 tokens 的请求收取 2 倍输入与 1.5 倍输出的溢价,而 Anthropic 对完整 100 万上下文按标准费率计费,因此在长上下文检索上差距收窄至约 8%,在重度缓存的代理循环上约为 33%。
GPT-6 Sol 与 Claude Opus 5.5 的 API 模型 ID 是什么?
在 OpenAI API 上,GPT-6 Sol 的型号为 gpt-6-sol。在 Claude API 上,Claude Opus 5.5 的型号为 claude-opus-5-5,在 Amazon Bedrock 上为 anthropic.claude-opus-5-5。通过 OpenRouter,二者分别为 openai/gpt-6-sol 与 anthropic/claude-opus-5.5。
我可以在哪里使用 GPT-6 Sol 与 Claude Opus 5.5?
GPT-6 Sol 可在 ChatGPT Work 与 Codex(Plus、Pro、Business、Enterprise、Edu 用户)中使用,也可通过 OpenAI API、在 Azure AI Foundry 与 AWS Bedrock、在 GitHub Copilot,以及通过 OpenRouter 访问;尚未在 ChatGPT 的消费者聊天中提供。Claude Opus 5.5 可在 Claude 应用、Claude API、AWS Bedrock、Google Cloud Vertex AI、Microsoft Foundry、以及 Claude Code、Cursor 与 GitHub Copilot 中使用。
哪一个更适合编码,GPT-6 Sol 还是 Claude Opus 5.5?
在已公布的基准上,Claude Opus 5.5 领先:Anthropic 报告其在 Terminal-Bench 4.0 为 66.4%、在 FrontierCode 为 54.4%;OpenAI 则称 GPT-6 Sol 在 FrontierCode 上与 Claude Fable 5.1 持平,而 Anthropic 给 Fable 5.1 的分数为 50.3%。在我们的上手测试中,一个带引力翻转的单文件俄罗斯方块克隆,两者逻辑都正确,GPT-6 Sol 在精致度与手感上以 5.0 对 4.3 领先。
在更高效、更实惠的前沿模型竞赛中,外界对 Anthropic 新模型的关注只持续了大约一个小时。
他们的 Claude Opus 5.5 是 Claude 5.5 系列中的首款模型,主打以低于 Opus 5 的运行成本,达到 Fable 5.1 级别的性能。
OpenAI 很快回应,发布了 GPT-6 家族的中端型号 GPT-6 Sol,采用与旗舰 GPT-6 Astra 相同的训练方法,API 价格是其前代 GPT-5.6 Sol 的一半。
本文将从多个性能维度、护栏与定价对比 GPT-6 Sol 和 Claude Opus 5.5,并附上一项我在二者上各跑了一遍的上手构建测试。
要点速览
什么是 GPT-6 Sol?
GPT-6 Sol 是 OpenAI 的中端 GPT-6 模型,于 2026 年 9 月 22 日与 GPT-6 Luna 一同发布,定位于旗舰 GPT-6 Astra 之下。
它的卖点是以 Astra 的训练配方,提供比 GPT-5.6 Sol 低一半的 API 价格,并支持在对推理力度或工具做出会话中途调整时仍保持提示缓存有效。
我们的《GPT-6 Sol 与 Luna 指南》涵盖了发布细节,另有《GPT-6 Astra API 教程》讲解该家族的异步工具与引导方式。
什么是 Claude Opus 5.5?
Claude Opus 5.5 是 Anthropic 的首款 Claude 5.5 模型,于 2026 年 9 月 22 日发布,被定位为该公司在长时间运行的代理式编码与知识工作方面的新旗舰。
它的卖点是在 Opus 价位上提供 Fable 级结果:Anthropic 称其在多数任务上可与 Claude Fable 5.1 持平,并配有 Fable 级的网络安全与生物安全防护。
我们的《Opus 5.5 指南》涵盖了发布内容,另有《Claude Opus 5 API 教程》介绍上一代 API。
GPT-6 Sol vs Claude Opus 5.5:正面对比
由于发布时间非常接近,双方都没把对手的新模型放进各自的发布表里,因此两者仅在两个基准上有重叠,且 Opus 5.5 均领先。Sol 的优势在于价格,以及在我们自测中的表现。
none到max;对其编码工作的误导性表述少于 GPT-5.6 Sol编码与代理式工作流
Opus 5.5 公布的代理式编码数据更强,而 Sol 的博文并未正面质疑这些结果。Anthropic 报告了 Opus 5.5 在 Terminal-Bench 4.0、FrontierCode 与 CursorBench 上的成绩;OpenAI 报告了 Sol 在 DeepSWE 上的成绩,并仅称其在 xhigh 努力度的 FrontierCode 上与 Claude Fable 5.1 持平。Anthropic 将 Fable 5.1 的 FrontierCode 记为 50.3%,而 Opus 5.5 为 54.4%,若两者说法都成立,则在两方都提到的这项编码基准上,Sol 大约落后 Opus 5.5 四个百分点。
两家更多依赖长周期案例而非共享分数。Anthropic 的内部案例是将 HAProxy 从 C 改写为 Rust,Opus 5.5 用时 9.5 小时,Fable 5.1 为 12 小时,成本低 51%。OpenAI 的论据是单任务成本:Sol 以远低于对方的大约 80% 成本,在 DeepSWE 上的分数与 Fable 5 相差约 1 个百分点。
看这些表需要两点保留:
纸面上,Opus 5.5 是更强的编码模型;不过在我们下面的单次构建测试中,这个差距并未显现。
业务工作流与电脑使用
在两者共享的两个基准上,Opus 5.5 都领先,其中 AutomationBench 的差距最干净:Opus 5.5 在 Zapier 针对 47 个业务工具的代理测试中为 40.0%,Sol 为 33.2%。
Sol 的反击是账单:OpenAI 将 Sol 描述为以 Opus 5 的 9% 单任务成本击败 Claude Opus 5,但该对比对象是上一代 Opus,而非本代。
按分数,Opus 5.5 是更强的代理;按账单,Sol 则是可以承受每一张工单都跑的那一个。
知识工作与事实可靠性
这里唯一跨厂商的数字来自 Opus 5.5:GDPval-AA v2.1 的 Elo 为 1846,领先 Anthropic 表中的 GPT-6 Astra 与 GPT-5.6 Sol;Sol 本身未列入。Anthropic 的报告写作测试中,只要编造数据即判失败,Opus 5.5 的 18 份报告中有 16 份通过,而 Fable 5.1 与 Opus 5 无一通过。
Sol 的证据来自与自身前代的对比:在 OpenAI 的内部事实性集合上,Sol 的错误约为 GPT-5.6 Sol 的一半。Artificial Analysis 的 AA-Omniscience 测试也同意,但有前提:Sol 的幻觉率从 92% 降至 60%,同时其答复率为 83%,低于前代的 99%。
两者都比各自前代更谨慎;只有 Opus 5.5 对外展示了对手比拼中的优势。
护栏与 API 约束
Sol 的 API 约束更少,Opus 5.5 的监管更强。
Opus 5.5 无法在关闭思考的状态下运行,会拒绝被强制使用工具,并将思考块绑定到生成它的模型与会话上,因此在 2026 年 8 月 31 日后创建的账户上,编辑过的上下文会触发 400 错误。大多数网络安全任务会在其 Cyber Verification Program 外改道至 Opus 4.8,生物学工作需要 Life Sciences Verification Program。
Sol 的努力度从
none到max,会话中途可调整努力度且不破坏缓存,OpenAI 还报告其对编码工作的误导性表述少于 GPT-5.6 Sol。这是有意为之的权衡:相比 Opus 5,Opus 5.5 试图跨越隔离边界的频率减少约 85%,这对无人值守代理很重要。
定价:您实际会付多少
标价上,Opus 5.5 恰好是 Sol 的两倍,但代理实际付费的两类机制打破了这一模式:缓存读取价格一致,而 Sol 在超过 272K tokens 的请求上加收附加费,Anthropic 则没有。
Token 费率并排对照
溢价在输入、输出与缓存写入上是平的,因此在引入缓存或长上下文之前,每种工作负载形态受影响基本一致。缓存读取是例外,Anthropic 称其构成了代理与编码工作的主要成本来源。两家都未公布“推理 tokens”的独立费率,因此按输出费率来预算。
真实工作负载要花多少钱
“高于阈值”这一行最关键:一旦每次请求都越过阈值,Sol 的附加费会把总账单抬到距离 Opus 5.5 仅 8% 的差距,因此在长上下文检索流水线中,选择 Sol 几乎得不到折扣。重度缓存循环之所以把差距缩小到 33%,是因为 1000 次缓存读取在两者上价格相同,只有新增 tokens 才按 2 倍溢价计费。
两者使用不同的分词器,且都未公布某个共享工作负载的 token 计数,因此将这些总额视为费率比较而非真实账单。Anthropic 确实表示 Opus 5.5 的单任务用 token 少于 Opus 5,但未说明与 Sol 的对比。
GPT-6 Sol 与 Claude Opus 5.5 的表现
来自两家厂商、互不测试对方模型的基准终究有限,因此我用完全相同的提示与工具,分别对两者跑了一个构建任务。
测试内容
我让两者在 12×24 的棋盘上构建一个单文件俄罗斯方块克隆,带一个变体:每 20 秒引力翻转。提示中的两个要求让它变难:翻转后,方块必须朝上方“天花板”坠落,并在上方堆叠处锁定,上下两侧各自满行都要消行,且已锁定的格子在引力翻转时绝不能移动。
两个模型都在 OpenCode 内运行,使用完全相同且已固定的工具面:只能读文件、搜索与编辑,不能用 shell,不能联网。两者都以
high推理力度运行,各一次尝试、不重试,提示逐字节送入一个全新会话。需要注意一个不对称点:在两家的努力度阶梯中,
high都距离顶端两级,但 Sol 的阶梯底部多一个none,因此high是 Sol 的第 4/6 档,而 Opus 5.5 的第 3/5 档。提示如下:
我记录了成本,并从以下三个维度按 1 到 5 分打分:
GPT-6 Sol 的产物
Sol 运行了 6 个回合、发起 9 次工具调用:在写入一个 22 KB 的
index.html前,先列出、搜索并读取了空工作区,随后又补丁了一次。成品带有自有品牌风格“Fall / Rise, a game of shifting ground”,带有在翻转时由琥珀色变青色的引力面板、下一次翻转的倒计时,以及边栏的规则卡片。它该做的都做了,且运行平滑稳定:翻转时地面堆叠保持不动,方块上升并在天花板处锁定,上下两侧都会消行,软降落手感灵敏,因此玩起来比另一个更有趣。