

什么是系数?
在红色方框中,您可以看到年龄对应的截距(“a” 值)和斜率(“b” 值)。这些 “a” 和 “b” 值在所有数据点之间绘制出一条直线。因此,在本例中,如果某个孩子 20.5 个月大,a 为 64.92,b 为 0.635,则模型(平均)预测其身高约为 64.92 + (0.635 * 20.5) = 77.93 厘米。
当一个回归使用两个或更多预测变量来构建线性回归时,它被称为多元线性回归。沿用您在前一个简单示例中的逻辑,孩子的身高将由以下式子测量:
身高 = a + 年龄 × b1 + (兄弟姐妹数量} × b2
您现在将身高视为月龄与孩子拥有的兄弟姐妹数量的函数。在上图中,红色矩形表示系数(b1 和 b2)。您可以这样解释这些系数:
在比较拥有相同兄弟姐妹数量的孩子时,平均预测身高每增加一个月会上升 0.63 厘米。同样地,在比较相同年龄的孩子时,身高会随着兄弟姐妹数量每增加一个而下降 0.01 厘米(因为系数为负)。
在 R 中,如需添加另一个系数,对于每个要加入模型的附加变量,添加符号 “+”。
lmHeight2 = lm(height~age + no_siblings, data = ageandheight) #Create a linear regression with two variables
summary(lmHeight2) #Review the results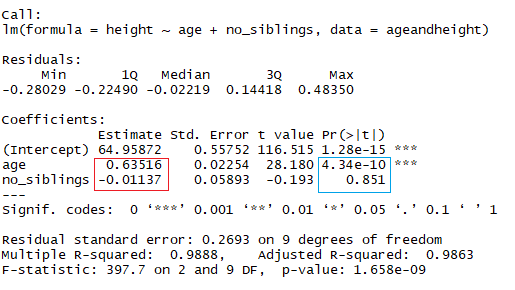
您可能已经注意到,用兄弟姐妹数量来预测孩子身高并不明智。在线性模型中,另一个需要关注的方面是系数的 p 值。在前面的示例中,蓝色矩形表示系数“年龄”和“兄弟姐妹数量”的 p 值。简单来说,p 值表示您能否拒绝或接受一个假设。在本例中,假设是该预测变量对模型没有意义。
- 年龄的 p 值为 4.34*e-10 或 0.000000000434。极小的数值意味着年龄很可能是您模型的一个极佳补充。
- 兄弟姐妹数量的 p 值为 0.85。换句话说,有 85% 的概率该预测变量对回归没有意义。
一种常见的检验预测变量是否无意义的方法是查看其 p 值是否小于 0.05。
什么是残差?
检验模型拟合质量的一个好方法是查看残差,即真实值与预测值之间的差异。上图中的直线表示预测值。从直线到观测数据值的红色竖线就是残差。
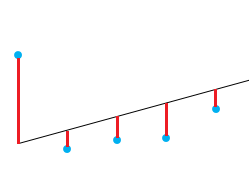
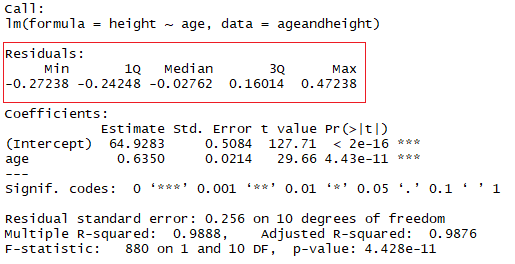
这里的思路是残差之和大约为零,或尽可能小。现实中,大多数情况不会完全沿直线变化,因此残差是可以预期的。在 lm() 函数的 R 摘要中,您可以看到模型残差的描述性统计。延续相同的示例,红色方框显示残差大约为零。
如何检验线性模型的拟合优度
一个非常常用的度量是判定系数 R²。该度量定义为由回归模型解释的总变异比例。
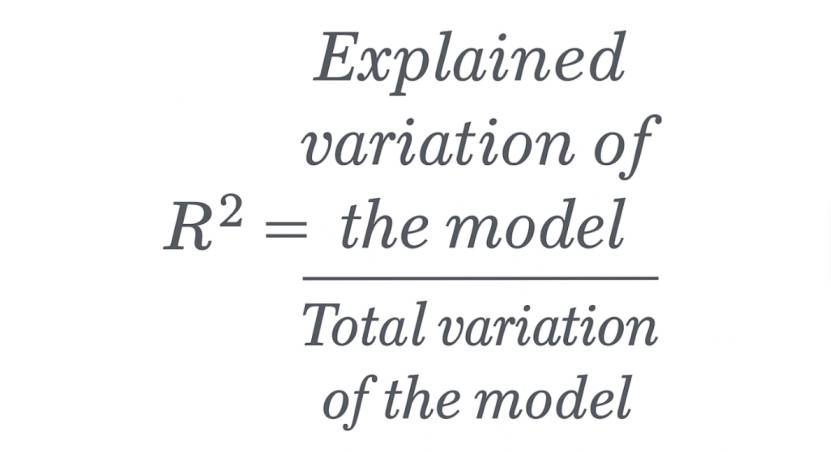
这看起来可能有点复杂,但一般而言,拟合良好的模型其 R² 接近 1;拟合较差的模型其 R² 接近 0。如下示例中,第一个模型的 R² 为 0.02,意味着该模型仅能解释 2% 的数据变异;第二个模型的 R² 为 0.99,能够解释 99% 的总变异。**
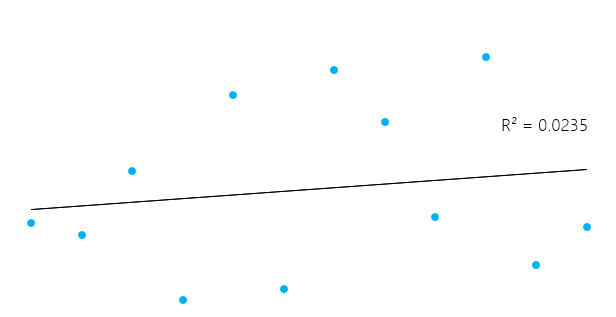
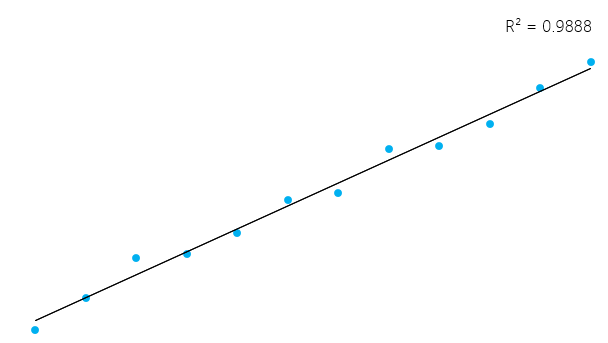
不过,务必要记住,有时较高的 R² 并不一定总是好事(见下方残差图),而较低的 R² 也不一定总是坏事。现实中的事件并不总是完美地沿直线变化。例如,您的数据中可能存在同龄但更高或更矮的孩子。在某些领域,R² 达到 0.5 就被认为不错。
沿用上述示例,查看线性模型的摘要以查看其 R²。
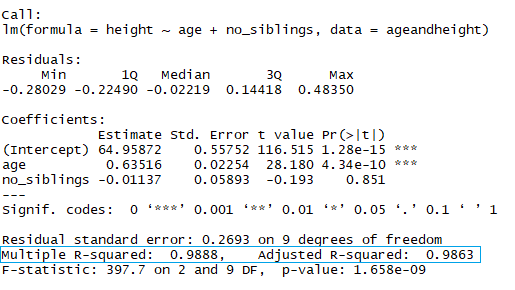
在蓝色矩形中,注意有两个不同的 R²:一个为多重 R²,一个为调整后的 R²。多重 R² 就是您之前看到的那个。该 R² 的一个问题在于,随着您向模型添加更多自变量,它不会下降;即便这些变量对预测没有贡献(如兄弟姐妹数量的示例),它也会随着模型复杂度增加而持续上升。因此,如果您在模型中添加了多个变量,更适合关注调整后的 R²,因为只有当它降低了整体预测误差时才会上升。
检查残差
您的模型可能有一个相当不错的 R²,但先别急着下结论。来看一个示例:您准备根据某种材料在实验室中的温度来预测其压力。
让我们绘制数据(简单散点图),并加入用线性模型得到的直线。在这个示例中,先用 read_excel 命令读取数据,创建一个包含数据的数据框,然后用新数据创建线性回归。plot() 命令接收一个数据框并对其中的变量作图。在此例中,它将材料的压力与温度作图。之后,用 abline 命令添加线性回归得到的直线。
pressure <- read_excel("pressure.xlsx") #Upload the data
lmTemp = lm(Pressure~Temperature, data = pressure) #Create the linear regression
plot(pressure, pch = 16, col = "blue") #Plot the results
abline(lmTemp) #Add a regression line
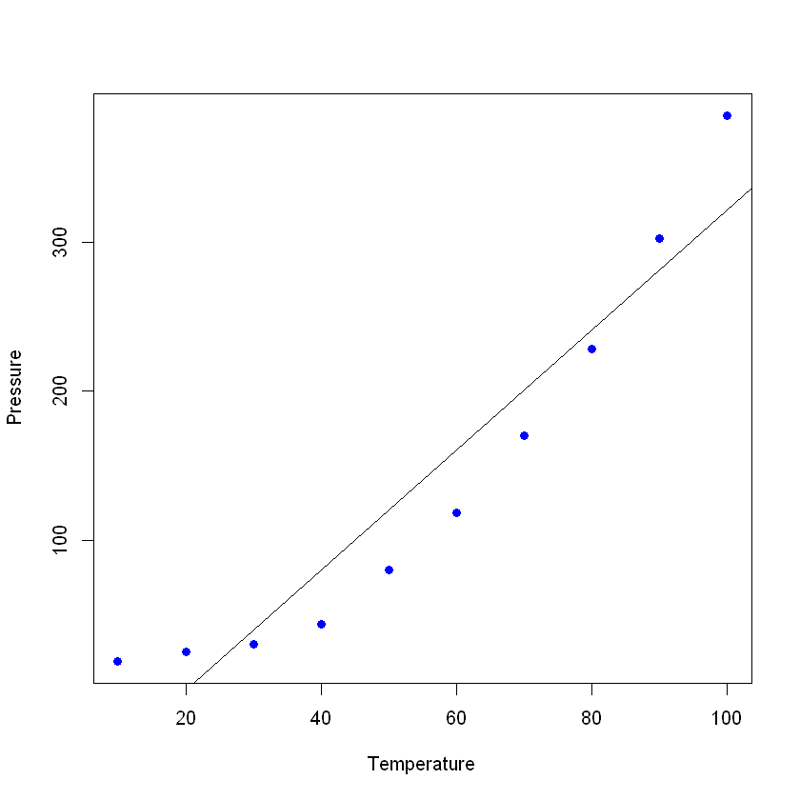
如果您查看新模型的摘要,会发现其结果相当不错(看看 R² 和调整后的 R²)。
summary(lmTemp)
Call:
lm(formula = Pressure ~ Temperature, data = pressure)
Residuals:
Min 1Q Median 3Q Max
-41.85 -34.72 -10.90 24.69 63.51
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) -81.5000 29.1395 -2.797 0.0233 *
Temperature 4.0309 0.4696 8.583 2.62e-05 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 42.66 on 8 degrees of freedom
Multiple R-squared: 0.902, Adjusted R-squared: 0.8898
F-statistic: 73.67 on 1 and 8 DF, p-value: 2.622e-05理想情况下,当您绘制残差时,它们应呈现随机分布。否则可能意味着线性模型没有考虑某个隐藏模式。要绘制残差,请使用命令 plot(lmTemp$residuals)。
plot(lmTemp$residuals, pch = 16, col = "red")
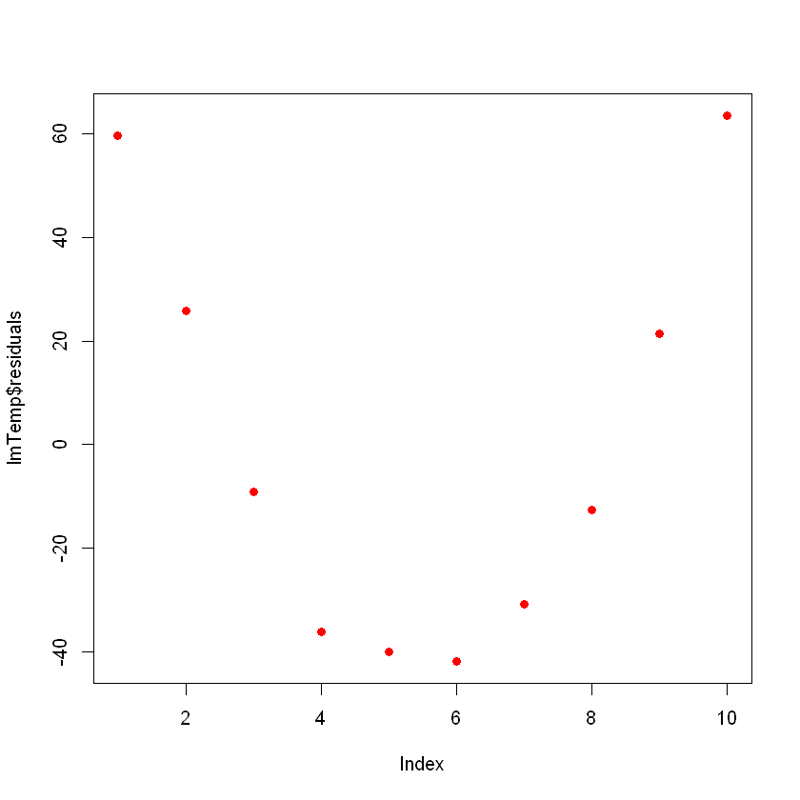
这可能是个问题。如果您有更多数据,简单线性模型将无法很好地泛化。在上图中,注意到存在某种模式(如残差上的曲线)。这完全不是随机的。
您可以对变量进行变换。有许多可能的变换可用于您的数据,例如添加二次项(x2)、三次项(x3),或更复杂的 ln(X)、ln(X+1)、sqrt(X)、1/x、Exp(X)。选择正确的变换需要一定的代数函数知识、实践和试错。
我们来尝试添加一个二次项。为此,在您的变换前加上 “I”(大写字母 I)。例如,下面将是常规的线性回归公式:
lmTemp2 = lm(Pressure~Temperature + I(Temperature^2), data = pressure) #Create a linear regression with a quadratic coefficient
summary(lmTemp2) #Review the results
Call:
lm(formula = Pressure ~ Temperature + I(Temperature^2), data = pressure)
Residuals:
Min 1Q Median 3Q Max
-4.6045 -1.6330 0.5545 1.1795 4.8273
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 33.750000 3.615591 9.335 3.36e-05 ***
Temperature -1.731591 0.151002 -11.467 8.62e-06 ***
I(Temperature^2) 0.052386 0.001338 39.158 1.84e-09 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 3.074 on 7 degrees of freedom
Multiple R-squared: 0.9996, Adjusted R-squared: 0.9994
F-statistic: 7859 on 2 and 7 DF, p-value: 1.861e-12请注意,模型显著改进。如果绘制新模型的残差,它们会如下所示:
plot(lmTemp2$residuals, pch = 16, col = "red")
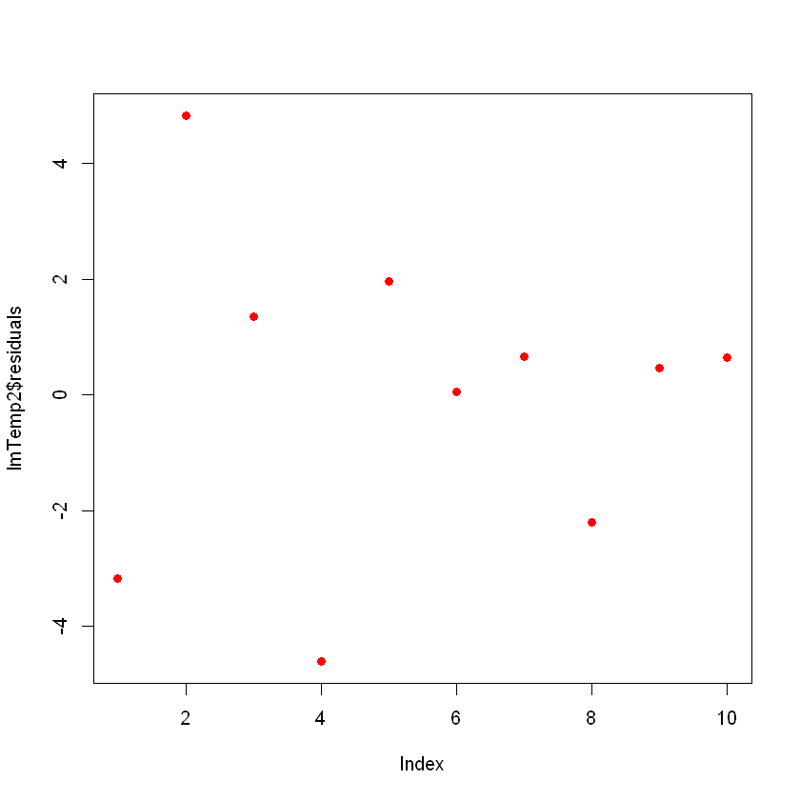
现在您不会在残差中看到明显的模式了,这很好!
检测高影响点
在数据中,可能存在会不必要地扭曲模型的高影响点。想象一下录入错误,将 “2.3” 误写成了 “23”。最常见的一类高影响点是离群点,即观察到的响应似乎不遵循其余数据所确立的模式的数据点。
您可以通过查看包含线性模型的对象,使用 cooks.distance() 函数并绘制这些距离来检测高影响点。我们有意修改一个值,看看在 Cook 距离图上的表现。要更改特定值,您可以直接用 ageandheight[row number, column number] = [new value] 指定。在此例中,将第二条记录的身高改为 7.7:
ageandheight[2, 2] = 7.7
head(ageandheight)
| age | height | no_siblings |
|---|---|---|
| 18 | 76.1 | 0 |
| 19 | 7.7 | 2 |
| 20 | 78.1 | 0 |
| 21 | 78.2 | 3 |
| 22 | 78.8 | 4 |
| 23 | 79.7 | 1 |
重新创建模型后,您会看到摘要显示拟合变差,然后绘制 Cook 距离。为此,在创建线性回归后,使用命令 cooks.distance([linear model],随后如有需要,可用 plot() 将这些距离绘制出来。
lmHeight3 = lm(height~age, data = ageandheight)#Create the linear regression
summary(lmHeight3)#Review the results
plot(cooks.distance(lmHeight3), pch = 16, col = "blue") #Plot the Cooks Distances.
Call:
lm(formula = height ~ age, data = ageandheight)
Residuals:
Min 1Q Median 3Q Max
-53.704 -2.584 3.609 9.503 17.512
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 7.905 38.319 0.206 0.841
age 2.816 1.613 1.745 0.112
Residual standard error: 19.29 on 10 degrees of freedom
Multiple R-squared: 0.2335, Adjusted R-squared: 0.1568
F-statistic: 3.046 on 1 and 10 DF, p-value: 0.1115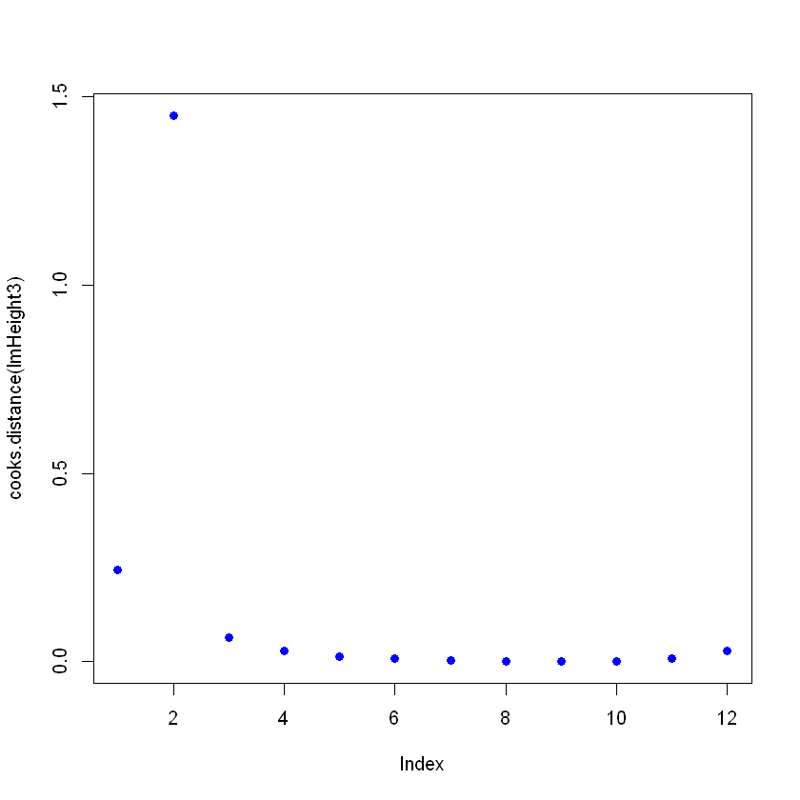
请注意,有一个点并不遵循模式,可能正在影响模型。您可以对这一点做出判断,一般而言,一个点之所以影响很大有三种原因:
- 有人在记录时出错
- 有人在采集观测时犯了根本性错误
- 该数据点完全有效,此时模型无法解释其行为。
如果是情形 1 或 2,那么您可以删除该点(或更正它)。如果是情形 3,不值得删除一个有效点;也许您可以尝试采用非线性模型而不是像线性回归这样的线性模型。
请注意,高影响点也可能是有效点;在删除之前务必检查数据及其来源。统计学教材中常见这样一句话:“有时我们丢弃了完全良好的数据,而真正该丢弃的是可疑的模型。”
结论
您已经读到最后了!线性回归是一个很大的主题,而且将长期存在。这里我们介绍了一些技巧,帮助您调优并充分发挥这一强大而简单的算法的优势。您还学会了理解这一简单统计模型背后的原理,以及如何根据需要对其进行修改。您也可以在 R 控制台输入 ?lm 探索更多这里未涉及的参数。查看我们的正则化教程:Ridge、Lasso 与 Elastic Net。如果您有兴趣深入学习统计模型,欢迎查看课程R 中的统计建模入门。
以持续学习提升团队的数据技能
由于线性回归构成了许多高级分析技术的基础,确保您的团队牢固掌握这一技能及其他关键技能,对长期成功至关重要。
DataCamp for Business 为希望在数据科学与分析方面提升团队能力的组织提供量身定制的方案。通过自定义学习路径和涵盖广泛统计方法(包括回归与预测建模)的实践型课程,您的团队能够自信地应对复杂的数据挑战。
立即申请演示,为组织的未来投资,帮助您的团队紧跟数据分析领域的最新工具与技术。
常见问题
线性回归中的 R^2 是什么?
R^2(判定系数)衡量因变量中可由自变量预测的方差比例。其取值范围为 0 到 1,数值越高表示拟合越好。
R 平方的公式是什么?
R 平方的计算方式是:用回归模型解释的因变量总变异占因变量总变异的比例。它将观测值与预测值的平方差之和与观测值相对于其均值的平方差总和进行比较。
线性回归中 r 的含义是什么?
在线性回归中,r 表示因变量的观测值与预测值之间的相关系数,指示线性关系的强度与方向。
线性回归是最重要、最基础的统计技术之一。掌握这项技术对任何数据分析师和数据科学家都至关重要,因为正如您将看到的,它是许多更高级方法的基础。
本教程将引导您在重要的编程语言 R 中执行线性回归的全过程。读完本教程,您将理解如何实现并解释线性回归模型,从而更轻松地将这一知识应用到您的数据分析任务中。
如果您还不熟悉 R 编程语言,建议先阅读我们的入门教程:R 探索性数据分析:零基础入门 和 精通 R 编程语言中的数据结构。
什么是线性回归?
线性回归是一种统计模型,用于分析响应变量(通常记为y)与一个或多个变量及其交互作用(通常记为 x 或解释变量)之间的关系。您在日常思考中也会构建这种关系,例如,当您根据孩子的身高来推测其年龄时,您是在假设年龄越大,身高越高。
线性回归是最基础的统计模型之一。几乎所有人都能解释其结果,而且它自19世纪早期就已出现。这正是线性回归如此流行的原因:它简单,而且历经数百年仍经久不衰。尽管它不如人工神经网络或随机森林等算法复杂,但据 KD Nuggets 的调查,回归是数据科学家在2016 年和2017 年使用最多的算法。甚至还有人预测到2118 年它仍将被使用!
在本线性回归教程中,我们将探讨如何在 R 中创建线性回归,并通过一个可供您亲自操作的示例,展示所需步骤。
若想轻松运行本教程中的所有示例代码,您可以免费创建一个 DataLab 工作簿,其中已预装 R 并包含所有代码示例。若需更多线性回归练习,请查看我们的 DataCamp 实操练习。
如何在 R 中创建线性回归
并非每个问题都能用同一种算法解决。已知当响应与结果之间存在线性关系时,线性回归效果较好。换言之,线性回归假设响应变量与解释变量之间存在线性关系。在两个变量的情形下,这意味着您可以在两个变量之间拟合一条直线。回到我们之前的孩子年龄示例,很明显,孩子年龄与身高之间存在关系。
在这个例子中,如果您知道孩子的年龄,就可以计算她的身高:
在这种情况下,a 和 b 分别称为截距和斜率。以上述示例而言,a(截距)是您开始计量的起点。新生儿在 0 个月时并不是 0 厘米高,这正是截距的作用。斜率衡量的是相对于月龄的身高变化。一般来说,孩子每长大一个月,身高就会增加 b。
R 中的 lm()
可以使用 R 中的
lm()命令来计算线性回归。在下一个示例中,我们使用此命令根据孩子的年龄来估计身高。首先,导入库
readxl以读取 Microsoft Excel 文件。如果您不熟悉如何在 R 环境(如 RStudio)中导入 Excel 或 CSV 文件,我们的R 数据导入入门课程是一个很好的资源。您可以在开始之前下载本教程所用数据。将数据下载到一个名为
ageandheight的对象中,然后在第三行创建线性回归。lm()函数按如下格式接收变量:在下面的代码中,我们使用
lm()函数创建一个线性模型对象,命名为lmHeight。随后在lmHeight上使用summary()函数,以查看模型性能和系数的详细信息。