跳至内容
人工智能

您该了解的 RAG 框架:让 AI 更聪明的开源工具

了解检索增强生成如何通过外部知识源弥补 LLM 的局限。探索常见框架、实用搭建方案与真实使用场景。
Oluseye Jeremiah's photo
Oluseye Jeremiah
已更新 · 10分钟 阅读

使用 AI 探索

ChatGPTClaudePerplexity

创建您的免费账户

实践并学习路径你的进步。

使用 Google 继续
继续操作即表示您接受我们的《使用条款》和《隐私政策》,并同意您的数据存储在美国。

检索增强生成(RAG)正迅速成为使用大语言模型最实用的演进之一。它并不是一种新模型或 LLM 的替代品;相反,它是一种创新系统,帮助模型基于来自真实数据源的事实进行推理。从根本上说,RAG 解决了生成式 AI 的一些最大挑战:幻觉、有限记忆以及知识过时。将检索与生成结合为一条流水线,使模型能够把答案扎根于当前且相关的上下文中,且往往可针对某个业务或领域。

这一转变比以往任何时候都更重要。在企业环境中,人们期望 LLM 的回答准确且可解释。开发者希望输出能反映产品文档、内部 Wiki 或工单支持,而不是泛化的网络知识。RAG 正是实现这一点的途径。

本指南将解释 RAG 框架的工作原理、它在您的 AI 技术栈中的位置,以及如何结合基础工具与数据来使用它。

什么是 RAG 框架?

RAG 是 检索(Retrieve)、增强(Augment)、生成(Generate) 的缩写。它是一种让大语言模型(LLM)无需重新训练即可访问外部知识的聪明做法。

思路如下:当用户提出问题时,与其直接把问题扔给模型寄希望于得到一个好答案,RAG 会先检索知识库中的相关信息。然后,它会用这些额外的上下文来增强原始提示。最后,LLM 生成结合问题与新增信息的回答。

这种方法通过即时引入真实、最新且相关的数据,帮助解决 LLM 的关键局限——如幻觉、短期记忆(上下文窗口)以及知识截止等问题。

为何使用 RAG 框架?

单独的 LLM 虽然强大,但也有盲点。它们会产生幻觉、会遗忘、且对最后一次训练之后的内容一无所知。RAG 改变了这一切。将 LLM 与实时检索结合,您将获得:

  • 事实准确性:回答基于您的真实数据,而非猜测。
  • 领域相关性:您可以注入小众或内部知识。
  • 无需再训练:只需更新知识库——不需要微调。
  • 可扩展性:非常适用于聊天机器人、搜索工具、支持助手等。

简而言之,RAG 让您以更少的投入构建更聪明、更可信的 AI 系统。

最佳开源 RAG 框架

RAG 生态发展迅速,已有数十个开源项目帮助开发者构建更智能的检索增强应用。无论您在寻找可插拔、直观的工具,还是拥有可自定义组件的全栈流水线,您大概率都能找到合适的方案。

下面我们将评测顶级开源 RAG 框架。每一项都会重点介绍其 GitHub 热度、部署方式、独特优势、主要使用场景,并配有可帮助您快速了解项目的示意图。

1. Haystack

Haystack 是一个稳健、模块化的框架,用于构建可投入生产的 NLP 系统。它支持检索器、阅读器与生成器等多种组件,并可与 Elasticsearch、Hugging Face Transformers 等工具无缝集成。
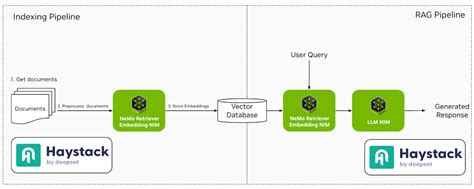
  • GitHub 星标:约 13.5k
  • 部署:Docker、Kubernetes、Hugging Face Spaces
  • 亮点功能:模块化组件、与 Hugging Face 深度集成、多语言支持
  • 使用场景:企业级问答系统、聊天机器人、内部文档搜索(TrueFoundry、Anyscale、LobeHub)

2. LlamaIndex

LlamaIndex 是一个数据框架,用于将自定义数据源连接到大语言模型。它简化了数据索引与查询流程,让构建需要情境感知回答的应用更加容易。

  • GitHub 星标:约 13k
  • 部署:基于 Python,文件或 Web 数据皆可在任意环境运行
  • 亮点功能:索引、检索与路由的简洁抽象
  • 使用场景:个人助手、知识机器人、RAG 演示(GitHub)

3. LangChain

LangChain 是一个全面的框架,使开发者能够构建由语言模型驱动的应用。它提供了把提示模板、记忆和智能体等不同组件串联起来的工具,以创建复杂的工作流。
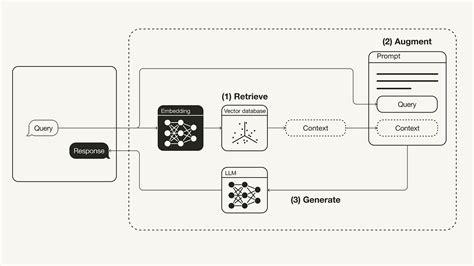
LangChain Diagram

  • GitHub 星标:约 72k
  • 部署:Python、JavaScript,支持所有主流云平台
  • 亮点功能:工具链式调用、智能体、提示模板、丰富集成
  • 使用场景:端到端 LLM 应用、数据智能体、动态聊天流

4. RAGFlow

RAGFlow 是一个专注于深度文档理解的开源引擎。它为企业实现 RAG 系统提供了简化的工作流,强调以引文为依据的真实问答,适配复杂数据格式。
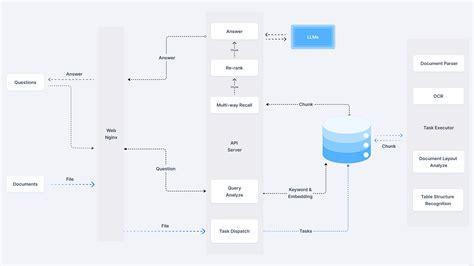
RAGFlow

  • GitHub 星标:约 1.1k
  • 部署:Docker;支持基于 FastAPI 的微服务
  • 亮点功能:分块可视化、Weaviate 集成、灵活配置
  • 使用场景:轻量级 RAG 后端、企业原型(jina.ai)

5. txtAI

txtAI 是一个集成语义搜索与 RAG 能力的一体化 AI 框架。它可高效构建用于搜索、索引与信息检索的应用,支持多种数据类型与格式。

  • GitHub 星标:约 3.9k
  • 部署:基于 Python;几行代码即可运行。
  • 亮点功能:极其轻量、离线模式、评分/排序支持
  • 使用场景:基于嵌入的搜索引擎、与 PDF 对话、元数据问答(Introduction | LangChain、GitHub、GitHub)

6. Cognita

Cognita 是一个模块化的 RAG 框架,旨在实现易于自定义与部署。它提供前端界面以便试验不同的 RAG 配置,适用于开发与生产环境。

  • GitHub 星标:有一定知名度
  • 部署:Docker + TrueFoundry 集成
  • 亮点功能:以 API 为中心、即用型 UI、易于扩展
  • 使用场景:面向业务的 AI 助手、基于数据的聊天机器人(TrueFoundry、LlamaIndex)

7. LLMWare

LLMWare 提供统一框架,用于构建企业级 RAG 应用。它强调使用可私有部署的小型专用模型,以确保数据安全与合规。

  • GitHub 星标:约 2.5k
  • 部署:CLI 工具、API、可自定义项目模板
  • 亮点功能:零代码流水线、文档解析工具
  • 使用场景:文档智能体、知识助手(LinkedIn)

8. STORM

STORM 是一个研究助手,扩展了基于大纲驱动的 RAG 概念。它专注于综合多源信息生成完整文章,非常适合内容创作任务。

  • GitHub 星标:小众
  • 部署:源码安装
  • 亮点功能:Co-STORM 推理引擎、基于图的探索
  • 使用场景:自定义 RAG 设置、研究问答流水线(GitHub)

9. R2R

R2R(Reason to Retrieve)是一套先进的 AI 检索系统,支持具备生产特性的 RAG。它提供多模态内容摄取、混合搜索与知识图谱集成,满足复杂企业需求。

  • GitHub 星标:小众
  • 部署:REST API,支持混合搜索与图谱搜索
  • 亮点功能:多模态 RAG、文档验证
  • 使用场景:AI 研究工具、学术智能体(YouTube、Open Source For You、Weaviate Newsletter)

10. EmbedChain

EmbedChain 是一个 Python 库,可简化使用 RAG 模型创建与部署 AI 应用的流程。它支持包括 PDF、图像与网页在内的多种数据类型,适配多元场景。

  • GitHub 星标:约 3.5k
  • 部署:Python 库,同时提供托管 SaaS
  • 亮点功能:一条命令搭建应用、API 优先
  • 使用场景:快速原型、构建任何领域的知识机器人(LLMWare AI for Complex Enterprises)

11. RAGatouille

RAGatouille 将 ColBERT 等高级检索方法集成进 RAG 流水线。它允许对不同检索技术进行模块化试验,增强 RAG 系统的灵活性与性能。

  • GitHub 星标:小众但增长中
  • 部署:Python 包
  • 亮点功能:检索实验、模块化输入
  • 使用场景:在 RAG 流水线中评估检索技术

12. Verba

Verba 是一款可定制的个人助手,利用 RAG 对数据进行查询与交互。它与 Weaviate 的上下文感知型数据库集成,实现高效的信息检索与交互。

  • GitHub 星标:中等规模
  • 部署:本地与云端均支持
  • 亮点功能:情境记忆、个人数据问答
  • 使用场景:自建助手、数据探索(LinkedIn、Brandfetch)

13. Jina AI

Jina AI 提供用于构建多模态 AI 应用的工具,并具备可扩展的部署选项。它支持多种通信协议,适合希望构建与扩展 AI 服务的开发者。

  • GitHub 星标:约 18k(主组织)
  • 部署:Docker、REST/gRPC/WebSocket API
  • 亮点功能:多模态流水线、混合搜索
  • 使用场景:结合文本、图像或视频的企业级应用

14. Neurite

Neurite 是一款新兴的 RAG 框架,简化 AI 驱动应用的构建。其对开发者体验与快速原型的重视,使之成为探索试验的理想之选。

  • GitHub 星标:体量小但前景可期
  • 部署:源码搭建
  • 亮点功能:神经-符号融合
  • 使用场景:AI 研究实验、原型系统(GitHub、Hugging Face、GitHub)

15. LLM-App

LLM-App 是一个用于构建大语言模型驱动应用的框架。它提供模板与工具以简化开发流程,使在各类应用中集成 RAG 能力更加容易。

  • GitHub 星标:新兴
  • 部署:基于 Git 的部署与 CLI 工具
  • 亮点功能:应用起步模板、支持 OpenAI
  • 使用场景:个人 RAG 项目、黑客松工具

每个框架都提供了面向不同使用场景与部署偏好的独特功能。根据您的具体需求——是部署便捷性、自定义能力,还是集成能力——选择最契合项目目标的框架。

选择合适的 RAG 框架

选择合适的 RAG 框架取决于您的具体需求:法律文档分析、学术研究,或轻量级本地开发。请使用下表快速比较流行的开源 RAG 框架:它们的部署方式、自定义程度、对高级检索的支持、集成能力,以及各自最适用的方向。

框架

部署

可定制性

高级检索

集成支持

最佳适用

Haystack

Docker、K8s、Hugging Face

高

是

Elasticsearch、Hugging Face

企业搜索与问答

LlamaIndex

Python(本地/云端)

高

是

LangChain、FAISS

文档感知型机器人

LangChain

Python、JS、云端

高

是

OpenAI、API、数据库

LLM 智能体与流水线

RAGFlow

Docker

中

是

Weaviate

法律或结构化文档

txtAI

本地(Python)

中

基础

Transformers

轻量本地开发

Cognita

Docker + UI

高

是

TrueFoundry

基于 GUI 的业务工具

LLMWare

CLI、API

高

是

私有 LLM

私有化企业 RAG

STORM

源码安装

高

是

LangChain、LangGraph

研究助手

R2R

REST API

高

是

多模态

学术与混合 RAG

EmbedChain

Python、SaaS

中

基础

网页、PDF、图像

快速原型

RAGatouille

Python

高

是

ColBERT

检索器实验

Verba

云端/本地

中

基础

Weaviate

情境化助手

Jina AI

Docker、REST/gRPC

高

是

多模态 API

可扩展的多模态应用

Neurite

源码搭建

中

否

N/A

实验探索

LLM-App

CLI、Git

中

否

OpenAI

黑客松 LLM 应用

实现 RAG 的常见陷阱

RAG 系统可以很强大,但也暗藏锋利的边缘。如果不加注意,模型的回答可能还不如不使用检索时。以下是四个常见问题需要规避——以及对应的替代做法。

1. 过度索引“杂质”

不是所有内容都该进入向量库。把每一篇文档、博文或邮件线程全都塞进去,看似全面,实则会污染搜索。检索器会拉回低价值的上下文,模型不得不去筛选(且常常被误用)。更好的做法是, 有选择地索引。只索引准确、行文良好、确有用处的内容。存之前先清洗。

2. 忽视 token 限制

LLM 的记忆很短。若您的提示加上所有检索回来的片段超过了模型的 token 上限,总会有部分被截断。而被截掉的,可能正是关键所在。请保持提示精炼。限制检索片段的数量,或在发送至模型前先做摘要。

3. 只追求召回而忽视精确

为了“面面俱到”,拉回更多文档很诱人。但若这些额外结果只是勉强相关,就会用“噪音”挤占提示。模型会分心,甚至更糊涂。更好的做法是,追求高精确率。少量高度相关的片段,胜过长长一串弱匹配。

4. 没有日志就“盲飞”

当模型给出糟糕答案时,您知道原因吗?如果没有记录查询、被检索的文档以及最终提示,您就在黑暗中调试。更好的做法是,记录完整的 RAG 流。包括用户输入、检索内容、发送给模型的材料,以及模型的响应。

结语

RAG 并非万能,但用得当时,它是让 LLM 更聪明、更实用、且更扎根于业务关键数据的最有效方式之一。

关键在于知己知彼。选择合适的框架只是其中一环,成功更取决于您对数据的理解深度,以及对检索流水线的精细调优。“垃圾进,垃圾出”依然适用,尤其当您构建的是生成语言而非仅仅检索事实的系统时。

把索引打好、关注 token 使用,并端到端监控流程。当这些环节契合到位,RAG 能让您的 AI 应用从“令人印象深刻”真正走向“切实有用”。


Oluseye Jeremiah's photo
Author
Oluseye Jeremiah
LinkedIn

专注于人工智能、机器学习与数据科学的技术写作者,擅长将复杂概念讲解得清晰易懂。

FAQs

RAG 框架用于做什么?

RAG 框架帮助 LLM 基于实时数据(如文档、网站或内部 Wiki)回答问题。

使用 RAG 是否需要微调我的模型?

不需要。RAG 框架通过检索相关数据并将其加入提示来工作。您无需对基础模型进行微调。

RAG 框架可使用哪些类型的数据?

取决于具体框架。许多框架支持 PDF、网站、Markdown 文件、数据库等。

RAG 框架能与 OpenAI 或 Hugging Face 模型配合吗?

可以。大多数框架对模型持中立态度,并能与 OpenAI、Cohere、Anthropic 与 Hugging Face 的 API 轻松集成。

RAG 中向量搜索与关键词搜索有什么区别?

向量搜索使用嵌入来寻找语义相关文本,而关键词搜索依赖精确的词匹配。

主题
人工智能

在 DataCamp 学习 AI

课程

使用 LangChain 开发 LLM 应用

3 小时
51.8K
了解如何使用 LLM、提示、链和代理在 LangChain 中构建 AI 驱动的应用程序。
查看详情开始课程

创建您的免费账户

实践并学习路径你的进步。

使用 Google 继续
继续操作即表示您接受我们的《使用条款》和《隐私政策》,并同意您的数据存储在美国。
查看更多