Retrieval-augmented generation (RAG) đang nhanh chóng trở thành một trong những bước tiến thực tiễn nhất trong việc sử dụng các mô hình ngôn ngữ lớn. Đây không phải là một mô hình mới hay sự thay thế cho LLM; thay vào đó, đó là một hệ thống sáng tạo giúp LLM suy luận dựa trên các sự kiện được lấy từ các nguồn dữ liệu thực. Về cốt lõi, RAG giải quyết một số thách thức lớn nhất của AI sinh sinh: ảo giác, bộ nhớ hạn chế và kiến thức lỗi thời. Kết hợp truy xuất và sinh trong một pipeline duy nhất cho phép mô hình neo câu trả lời vào bối cảnh hiện tại, phù hợp, thường mang tính đặc thù theo doanh nghiệp hoặc lĩnh vực.
Sự thay đổi này ngày càng quan trọng. Trong môi trường doanh nghiệp, LLM được kỳ vọng phải trả lời chính xác và có khả năng giải thích. Nhà phát triển muốn đầu ra phản ánh tài liệu sản phẩm, wiki nội bộ hoặc phiếu hỗ trợ, không chỉ là kiến thức chung trên web. RAG giúp điều đó trở thành hiện thực.
Hướng dẫn này giải thích cách framework RAG hoạt động, vị trí của nó trong ngăn xếp AI của bạn và cách sử dụng với các công cụ và dữ liệu nền tảng.
RAG Framework là gì?
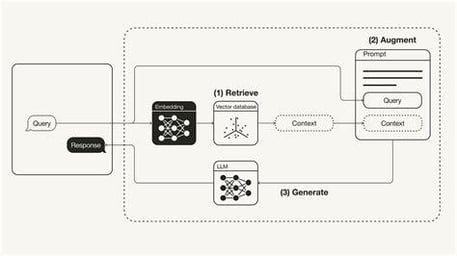
RAG là viết tắt của Retrieve, Augment, Generate. Đây là cách thông minh để cấp quyền truy cập vào kiến thức bên ngoài cho các mô hình ngôn ngữ lớn (LLM) mà không cần huấn luyện lại chúng.
Ý tưởng là: khi người dùng đặt câu hỏi, thay vì ném thẳng câu hỏi đó vào mô hình và hy vọng có câu trả lời tốt, RAG trước tiên sẽ truy xuất thông tin liên quan từ một cơ sở tri thức. Sau đó, nó bổ sung ngữ cảnh thêm vào prompt gốc. Cuối cùng, LLM sinh câu trả lời dựa trên câu hỏi và thông tin đã được thêm vào.
Cách tiếp cận này giúp khắc phục các hạn chế chủ chốt của LLM—như ảo giác, bộ nhớ ngắn (cửa sổ ngữ cảnh) và giới hạn kiến thức—bằng cách cắm dữ liệu thực, hiện thời và phù hợp theo thời gian thực.
Tại sao nên dùng RAG Framework?
Các LLM độc lập rất ấn tượng, nhưng vẫn có điểm mù. Chúng có thể bịa, quên nhanh và không biết gì mới hơn lần huấn luyện gần nhất. RAG thay đổi điều đó. Kết hợp LLM với truy xuất thời gian thực, bạn có được:
- Độ chính xác theo sự kiện: Câu trả lời dựa trên dữ liệu thực của bạn, không phải phỏng đoán.
- Tính liên quan theo miền: Bạn có thể đưa vào kiến thức chuyên biệt hoặc nội bộ.
- Không cần huấn luyện lại: Chỉ cần cập nhật cơ sở tri thức—không cần tinh chỉnh.
- Khả năng mở rộng: Tuyệt vời cho chatbot, công cụ tìm kiếm, trợ lý hỗ trợ, và hơn thế nữa.
Tóm lại, RAG giúp bạn xây dựng các hệ thống AI thông minh và đáng tin cậy hơn với ít nỗ lực hơn nhiều.
Những RAG Frameworks mã nguồn mở tốt nhất
Hệ sinh thái RAG đang phát triển nhanh chóng, với hàng chục dự án mã nguồn mở giúp nhà phát triển xây dựng các ứng dụng được tăng cường truy xuất thông minh hơn. Dù bạn tìm kiếm một giải pháp cắm là chạy, đơn giản hay một pipeline full-stack với các thành phần có thể tùy chỉnh, khả năng cao là có công cụ phù hợp cho bạn.
Bên dưới, chúng tôi sẽ điểm qua các framework RAG mã nguồn mở hàng đầu. Mỗi mục nêu bật độ quan tâm trên GitHub, kiểu triển khai, điểm mạnh riêng, trường hợp sử dụng chính, và một hình minh họa để bạn nhanh chóng nắm bắt dự án.
1. Haystack
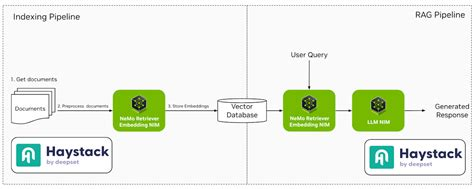
Haystack là một framework vững chắc, dạng mô-đun, được thiết kế để xây dựng các hệ thống NLP sẵn sàng cho sản xuất. Nó hỗ trợ nhiều thành phần như retriever, reader và generator, cho phép tích hợp liền mạch với các công cụ như Elasticsearch và Hugging Face Transformers.
- Số sao GitHub: ~13.5k
- Triển khai: Docker, Kubernetes, Hugging Face Spaces
- Tính năng nổi bật: Thành phần mô-đun, tích hợp chặt chẽ với Hugging Face, hỗ trợ đa ngôn ngữ
- Trường hợp sử dụng: Hệ thống hỏi đáp cấp doanh nghiệp, chatbot, tìm kiếm tài liệu nội bộ (TrueFoundry, Anyscale, LobeHub)
2. LlamaIndex
LlamaIndex là một data framework kết nối các nguồn dữ liệu tùy biến với các mô hình ngôn ngữ lớn. Nó đơn giản hóa việc lập chỉ mục và truy vấn dữ liệu, giúp dễ dàng xây dựng các ứng dụng cần phản hồi theo ngữ cảnh.
- Số sao GitHub: ~13k
- Triển khai: Dựa trên Python, chạy ở mọi nơi với dữ liệu tệp hoặc web
- Tính năng nổi bật: Trừu tượng hóa đơn giản cho lập chỉ mục, truy xuất và định tuyến
- Trường hợp sử dụng: Trợ lý cá nhân, bot tri thức, demo RAG (GitHub)
3. LangChain
LangChain là một framework toàn diện cho phép nhà phát triển xây dựng các ứng dụng vận hành bởi mô hình ngôn ngữ. Nó cung cấp công cụ để xâu chuỗi các thành phần khác nhau như mẫu prompt, bộ nhớ và agents nhằm tạo ra các quy trình phức tạp.
- Số sao GitHub: ~72k
- Triển khai: Python, JavaScript, hỗ trợ trên mọi dịch vụ đám mây lớn
- Tính năng nổi bật: Chuỗi công cụ, agents, mẫu prompt, tích hợp phong phú
- Trường hợp sử dụng: Ứng dụng LLM end-to-end, data agents, luồng chat động
4. RAGFlow
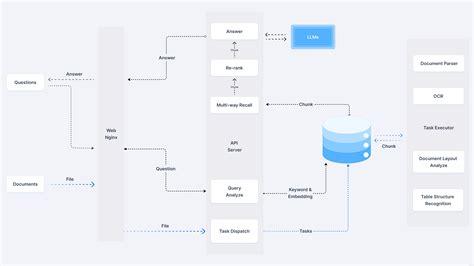
RAGFlow là một engine mã nguồn mở tập trung vào hiểu tài liệu sâu. Nó cung cấp workflow gọn nhẹ để doanh nghiệp triển khai hệ thống RAG, nhấn mạnh trả lời trung thực với trích dẫn từ các định dạng dữ liệu phức tạp.
- Số sao GitHub: ~1.1k
- Triển khai: Docker; hỗ trợ microservice dựa trên FastAPI
- Tính năng nổi bật: Trình trực quan hóa chunk, tích hợp Weaviate, cấu hình linh hoạt
- Trường hợp sử dụng: Backend RAG gọn nhẹ, nguyên mẫu doanh nghiệp (jina.ai)
5. txtAI
txtAI là một framework AI tất cả trong một kết hợp tìm kiếm ngữ nghĩa với khả năng RAG. Nó cho phép xây dựng các ứng dụng tìm kiếm, lập chỉ mục và truy xuất thông tin hiệu quả, hỗ trợ nhiều loại và định dạng dữ liệu.
- Số sao GitHub: ~3.9k
- Triển khai: Dựa trên Python; chạy chỉ với vài dòng mã.
- Tính năng nổi bật: Cực kỳ nhẹ, chế độ offline, hỗ trợ chấm điểm/xếp hạng
- Trường hợp sử dụng: Công cụ tìm kiếm dựa trên embedding, chat với PDF, H&Đ trên metadata (Introduction | LangChain, GitHub, GitHub)
6. Cognita
Cognita là một framework RAG mô-đun được thiết kế để dễ tùy biến và triển khai. Nó cung cấp giao diện frontend để thử nghiệm các cấu hình RAG khác nhau, phù hợp cho cả môi trường phát triển và sản xuất.
- Số sao GitHub: Đáng chú ý
- Triển khai: Docker + tích hợp TrueFoundry
- Tính năng nổi bật: Điều khiển qua API, sẵn sàng cho UI, dễ mở rộng
- Trường hợp sử dụng: Trợ lý AI hướng doanh nghiệp, chatbot dựa trên dữ liệu (TrueFoundry, LlamaIndex)
7. LLMWare
LLMWare cung cấp một framework thống nhất để xây dựng ứng dụng RAG cấp doanh nghiệp. Nó nhấn mạnh sử dụng các mô hình nhỏ, chuyên biệt có thể triển khai riêng tư, đảm bảo an toàn dữ liệu và tuân thủ.
- Số sao GitHub: ~2.5k
- Triển khai: Công cụ CLI, API, mẫu dự án có thể tùy chỉnh
- Tính năng nổi bật: Pipeline no-code, công cụ phân tích tài liệu
- Trường hợp sử dụng: Document agents, trợ lý tri thức (LinkedIn)
8. STORM
STORM là một trợ lý nghiên cứu mở rộng khái niệm RAG dựa trên dàn ý. Nó tập trung tạo ra các bài viết toàn diện bằng cách tổng hợp thông tin từ nhiều nguồn, lý tưởng cho các tác vụ sáng tạo nội dung.
- Số sao GitHub: Ngách
- Triển khai: Cài đặt từ mã nguồn
- Tính năng nổi bật: Engine lý luận Co-STORM, khám phá dựa trên đồ thị
- Trường hợp sử dụng: Thiết lập RAG tùy chỉnh, pipeline hỏi đáp nghiên cứu (GitHub)
9. R2R
R2R (Reason to Retrieve) là hệ thống truy xuất AI tiên tiến hỗ trợ RAG với các tính năng sẵn sàng cho sản xuất. Nó cung cấp khả năng nạp nội dung đa phương thức, tìm kiếm lai và tích hợp đồ thị tri thức, đáp ứng nhu cầu doanh nghiệp phức tạp.
- Số sao GitHub: Ngách
- Triển khai: REST API, hỗ trợ tìm kiếm lai và đồ thị
- Tính năng nổi bật: RAG đa phương thức, xác thực tài liệu
- Trường hợp sử dụng: Công cụ nghiên cứu AI, tác nhân học thuật (YouTube, Open Source For You, Weaviate Newsletter)
10. EmbedChain
EmbedChain là thư viện Python giúp đơn giản hóa việc tạo và triển khai ứng dụng AI sử dụng mô hình RAG. Nó hỗ trợ nhiều loại dữ liệu như PDF, hình ảnh và trang web, linh hoạt cho nhiều trường hợp sử dụng.
- Số sao GitHub: ~3.5k
- Triển khai: Thư viện Python, cũng có dạng SaaS được lưu trữ
- Tính năng nổi bật: Thiết lập ứng dụng bằng một lệnh, ưu tiên API
- Trường hợp sử dụng: Dựng thử nhanh, xây bot tri thức cho bất kỳ miền nào (LLMWare AI for Complex Enterprises)
11. RAGatouille
RAGatouille tích hợp các phương pháp truy xuất tiên tiến như ColBERT vào pipeline RAG. Nó cho phép thử nghiệm dạng mô-đun với các kỹ thuật truy xuất khác nhau, nâng cao tính linh hoạt và hiệu năng của hệ thống RAG.
- Số sao GitHub: Ngách nhưng đang tăng
- Triển khai: Gói Python
- Tính năng nổi bật: Thử nghiệm truy xuất, đầu vào mô-đun
- Trường hợp sử dụng: Đánh giá kỹ thuật truy xuất trong các pipeline RAG
12. Verba
Verba là một trợ lý cá nhân có thể tùy chỉnh, sử dụng RAG để truy vấn và tương tác với dữ liệu. Nó tích hợp với cơ sở dữ liệu nhận thức ngữ cảnh của Weaviate, cho phép truy xuất và tương tác thông tin hiệu quả.
- Số sao GitHub: Vừa phải
- Triển khai: Hỗ trợ cục bộ và đám mây
- Tính năng nổi bật: Bộ nhớ theo ngữ cảnh, H&Đ dữ liệu cá nhân
- Trường hợp sử dụng: Tự dựng trợ lý, khám phá dữ liệu (LinkedIn, Brandfetch)
13. Jina AI
Jina AI cung cấp các công cụ để xây dựng ứng dụng AI đa phương thức với lựa chọn triển khai có khả năng mở rộng. Nó hỗ trợ nhiều giao thức giao tiếp, phù hợp với nhà phát triển muốn xây và mở rộng dịch vụ AI.
- Số sao GitHub: ~18k (tổ chức chính)
- Triển khai: Docker, REST/gRPC/WebSocket APIs
- Tính năng nổi bật: Pipeline đa phương thức, tìm kiếm lai
- Trường hợp sử dụng: Ứng dụng cấp doanh nghiệp kết hợp văn bản, hình ảnh hoặc video
14. Neurite
Neurite là một framework RAG mới nổi đơn giản hóa việc xây dựng ứng dụng vận hành bởi AI. Sự nhấn mạnh vào trải nghiệm nhà phát triển và dựng thử nhanh khiến nó hấp dẫn cho thử nghiệm.
- Số sao GitHub: Nhỏ nhưng đầy hứa hẹn
- Triển khai: Thiết lập từ mã nguồn
- Tính năng nổi bật: Hợp nhất neural-symbolic
- Trường hợp sử dụng: Thử nghiệm nghiên cứu AI, hệ thống nguyên mẫu (GitHub, Hugging Face, GitHub)
15. LLM-App
LLM-App là một framework để xây dựng ứng dụng vận hành bởi các mô hình ngôn ngữ lớn. Nó cung cấp template và công cụ để tối ưu hóa quy trình phát triển, giúp tích hợp khả năng RAG vào nhiều ứng dụng dễ dàng hơn.
- Số sao GitHub: Mới nổi
- Triển khai: Triển khai dựa trên Git và công cụ CLI
- Tính năng nổi bật: Template khởi động ứng dụng, sẵn sàng cho OpenAI
- Trường hợp sử dụng: Dự án RAG cá nhân, công cụ hackathon
Mỗi framework mang lại các tính năng riêng biệt phù hợp với các trường hợp sử dụng và ưu tiên triển khai khác nhau. Tùy theo yêu cầu cụ thể của bạn—dễ triển khai, tùy biến hay khả năng tích hợp—hãy chọn framework phù hợp nhất với mục tiêu dự án.
Chọn RAG Framework phù hợp
Việc chọn framework RAG phù hợp phụ thuộc vào nhu cầu cụ thể của bạn: phân tích tài liệu pháp lý, nghiên cứu học thuật, hay phát triển cục bộ gọn nhẹ. Hãy dùng bảng này để nhanh chóng so sánh các framework RAG mã nguồn mở phổ biến dựa trên cách triển khai, mức độ tùy biến, hỗ trợ truy xuất nâng cao, khả năng tích hợp và mục đích sử dụng tốt nhất của từng công cụ.
|
Framework
|
Triển khai
|
Khả năng tùy biến
|
Truy xuất nâng cao
|
Hỗ trợ tích hợp
|
Phù hợp nhất cho
|
|
Haystack
|
Docker, K8s, Hugging Face
|
Cao
|
Có
|
Elasticsearch, Hugging Face
|
Tìm kiếm & H&Đ doanh nghiệp
|
|
LlamaIndex
|
Python (cục bộ/đám mây)
|
Cao
|
Có
|
LangChain, FAISS
|
Bot hiểu tài liệu
|
|
LangChain
|
Python, JS, Đám mây
|
Cao
|
Có
|
OpenAI, API, CSDL
|
Tác nhân & pipeline LLM
|
|
RAGFlow
|
Docker
|
Trung bình
|
Có
|
Weaviate
|
Tài liệu pháp lý/ có cấu trúc
|
|
txtAI
|
Cục bộ (Python)
|
Trung bình
|
Cơ bản
|
Transformers
|
Phát triển cục bộ nhẹ
|
|
Cognita
|
Docker + UI
|
Cao
|
Có
|
TrueFoundry
|
Công cụ kinh doanh dựa trên GUI
|
|
LLMWare
|
CLI, API
|
Cao
|
Có
|
LLM riêng tư
|
RAG doanh nghiệp riêng tư
|
|
STORM
|
Cài từ nguồn
|
Cao
|
Có
|
LangChain, LangGraph
|
Trợ lý nghiên cứu
|
|
R2R
|
REST API
|
Cao
|
Có
|
Đa phương thức
|
RAG học thuật & lai
|
|
EmbedChain
|
Python, SaaS
|
Trung bình
|
Cơ bản
|
Web, PDF, Hình ảnh
|
Dựng thử nhanh
|
|
RAGatouille
|
Python
|
Cao
|
Có
|
ColBERT
|
Thử nghiệm retriever
|
|
Verba
|
Đám mây/Cục bộ
|
Trung bình
|
Cơ bản
|
Weaviate
|
Trợ lý theo ngữ cảnh
|
|
Jina AI
|
Docker, REST/gRPC
|
Cao
|
Có
|
API đa phương thức
|
Ứng dụng đa phương thức mở rộng
|
|
Neurite
|
Thiết lập từ nguồn
|
Trung bình
|
Không
|
N/A
|
Thử nghiệm
|
|
LLM-App
|
CLI, Git
|
Trung bình
|
Không
|
OpenAI
|
Ứng dụng LLM cho hackathon
|
Những lỗi thường gặp khi triển khai RAG
Hệ thống RAG có thể rất mạnh, nhưng cũng có nhiều góc cạnh sắc. Nếu không cẩn thận, câu trả lời của mô hình còn tệ hơn cả khi bạn không dùng truy xuất. Dưới đây là bốn vấn đề phổ biến cần tránh—và cách làm thay thế.
1. Lập chỉ mục quá nhiều nội dung rác
Không phải mọi thứ đều cần đưa vào vector store. Đổ mọi tài liệu, bài blog hay chuỗi email vào có vẻ kỹ lưỡng, nhưng chỉ làm ô nhiễm tìm kiếm. Retriever sẽ kéo về ngữ cảnh giá trị thấp mà mô hình phải sàng lọc (thường bị dùng sai). Thay vào đó, hãy chọn lọc. Chỉ lập chỉ mục nội dung chính xác, viết tốt và hữu ích. Dọn sạch trước khi lưu trữ.
2. Bỏ qua giới hạn token
LLM có bộ nhớ ngắn. Nếu prompt của bạn cộng với mọi chunk truy xuất vượt quá giới hạn token của mô hình, sẽ có thứ bị cắt bỏ. Và "thứ đó" có thể là phần quan trọng. Thay vào đó, hãy giữ prompt gọn. Giới hạn số chunk truy xuất hoặc tóm tắt chúng trước khi gửi vào mô hình.
3. Tối ưu cho recall thay vì precision
Rất dễ bị cám dỗ truy xuất nhiều tài liệu để "bao phủ mọi thứ". Nhưng nếu kết quả thêm chỉ liên quan lỏng lẻo, bạn sẽ nhồi prompt bằng nội dung thừa. Mô hình bị xao nhãng hoặc tệ hơn, bị rối. Thay vào đó, hướng tới độ chính xác cao. Vài chunk thật sự liên quan tốt hơn danh sách dài những kết quả yếu.
4. Bay mù khi không có log
Khi mô hình trả lời kém, bạn có biết vì sao không? Nếu bạn không ghi log truy vấn, tài liệu truy xuất và prompt cuối cùng, bạn đang gỡ lỗi trong bóng tối. Thay vào đó, hãy log toàn bộ luồng RAG. Bao gồm đầu vào người dùng, nội dung truy xuất, những gì gửi tới mô hình và phản hồi của mô hình.
Kết luận
RAG không phải cây đũa thần cho mọi thứ, nhưng khi dùng đúng cách, đây là một trong những phương pháp hiệu quả nhất để khiến LLM trở nên thông minh, thực tiễn và bám dữ liệu quan trọng với doanh nghiệp của bạn.
Mấu chốt là hiểu rõ thứ bạn đang làm việc cùng. Chọn đúng framework là một phần, nhưng thành công phụ thuộc vào mức độ bạn hiểu dữ liệu và cách bạn tinh chỉnh pipeline truy xuất cẩn thận. Rác vào, rác ra vẫn luôn đúng, nhất là khi bạn xây hệ thống sinh ngôn ngữ chứ không chỉ truy xuất sự kiện.
Hãy lập chỉ mục chuẩn, theo dõi việc dùng token, và giám sát luồng từ đầu đến cuối. Khi mọi mảnh ghép khớp nhau, RAG có thể biến ứng dụng AI của bạn từ ấn tượng thành thực sự hữu ích.


Retrieval-augmented generation (RAG) đang nhanh chóng trở thành một trong những bước tiến thực tiễn nhất trong việc sử dụng các mô hình ngôn ngữ lớn. Đây không phải là một mô hình mới hay sự thay thế cho LLM; thay vào đó, đó là một hệ thống sáng tạo giúp LLM suy luận dựa trên các sự kiện được lấy từ các nguồn dữ liệu thực. Về cốt lõi, RAG giải quyết một số thách thức lớn nhất của AI sinh sinh: ảo giác, bộ nhớ hạn chế và kiến thức lỗi thời. Kết hợp truy xuất và sinh trong một pipeline duy nhất cho phép mô hình neo câu trả lời vào bối cảnh hiện tại, phù hợp, thường mang tính đặc thù theo doanh nghiệp hoặc lĩnh vực.
Sự thay đổi này ngày càng quan trọng. Trong môi trường doanh nghiệp, LLM được kỳ vọng phải trả lời chính xác và có khả năng giải thích. Nhà phát triển muốn đầu ra phản ánh tài liệu sản phẩm, wiki nội bộ hoặc phiếu hỗ trợ, không chỉ là kiến thức chung trên web. RAG giúp điều đó trở thành hiện thực.
Hướng dẫn này giải thích cách framework RAG hoạt động, vị trí của nó trong ngăn xếp AI của bạn và cách sử dụng với các công cụ và dữ liệu nền tảng.
RAG Framework là gì?
RAG là viết tắt của Retrieve, Augment, Generate. Đây là cách thông minh để cấp quyền truy cập vào kiến thức bên ngoài cho các mô hình ngôn ngữ lớn (LLM) mà không cần huấn luyện lại chúng.
Ý tưởng là: khi người dùng đặt câu hỏi, thay vì ném thẳng câu hỏi đó vào mô hình và hy vọng có câu trả lời tốt, RAG trước tiên sẽ truy xuất thông tin liên quan từ một cơ sở tri thức. Sau đó, nó bổ sung ngữ cảnh thêm vào prompt gốc. Cuối cùng, LLM sinh câu trả lời dựa trên câu hỏi và thông tin đã được thêm vào.
Cách tiếp cận này giúp khắc phục các hạn chế chủ chốt của LLM—như ảo giác, bộ nhớ ngắn (cửa sổ ngữ cảnh) và giới hạn kiến thức—bằng cách cắm dữ liệu thực, hiện thời và phù hợp theo thời gian thực.
Tại sao nên dùng RAG Framework?
Các LLM độc lập rất ấn tượng, nhưng vẫn có điểm mù. Chúng có thể bịa, quên nhanh và không biết gì mới hơn lần huấn luyện gần nhất. RAG thay đổi điều đó. Kết hợp LLM với truy xuất thời gian thực, bạn có được:
Tóm lại, RAG giúp bạn xây dựng các hệ thống AI thông minh và đáng tin cậy hơn với ít nỗ lực hơn nhiều.
Những RAG Frameworks mã nguồn mở tốt nhất
Hệ sinh thái RAG đang phát triển nhanh chóng, với hàng chục dự án mã nguồn mở giúp nhà phát triển xây dựng các ứng dụng được tăng cường truy xuất thông minh hơn. Dù bạn tìm kiếm một giải pháp cắm là chạy, đơn giản hay một pipeline full-stack với các thành phần có thể tùy chỉnh, khả năng cao là có công cụ phù hợp cho bạn.
Bên dưới, chúng tôi sẽ điểm qua các framework RAG mã nguồn mở hàng đầu. Mỗi mục nêu bật độ quan tâm trên GitHub, kiểu triển khai, điểm mạnh riêng, trường hợp sử dụng chính, và một hình minh họa để bạn nhanh chóng nắm bắt dự án.
1. Haystack
Haystack là một framework vững chắc, dạng mô-đun, được thiết kế để xây dựng các hệ thống NLP sẵn sàng cho sản xuất. Nó hỗ trợ nhiều thành phần như retriever, reader và generator, cho phép tích hợp liền mạch với các công cụ như Elasticsearch và Hugging Face Transformers.
2. LlamaIndex
LlamaIndex là một data framework kết nối các nguồn dữ liệu tùy biến với các mô hình ngôn ngữ lớn. Nó đơn giản hóa việc lập chỉ mục và truy vấn dữ liệu, giúp dễ dàng xây dựng các ứng dụng cần phản hồi theo ngữ cảnh.
3. LangChain
LangChain là một framework toàn diện cho phép nhà phát triển xây dựng các ứng dụng vận hành bởi mô hình ngôn ngữ. Nó cung cấp công cụ để xâu chuỗi các thành phần khác nhau như mẫu prompt, bộ nhớ và agents nhằm tạo ra các quy trình phức tạp.
4. RAGFlow
RAGFlow là một engine mã nguồn mở tập trung vào hiểu tài liệu sâu. Nó cung cấp workflow gọn nhẹ để doanh nghiệp triển khai hệ thống RAG, nhấn mạnh trả lời trung thực với trích dẫn từ các định dạng dữ liệu phức tạp.
5. txtAI
txtAI là một framework AI tất cả trong một kết hợp tìm kiếm ngữ nghĩa với khả năng RAG. Nó cho phép xây dựng các ứng dụng tìm kiếm, lập chỉ mục và truy xuất thông tin hiệu quả, hỗ trợ nhiều loại và định dạng dữ liệu.
6. Cognita
Cognita là một framework RAG mô-đun được thiết kế để dễ tùy biến và triển khai. Nó cung cấp giao diện frontend để thử nghiệm các cấu hình RAG khác nhau, phù hợp cho cả môi trường phát triển và sản xuất.
7. LLMWare
LLMWare cung cấp một framework thống nhất để xây dựng ứng dụng RAG cấp doanh nghiệp. Nó nhấn mạnh sử dụng các mô hình nhỏ, chuyên biệt có thể triển khai riêng tư, đảm bảo an toàn dữ liệu và tuân thủ.
8. STORM
STORM là một trợ lý nghiên cứu mở rộng khái niệm RAG dựa trên dàn ý. Nó tập trung tạo ra các bài viết toàn diện bằng cách tổng hợp thông tin từ nhiều nguồn, lý tưởng cho các tác vụ sáng tạo nội dung.
9. R2R
R2R (Reason to Retrieve) là hệ thống truy xuất AI tiên tiến hỗ trợ RAG với các tính năng sẵn sàng cho sản xuất. Nó cung cấp khả năng nạp nội dung đa phương thức, tìm kiếm lai và tích hợp đồ thị tri thức, đáp ứng nhu cầu doanh nghiệp phức tạp.
10. EmbedChain
EmbedChain là thư viện Python giúp đơn giản hóa việc tạo và triển khai ứng dụng AI sử dụng mô hình RAG. Nó hỗ trợ nhiều loại dữ liệu như PDF, hình ảnh và trang web, linh hoạt cho nhiều trường hợp sử dụng.
11. RAGatouille
RAGatouille tích hợp các phương pháp truy xuất tiên tiến như ColBERT vào pipeline RAG. Nó cho phép thử nghiệm dạng mô-đun với các kỹ thuật truy xuất khác nhau, nâng cao tính linh hoạt và hiệu năng của hệ thống RAG.
12. Verba
Verba là một trợ lý cá nhân có thể tùy chỉnh, sử dụng RAG để truy vấn và tương tác với dữ liệu. Nó tích hợp với cơ sở dữ liệu nhận thức ngữ cảnh của Weaviate, cho phép truy xuất và tương tác thông tin hiệu quả.
13. Jina AI
Jina AI cung cấp các công cụ để xây dựng ứng dụng AI đa phương thức với lựa chọn triển khai có khả năng mở rộng. Nó hỗ trợ nhiều giao thức giao tiếp, phù hợp với nhà phát triển muốn xây và mở rộng dịch vụ AI.
14. Neurite
Neurite là một framework RAG mới nổi đơn giản hóa việc xây dựng ứng dụng vận hành bởi AI. Sự nhấn mạnh vào trải nghiệm nhà phát triển và dựng thử nhanh khiến nó hấp dẫn cho thử nghiệm.
15. LLM-App
LLM-App là một framework để xây dựng ứng dụng vận hành bởi các mô hình ngôn ngữ lớn. Nó cung cấp template và công cụ để tối ưu hóa quy trình phát triển, giúp tích hợp khả năng RAG vào nhiều ứng dụng dễ dàng hơn.
Mỗi framework mang lại các tính năng riêng biệt phù hợp với các trường hợp sử dụng và ưu tiên triển khai khác nhau. Tùy theo yêu cầu cụ thể của bạn—dễ triển khai, tùy biến hay khả năng tích hợp—hãy chọn framework phù hợp nhất với mục tiêu dự án.
Chọn RAG Framework phù hợp
Việc chọn framework RAG phù hợp phụ thuộc vào nhu cầu cụ thể của bạn: phân tích tài liệu pháp lý, nghiên cứu học thuật, hay phát triển cục bộ gọn nhẹ. Hãy dùng bảng này để nhanh chóng so sánh các framework RAG mã nguồn mở phổ biến dựa trên cách triển khai, mức độ tùy biến, hỗ trợ truy xuất nâng cao, khả năng tích hợp và mục đích sử dụng tốt nhất của từng công cụ.
Framework
Triển khai
Khả năng tùy biến
Truy xuất nâng cao
Hỗ trợ tích hợp
Phù hợp nhất cho
Haystack
Docker, K8s, Hugging Face
Cao
Có
Elasticsearch, Hugging Face
Tìm kiếm & H&Đ doanh nghiệp
LlamaIndex
Python (cục bộ/đám mây)
Cao
Có
LangChain, FAISS
Bot hiểu tài liệu
LangChain
Python, JS, Đám mây
Cao
Có
OpenAI, API, CSDL
Tác nhân & pipeline LLM
RAGFlow
Docker
Trung bình
Có
Weaviate
Tài liệu pháp lý/ có cấu trúc
txtAI
Cục bộ (Python)
Trung bình
Cơ bản
Transformers
Phát triển cục bộ nhẹ
Cognita
Docker + UI
Cao
Có
TrueFoundry
Công cụ kinh doanh dựa trên GUI
LLMWare
CLI, API
Cao
Có
LLM riêng tư
RAG doanh nghiệp riêng tư
STORM
Cài từ nguồn
Cao
Có
LangChain, LangGraph
Trợ lý nghiên cứu
R2R
REST API
Cao
Có
Đa phương thức
RAG học thuật & lai
EmbedChain
Python, SaaS
Trung bình
Cơ bản
Web, PDF, Hình ảnh
Dựng thử nhanh
RAGatouille
Python
Cao
Có
ColBERT
Thử nghiệm retriever
Verba
Đám mây/Cục bộ
Trung bình
Cơ bản
Weaviate
Trợ lý theo ngữ cảnh
Jina AI
Docker, REST/gRPC
Cao
Có
API đa phương thức
Ứng dụng đa phương thức mở rộng
Neurite
Thiết lập từ nguồn
Trung bình
Không
N/A
Thử nghiệm
LLM-App
CLI, Git
Trung bình
Không
OpenAI
Ứng dụng LLM cho hackathon
Những lỗi thường gặp khi triển khai RAG
Hệ thống RAG có thể rất mạnh, nhưng cũng có nhiều góc cạnh sắc. Nếu không cẩn thận, câu trả lời của mô hình còn tệ hơn cả khi bạn không dùng truy xuất. Dưới đây là bốn vấn đề phổ biến cần tránh—và cách làm thay thế.
1. Lập chỉ mục quá nhiều nội dung rác
Không phải mọi thứ đều cần đưa vào vector store. Đổ mọi tài liệu, bài blog hay chuỗi email vào có vẻ kỹ lưỡng, nhưng chỉ làm ô nhiễm tìm kiếm. Retriever sẽ kéo về ngữ cảnh giá trị thấp mà mô hình phải sàng lọc (thường bị dùng sai). Thay vào đó, hãy chọn lọc. Chỉ lập chỉ mục nội dung chính xác, viết tốt và hữu ích. Dọn sạch trước khi lưu trữ.
2. Bỏ qua giới hạn token
LLM có bộ nhớ ngắn. Nếu prompt của bạn cộng với mọi chunk truy xuất vượt quá giới hạn token của mô hình, sẽ có thứ bị cắt bỏ. Và "thứ đó" có thể là phần quan trọng. Thay vào đó, hãy giữ prompt gọn. Giới hạn số chunk truy xuất hoặc tóm tắt chúng trước khi gửi vào mô hình.
3. Tối ưu cho recall thay vì precision
Rất dễ bị cám dỗ truy xuất nhiều tài liệu để "bao phủ mọi thứ". Nhưng nếu kết quả thêm chỉ liên quan lỏng lẻo, bạn sẽ nhồi prompt bằng nội dung thừa. Mô hình bị xao nhãng hoặc tệ hơn, bị rối. Thay vào đó, hướng tới độ chính xác cao. Vài chunk thật sự liên quan tốt hơn danh sách dài những kết quả yếu.
4. Bay mù khi không có log
Khi mô hình trả lời kém, bạn có biết vì sao không? Nếu bạn không ghi log truy vấn, tài liệu truy xuất và prompt cuối cùng, bạn đang gỡ lỗi trong bóng tối. Thay vào đó, hãy log toàn bộ luồng RAG. Bao gồm đầu vào người dùng, nội dung truy xuất, những gì gửi tới mô hình và phản hồi của mô hình.
Kết luận
RAG không phải cây đũa thần cho mọi thứ, nhưng khi dùng đúng cách, đây là một trong những phương pháp hiệu quả nhất để khiến LLM trở nên thông minh, thực tiễn và bám dữ liệu quan trọng với doanh nghiệp của bạn.
Mấu chốt là hiểu rõ thứ bạn đang làm việc cùng. Chọn đúng framework là một phần, nhưng thành công phụ thuộc vào mức độ bạn hiểu dữ liệu và cách bạn tinh chỉnh pipeline truy xuất cẩn thận. Rác vào, rác ra vẫn luôn đúng, nhất là khi bạn xây hệ thống sinh ngôn ngữ chứ không chỉ truy xuất sự kiện.
Hãy lập chỉ mục chuẩn, theo dõi việc dùng token, và giám sát luồng từ đầu đến cuối. Khi mọi mảnh ghép khớp nhau, RAG có thể biến ứng dụng AI của bạn từ ấn tượng thành thực sự hữu ích.