Retrieval-augmented generation (RAG) wordt razendsnel een van de meest praktische evoluties in het gebruik van large language models. Het is geen nieuw model of vervanging van LLM’s; het is een innovatief systeem dat ze helpt redeneren met feiten uit echte databronnen. In de kern lost RAG enkele van de grootste uitdagingen van generatieve AI op: hallucinaties, beperkte geheugenvensters en verouderde kennis. Door retrieval en generatie in één pipeline te combineren, kunnen modellen hun antwoorden verankeren in een actuele, relevante context, vaak specifiek voor een bedrijf of domein.
Die verschuiving is belangrijker dan ooit. In enterprise-omgevingen verwacht men van LLM’s nauwkeurigheid en verklaarbaarheid. Developers willen output die productdocumentatie, interne wiki’s of supporttickets weerspiegelt, niet generieke webkennis. RAG maakt dat mogelijk.
Deze gids legt uit hoe het RAG-framework werkt, waar het past in je AI-stack en hoe je het gebruikt met basistools en data.
Wat is een RAG-framework?
RAG staat voor Retrieve, Augment, Generate. Het is een slimme manier om large language models (LLM’s) toegang te geven tot externe kennis zonder ze te hertrainen.
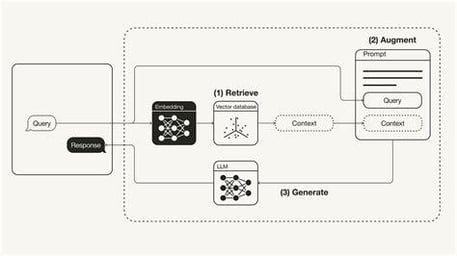
Het idee: wanneer een gebruiker een vraag stelt, gooi je die niet direct naar het model in de hoop op een goed antwoord. RAG haalt eerst relevante informatie op uit een kennisbank. Daarna verrijkt het de oorspronkelijke prompt met die extra context. Tot slot genereert het LLM een antwoord met de vraag én de toegevoegde informatie.
Deze aanpak helpt belangrijke beperkingen van LLM’s op te lossen—zoals hallucinaties, korte contextvensters en knowledge cutoffs—door realtime echte, actuele en relevante data in te pluggen.
Waarom een RAG-framework gebruiken?
Losse LLM’s zijn indrukwekkend, maar hebben blinde vlekken. Ze hallucineren, vergeten dingen en weten niets nieuwer dan hun laatste trainingsrun. RAG verandert dat. Door LLM’s te combineren met realtime retrieval krijg je:
- Feitelijke nauwkeurigheid: Antwoorden zijn gebaseerd op jouw echte data, niet op giswerk.
- Domeinrelevantie: Je kunt niche- of interne kennis injecteren.
- Geen retraining nodig: Werk gewoon je kennisbank bij—fijnslijpen is niet vereist.
- Schaalbaarheid: Ideaal voor chatbots, zoektools, supportassistenten en meer.
Kortom: met RAG bouw je slimmere, betrouwbaardere AI-systemen met veel minder moeite.
De beste open-source RAG-frameworks
Het RAG-ecosysteem groeit snel, met tientallen open-sourceprojecten die developers helpen om slimmere, retrieval-augmented applicaties te bouwen. Of je nu zoekt naar iets plugbaar en eenvoudig of een full-stack pipeline met aanpasbare componenten, er is waarschijnlijk een tool voor jou.
Hieronder bespreken we de beste open-source RAG-frameworks. Elke vermelding belicht de tractie op GitHub, deploystijl, unieke sterke punten, primaire usecases en een visual om je snel gevoel bij het project te geven.
1. Haystack
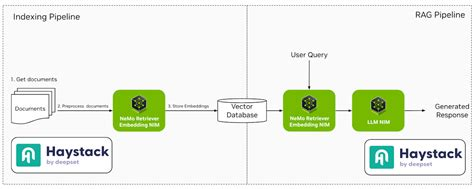
Haystack is een robuust, modulair framework voor het bouwen van productieklare NLP-systemen. Het ondersteunt diverse componenten zoals retrievers, readers en generators, en integreert naadloos met tools als Elasticsearch en Hugging Face Transformers.
- GitHub-sterren: ~13,5k
- Deployment: Docker, Kubernetes, Hugging Face Spaces
- Opvallende features: Modulaire componenten, sterke Hugging Face-integratie, meertalige ondersteuning
- Usecases: Enterprise-waardige QA-systemen, chatbots, interne documentzoek (TrueFoundry, Anyscale, LobeHub)
2. LlamaIndex
LlamaIndex is een dataframework dat aangepaste databronnen koppelt aan large language models. Het vereenvoudigt het indexeren en bevragen van data, waardoor je makkelijker applicaties bouwt die contextbewuste antwoorden vereisen.
- GitHub-sterren: ~13k
- Deployment: Python-based, draait overal met bestands- of webdata
- Opvallende features: Eenvoudige abstracties voor indexeren, retrieval en routing
- Usecases: Persoonlijke assistenten, knowledge bots, RAG-demo’s (GitHub)
3. LangChain
LangChain is een uitgebreid framework waarmee developers applicaties kunnen bouwen die worden aangedreven door language models. Het biedt tools om verschillende componenten te ketenen, zoals prompttemplates, geheugen en agents, om complexe workflows te creëren.
- GitHub-sterren: ~72k
- Deployment: Python, JavaScript, ondersteund op alle grote clouds
- Opvallende features: Toolchaining, agents, prompttemplates, talloze integraties
- Usecases: End-to-end LLM-applicaties, data-agents, dynamische chatflows
4. RAGFlow
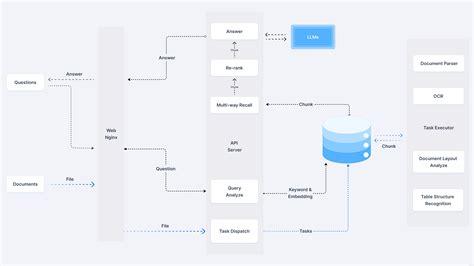
RAGFlow is een open-source engine gericht op diepgaand documentbegrip. Het biedt een gestroomlijnde workflow voor bedrijven om RAG-systemen te implementeren, met nadruk op waarheidsgetrouwe vraag-antwoordparen, onderbouwd met citaties uit complexe dataformaten.
- GitHub-sterren: ~1,1k
- Deployment: Docker; ondersteunt FastAPI-gebaseerde microservices
- Opvallende features: Chunkvisualizer, Weaviate-integratie, flexibele configs
- Usecases: Lichtgewicht RAG-backends, enterprise-prototypes (jina.ai)
5. txtAI
txtAI is een all-in-one AI-framework dat semantisch zoeken combineert met RAG-mogelijkheden. Het laat je applicaties bouwen die efficiënt zoeken, indexeren en informatie ophalen, met ondersteuning voor diverse datatypes en -formaten.
- GitHub-sterren: ~3,9k
- Deployment: Python-based; draait met een paar regels code.
- Opvallende features: Zeer lichtgewicht, offline modus, scoring/ranking-ondersteuning
- Usecases: Embedding-gebaseerde zoekmachines, chatten met PDF’s, metadata Q&A (Introduction | LangChain, GitHub, GitHub)
6. Cognita
Cognita is een modulair RAG-framework dat is ontworpen voor eenvoudige aanpassing en deployment. Het biedt een frontendinterface om te experimenteren met verschillende RAG-configuraties, geschikt voor zowel ontwikkeling als productie.
- GitHub-sterren: Opmerkelijk
- Deployment: Docker + TrueFoundry-integraties
- Opvallende features: API-gedreven, UI-klaar, eenvoudig te schalen
- Usecases: Bedrijfsgerichte AI-assistenten, datagestuurde chatbots (TrueFoundry, LlamaIndex)
7. LLMWare
LLMWare biedt een uniform framework voor het bouwen van enterprise-grade RAG-applicaties. De nadruk ligt op kleine, gespecialiseerde modellen die privé kunnen worden ingezet, met waarborging van databeveiliging en compliance.
- GitHub-sterren: ~2,5k
- Deployment: CLI-tool, API’s, aanpasbare projectsjablonen
- Opvallende features: No-code pipelines, documentparsing-tools
- Usecases: Documentagents, knowledge-assistenten (LinkedIn)
8. STORM
STORM is een researchassistent die het concept van outline-gedreven RAG uitbreidt. Het focust op het genereren van uitgebreide artikelen door informatie uit verschillende bronnen te synthetiseren, ideaal voor contentcreatie.
- GitHub-sterren: Niche
- Deployment: Installatie via broncode
- Opvallende features: Co-STORM-resoningengine, graafgebaseerde verkenning
- Usecases: Aangepaste RAG-setups, research-QA-pipelines (GitHub)
9. R2R
R2R (Reason to Retrieve) is een geavanceerd AI-retrievalsysteem met productieklare features voor RAG. Het biedt multimodale contentinname, hybride search en kennisgraafintegratie voor complexe enterprisebehoeften.
- GitHub-sterren: Niche
- Deployment: REST API, ondersteunt hybride en graafzoek
- Opvallende features: Multimodale RAG, documentvalidatie
- Usecases: AI-researchtools, academische agents (YouTube, Open Source For You, Weaviate Newsletter)
10. EmbedChain
EmbedChain is een Python-bibliotheek die het bouwen en deployen van AI-applicaties met RAG-modellen vereenvoudigt. Het ondersteunt diverse datatypes, waaronder PDF’s, afbeeldingen en webpagina’s, en is daardoor veelzijdig inzetbaar.
- GitHub-sterren: ~3,5k
- Deployment: Python-lib, ook beschikbaar als hosted SaaS
- Opvallende features: App-setup met één commando, API-first
- Usecases: Snel prototypen, knowledge bots bouwen voor elk domein (LLMWare AI for Complex Enterprises)
11. RAGatouille
RAGatouille integreert geavanceerde retrievalmethoden zoals ColBERT in RAG-pipelines. Het maakt modulaire experimenten met verschillende retrievaltechnieken mogelijk, wat de flexibiliteit en performance van RAG-systemen vergroot.
- GitHub-sterren: Niche maar groeiend
- Deployment: Python-pakket
- Opvallende features: Retrievalexperimenten, modulaire inputs
- Usecases: Retrievaltechnieken evalueren in RAG-pipelines
12. Verba
Verba is een aanpasbare persoonlijke assistent die RAG gebruikt om data te bevragen en ermee te interageren. Het integreert met Weaviate’s contextbewuste database, wat efficiënte informatieophaal en interactie mogelijk maakt.
- GitHub-sterren: Bescheiden
- Deployment: Lokaal en cloud ondersteund
- Opvallende features: Contextueel geheugen, Q&A over persoonlijke data
- Usecases: Bouw-je-eigen assistent, data-exploratie (LinkedIn, Brandfetch)
13. Jina AI
Jina AI biedt tools voor het bouwen van multimodale AI-applicaties met schaalbare deploymentopties. Het ondersteunt diverse communicatieprotocollen en is geschikt voor developers die AI-services willen bouwen en schalen.
- GitHub-sterren: ~18k (hoofdorg)
- Deployment: Docker, REST/gRPC/WebSocket-API’s
- Opvallende features: Multimodale pipelines, hybride zoek
- Usecases: Enterprise-waardige apps die tekst, beeld of video combineren
14. Neurite
Neurite is een opkomend RAG-framework dat het bouwen van AI-gedreven applicaties vereenvoudigt. De nadruk op developer experience en snel prototypen maakt het aantrekkelijk voor experimenten.
- GitHub-sterren: Klein maar veelbelovend
- Deployment: Broninstallatie
- Opvallende features: Neuraal-symbolische fusie
- Usecases: AI-onderzoeksexperimenten, prototypesystemen (GitHub, Hugging Face, GitHub)
15. LLM-App
LLM-App is een framework voor het bouwen van applicaties die worden aangedreven door large language models. Het biedt sjablonen en tools om het ontwikkelproces te stroomlijnen, waardoor het makkelijker wordt RAG-mogelijkheden te integreren.
- GitHub-sterren: Opkomend
- Deployment: Git-gebaseerde deployment en CLI-tools
- Opvallende features: Appstartersjablonen, OpenAI-klaar
- Usecases: Persoonlijke RAG-projecten, hackathontools
Elk framework biedt unieke features voor verschillende usecases en deploymentvoorkeuren. Afhankelijk van je eisen—eenvoudige deployment, maatwerk of integratiemogelijkheden—kies je het framework dat het beste aansluit bij de doelen van je project.
Het juiste RAG-framework kiezen
De juiste keuze hangt af van je specifieke behoeften: juridische documentanalyse, academisch onderzoek of lichtgewicht lokale ontwikkeling. Gebruik deze tabel om populaire open-source RAG-frameworks snel te vergelijken op deployment, mate van aanpasbaarheid, ondersteuning voor geavanceerde retrieval, integratiemogelijkheden en het ideale toepassingsgebied van elke tool.
|
Framework
|
Deployment
|
Aanpasbaarheid
|
Geavanceerde retrieval
|
Integratie-ondersteuning
|
Beste voor
|
|
Haystack
|
Docker, K8s, Hugging Face
|
Hoog
|
Ja
|
Elasticsearch, Hugging Face
|
Enterprise search & QA
|
|
LlamaIndex
|
Python (lokaal/cloud)
|
Hoog
|
Ja
|
LangChain, FAISS
|
Document-bewuste bots
|
|
LangChain
|
Python, JS, Cloud
|
Hoog
|
Ja
|
OpenAI, API’s, DB’s
|
LLM-agents & pipelines
|
|
RAGFlow
|
Docker
|
Middel
|
Ja
|
Weaviate
|
Juridische of gestructureerde docs
|
|
txtAI
|
Lokaal (Python)
|
Middel
|
Basis
|
Transformers
|
Lichtgewicht lokaal dev
|
|
Cognita
|
Docker + UI
|
Hoog
|
Ja
|
TrueFoundry
|
GUI-gebaseerde businesstools
|
|
LLMWare
|
CLI, API’s
|
Hoog
|
Ja
|
Private LLM’s
|
Private enterprise RAG
|
|
STORM
|
Broninstallatie
|
Hoog
|
Ja
|
LangChain, LangGraph
|
Researchassistenten
|
|
R2R
|
REST API
|
Hoog
|
Ja
|
Multimodaal
|
Academische & hybride RAG
|
|
EmbedChain
|
Python, SaaS
|
Middel
|
Basis
|
Web, PDF, Afbeeldingen
|
Snel prototypen
|
|
RAGatouille
|
Python
|
Hoog
|
Ja
|
ColBERT
|
Retriever-experimentatie
|
|
Verba
|
Cloud/Lokaal
|
Middel
|
Basis
|
Weaviate
|
Contextuele assistenten
|
|
Jina AI
|
Docker, REST/gRPC
|
Hoog
|
Ja
|
Multimodale API’s
|
Schaalbare multimodale apps
|
|
Neurite
|
Broninstallatie
|
Middel
|
Nee
|
n.v.t.
|
Experimentatie
|
|
LLM-App
|
CLI, Git
|
Middel
|
Nee
|
OpenAI
|
Hackathon-LLM-apps
|
Veelvoorkomende valkuilen bij het implementeren van RAG
RAG-systemen kunnen robuust zijn, maar ze hebben ook scherpe randjes. Als je niet oplet, kunnen de antwoorden van je model slechter uitpakken dan zonder retrieval. Dit zijn vier veelvoorkomende issues om te vermijden—en wat je in plaats daarvan doet.
1. Te veel rommel indexeren
Niet alles hoeft in je vectorstore. Het voelt misschien grondig om elk document, blogbericht of e-maildraad te dumpen, maar je vervuilt er je zoekresultaten mee. De retriever haalt laagwaardige context op waar het model doorheen moet (en vaak verkeerd gebruikt). Wees in plaats daarvan selectief. Indexeer alleen content die accuraat, goed geschreven en nuttig is. Ruim op vóór je opslaat.
2. Tokenlimieten negeren
LLM’s hebben een kort geheugen. Als je prompt plus alle opgehaalde chunks de tokenlimiet van het model overschrijdt, valt er iets af. En dat kan net het belangrijke deel zijn. Houd prompts daarom strak. Beperk het aantal opgehaalde chunks of vat ze samen voordat je ze naar het model stuurt.
3. Optimaliseren voor recall, niet voor precisie
Het is verleidelijk om meer documenten op te halen om “alles te dekken”. Maar als de extra resultaten slechts vaag gerelateerd zijn, vul je de prompt met ruis. Het model raakt afgeleid of, erger nog, in de war. Streef in plaats daarvan naar hoge precisie. Een paar zeer relevante chunks zijn beter dan een lange lijst zwakke matches.
4. Vliegen zonder logs
Weet je waarom het model een slecht antwoord gaf? Als je de query, de opgehaalde documenten en de uiteindelijke prompt niet logt, debug je in het donker. Log in plaats daarvan de volledige RAG-flow. Dus: userinput, opgehaalde content, wat er naar het model is gestuurd en de modelrespons.
Conclusie
RAG is geen magische oplossing voor alles, maar als je het goed inzet, is het een van de effectiefste manieren om LLM’s slimmer, praktischer en beter verankerd in jouw relevante data te maken.
De sleutel is weten waar je mee werkt. Het juiste framework kiezen is daar een deel van, maar succes hangt vooral af van hoe goed je je data begrijpt en hoe zorgvuldig je je retrievalpipeline afstelt. Garbage in, garbage out blijft gelden—zeker wanneer je systemen bouwt die taal genereren en niet alleen feiten ophalen.
Zorg dat je indexing klopt, let op je tokenverbruik en monitor de flow end-to-end. Als al die stukjes klikken, kan RAG je AI-applicaties transformeren van indrukwekkend naar echt behulpzaam.




Retrieval-augmented generation (RAG) wordt razendsnel een van de meest praktische evoluties in het gebruik van large language models. Het is geen nieuw model of vervanging van LLM’s; het is een innovatief systeem dat ze helpt redeneren met feiten uit echte databronnen. In de kern lost RAG enkele van de grootste uitdagingen van generatieve AI op: hallucinaties, beperkte geheugenvensters en verouderde kennis. Door retrieval en generatie in één pipeline te combineren, kunnen modellen hun antwoorden verankeren in een actuele, relevante context, vaak specifiek voor een bedrijf of domein.
Die verschuiving is belangrijker dan ooit. In enterprise-omgevingen verwacht men van LLM’s nauwkeurigheid en verklaarbaarheid. Developers willen output die productdocumentatie, interne wiki’s of supporttickets weerspiegelt, niet generieke webkennis. RAG maakt dat mogelijk.
Deze gids legt uit hoe het RAG-framework werkt, waar het past in je AI-stack en hoe je het gebruikt met basistools en data.
Wat is een RAG-framework?
RAG staat voor Retrieve, Augment, Generate. Het is een slimme manier om large language models (LLM’s) toegang te geven tot externe kennis zonder ze te hertrainen.
Het idee: wanneer een gebruiker een vraag stelt, gooi je die niet direct naar het model in de hoop op een goed antwoord. RAG haalt eerst relevante informatie op uit een kennisbank. Daarna verrijkt het de oorspronkelijke prompt met die extra context. Tot slot genereert het LLM een antwoord met de vraag én de toegevoegde informatie.
Deze aanpak helpt belangrijke beperkingen van LLM’s op te lossen—zoals hallucinaties, korte contextvensters en knowledge cutoffs—door realtime echte, actuele en relevante data in te pluggen.
Waarom een RAG-framework gebruiken?
Losse LLM’s zijn indrukwekkend, maar hebben blinde vlekken. Ze hallucineren, vergeten dingen en weten niets nieuwer dan hun laatste trainingsrun. RAG verandert dat. Door LLM’s te combineren met realtime retrieval krijg je:
Kortom: met RAG bouw je slimmere, betrouwbaardere AI-systemen met veel minder moeite.
De beste open-source RAG-frameworks
Het RAG-ecosysteem groeit snel, met tientallen open-sourceprojecten die developers helpen om slimmere, retrieval-augmented applicaties te bouwen. Of je nu zoekt naar iets plugbaar en eenvoudig of een full-stack pipeline met aanpasbare componenten, er is waarschijnlijk een tool voor jou.
Hieronder bespreken we de beste open-source RAG-frameworks. Elke vermelding belicht de tractie op GitHub, deploystijl, unieke sterke punten, primaire usecases en een visual om je snel gevoel bij het project te geven.
1. Haystack
Haystack is een robuust, modulair framework voor het bouwen van productieklare NLP-systemen. Het ondersteunt diverse componenten zoals retrievers, readers en generators, en integreert naadloos met tools als Elasticsearch en Hugging Face Transformers.
2. LlamaIndex
LlamaIndex is een dataframework dat aangepaste databronnen koppelt aan large language models. Het vereenvoudigt het indexeren en bevragen van data, waardoor je makkelijker applicaties bouwt die contextbewuste antwoorden vereisen.
3. LangChain
LangChain is een uitgebreid framework waarmee developers applicaties kunnen bouwen die worden aangedreven door language models. Het biedt tools om verschillende componenten te ketenen, zoals prompttemplates, geheugen en agents, om complexe workflows te creëren.
4. RAGFlow
RAGFlow is een open-source engine gericht op diepgaand documentbegrip. Het biedt een gestroomlijnde workflow voor bedrijven om RAG-systemen te implementeren, met nadruk op waarheidsgetrouwe vraag-antwoordparen, onderbouwd met citaties uit complexe dataformaten.
5. txtAI
txtAI is een all-in-one AI-framework dat semantisch zoeken combineert met RAG-mogelijkheden. Het laat je applicaties bouwen die efficiënt zoeken, indexeren en informatie ophalen, met ondersteuning voor diverse datatypes en -formaten.
6. Cognita
Cognita is een modulair RAG-framework dat is ontworpen voor eenvoudige aanpassing en deployment. Het biedt een frontendinterface om te experimenteren met verschillende RAG-configuraties, geschikt voor zowel ontwikkeling als productie.
7. LLMWare
LLMWare biedt een uniform framework voor het bouwen van enterprise-grade RAG-applicaties. De nadruk ligt op kleine, gespecialiseerde modellen die privé kunnen worden ingezet, met waarborging van databeveiliging en compliance.
8. STORM
STORM is een researchassistent die het concept van outline-gedreven RAG uitbreidt. Het focust op het genereren van uitgebreide artikelen door informatie uit verschillende bronnen te synthetiseren, ideaal voor contentcreatie.
9. R2R
R2R (Reason to Retrieve) is een geavanceerd AI-retrievalsysteem met productieklare features voor RAG. Het biedt multimodale contentinname, hybride search en kennisgraafintegratie voor complexe enterprisebehoeften.
10. EmbedChain
EmbedChain is een Python-bibliotheek die het bouwen en deployen van AI-applicaties met RAG-modellen vereenvoudigt. Het ondersteunt diverse datatypes, waaronder PDF’s, afbeeldingen en webpagina’s, en is daardoor veelzijdig inzetbaar.
11. RAGatouille
RAGatouille integreert geavanceerde retrievalmethoden zoals ColBERT in RAG-pipelines. Het maakt modulaire experimenten met verschillende retrievaltechnieken mogelijk, wat de flexibiliteit en performance van RAG-systemen vergroot.
12. Verba
Verba is een aanpasbare persoonlijke assistent die RAG gebruikt om data te bevragen en ermee te interageren. Het integreert met Weaviate’s contextbewuste database, wat efficiënte informatieophaal en interactie mogelijk maakt.
13. Jina AI
Jina AI biedt tools voor het bouwen van multimodale AI-applicaties met schaalbare deploymentopties. Het ondersteunt diverse communicatieprotocollen en is geschikt voor developers die AI-services willen bouwen en schalen.
14. Neurite
Neurite is een opkomend RAG-framework dat het bouwen van AI-gedreven applicaties vereenvoudigt. De nadruk op developer experience en snel prototypen maakt het aantrekkelijk voor experimenten.
15. LLM-App
LLM-App is een framework voor het bouwen van applicaties die worden aangedreven door large language models. Het biedt sjablonen en tools om het ontwikkelproces te stroomlijnen, waardoor het makkelijker wordt RAG-mogelijkheden te integreren.
Elk framework biedt unieke features voor verschillende usecases en deploymentvoorkeuren. Afhankelijk van je eisen—eenvoudige deployment, maatwerk of integratiemogelijkheden—kies je het framework dat het beste aansluit bij de doelen van je project.
Het juiste RAG-framework kiezen
De juiste keuze hangt af van je specifieke behoeften: juridische documentanalyse, academisch onderzoek of lichtgewicht lokale ontwikkeling. Gebruik deze tabel om populaire open-source RAG-frameworks snel te vergelijken op deployment, mate van aanpasbaarheid, ondersteuning voor geavanceerde retrieval, integratiemogelijkheden en het ideale toepassingsgebied van elke tool.
Framework
Deployment
Aanpasbaarheid
Geavanceerde retrieval
Integratie-ondersteuning
Beste voor
Haystack
Docker, K8s, Hugging Face
Hoog
Ja
Elasticsearch, Hugging Face
Enterprise search & QA
LlamaIndex
Python (lokaal/cloud)
Hoog
Ja
LangChain, FAISS
Document-bewuste bots
LangChain
Python, JS, Cloud
Hoog
Ja
OpenAI, API’s, DB’s
LLM-agents & pipelines
RAGFlow
Docker
Middel
Ja
Weaviate
Juridische of gestructureerde docs
txtAI
Lokaal (Python)
Middel
Basis
Transformers
Lichtgewicht lokaal dev
Cognita
Docker + UI
Hoog
Ja
TrueFoundry
GUI-gebaseerde businesstools
LLMWare
CLI, API’s
Hoog
Ja
Private LLM’s
Private enterprise RAG
STORM
Broninstallatie
Hoog
Ja
LangChain, LangGraph
Researchassistenten
R2R
REST API
Hoog
Ja
Multimodaal
Academische & hybride RAG
EmbedChain
Python, SaaS
Middel
Basis
Web, PDF, Afbeeldingen
Snel prototypen
RAGatouille
Python
Hoog
Ja
ColBERT
Retriever-experimentatie
Verba
Cloud/Lokaal
Middel
Basis
Weaviate
Contextuele assistenten
Jina AI
Docker, REST/gRPC
Hoog
Ja
Multimodale API’s
Schaalbare multimodale apps
Neurite
Broninstallatie
Middel
Nee
n.v.t.
Experimentatie
LLM-App
CLI, Git
Middel
Nee
OpenAI
Hackathon-LLM-apps
Veelvoorkomende valkuilen bij het implementeren van RAG
RAG-systemen kunnen robuust zijn, maar ze hebben ook scherpe randjes. Als je niet oplet, kunnen de antwoorden van je model slechter uitpakken dan zonder retrieval. Dit zijn vier veelvoorkomende issues om te vermijden—en wat je in plaats daarvan doet.
1. Te veel rommel indexeren
Niet alles hoeft in je vectorstore. Het voelt misschien grondig om elk document, blogbericht of e-maildraad te dumpen, maar je vervuilt er je zoekresultaten mee. De retriever haalt laagwaardige context op waar het model doorheen moet (en vaak verkeerd gebruikt). Wees in plaats daarvan selectief. Indexeer alleen content die accuraat, goed geschreven en nuttig is. Ruim op vóór je opslaat.
2. Tokenlimieten negeren
LLM’s hebben een kort geheugen. Als je prompt plus alle opgehaalde chunks de tokenlimiet van het model overschrijdt, valt er iets af. En dat kan net het belangrijke deel zijn. Houd prompts daarom strak. Beperk het aantal opgehaalde chunks of vat ze samen voordat je ze naar het model stuurt.
3. Optimaliseren voor recall, niet voor precisie
Het is verleidelijk om meer documenten op te halen om “alles te dekken”. Maar als de extra resultaten slechts vaag gerelateerd zijn, vul je de prompt met ruis. Het model raakt afgeleid of, erger nog, in de war. Streef in plaats daarvan naar hoge precisie. Een paar zeer relevante chunks zijn beter dan een lange lijst zwakke matches.
4. Vliegen zonder logs
Weet je waarom het model een slecht antwoord gaf? Als je de query, de opgehaalde documenten en de uiteindelijke prompt niet logt, debug je in het donker. Log in plaats daarvan de volledige RAG-flow. Dus: userinput, opgehaalde content, wat er naar het model is gestuurd en de modelrespons.
Conclusie
RAG is geen magische oplossing voor alles, maar als je het goed inzet, is het een van de effectiefste manieren om LLM’s slimmer, praktischer en beter verankerd in jouw relevante data te maken.
De sleutel is weten waar je mee werkt. Het juiste framework kiezen is daar een deel van, maar succes hangt vooral af van hoe goed je je data begrijpt en hoe zorgvuldig je je retrievalpipeline afstelt. Garbage in, garbage out blijft gelden—zeker wanneer je systemen bouwt die taal genereren en niet alleen feiten ophalen.
Zorg dat je indexing klopt, let op je tokenverbruik en monitor de flow end-to-end. Als al die stukjes klikken, kan RAG je AI-applicaties transformeren van indrukwekkend naar echt behulpzaam.