Geri getirme destekli üretim (RAG), büyük dil modellerinden yararlanmanın en pratik evrimlerinden biri hâline geliyor. Bu, yeni bir model ya da LLM’lerin yerine geçen bir şey değil; aksine, gerçek veri kaynaklarından çekilen olgularla akıl yürütmelerine yardımcı olan yenilikçi bir sistem. Özünde RAG, üretken yapay zekânın en büyük sorunlarından bazılarını çözer: halüsinasyonlar, sınırlı bellek ve güncelliğini yitirmiş bilgi. Geri getirme ve üretimi tek bir boru hattında birleştirmek, modellerin yanıtlarını çoğu zaman bir işletmeye veya alana özgü olan güncel ve ilgili bir bağlama oturtmasını sağlar.
Bu dönüşüm her zamankinden daha önemli. Kurumsal ortamlarda LLM’lerin doğruluk ve açıklanabilirlikle yanıt vermesi beklenir. Geliştiriciler, çıktılarda genel web bilgisini değil, ürün dokümantasyonunu, iç wiki’leri veya destek kayıtlarını görmek ister. RAG bunu mümkün kılar.
Bu rehber, RAG çerçevesinin nasıl çalıştığını, yapay zekâ yığınınıza nerede uyduğunu ve temel araçlar ile verilerle nasıl kullanılacağını açıklar.
RAG Çerçevesi Nedir?
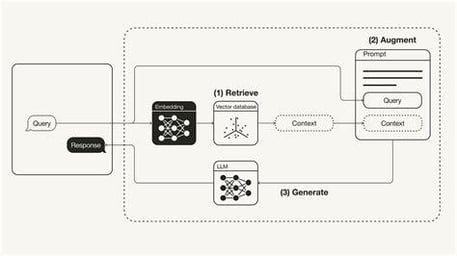
RAG, Retrieve, Augment, Generate ifadelerinin kısaltmasıdır. Büyük dil modellerine (LLM’ler) yeniden eğitmeden haricî bilgiye erişim vermenin akıllı bir yoludur.
Fikir şu: Bir kullanıcı soru sorduğunda, soruyu doğrudan modele gönderip iyi bir yanıt ummak yerine RAG önce bir bilgi tabanından ilgili bilgileri geri getirir. Ardından özgün istemi bu ek bağlamla zenginleştirir. Son olarak LLM, soruyu ve eklenen bilgiyi kullanarak bir yanıt üretir.
Bu yaklaşım, gerçek, güncel ve ilgili verileri anlık olarak devreye alarak halüsinasyonlar, kısa hafıza (bağlam pencereleri) ve bilgi kesim tarihleri gibi temel LLM sınırlamalarını aşmaya yardımcı olur.
Neden Bir RAG Çerçevesi Kullanmalı?
Bağımsız LLM’ler etkileyici olsa da kör noktaları vardır. Halüsinasyon üretirler, şeyleri unutururlar ve son eğitim çalıştırmalarından daha yeni hiçbir şeyi bilmezler. RAG bunu değiştirir. LLM’leri gerçek zamanlı geri getirme ile birleştirerek şunları elde edersiniz:
- Olgusal doğruluk: Yanıtlar tahminlere değil, gerçek verilerinize dayanır.
- Alanla uyum: Niş veya dahili bilgiyi sisteme katabilirsiniz.
- Yeniden eğitim gerekmez: Bilgi tabanınızı güncellemeniz yeterlidir—ince ayar şart değildir.
- Ölçeklenebilirlik: Sohbet botları, arama araçları, destek asistanları ve daha fazlası için idealdir.
Kısacası RAG, çok daha az çabayla daha akıllı ve güvenilir yapay zekâ sistemleri kurmanızı sağlar.
En İyi Açık Kaynak RAG Çerçeveleri
RAG ekosistemi hızla büyüyor ve düzinelerce açık kaynak proje, geliştiricilerin daha akıllı, geri getirme destekli uygulamalar kurmasına yardımcı oluyor. Tak-çalıştır, sade bir şey arıyor olun ya da bileşenleri özelleştirilebilir tam yığın bir boru hattı isteyin, muhtemelen size uygun bir araç vardır.
Aşağıda, en iyi açık kaynak RAG çerçevelerini gözden geçireceğiz. Her birinde GitHub ilgisi, dağıtım tarzı, benzersiz güçlü yönleri, başlıca kullanım alanları ve projeye hızlı bir bakış sunan bir görsel vurgulanır.
1. Haystack
Haystack, üretime hazır NLP sistemleri kurmak için tasarlanmış, sağlam ve modüler bir çerçevedir. Retrievers, readers ve generators gibi çeşitli bileşenleri destekler; Elasticsearch ve Hugging Face Transformers gibi araçlarla sorunsuz entegrasyona olanak tanır.
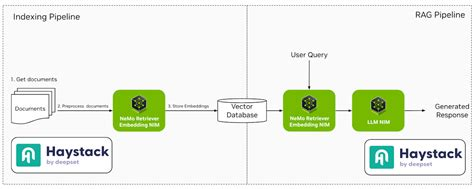
- GitHub yıldızları: ~13,5k
- Dağıtım: Docker, Kubernetes, Hugging Face Spaces
- Öne çıkan özellikler: Modüler bileşenler, güçlü Hugging Face entegrasyonu, çok dilli destek
- Kullanım alanları: Kurumsal düzeyde S&C sistemleri, sohbet botları, dahili doküman arama (TrueFoundry, Anyscale, LobeHub)
2. LlamaIndex
LlamaIndex, özel veri kaynaklarını büyük dil modellerine bağlayan bir veri çerçevesidir. Verilerin indekslenmesini ve sorgulanmasını basitleştirir; bağlamı dikkate alan yanıtlar gerektiren uygulamaların geliştirilmesini kolaylaştırır.
- GitHub yıldızları: ~13k
- Dağıtım: Python tabanlı, dosya veya web verisiyle her yerde çalışır
- Öne çıkan özellikler: İndeksleme, geri getirme ve yönlendirme için basit soyutlamalar
- Kullanım alanları: Kişisel asistanlar, bilgi botları, RAG demoları (GitHub)
3. LangChain
LangChain, geliştiricilerin dil modelleriyle çalışan uygulamalar inşa etmesini sağlayan kapsamlı bir çerçevedir. Karmaşık iş akışları oluşturmak için istem şablonları, bellek ve ajanlar gibi farklı bileşenleri birbirine zincirlemeye yönelik araçlar sunar.
- GitHub yıldızları: ~72k
- Dağıtım: Python, JavaScript, tüm büyük bulutlarda desteklenir
- Öne çıkan özellikler: Araç zincirleme, ajanlar, istem şablonları, çok sayıda entegrasyon
- Kullanım alanları: Uçtan uca LLM uygulamaları, veri ajanları, dinamik sohbet akışları
4. RAGFlow
RAGFlow, derin doküman anlama odaklı açık kaynak bir motordur. İşletmelerin RAG sistemleri uygulaması için sadeleştirilmiş bir iş akışı sağlar; karmaşık veri formatlarından alıntılarla desteklenen gerçekçi soru-cevaplamayı vurgular.
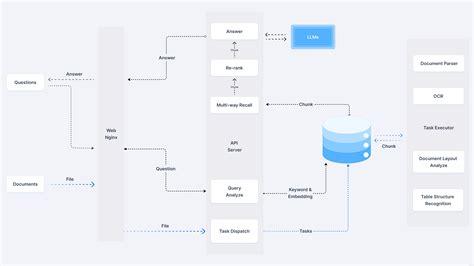
- GitHub yıldızları: ~1,1k
- Dağıtım: Docker; FastAPI tabanlı mikro hizmetleri destekler
- Öne çıkan özellikler: Parça görselleştirici, Weaviate entegrasyonu, esnek yapılandırmalar
- Kullanım alanları: Hafif RAG arka uçları, kurumsal prototipler (jina.ai)
5. txtAI
txtAI, anlamsal aramayı RAG yetenekleriyle birleştiren hepsi bir arada bir yapay zekâ çerçevesidir. Çeşitli veri türleri ve formatlarını destekleyerek bilgiyi verimli şekilde arayan, indeksleyen ve geri getiren uygulamalar kurmanıza olanak verir.
- GitHub yıldızları: ~3,9k
- Dağıtım: Python tabanlı; birkaç satır kodla çalışır.
- Öne çıkan özellikler: Son derece hafif, çevrimdışı mod, puanlama/sıralama desteği
- Kullanım alanları: Gömme tabanlı arama motorları, PDF’lerle sohbet, meta veri S&C (Introduction | LangChain, GitHub, GitHub)
6. Cognita
Cognita, kolay özelleştirme ve dağıtım için tasarlanmış modüler bir RAG çerçevesidir. Farklı RAG yapılandırmalarıyla denemeler yapmaya yarayan bir ön yüz sunar; hem geliştirme hem de üretim ortamları için uygundur.
- GitHub yıldızları: Dikkate değer
- Dağıtım: Docker + TrueFoundry entegrasyonları
- Öne çıkan özellikler: API odaklı, arayüze hazır, ölçeklemesi kolay
- Kullanım alanları: İş odaklı yapay zekâ asistanları, veri destekli sohbet botları (TrueFoundry, LlamaIndex)
7. LLMWare
LLMWare, kurumsal düzeyde RAG uygulamaları geliştirmek için birleşik bir çerçeve sunar. Verilerin güvenliği ve mevzuata uyumunu sağlamak için özel olarak dağıtılabilen küçük, uzmanlaşmış modellerin kullanımını vurgular.
- GitHub yıldızları: ~2,5k
- Dağıtım: CLI aracı, API’ler, özelleştirilebilir proje şablonları
- Öne çıkan özellikler: Kod yazmadan boru hatları, doküman ayrıştırma araçları
- Kullanım alanları: Doküman ajanları, bilgi asistanları (LinkedIn)
8. STORM
STORM, taslak odaklı RAG kavramını genişleten bir araştırma asistanıdır. Çeşitli kaynaklardan bilgileri sentezleyerek kapsamlı makaleler üretmeye odaklanır; içerik üretimi görevleri için idealdir.
- GitHub yıldızları: Niş
- Dağıtım: Kaynak kod kurulumu
- Öne çıkan özellikler: Co-STORM akıl yürütme motoru, graf tabanlı keşif
- Kullanım alanları: Özel RAG kurulumları, araştırma S&C boru hatları (GitHub)
9. R2R
R2R (Reason to Retrieve), üretime hazır özelliklerle RAG’ı destekleyen gelişmiş bir yapay zekâ geri getirme sistemidir. Çok modlu içerik alımı, hibrit arama ve bilgi grafiği entegrasyonu sunar; karmaşık kurumsal ihtiyaçlara hitap eder.
- GitHub yıldızları: Niş
- Dağıtım: REST API, hibrit ve grafik aramayı destekler
- Öne çıkan özellikler: Çok modlu RAG, doküman doğrulama
- Kullanım alanları: Yapay zekâ araştırma araçları, akademik ajanlar (YouTube, Open Source For You, Weaviate Newsletter)
10. EmbedChain
EmbedChain, RAG modelleri kullanarak yapay zekâ uygulamaları oluşturmayı ve dağıtmayı basitleştiren bir Python kitaplığıdır. PDF’ler, görseller ve web sayfaları dahil çeşitli veri türlerini destekler; farklı kullanım alanları için çok yönlüdür.
- GitHub yıldızları: ~3,5k
- Dağıtım: Python kitaplığı, aynı zamanda barındırılan SaaS olarak mevcut
- Öne çıkan özellikler: Tek komutla uygulama kurulumu, API öncelikli
- Kullanım alanları: Hızlı prototipleme, her alanda bilgi botları oluşturma (LLMWare AI for Complex Enterprises)
11. RAGatouille
RAGatouille, ColBERT gibi gelişmiş geri getirme yöntemlerini RAG boru hatlarına entegre eder. Farklı geri getirme teknikleriyle modüler denemelere olanak tanıyarak RAG sistemlerinin esnekliğini ve performansını artırır.
- GitHub yıldızları: Niş ancak büyüyor
- Dağıtım: Python paketi
- Öne çıkan özellikler: Geri getirme denemeleri, modüler girdiler
- Kullanım alanları: RAG boru hatlarında geri getirme tekniklerini değerlendirme
12. Verba
Verba, verileri sorgulamak ve onlarla etkileşim kurmak için RAG kullanan özelleştirilebilir bir kişisel asistandır. Weaviate’in bağlam farkındalığına sahip veritabanıyla entegre olur; verimli bilgi geri getirme ve etkileşim sağlar.
- GitHub yıldızları: Mütevazı
- Dağıtım: Yerel ve bulut destekli
- Öne çıkan özellikler: Bağlamsal bellek, kişisel veri S&C
- Kullanım alanları: Kendi asistanını oluşturma, veri keşfi (LinkedIn, Brandfetch)
13. Jina AI
Jina AI, ölçeklenebilir dağıtım seçenekleriyle çok modlu yapay zekâ uygulamaları kurmaya yönelik araçlar sunar. Çeşitli iletişim protokollerini destekler; yapay zekâ servisleri geliştirmek ve ölçeklemek isteyen geliştiriciler için uygundur.
- GitHub yıldızları: ~18k (ana organizasyon)
- Dağıtım: Docker, REST/gRPC/WebSocket API’leri
- Öne çıkan özellikler: Çok modlu boru hatları, hibrit arama
- Kullanım alanları: Metin, görsel veya videoyu birleştiren kurumsal uygulamalar
14. Neurite
Neurite, yapay zekâ destekli uygulamalar geliştirmeyi basitleştiren ortaya çıkan bir RAG çerçevesidir. Geliştirici deneyimi ve hızlı prototiplemeye yaptığı vurgu, denemeler için çekici bir seçenek kılar.
- GitHub yıldızları: Küçük ama umut verici
- Dağıtım: Kaynak kurulumu
- Öne çıkan özellikler: Nöral-sembolik füzyon
- Kullanım alanları: Yapay zekâ araştırma deneyleri, prototip sistemler (GitHub, Hugging Face, GitHub)
15. LLM-App
LLM-App, büyük dil modelleriyle çalışan uygulamalar geliştirmeye yönelik bir çerçevedir. Geliştirme sürecini sadeleştiren şablonlar ve araçlar sağlar; böylece çeşitli uygulamalara RAG yeteneklerini entegre etmeyi kolaylaştırır.
- GitHub yıldızları: Yükselen
- Dağıtım: Git tabanlı dağıtım ve CLI araçları
- Öne çıkan özellikler: Uygulama başlangıç şablonları, OpenAI’ye hazır
- Kullanım alanları: Kişisel RAG projeleri, hackathon araçları
Her çerçeve, farklı kullanım alanlarına ve dağıtım tercihlerinize göre benzersiz özellikler sunar. Özel gereksinimlerinize, dağıtım kolaylığına, özelleştirmeye veya entegrasyon kabiliyetlerine bağlı olarak projenizin hedefleriyle en iyi uyum sağlayan çerçeveyi seçebilirsiniz.
Doğru RAG Çerçevesini Seçmek
Uygun RAG çerçevesini seçmek, özel ihtiyaçlarınıza bağlıdır: hukuki doküman analizi, akademik araştırma veya hafif yerel geliştirme. Bu tabloyu, popüler açık kaynak RAG çerçevelerini nasıl dağıtıldıkları, ne kadar özelleştirilebilir oldukları, gelişmiş geri getirmeyi destekleyip desteklemedikleri, entegrasyon yetenekleri ve hangi işler için en uygun oldukları açısından hızlıca karşılaştırmak için kullanın.
|
Çerçeve
|
Dağıtım
|
Özelleştirilebilirlik
|
Gelişmiş Geri Getirme
|
Entegrasyon Desteği
|
En Uygun Olduğu
|
|
Haystack
|
Docker, K8s, Hugging Face
|
Yüksek
|
Evet
|
Elasticsearch, Hugging Face
|
Kurumsal arama & S&C
|
|
LlamaIndex
|
Python (yerel/bulut)
|
Yüksek
|
Evet
|
LangChain, FAISS
|
Dokümana duyarlı botlar
|
|
LangChain
|
Python, JS, Bulut
|
Yüksek
|
Evet
|
OpenAI, API’ler, VT’ler
|
LLM ajanları & boru hatları
|
|
RAGFlow
|
Docker
|
Orta
|
Evet
|
Weaviate
|
Hukuki veya yapısal dokümanlar
|
|
txtAI
|
Yerel (Python)
|
Orta
|
Temel
|
Transformers
|
Hafif yerel geliştirme
|
|
Cognita
|
Docker + Arayüz
|
Yüksek
|
Evet
|
TrueFoundry
|
Arayüz tabanlı iş araçları
|
|
LLMWare
|
CLI, API’ler
|
Yüksek
|
Evet
|
Özel LLM’ler
|
Özel kurumsal RAG
|
|
STORM
|
Kaynak kurulumu
|
Yüksek
|
Evet
|
LangChain, LangGraph
|
Araştırma asistanları
|
|
R2R
|
REST API
|
Yüksek
|
Evet
|
Çok modlu
|
Akademik & hibrit RAG
|
|
EmbedChain
|
Python, SaaS
|
Orta
|
Temel
|
Web, PDF, Görseller
|
Hızlı prototipleme
|
|
RAGatouille
|
Python
|
Yüksek
|
Evet
|
ColBERT
|
Geri getirici denemeleri
|
|
Verba
|
Bulut/Yerel
|
Orta
|
Temel
|
Weaviate
|
Bağlamsal asistanlar
|
|
Jina AI
|
Docker, REST/gRPC
|
Yüksek
|
Evet
|
Çok modlu API’ler
|
Ölçeklenebilir çok modlu uygulamalar
|
|
Neurite
|
Kaynak kurulumu
|
Orta
|
Hayır
|
Yok
|
Deneyler
|
|
LLM-App
|
CLI, Git
|
Orta
|
Hayır
|
OpenAI
|
Hackathon LLM uygulamaları
|
RAG Uygularken Sık Yapılan Hatalar
RAG sistemleri sağlam olabilir, ancak keskin köşeleri de vardır. Dikkatli olmazsanız modelinizin yanıtları, hiç geri getirme kullanmasaydınız vereceklerinden bile kötü olabilir. İşte kaçınmanız gereken dört yaygın sorun—ve bunun yerine ne yapmanız gerektiği.
1. Çok fazla işe yaramaz içeriği indekslemek
Her şey vektör deponuza girmek zorunda değil. Her belgeyi, blog yazısını veya e-posta dizisini yığmak kapsamlı hissettirebilir ama yalnızca aramanızı kirletir. Geri getirici, modelin elemek zorunda kaldığı (çoğu zaman yanlış kullanılan) düşük değerli bağlamları çeker. Bunun yerine seçici olun. Yalnızca doğru, iyi yazılmış ve faydalı içeriği indeksleyin. Depolamadan önce temizleyin.
2. Belirteç sınırlarını yok saymak
LLM’lerin hafızası kısadır. İsteminiz ve geri getirilen tüm parçalar birlikte modelin belirteç sınırını aşarsa bir şeyler kesilir. Bu “bir şey”, önemli kısım olabilir. Bunun yerine istemleri sıkı tutun. Geri getirilen parça sayısını sınırlayın veya modele göndermeden önce özetleyin.
3. Duyarlılık yerine kapsama odaklanmak
“Her şeyi kapsadığınızdan” emin olmak için daha fazla belge getirmek cazip gelir. Ancak ekstra sonuçlar yüzeysel olarak ilgiliyse istemi ıvır zıvırla doldurursunuz. Model dikkati dağılır ya da daha da kötüsü, kafası karışır. Bunun yerine yüksek duyarlılığı hedefleyin. Birkaç son derece ilgili parça, uzun bir zayıf eşleşme listesinden daha iyidir.
4. Günlükler olmadan kör uçuş
Model kötü bir yanıt verdiğinde nedenini biliyor musunuz? Sorguyu, geri getirilen belgeleri ve son istemi günlüğe kaydetmiyorsanız karanlıkta hata ayıklıyorsunuz demektir. Bunun yerine tüm RAG akışını günlükleyin. Buna kullanıcı girdisi, geri getirilen içerik, modele gönderilenler ve modelin yanıtı dahildir.
Sonuç
RAG her şey için sihirli bir çözüm değildir; ancak doğru kullanıldığında, LLM’leri işletmeniz için önemli verilere dayalı olarak daha akıllı, daha pratik ve daha sağlam hâle getirmenin en etkili yollarından biridir.
Mesele, neyle çalıştığınızı bilmektir. Doğru çerçeveyi seçmek bunun bir parçasıdır; ancak başarı, verinizi ne kadar iyi anladığınıza ve geri getirme boru hattınızı ne kadar özenle ayarladığınıza bağlıdır. “Çöp girerse, çöp çıkar” ilkesi hâlâ geçerlidir; özellikle de yalnızca olguları getirmekle kalmayıp dil üreten sistemler kurarken.
İndekslemeyi doğru yapın, belirteç kullanımınızı takip edin ve akışı uçtan uca izleyin. Tüm bu parçalar yerine oturduğunda, RAG yapay zekâ uygulamalarınızı etkileyiciden gerçekten yardımcı olana dönüştürebilir.





Geri getirme destekli üretim (RAG), büyük dil modellerinden yararlanmanın en pratik evrimlerinden biri hâline geliyor. Bu, yeni bir model ya da LLM’lerin yerine geçen bir şey değil; aksine, gerçek veri kaynaklarından çekilen olgularla akıl yürütmelerine yardımcı olan yenilikçi bir sistem. Özünde RAG, üretken yapay zekânın en büyük sorunlarından bazılarını çözer: halüsinasyonlar, sınırlı bellek ve güncelliğini yitirmiş bilgi. Geri getirme ve üretimi tek bir boru hattında birleştirmek, modellerin yanıtlarını çoğu zaman bir işletmeye veya alana özgü olan güncel ve ilgili bir bağlama oturtmasını sağlar.
Bu dönüşüm her zamankinden daha önemli. Kurumsal ortamlarda LLM’lerin doğruluk ve açıklanabilirlikle yanıt vermesi beklenir. Geliştiriciler, çıktılarda genel web bilgisini değil, ürün dokümantasyonunu, iç wiki’leri veya destek kayıtlarını görmek ister. RAG bunu mümkün kılar.
Bu rehber, RAG çerçevesinin nasıl çalıştığını, yapay zekâ yığınınıza nerede uyduğunu ve temel araçlar ile verilerle nasıl kullanılacağını açıklar.
RAG Çerçevesi Nedir?
RAG, Retrieve, Augment, Generate ifadelerinin kısaltmasıdır. Büyük dil modellerine (LLM’ler) yeniden eğitmeden haricî bilgiye erişim vermenin akıllı bir yoludur.
Fikir şu: Bir kullanıcı soru sorduğunda, soruyu doğrudan modele gönderip iyi bir yanıt ummak yerine RAG önce bir bilgi tabanından ilgili bilgileri geri getirir. Ardından özgün istemi bu ek bağlamla zenginleştirir. Son olarak LLM, soruyu ve eklenen bilgiyi kullanarak bir yanıt üretir.
Bu yaklaşım, gerçek, güncel ve ilgili verileri anlık olarak devreye alarak halüsinasyonlar, kısa hafıza (bağlam pencereleri) ve bilgi kesim tarihleri gibi temel LLM sınırlamalarını aşmaya yardımcı olur.
Neden Bir RAG Çerçevesi Kullanmalı?
Bağımsız LLM’ler etkileyici olsa da kör noktaları vardır. Halüsinasyon üretirler, şeyleri unutururlar ve son eğitim çalıştırmalarından daha yeni hiçbir şeyi bilmezler. RAG bunu değiştirir. LLM’leri gerçek zamanlı geri getirme ile birleştirerek şunları elde edersiniz:
Kısacası RAG, çok daha az çabayla daha akıllı ve güvenilir yapay zekâ sistemleri kurmanızı sağlar.
En İyi Açık Kaynak RAG Çerçeveleri
RAG ekosistemi hızla büyüyor ve düzinelerce açık kaynak proje, geliştiricilerin daha akıllı, geri getirme destekli uygulamalar kurmasına yardımcı oluyor. Tak-çalıştır, sade bir şey arıyor olun ya da bileşenleri özelleştirilebilir tam yığın bir boru hattı isteyin, muhtemelen size uygun bir araç vardır.
Aşağıda, en iyi açık kaynak RAG çerçevelerini gözden geçireceğiz. Her birinde GitHub ilgisi, dağıtım tarzı, benzersiz güçlü yönleri, başlıca kullanım alanları ve projeye hızlı bir bakış sunan bir görsel vurgulanır.
1. Haystack
Haystack, üretime hazır NLP sistemleri kurmak için tasarlanmış, sağlam ve modüler bir çerçevedir. Retrievers, readers ve generators gibi çeşitli bileşenleri destekler; Elasticsearch ve Hugging Face Transformers gibi araçlarla sorunsuz entegrasyona olanak tanır.
2. LlamaIndex
LlamaIndex, özel veri kaynaklarını büyük dil modellerine bağlayan bir veri çerçevesidir. Verilerin indekslenmesini ve sorgulanmasını basitleştirir; bağlamı dikkate alan yanıtlar gerektiren uygulamaların geliştirilmesini kolaylaştırır.
3. LangChain
LangChain, geliştiricilerin dil modelleriyle çalışan uygulamalar inşa etmesini sağlayan kapsamlı bir çerçevedir. Karmaşık iş akışları oluşturmak için istem şablonları, bellek ve ajanlar gibi farklı bileşenleri birbirine zincirlemeye yönelik araçlar sunar.
4. RAGFlow
RAGFlow, derin doküman anlama odaklı açık kaynak bir motordur. İşletmelerin RAG sistemleri uygulaması için sadeleştirilmiş bir iş akışı sağlar; karmaşık veri formatlarından alıntılarla desteklenen gerçekçi soru-cevaplamayı vurgular.
5. txtAI
txtAI, anlamsal aramayı RAG yetenekleriyle birleştiren hepsi bir arada bir yapay zekâ çerçevesidir. Çeşitli veri türleri ve formatlarını destekleyerek bilgiyi verimli şekilde arayan, indeksleyen ve geri getiren uygulamalar kurmanıza olanak verir.
6. Cognita
Cognita, kolay özelleştirme ve dağıtım için tasarlanmış modüler bir RAG çerçevesidir. Farklı RAG yapılandırmalarıyla denemeler yapmaya yarayan bir ön yüz sunar; hem geliştirme hem de üretim ortamları için uygundur.
7. LLMWare
LLMWare, kurumsal düzeyde RAG uygulamaları geliştirmek için birleşik bir çerçeve sunar. Verilerin güvenliği ve mevzuata uyumunu sağlamak için özel olarak dağıtılabilen küçük, uzmanlaşmış modellerin kullanımını vurgular.
8. STORM
STORM, taslak odaklı RAG kavramını genişleten bir araştırma asistanıdır. Çeşitli kaynaklardan bilgileri sentezleyerek kapsamlı makaleler üretmeye odaklanır; içerik üretimi görevleri için idealdir.
9. R2R
R2R (Reason to Retrieve), üretime hazır özelliklerle RAG’ı destekleyen gelişmiş bir yapay zekâ geri getirme sistemidir. Çok modlu içerik alımı, hibrit arama ve bilgi grafiği entegrasyonu sunar; karmaşık kurumsal ihtiyaçlara hitap eder.
10. EmbedChain
EmbedChain, RAG modelleri kullanarak yapay zekâ uygulamaları oluşturmayı ve dağıtmayı basitleştiren bir Python kitaplığıdır. PDF’ler, görseller ve web sayfaları dahil çeşitli veri türlerini destekler; farklı kullanım alanları için çok yönlüdür.
11. RAGatouille
RAGatouille, ColBERT gibi gelişmiş geri getirme yöntemlerini RAG boru hatlarına entegre eder. Farklı geri getirme teknikleriyle modüler denemelere olanak tanıyarak RAG sistemlerinin esnekliğini ve performansını artırır.
12. Verba
Verba, verileri sorgulamak ve onlarla etkileşim kurmak için RAG kullanan özelleştirilebilir bir kişisel asistandır. Weaviate’in bağlam farkındalığına sahip veritabanıyla entegre olur; verimli bilgi geri getirme ve etkileşim sağlar.
13. Jina AI
Jina AI, ölçeklenebilir dağıtım seçenekleriyle çok modlu yapay zekâ uygulamaları kurmaya yönelik araçlar sunar. Çeşitli iletişim protokollerini destekler; yapay zekâ servisleri geliştirmek ve ölçeklemek isteyen geliştiriciler için uygundur.
14. Neurite
Neurite, yapay zekâ destekli uygulamalar geliştirmeyi basitleştiren ortaya çıkan bir RAG çerçevesidir. Geliştirici deneyimi ve hızlı prototiplemeye yaptığı vurgu, denemeler için çekici bir seçenek kılar.
15. LLM-App
LLM-App, büyük dil modelleriyle çalışan uygulamalar geliştirmeye yönelik bir çerçevedir. Geliştirme sürecini sadeleştiren şablonlar ve araçlar sağlar; böylece çeşitli uygulamalara RAG yeteneklerini entegre etmeyi kolaylaştırır.
Her çerçeve, farklı kullanım alanlarına ve dağıtım tercihlerinize göre benzersiz özellikler sunar. Özel gereksinimlerinize, dağıtım kolaylığına, özelleştirmeye veya entegrasyon kabiliyetlerine bağlı olarak projenizin hedefleriyle en iyi uyum sağlayan çerçeveyi seçebilirsiniz.
Doğru RAG Çerçevesini Seçmek
Uygun RAG çerçevesini seçmek, özel ihtiyaçlarınıza bağlıdır: hukuki doküman analizi, akademik araştırma veya hafif yerel geliştirme. Bu tabloyu, popüler açık kaynak RAG çerçevelerini nasıl dağıtıldıkları, ne kadar özelleştirilebilir oldukları, gelişmiş geri getirmeyi destekleyip desteklemedikleri, entegrasyon yetenekleri ve hangi işler için en uygun oldukları açısından hızlıca karşılaştırmak için kullanın.
Çerçeve
Dağıtım
Özelleştirilebilirlik
Gelişmiş Geri Getirme
Entegrasyon Desteği
En Uygun Olduğu
Haystack
Docker, K8s, Hugging Face
Yüksek
Evet
Elasticsearch, Hugging Face
Kurumsal arama & S&C
LlamaIndex
Python (yerel/bulut)
Yüksek
Evet
LangChain, FAISS
Dokümana duyarlı botlar
LangChain
Python, JS, Bulut
Yüksek
Evet
OpenAI, API’ler, VT’ler
LLM ajanları & boru hatları
RAGFlow
Docker
Orta
Evet
Weaviate
Hukuki veya yapısal dokümanlar
txtAI
Yerel (Python)
Orta
Temel
Transformers
Hafif yerel geliştirme
Cognita
Docker + Arayüz
Yüksek
Evet
TrueFoundry
Arayüz tabanlı iş araçları
LLMWare
CLI, API’ler
Yüksek
Evet
Özel LLM’ler
Özel kurumsal RAG
STORM
Kaynak kurulumu
Yüksek
Evet
LangChain, LangGraph
Araştırma asistanları
R2R
REST API
Yüksek
Evet
Çok modlu
Akademik & hibrit RAG
EmbedChain
Python, SaaS
Orta
Temel
Web, PDF, Görseller
Hızlı prototipleme
RAGatouille
Python
Yüksek
Evet
ColBERT
Geri getirici denemeleri
Verba
Bulut/Yerel
Orta
Temel
Weaviate
Bağlamsal asistanlar
Jina AI
Docker, REST/gRPC
Yüksek
Evet
Çok modlu API’ler
Ölçeklenebilir çok modlu uygulamalar
Neurite
Kaynak kurulumu
Orta
Hayır
Yok
Deneyler
LLM-App
CLI, Git
Orta
Hayır
OpenAI
Hackathon LLM uygulamaları
RAG Uygularken Sık Yapılan Hatalar
RAG sistemleri sağlam olabilir, ancak keskin köşeleri de vardır. Dikkatli olmazsanız modelinizin yanıtları, hiç geri getirme kullanmasaydınız vereceklerinden bile kötü olabilir. İşte kaçınmanız gereken dört yaygın sorun—ve bunun yerine ne yapmanız gerektiği.
1. Çok fazla işe yaramaz içeriği indekslemek
Her şey vektör deponuza girmek zorunda değil. Her belgeyi, blog yazısını veya e-posta dizisini yığmak kapsamlı hissettirebilir ama yalnızca aramanızı kirletir. Geri getirici, modelin elemek zorunda kaldığı (çoğu zaman yanlış kullanılan) düşük değerli bağlamları çeker. Bunun yerine seçici olun. Yalnızca doğru, iyi yazılmış ve faydalı içeriği indeksleyin. Depolamadan önce temizleyin.
2. Belirteç sınırlarını yok saymak
LLM’lerin hafızası kısadır. İsteminiz ve geri getirilen tüm parçalar birlikte modelin belirteç sınırını aşarsa bir şeyler kesilir. Bu “bir şey”, önemli kısım olabilir. Bunun yerine istemleri sıkı tutun. Geri getirilen parça sayısını sınırlayın veya modele göndermeden önce özetleyin.
3. Duyarlılık yerine kapsama odaklanmak
“Her şeyi kapsadığınızdan” emin olmak için daha fazla belge getirmek cazip gelir. Ancak ekstra sonuçlar yüzeysel olarak ilgiliyse istemi ıvır zıvırla doldurursunuz. Model dikkati dağılır ya da daha da kötüsü, kafası karışır. Bunun yerine yüksek duyarlılığı hedefleyin. Birkaç son derece ilgili parça, uzun bir zayıf eşleşme listesinden daha iyidir.
4. Günlükler olmadan kör uçuş
Model kötü bir yanıt verdiğinde nedenini biliyor musunuz? Sorguyu, geri getirilen belgeleri ve son istemi günlüğe kaydetmiyorsanız karanlıkta hata ayıklıyorsunuz demektir. Bunun yerine tüm RAG akışını günlükleyin. Buna kullanıcı girdisi, geri getirilen içerik, modele gönderilenler ve modelin yanıtı dahildir.
Sonuç
RAG her şey için sihirli bir çözüm değildir; ancak doğru kullanıldığında, LLM’leri işletmeniz için önemli verilere dayalı olarak daha akıllı, daha pratik ve daha sağlam hâle getirmenin en etkili yollarından biridir.
Mesele, neyle çalıştığınızı bilmektir. Doğru çerçeveyi seçmek bunun bir parçasıdır; ancak başarı, verinizi ne kadar iyi anladığınıza ve geri getirme boru hattınızı ne kadar özenle ayarladığınıza bağlıdır. “Çöp girerse, çöp çıkar” ilkesi hâlâ geçerlidir; özellikle de yalnızca olguları getirmekle kalmayıp dil üreten sistemler kurarken.
İndekslemeyi doğru yapın, belirteç kullanımınızı takip edin ve akışı uçtan uca izleyin. Tüm bu parçalar yerine oturduğunda, RAG yapay zekâ uygulamalarınızı etkileyiciden gerçekten yardımcı olana dönüştürebilir.