La retrieval-augmented generation (RAG) sta rapidamente diventando una delle evoluzioni più pratiche nell’uso dei large language model. Non è un nuovo modello né un sostituto degli LLM; è invece un sistema innovativo che li aiuta a ragionare su fatti estratti da fonti di dati reali. In sostanza, RAG risolve alcune delle sfide più grandi dell’AI generativa: allucinazioni, memoria limitata e conoscenze non aggiornate. Combinare retrieval e generazione in un’unica pipeline permette ai modelli di ancorare le risposte a un contesto attuale e pertinente, spesso specifico per un’azienda o un dominio.
Questo cambiamento conta oggi più che mai. In ambito enterprise, ci si aspetta che gli LLM rispondano con accuratezza e spiegabilità. Gli sviluppatori vogliono output che riflettano la documentazione del prodotto, i wiki interni o i ticket di supporto, non una conoscenza generica del web. RAG lo rende possibile.
Questa guida spiega come funziona un framework RAG, dove si inserisce nel tuo stack AI e come usarlo con strumenti e dati fondamentali.
Cos’è un framework RAG?
RAG sta per Retrieve, Augment, Generate. È un modo intelligente per dare ai large language model (LLM) accesso a conoscenze esterne senza doverli riaddestrare.
L’idea è questa: quando un utente fa una domanda, invece di lanciarla direttamente al modello sperando in una buona risposta, RAG prima recupera informazioni pertinenti da una base di conoscenza. Poi arricchisce il prompt originale con questo contesto extra. Infine, l’LLM genera una risposta usando la domanda e le informazioni aggiunte.
Questo approccio aiuta a risolvere limiti chiave degli LLM—come le allucinazioni, la memoria breve (finestra di contesto) e i cutoff di conoscenza—collegando al volo dati reali, aggiornati e rilevanti.
Perché usare un framework RAG?
Gli LLM standalone sono impressionanti, ma hanno punti ciechi. Allucinano, dimenticano e non sanno nulla di più recente rispetto al loro ultimo addestramento. RAG cambia le cose. Combinando LLM e retrieval in tempo reale, ottieni:
- Accuratezza fattuale: le risposte si basano sui tuoi dati reali, non su supposizioni.
- Rilevanza di dominio: puoi inserire conoscenze di nicchia o interne.
- Niente retraining necessario: ti basta aggiornare la base di conoscenza—non è richiesto alcun fine-tuning.
- Scalabilità: ideale per chatbot, strumenti di ricerca, assistenti di supporto e altro.
In breve, RAG ti permette di creare sistemi di AI più intelligenti e affidabili con molto meno sforzo.
I migliori framework RAG open-source
L’ecosistema RAG sta crescendo rapidamente, con decine di progetti open-source che aiutano gli sviluppatori a creare applicazioni più intelligenti e potenziate dal retrieval. Che tu cerchi qualcosa di plug-and-play e lineare o una pipeline full-stack con componenti personalizzabili, probabilmente esiste lo strumento che fa per te.
Di seguito esaminiamo i principali framework RAG open-source. Per ciascuno, evidenziamo la trazione su GitHub, lo stile di deployment, i punti di forza unici, i casi d’uso primari e un elemento visivo per darti un’idea rapida del progetto.
1. Haystack
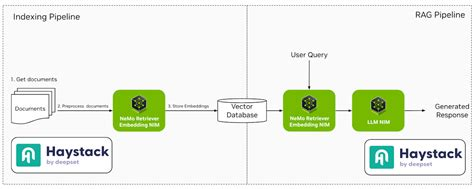
Haystack è un framework robusto e modulare progettato per costruire sistemi NLP pronti per la produzione. Supporta vari componenti come retriever, reader e generator, consentendo un’integrazione fluida con strumenti come Elasticsearch e Hugging Face Transformers.
- Stelle GitHub: ~13,5k
- Deployment: Docker, Kubernetes, Hugging Face Spaces
- Punti di forza: Componenti modulari, forte integrazione con Hugging Face, supporto multilingue
- Casi d’uso: Sistemi di QA enterprise, chatbot, ricerca su documenti interni (TrueFoundry, Anyscale, LobeHub)
2. LlamaIndex
LlamaIndex è un data framework che collega fonti di dati personalizzate ai large language model. Semplifica il processo di indicizzazione e interrogazione dei dati, rendendo più facile creare applicazioni che richiedono risposte contestuali.
- Stelle GitHub: ~13k
- Deployment: Basato su Python, eseguito ovunque con dati da file o web
- Punti di forza: Astrazioni semplici per indicizzazione, retrieval e routing
- Casi d’uso: Assistenti personali, knowledge bot, demo RAG (GitHub)
3. LangChain
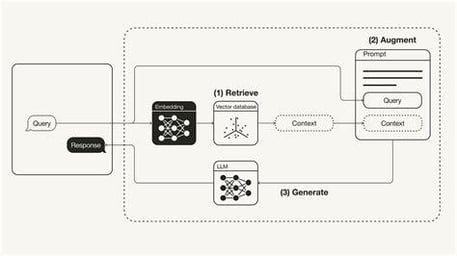
LangChain è un framework completo che permette agli sviluppatori di creare applicazioni basate su modelli linguistici. Offre strumenti per concatenare diversi componenti come template di prompt, memoria e agent per creare workflow complessi.
- Stelle GitHub: ~72k
- Deployment: Python, JavaScript, supportato su tutti i principali cloud
- Punti di forza: Chaining di strumenti, agent, template di prompt, molte integrazioni
- Casi d’uso: Applicazioni LLM end-to-end, data agent, flussi di chat dinamici
4. RAGFlow
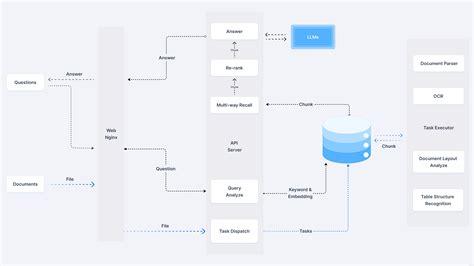
RAGFlow è un motore open-source focalizzato sulla comprensione profonda dei documenti. Fornisce un workflow snello per implementare sistemi RAG in azienda, con enfasi su risposte veritiere supportate da citazioni provenienti da formati di dati complessi.
- Stelle GitHub: ~1,1k
- Deployment: Docker; supporta microservizi basati su FastAPI
- Punti di forza: Visualizzatore di chunk, integrazione con Weaviate, configurazioni flessibili
- Casi d’uso: Backend RAG leggeri, prototipi enterprise (jina.ai)
5. txtAI
txtAI è un framework AI all-in-one che combina ricerca semantica e funzionalità RAG. Consente di creare applicazioni che cercano, indicizzano e recuperano informazioni in modo efficiente, supportando vari tipi e formati di dati.
- Stelle GitHub: ~3,9k
- Deployment: Basato su Python; si esegue con poche righe di codice.
- Punti di forza: Estremamente leggero, modalità offline, supporto a scoring/ranking
- Casi d’uso: Motori di ricerca basati su embedding, chat con PDF, Q&A su metadati (Introduction | LangChain, GitHub, GitHub)
6. Cognita
Cognita è un framework RAG modulare progettato per una personalizzazione e un deployment semplici. Offre un’interfaccia frontend per sperimentare diverse configurazioni RAG, adatto sia a sviluppo sia a produzione.
- Stelle GitHub: Rilevante
- Deployment: Docker + integrazioni TrueFoundry
- Punti di forza: API-first, pronto per la UI, facile da scalare
- Casi d’uso: Assistenti AI per il business, chatbot basati sui dati (TrueFoundry, LlamaIndex)
7. LLMWare
LLMWare offre un framework unificato per creare applicazioni RAG di livello enterprise. Sottolinea l’uso di modelli piccoli e specializzati che possono essere distribuiti in privato, garantendo sicurezza dei dati e compliance.
- Stelle GitHub: ~2,5k
- Deployment: Strumento CLI, API, template di progetto personalizzabili
- Punti di forza: Pipeline no-code, strumenti di parsing dei documenti
- Casi d’uso: Agent per documenti, assistenti alla conoscenza (LinkedIn)
8. STORM
STORM è un assistente di ricerca che estende il concetto di RAG basato su outline. Si concentra sulla generazione di articoli completi sintetizzando informazioni da varie fonti, ideale per attività di content creation.
- Stelle GitHub: Di nicchia
- Deployment: Installazione da sorgente
- Punti di forza: Motore di ragionamento Co-STORM, esplorazione basata su grafi
- Casi d’uso: Configurazioni RAG personalizzate, pipeline di QA per la ricerca (GitHub)
9. R2R
R2R (Reason to Retrieve) è un sistema di retrieval AI avanzato che supporta RAG con funzionalità pronte per la produzione. Offre ingestion multimodale, ricerca ibrida e integrazione con knowledge graph, pensato per esigenze enterprise complesse.
- Stelle GitHub: Di nicchia
- Deployment: REST API, supporta ricerca ibrida e su grafi
- Punti di forza: RAG multimodale, validazione dei documenti
- Casi d’uso: Strumenti di ricerca AI, agenti accademici (YouTube, Open Source For You, Weaviate Newsletter)
10. EmbedChain
EmbedChain è una libreria Python che semplifica la creazione e il deployment di applicazioni AI basate su modelli RAG. Supporta vari tipi di dati, inclusi PDF, immagini e pagine web, risultando versatile per diversi casi d’uso.
- Stelle GitHub: ~3,5k
- Deployment: Libreria Python, disponibile anche come SaaS hosted
- Punti di forza: Setup dell’app con un solo comando, API-first
- Casi d’uso: Prototipazione rapida, creazione di knowledge bot per qualsiasi dominio (LLMWare AI for Complex Enterprises)
11. RAGatouille
RAGatouille integra metodi di retrieval avanzati come ColBERT nelle pipeline RAG. Permette di sperimentare in modo modulare diverse tecniche di retrieval, migliorando flessibilità e prestazioni dei sistemi RAG.
- Stelle GitHub: Di nicchia ma in crescita
- Deployment: Pacchetto Python
- Punti di forza: Sperimentazione sul retrieval, input modulari
- Casi d’uso: Valutazione di tecniche di retrieval nelle pipeline RAG
12. Verba
Verba è un assistente personale personalizzabile che utilizza RAG per interrogare e interagire con i dati. Si integra con il database context-aware di Weaviate, abilitando retrieval e interazione efficienti.
- Stelle GitHub: Modeste
- Deployment: Supporto locale e cloud
- Punti di forza: Memoria contestuale, Q&A su dati personali
- Casi d’uso: Crea il tuo assistente, esplorazione dei dati (LinkedIn, Brandfetch)
13. Jina AI
Jina AI offre strumenti per costruire applicazioni AI multimodali con opzioni di deployment scalabili. Supporta vari protocolli di comunicazione, risultando adatto a sviluppatori che vogliono creare e scalare servizi AI.
- Stelle GitHub: ~18k (org principale)
- Deployment: API Docker, REST/gRPC/WebSocket
- Punti di forza: Pipeline multimodali, ricerca ibrida
- Casi d’uso: App enterprise che combinano testo, immagini o video
14. Neurite
Neurite è un framework RAG emergente che semplifica la creazione di applicazioni alimentate dall’AI. L’enfasi sulla developer experience e sulla prototipazione rapida lo rende un’opzione interessante per la sperimentazione.
- Stelle GitHub: Piccole ma promettenti
- Deployment: Setup da sorgente
- Punti di forza: Fusione neurale-simbolica
- Casi d’uso: Esperimenti di ricerca AI, protosistemi (GitHub, Hugging Face, GitHub)
15. LLM-App
LLM-App è un framework per creare applicazioni basate su large language model. Fornisce template e strumenti per snellire lo sviluppo, rendendo più semplice integrare funzionalità RAG in varie applicazioni.
- Stelle GitHub: In crescita
- Deployment: Deployment basato su Git e strumenti CLI
- Punti di forza: Template di avvio app, pronto per OpenAI
- Casi d’uso: Progetti RAG personali, strumenti da hackathon
Ogni framework offre funzionalità uniche pensate per diversi casi d’uso e preferenze di deployment. In base alle tue esigenze specifiche—facilità di distribuzione, personalizzazione o capacità di integrazione—puoi scegliere il framework più allineato agli obiettivi del tuo progetto.
Scegliere il framework RAG giusto
La scelta del framework RAG appropriato dipende dalle tue necessità specifiche: analisi di documenti legali, ricerca accademica o sviluppo locale leggero. Usa questa tabella per confrontare rapidamente i framework RAG open-source più diffusi in base a come vengono distribuiti, al loro livello di personalizzazione, al supporto per retrieval avanzato, alle capacità di integrazione e all’uso ideale di ogni strumento.
|
Framework
|
Deployment
|
Personalizzazione
|
Retrieval avanzato
|
Supporto integrazioni
|
Ideale per
|
|
Haystack
|
Docker, K8s, Hugging Face
|
Alta
|
Sì
|
Elasticsearch, Hugging Face
|
Ricerca & QA enterprise
|
|
LlamaIndex
|
Python (locale/cloud)
|
Alta
|
Sì
|
LangChain, FAISS
|
Bot consapevoli dei documenti
|
|
LangChain
|
Python, JS, Cloud
|
Alta
|
Sì
|
OpenAI, API, DB
|
Agent & pipeline LLM
|
|
RAGFlow
|
Docker
|
Media
|
Sì
|
Weaviate
|
Documenti legali o strutturati
|
|
txtAI
|
Locale (Python)
|
Media
|
Base
|
Transformers
|
Sviluppo locale leggero
|
|
Cognita
|
Docker + UI
|
Alta
|
Sì
|
TrueFoundry
|
Strumenti business con GUI
|
|
LLMWare
|
CLI, API
|
Alta
|
Sì
|
LLM privati
|
RAG enterprise privati
|
|
STORM
|
Install da sorgente
|
Alta
|
Sì
|
LangChain, LangGraph
|
Assistenti di ricerca
|
|
R2R
|
REST API
|
Alta
|
Sì
|
Multimodale
|
RAG accademico & ibrido
|
|
EmbedChain
|
Python, SaaS
|
Media
|
Base
|
Web, PDF, Immagini
|
Prototipazione rapida
|
|
RAGatouille
|
Python
|
Alta
|
Sì
|
ColBERT
|
Sperimentazione dei retriever
|
|
Verba
|
Cloud/Locale
|
Media
|
Base
|
Weaviate
|
Assistenti contestuali
|
|
Jina AI
|
Docker, REST/gRPC
|
Alta
|
Sì
|
API multimodali
|
App multimodali scalabili
|
|
Neurite
|
Setup da sorgente
|
Media
|
No
|
N/D
|
Sperimentazione
|
|
LLM-App
|
CLI, Git
|
Media
|
No
|
OpenAI
|
App LLM da hackathon
|
Errori comuni nell’implementazione di RAG
I sistemi RAG possono essere solidi, ma hanno anche spigoli vivi. Se non stai attento, le risposte del modello potrebbero peggiorare rispetto a non usare affatto il retrieval. Ecco quattro problemi comuni da evitare—e cosa fare invece.
1. Indicizzare troppa roba inutile
Non tutto deve finire nel tuo vector store. Riversare ogni documento, post del blog o thread di email può sembrare scrupoloso, ma in realtà inquina la ricerca. Il retriever richiama contesto di poco valore che il modello deve smistare (spesso in modo errato). Meglio essere selettivi: indicizza solo contenuti accurati, ben scritti e utili. Fai pulizia prima di archiviare.
2. Ignorare i limiti di token
Gli LLM hanno una memoria breve. Se il tuo prompt, più tutti i chunk recuperati, supera il limite di token del modello, qualcosa verrà tagliato. E quel “qualcosa” potrebbe essere la parte importante. Mantieni quindi i prompt snelli. Limita il numero di chunk recuperati o sintetizzali prima di inviarli al modello.
3. Ottimizzare per recall, non per precision
È allettante recuperare più documenti per essere sicuro di “coprire tutto”. Ma se i risultati extra sono solo vagamente correlati, riempi il prompt di rumore. Il modello si distrae o, peggio, si confonde. Punta invece alla massima precision. Pochi chunk molto pertinenti sono meglio di una lunga lista di corrispondenze deboli.
4. Volare alla cieca senza log
Quando il modello dà una risposta sbagliata, sai perché? Se non registri query, documenti recuperati e prompt finale, stai facendo debug al buio. Al contrario, registra l’intero flusso RAG: input dell’utente, contenuti recuperati, cosa è stato inviato al modello e la risposta del modello.
Conclusione
RAG non è una bacchetta magica, ma se usato correttamente è uno dei modi più efficaci per rendere gli LLM più intelligenti, pratici e ancorati ai dati che contano per il tuo business.
La chiave è sapere con cosa stai lavorando. Scegliere il framework giusto è parte dell’equazione, ma il successo dipende da quanto bene conosci i tuoi dati e da quanto accuratamente ottimizzi la pipeline di retrieval. Garbage in, garbage out vale ancora, soprattutto quando costruisci sistemi che generano linguaggio, non solo recuperano fatti.
Imposta correttamente l’indicizzazione, tieni d’occhio l’uso dei token e monitora il flusso end-to-end. Quando tutti questi pezzi si incastrano, RAG può trasformare le tue applicazioni AI da impressionanti a davvero utili.







La retrieval-augmented generation (RAG) sta rapidamente diventando una delle evoluzioni più pratiche nell’uso dei large language model. Non è un nuovo modello né un sostituto degli LLM; è invece un sistema innovativo che li aiuta a ragionare su fatti estratti da fonti di dati reali. In sostanza, RAG risolve alcune delle sfide più grandi dell’AI generativa: allucinazioni, memoria limitata e conoscenze non aggiornate. Combinare retrieval e generazione in un’unica pipeline permette ai modelli di ancorare le risposte a un contesto attuale e pertinente, spesso specifico per un’azienda o un dominio.
Questo cambiamento conta oggi più che mai. In ambito enterprise, ci si aspetta che gli LLM rispondano con accuratezza e spiegabilità. Gli sviluppatori vogliono output che riflettano la documentazione del prodotto, i wiki interni o i ticket di supporto, non una conoscenza generica del web. RAG lo rende possibile.
Questa guida spiega come funziona un framework RAG, dove si inserisce nel tuo stack AI e come usarlo con strumenti e dati fondamentali.
Cos’è un framework RAG?
RAG sta per Retrieve, Augment, Generate. È un modo intelligente per dare ai large language model (LLM) accesso a conoscenze esterne senza doverli riaddestrare.
L’idea è questa: quando un utente fa una domanda, invece di lanciarla direttamente al modello sperando in una buona risposta, RAG prima recupera informazioni pertinenti da una base di conoscenza. Poi arricchisce il prompt originale con questo contesto extra. Infine, l’LLM genera una risposta usando la domanda e le informazioni aggiunte.
Questo approccio aiuta a risolvere limiti chiave degli LLM—come le allucinazioni, la memoria breve (finestra di contesto) e i cutoff di conoscenza—collegando al volo dati reali, aggiornati e rilevanti.
Perché usare un framework RAG?
Gli LLM standalone sono impressionanti, ma hanno punti ciechi. Allucinano, dimenticano e non sanno nulla di più recente rispetto al loro ultimo addestramento. RAG cambia le cose. Combinando LLM e retrieval in tempo reale, ottieni:
In breve, RAG ti permette di creare sistemi di AI più intelligenti e affidabili con molto meno sforzo.
I migliori framework RAG open-source
L’ecosistema RAG sta crescendo rapidamente, con decine di progetti open-source che aiutano gli sviluppatori a creare applicazioni più intelligenti e potenziate dal retrieval. Che tu cerchi qualcosa di plug-and-play e lineare o una pipeline full-stack con componenti personalizzabili, probabilmente esiste lo strumento che fa per te.
Di seguito esaminiamo i principali framework RAG open-source. Per ciascuno, evidenziamo la trazione su GitHub, lo stile di deployment, i punti di forza unici, i casi d’uso primari e un elemento visivo per darti un’idea rapida del progetto.
1. Haystack
Haystack è un framework robusto e modulare progettato per costruire sistemi NLP pronti per la produzione. Supporta vari componenti come retriever, reader e generator, consentendo un’integrazione fluida con strumenti come Elasticsearch e Hugging Face Transformers.
2. LlamaIndex
LlamaIndex è un data framework che collega fonti di dati personalizzate ai large language model. Semplifica il processo di indicizzazione e interrogazione dei dati, rendendo più facile creare applicazioni che richiedono risposte contestuali.
3. LangChain
LangChain è un framework completo che permette agli sviluppatori di creare applicazioni basate su modelli linguistici. Offre strumenti per concatenare diversi componenti come template di prompt, memoria e agent per creare workflow complessi.
4. RAGFlow
RAGFlow è un motore open-source focalizzato sulla comprensione profonda dei documenti. Fornisce un workflow snello per implementare sistemi RAG in azienda, con enfasi su risposte veritiere supportate da citazioni provenienti da formati di dati complessi.
5. txtAI
txtAI è un framework AI all-in-one che combina ricerca semantica e funzionalità RAG. Consente di creare applicazioni che cercano, indicizzano e recuperano informazioni in modo efficiente, supportando vari tipi e formati di dati.
6. Cognita
Cognita è un framework RAG modulare progettato per una personalizzazione e un deployment semplici. Offre un’interfaccia frontend per sperimentare diverse configurazioni RAG, adatto sia a sviluppo sia a produzione.
7. LLMWare
LLMWare offre un framework unificato per creare applicazioni RAG di livello enterprise. Sottolinea l’uso di modelli piccoli e specializzati che possono essere distribuiti in privato, garantendo sicurezza dei dati e compliance.
8. STORM
STORM è un assistente di ricerca che estende il concetto di RAG basato su outline. Si concentra sulla generazione di articoli completi sintetizzando informazioni da varie fonti, ideale per attività di content creation.
9. R2R
R2R (Reason to Retrieve) è un sistema di retrieval AI avanzato che supporta RAG con funzionalità pronte per la produzione. Offre ingestion multimodale, ricerca ibrida e integrazione con knowledge graph, pensato per esigenze enterprise complesse.
10. EmbedChain
EmbedChain è una libreria Python che semplifica la creazione e il deployment di applicazioni AI basate su modelli RAG. Supporta vari tipi di dati, inclusi PDF, immagini e pagine web, risultando versatile per diversi casi d’uso.
11. RAGatouille
RAGatouille integra metodi di retrieval avanzati come ColBERT nelle pipeline RAG. Permette di sperimentare in modo modulare diverse tecniche di retrieval, migliorando flessibilità e prestazioni dei sistemi RAG.
12. Verba
Verba è un assistente personale personalizzabile che utilizza RAG per interrogare e interagire con i dati. Si integra con il database context-aware di Weaviate, abilitando retrieval e interazione efficienti.
13. Jina AI
Jina AI offre strumenti per costruire applicazioni AI multimodali con opzioni di deployment scalabili. Supporta vari protocolli di comunicazione, risultando adatto a sviluppatori che vogliono creare e scalare servizi AI.
14. Neurite
Neurite è un framework RAG emergente che semplifica la creazione di applicazioni alimentate dall’AI. L’enfasi sulla developer experience e sulla prototipazione rapida lo rende un’opzione interessante per la sperimentazione.
15. LLM-App
LLM-App è un framework per creare applicazioni basate su large language model. Fornisce template e strumenti per snellire lo sviluppo, rendendo più semplice integrare funzionalità RAG in varie applicazioni.
Ogni framework offre funzionalità uniche pensate per diversi casi d’uso e preferenze di deployment. In base alle tue esigenze specifiche—facilità di distribuzione, personalizzazione o capacità di integrazione—puoi scegliere il framework più allineato agli obiettivi del tuo progetto.
Scegliere il framework RAG giusto
La scelta del framework RAG appropriato dipende dalle tue necessità specifiche: analisi di documenti legali, ricerca accademica o sviluppo locale leggero. Usa questa tabella per confrontare rapidamente i framework RAG open-source più diffusi in base a come vengono distribuiti, al loro livello di personalizzazione, al supporto per retrieval avanzato, alle capacità di integrazione e all’uso ideale di ogni strumento.
Framework
Deployment
Personalizzazione
Retrieval avanzato
Supporto integrazioni
Ideale per
Haystack
Docker, K8s, Hugging Face
Alta
Sì
Elasticsearch, Hugging Face
Ricerca & QA enterprise
LlamaIndex
Python (locale/cloud)
Alta
Sì
LangChain, FAISS
Bot consapevoli dei documenti
LangChain
Python, JS, Cloud
Alta
Sì
OpenAI, API, DB
Agent & pipeline LLM
RAGFlow
Docker
Media
Sì
Weaviate
Documenti legali o strutturati
txtAI
Locale (Python)
Media
Base
Transformers
Sviluppo locale leggero
Cognita
Docker + UI
Alta
Sì
TrueFoundry
Strumenti business con GUI
LLMWare
CLI, API
Alta
Sì
LLM privati
RAG enterprise privati
STORM
Install da sorgente
Alta
Sì
LangChain, LangGraph
Assistenti di ricerca
R2R
REST API
Alta
Sì
Multimodale
RAG accademico & ibrido
EmbedChain
Python, SaaS
Media
Base
Web, PDF, Immagini
Prototipazione rapida
RAGatouille
Python
Alta
Sì
ColBERT
Sperimentazione dei retriever
Verba
Cloud/Locale
Media
Base
Weaviate
Assistenti contestuali
Jina AI
Docker, REST/gRPC
Alta
Sì
API multimodali
App multimodali scalabili
Neurite
Setup da sorgente
Media
No
N/D
Sperimentazione
LLM-App
CLI, Git
Media
No
OpenAI
App LLM da hackathon
Errori comuni nell’implementazione di RAG
I sistemi RAG possono essere solidi, ma hanno anche spigoli vivi. Se non stai attento, le risposte del modello potrebbero peggiorare rispetto a non usare affatto il retrieval. Ecco quattro problemi comuni da evitare—e cosa fare invece.
1. Indicizzare troppa roba inutile
Non tutto deve finire nel tuo vector store. Riversare ogni documento, post del blog o thread di email può sembrare scrupoloso, ma in realtà inquina la ricerca. Il retriever richiama contesto di poco valore che il modello deve smistare (spesso in modo errato). Meglio essere selettivi: indicizza solo contenuti accurati, ben scritti e utili. Fai pulizia prima di archiviare.
2. Ignorare i limiti di token
Gli LLM hanno una memoria breve. Se il tuo prompt, più tutti i chunk recuperati, supera il limite di token del modello, qualcosa verrà tagliato. E quel “qualcosa” potrebbe essere la parte importante. Mantieni quindi i prompt snelli. Limita il numero di chunk recuperati o sintetizzali prima di inviarli al modello.
3. Ottimizzare per recall, non per precision
È allettante recuperare più documenti per essere sicuro di “coprire tutto”. Ma se i risultati extra sono solo vagamente correlati, riempi il prompt di rumore. Il modello si distrae o, peggio, si confonde. Punta invece alla massima precision. Pochi chunk molto pertinenti sono meglio di una lunga lista di corrispondenze deboli.
4. Volare alla cieca senza log
Quando il modello dà una risposta sbagliata, sai perché? Se non registri query, documenti recuperati e prompt finale, stai facendo debug al buio. Al contrario, registra l’intero flusso RAG: input dell’utente, contenuti recuperati, cosa è stato inviato al modello e la risposta del modello.
Conclusione
RAG non è una bacchetta magica, ma se usato correttamente è uno dei modi più efficaci per rendere gli LLM più intelligenti, pratici e ancorati ai dati che contano per il tuo business.
La chiave è sapere con cosa stai lavorando. Scegliere il framework giusto è parte dell’equazione, ma il successo dipende da quanto bene conosci i tuoi dati e da quanto accuratamente ottimizzi la pipeline di retrieval. Garbage in, garbage out vale ancora, soprattutto quando costruisci sistemi che generano linguaggio, non solo recuperano fatti.
Imposta correttamente l’indicizzazione, tieni d’occhio l’uso dei token e monitora il flusso end-to-end. Quando tutti questi pezzi si incastrano, RAG può trasformare le tue applicazioni AI da impressionanti a davvero utili.